

Når man træder ind i et produkt, der har udviklet sig i mere end ti år, er det ikke overraskende at møde forældede teknologier. Men hvad nu hvis du om et halvt år skal håndtere en belastning, der er ti gange højere, og omkostningerne ved nedbrud stiger hundredevis af gange? I så fald har du brug for en dygtig Highload Engineer. Men i mangel af en kvalificeret person, blev problemet mig overdraget. I den første del af artiklen vil jeg fortælle, hvordan vi flyttede fra Redis til Redis-cluster, og i den anden del vil jeg give råd om, hvordan man begynder at bruge clusteren, og hvad man skal være opmærksom på ved driften.
Valg af teknologi
Er standalone Redis så dårlig? (standalone redis) i konfigurationen 1 master og N slaver? Hvorfor kalder jeg det for en forældet teknologi? Nej, Redis er ikke så dårligt… Men der er nogle mangler, som man ikke kan ignorere.
For det første understøtter Redis ikke mekanismer til katastrofegenopretning efter nedbrud af masteren. For at løse dette problem brugte vi en konfiguration med automatisk omdirigering af VIP'er til en ny master, skift af rolle for en af slaverne, og skift af de øvrige. Denne mekanisme fungerede, men det kunne ikke kaldes en pålidelig løsning. For det første opstod der falske alarmer, og for det andet var den engangsbrug, og efter aktivering krævedes der manuelle handlinger for at nulstille systemet.
For det andet førte det at have kun én master til et sharding-problem. Man var nødt til at oprette flere uafhængige klynger med '1 master og N slaver', derefter manuelt fordele databaserne på disse maskiner og håbe, at en af databaserne ikke ville vokse så meget næste dag, at den skulle flyttes til en separat instans.
Hvilke muligheder er der?
Den dyreste og mest omfattende løsning er Redis-Enterprise. Dette er en pakkeløsning med fuld teknisk support. Selvom det ser ideelt ud fra en teknisk synsvinkel, var det ikke passende for os af ideologiske årsager.
- Redis-cluster. Der er indbygget support til katastrofeomskiftning af masteren og sharding. Grænsefladen adskiller sig næsten ikke fra den almindelige version. Det ser lovende ud, vi vil tale om faldgruberne senere.
- Redis-cluster. Der er indbygget understøttelse af failover og sharding. Grænsefladen adskiller sig næsten ikke fra den almindelige version. Det ser lovende ud; vi vil tale om faldgruberne senere.
- Tarantool, Memcache, Aerospike og andre. Alle disse værktøjer gør stort set det samme. Men hver har sine egne ulemper. Vi har besluttet ikke at lægge alle æggene i én kurv. Memcache og Tarantool bruger vi til andre opgaver, og jeg vil sige på forhånd, at vi har haft flere problemer med dem i vores erfaring.
Specifikationen af anvendelse
Lad os se på, hvilke opgaver vi historisk har løst med Redis og hvilken funktionalitet vi har brugt:
- Cache før forespørgsler til eksterne tjenester som 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache før MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Primært lager for tjenester, der arbejder med sessioner og chaufførers koordinater | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Som du kan se, ingen avanceret matematik. Hvad er så kompleksiteten? Lad os se nærmere på hver metode.
Metoden
Description
Egenskaber ved Redis-cluster
Løsning
GET SET
Skrive/læse nøgle
MGET MSET
Skrive/læse flere nøgler
Nøglerne vil være placeret på forskellige noder. Færdige biblioteker kan kun udføre multi-operationer inden for én node.
Erstat MGET med pipeline af N GET-operationer
SELECT DB
Vælg den database, vi vil arbejde med
Understøtter ikke flere databaser
Læg alt i én database. Tilføj præfikser til nøglerne.
SCAN
Gennemgå alle nøgler i databasen
Da vi har én database, er det for omkostningsfuldt at gennemgå alle nøgler i klyngen.
Oprethold invariant inden for én nøgle og udfør HSCAN på denne nøgle. Eller drop helt.
GEO
Operationer med geonøgle
Geonøgle bliver ikke sharderet
KEY BY PATTERN
Søg nøgle efter mønster
Da vi har én database, vil vi søge blandt alle nøgler i klyngen. Meget omkostningsfuldt.
Drop eller oprethold invariant, ligesom i tilfælde af SCAN.
Redis vs Redis-cluster
Hvad mister vi, og hvad får vi ved at overgå til en klynge?
- Ulemper: mister funktionaliteten af flere databaser.
- Hvis vi ønsker at opbevare logisk ikke-relaterede data i én klynge, bliver vi nødt til at lave løsninger med præfikser.
- Mister alle operationer "pr. database", som SCAN, DBSIZE, CLEAR DB osv.
- Multi-operationer er blevet betydeligt mere komplekse at implementere, da det kan kræve adgang til flere noder.
- Fordele:
- Fejltolerance i form af failover til master.
- Shardering på Redis-siden.
- Atomar dataoverførsel mellem noder uden driftsstop.
- Tilføjelse og redistribution af kapaciteter og belastninger uden driftsstop.
Jeg vil konkludere, at hvis du ikke har brug for at sikre et højt niveau af fejlretningskapacitet, så er det ikke værd at flytte til et cluster, da det kan være en ikke-triviel opgave. Men hvis man fra starten skal vælge mellem en separat version og en cluster-version, så bør man vælge cluster, da det ikke er ringere og i tillæg vil fjerne en del af dit besvær.
Forberedelse til flytning
Lad os starte med kravene til flytningen:
- Den skal være sømløs. En total nedlukning af servicen i 5 minutter er vi ikke tilfredse med.
- Den skal være så sikker og gradvis som muligt. Vi ønsker at have en vis kontrol over situationen. Vi vil ikke bare smide alt ud på en gang og bede til en tilbageslagsknap.
- Minimale datatab under flytningen. Vi forstår, at det vil være meget svært at flytte atomart, så vi accepterer en vis desynkronisering mellem dataene i den normale og cluster-Redis.
Vedligeholdelse af clustret
Før selve flytningen bør vi overveje, om vi kan vedligeholde clustret:
- Grafer. Vi bruger Prometheus og Grafana til grafikker over CPU-belastning, hukommelsesforbrug, antal klienter, antal GET-, SET-, AUTH-operationer osv.
- Ekspertise. Forestil dig, at der i morgen vil være et enormt cluster under dit ansvar. Hvis det går i stykker, kan ingen, undtagen dig, reparere det. Hvis det begynder at hænge, vil alle komme til dig. Hvis der skal tilføjes ressourcer eller omfordeles belastninger, igen til dig. For ikke at blive gråhåret ved 25, er det klogt at forudse disse scenarier og teste på forhånd, hvordan teknologien vil reagere på forskellige handlinger. Det vil vi tale mere om i afsnittet „Ekspertise“.
- Overvågning og advarsler. Når clustret går i stykker, vil man gerne vide det først. Her har vi begrænset os til at advare om, at alle noder returnerer ens oplysninger om clusterets tilstand (ja, der kan være andre tilfælde). De øvrige problemer opdages hurtigere gennem advarsler fra Redis-klientservices.
Flytning
Hvordan vil vi flytte:
- Først og fremmest skal vi forberede biblioteket til at arbejde med klyngen. Som grundlag for versionen i Go har vi taget go-redis og tilpasset den til vores behov. Vi har implementeret Multi-metoder via pipelines, og desuden har vi justeret reglerne for gentagelse af forespørgsler. Med versionen til PHP opstod der flere problemer, men i sidste ende endte vi med php-redis. For nylig implementerede de klyngestøtte, og efter vores mening ser det godt ud.
- Derefter skal klyngen opsættes. Dette gøres bogstaveligt talt med to kommandoer baseret på konfigurationsfilen. Vi vil diskutere opsætningen nærmere nedenfor.
- Til den gradvise migration bruger vi dry-mode. Da vi har to versioner af biblioteket med samme interface (én til den almindelige version, den anden til klyngen), er det ikke svært at lave en wrapper, der arbejder med den separate version og samtidig dublere alle forespørgsler til klyngen, sammenligne svarene og logge uoverensstemmelser (i vores tilfælde i NewRelic). Dermed, selvom klyngeversionen fejler ved udrulning, vil vores produktion ikke blive ramt.
- Når vi ruller klyngen ud i dry-mode, kan vi roligt se på grafen for uoverensstemmelser i svarene. Hvis fejlprocenten langsomt, men sikkert bevæger sig mod en lille konstant, er alt i orden. Hvorfor er der stadig uoverensstemmelser? Fordi optegnelsen i den separate version sker lidt tidligere end i klyngen, og på grund af mikrolag kan dataene divergere. Vi skal blot se på loggene for uoverensstemmelser, og hvis alle kan forklares med ikke-atomariteten af optegnelsen, kan vi gå videre.
- Nu kan vi skifte dry-mode tilbage. Vi vil skrive og læse fra klyngen og dublere til den separate version. Hvorfor? I løbet af den kommende uge ønsker vi at observere klyngens drift. Hvis det viser sig, at der er problemer ved spidsbelastning, eller hvis vi har overset noget, har vi altid en nødnedrulning til den gamle kode og aktuelle data takket være dry-mode.
- Til sidst skal vi deaktivere dry-mode og afmontere den separate version.
Ekspertise
Først en kort beskrivelse af klyngens opbygning.
Først og fremmest er Redis et key-value lager. Som nøgle anvendes vilkårlige strenge. Som værdier kan der anvendes tal, strenge og hele strukturer. Der er et væld af sidstnævnte, men for at forstå den overordnede struktur er det ikke vigtigt.
Det næste abstraheringsniveau efter nøglerne er slots (SLOTS). Hvert slot tilhører en af de 16.383 slots. Inden for hvert slot kan der være et vilkårligt antal nøgler. Dermed opdeles alle nøgler i 16.383 ikke-overlappende mængder.
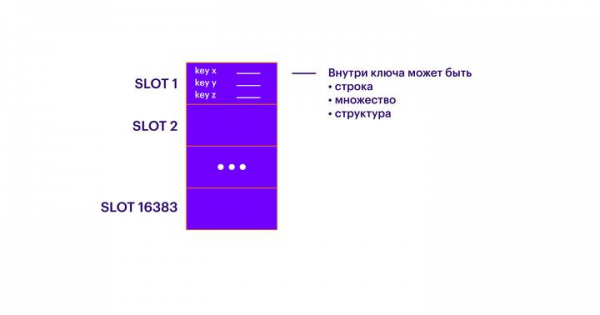
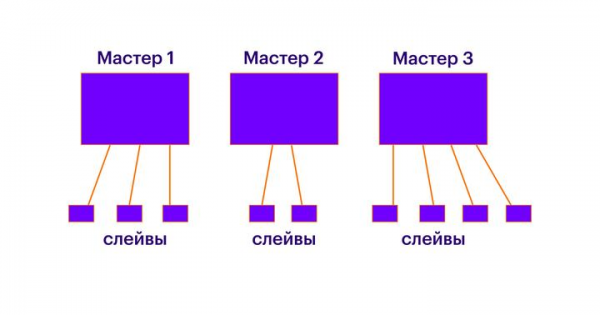
Derudover skal der være N master-noder i klyngen. Hver node kan betragtes som en separat Redis-instans, der kender alt til de andre noder i klyngen. Hver master-node indeholder et bestemt antal slots. Hvert slot tilhører kun én master-node. Alle slots skal fordeles mellem noderne. Hvis nogle slots ikke er fordelt, vil de nøgler, der er gemt i dem, være utilgængelige. Det giver mening at køre hver master-node på en separat logisk eller fysisk maskine. Det er også værd at huske, at hver node kun kører på én kerne, og hvis du vil køre flere Redis-instanser på én logisk maskine, så sørg for, at de kører på forskellige kerner (vi har ikke prøvet dette, men i teorien skulle det fungere). Grundlæggende sikrer master-noder almindelig sharding, og et større antal master-noder muliggør skalering af skrive- og læseanmodninger.
Når alle nøgler er fordelt på slots, og slots er fordelt på master-noder, kan der tilføjes et vilkårligt antal slave-noder til hver master-node. Inden for hver sådan ‘master-slave’-binding vil der være normal replikation. Slaverne er nødvendige for at skalere læseanmodninger og til failover i tilfælde af, at masteren fejler.
Lad os nu tale om de operationer, som vi helst skal kunne udføre.
Vi vil have adgang til systemet gennem Redis-CLI. Da Redis ikke har et enkelt indgangspunkt, kan de følgende operationer udføres på hvilken som helst af noderne. I hvert punkt vil jeg specifikt påpege muligheden for at udføre operationen under belastning.
- Den første og vigtigste, vi har brug for: operationen cluster nodes. Den returnerer tilstanden af klyngen, viser listen over noder, deres roller, fordelingen af slots osv. Yderligere oplysninger kan fås med cluster info og cluster slots.
- Det ville være godt at kunne tilføje og fjerne noder. Dette kan gøres med operationerne cluster meet og cluster forget. Bemærk, at cluster forget skal anvendes på HVER nod, både mestre og replikaer. Cluster meet skal derimod kun kaldes på én nod. Denne forskel kan være forvirrende, så det er bedst at lære om den, før man sætter klyngen i drift. At tilføje en nod kan udføres sikkert under drift og påvirker ikke klyngens funktion (hvilket giver mening). Hvis du derimod planlægger at fjerne en nod fra klyngen, skal du sikre dig, at der ikke er resterende slots på den (ellers risikerer du at miste adgangen til alle nøgler på den nod). Fjern heller ikke en master, der har slaves, ellers vil der blive gennemført en unødvendig afstemning om en ny master. Hvis der ikke allerede er slots på noderne, er det et lille problem, men hvorfor tage unødvendige valg, hvis man først kan fjerne slaves.
- Hvis du nødvendigvis skal bytte master og slave, kan du bruge kommandoen cluster failover. Når du kalder den under drift, skal du være opmærksom på, at mesteren vil være utilgængelig under operationens udførelse. Normalt sker skiftet på mindre end et sekund, men ikke atomart. Du kan forvente, at nogle forespørgsler til mesteren i denne periode vil fejle.
- Før du fjerner en node fra klyngen, må der ikke være nogen slots tilbage. Det er bedst at omfordele dem med kommandoen cluster reshard. Slots vil blive flyttet fra en master til en anden. Hele operationen kan tage flere minutter, afhængigt af mængden af flyttede data; men overførselsprocessen er sikker og påvirker ikke klyngens drift. På den måde kan alle data flyttes fra én node til en anden, selv under belastning, og der behøver ikke være bekymringer om deres tilgængelighed. Der er dog nogle detaljer. For det første medfører dataoverførslen en vis belastning på både afsender- og modtager-noden. Hvis modtager-noden allerede er meget belastet CPU-mæssigt, bør du ikke belaste den yderligere med modtagelse af nye data. For det andet, så snart der ikke er nogen slots tilbage på afsender-masteren, vil alle dens slaver straks skifte til den master, som disse slots er blevet flyttet til. Problemet er, at alle disse slaver vil forsøge at synkronisere data på én gang. Du kan være heldig, hvis det kun er en delvis og ikke en fuld synkronisering. Tag dette i betragtning, og kombiner operationer for slotflytning og slaver-afbrydelse/flytning. Eller håb på, at du har en tilstrækkelig buffer.
- Hvad skal du gøre, hvis du under flytningen opdager, at du har mistet slots? Jeg håber, dette problem ikke rammer dig, men hvis det gør, findes der en operation cluster fix. Den vil fordele slots over noderne i tilfældig rækkefølge. Jeg anbefaler at teste dens funktion ved først at fjerne en node med fordelte slots fra klyngen. Da dataene i de ufordelte slots allerede ikke er tilgængelige, er det for sent at bekymre sig om tilgængelighedsproblemer med disse slots. På den anden side vil operationen ikke påvirke de fordelte slots.
- En anden nyttig operation er monitor. Den giver dig mulighed for i realtid at se hele listen over anmodninger, der går til noden. Desuden kan du lave grep på den og finde ud af, om den ønskede trafik er til stede.
Det er også værd at nævne proceduren for fejloverførsel af masteren. Kort sagt, den findes, og efter min mening fungerer den glimrende. Men man skal ikke tro, at hvis man tager stikket ud af stikkontakten på en maskine med master-noden, så vil Redis straks skifte, og kunderne vil ikke bemærke tabet. I min erfaring tager det nogle sekunder at skifte. I denne periode vil nogle data være utilgængelige: masterens utilgængelighed opdages, noderne stemmer om en ny, slavene skifter, data synkroniseres. Den bedste måde at sikre sig selv, at skemaet fungerer, er at gennemføre lokale øvelser. Opsæt et klynge på din bærbare computer, giv minimal belastning, simulér et nedbrud (for eksempel ved at blokere porte), og vurdér skiftets hastighed. Efter min mening kan man kun være sikker på teknologiens funktion ved at eksperimentere på denne måde i en dag eller to. Eller man kan håbe, at softwaren, som halvdelen af internettet bruger, helt sikkert fungerer.
Konfiguration
Ofte er konfigurationen det første, man skal have på plads for at begynde at arbejde med værktøjet. Når alt virker, er det fristende ikke at røre ved konfigurationen. Der kræves en bestemt indsats for at tvinge sig selv til at vende tilbage til indstillingerne og grundigt gennemgå dem. Efter min hukommelse har vi haft mindst to alvorlige fiaskoer på grund af uforsigtighed med konfigurationen. Vær især opmærksom på følgende punkter:
- timeout 0
Den tid, hvorefter inaktive forbindelser lukkes (i sekunder). 0 — lukker ikke.
Ikke hver af vores biblioteker kunne korrekt lukke forbindelser. Ved at deaktivere denne indstilling risikerer vi at ramme grænsen for antallet af klienter. På den anden side, hvis der er et sådant problem, vil automatisk afslutning af tabte forbindelser skjule det, så vi kan overse det. Desuden bør man ikke aktivere denne indstilling ved brug af persist-forbindelser. - Save x y & appendonly yes
Gem RDB-snapshot.
Vi vil diskutere problemerne med RDB/AOF nærmere nedenfor. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Hvis det er aktiveret, stopper masteren med at modtage ændringsforespørgsler ved en fejl i RDB-snapshotet. Hvis forbindelsen til masteren går tabt, kan slaven fortsætte med at svare på forespørgsler (yes). Eller stoppe med at svare (no).
Vi er ikke tilfredse med en situation, hvor Redis bliver til et græskar. - repl-ping-slave-period 5
Efter denne periode begynder vi at bekymre os om, at masteren er gået ned, og det er på tide at udføre failover-proceduren.
Vi skal manuelt finde balancen mellem falske alarmer og aktivering af failover. I vores praksis er det 5 sekunder. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Lige så mange data kan vi opbevare i bufferen for den nedlagte replika. Hvis bufferen er fyldt, skal vi synkronisere fuldstændigt.
Praksis viser, at det er bedre at sætte værdien større. Der er mange grunde til, at replikaen kan begynde at hænge bagud. Hvis den hænger bagud, er det sandsynligt, at din master allerede har svært ved at klare sig, og en fuldstændig synkronisering vil være dråben, der får bægeret til at flyde over. - maxclients 10000
Det maksimale antal samtidige kunder.
Efter vores erfaring er det bedre at sætte værdien højere. Redis håndterer fint 10.000 forbindelser. Sørg bare for, at der er nok sockets i systemet. - maxmemory-policy volatile-ttl
Reglen for, hvordan nøgler slettes, når grænsen for tilgængelig hukommelse nås.
Det vigtige her er ikke selve reglen, men forståelsen af, hvordan dette vil ske. Redis kan roses for sin evne til at fungere korrekt, når hukommelsesgrænsen nås.
Problemer med RDB og AOF
Selvom Redis selv opbevarer al information i hukommelsen, er der også en mekanisme til at gemme data på disk. Mere specifikt er der tre mekanismer:
- RDB-snapshot — et komplet snapshot af alle data. Dette indstilles via konfigurationen SAVE X Y og læses som "Gem et fuldt snapshot af alle data hver X sekunder, hvis mindst Y nøgler er ændret."
- Append-only file — en liste over operationer i den rækkefølge, de udføres. Tilføjer nye operationer til filen hver X sekunder eller hver Y operationer.
- RDB og AOF — en kombination af de to tidligere.
Alle metoder har deres fordele og ulemper; jeg vil ikke nævne dem alle, men jeg vil gerne påpege nogle af de mindre oplagte punkter, efter min mening.
For det første kræver det at gemme et RDB-snapshot, at der kaldes FORK. Hvis der er mange data, kan dette få hele Redis til at fryse i en periode fra nogle millisekunder til et sekund. Desuden kræver systemet hukommelse til et sådant snapshot, hvilket betyder, at man skal have dobbelt så meget RAM til Redis: hvis der er afsat 8 GB til Redis, skal der være 16 GB tilgængeligt på den virtuelle maskine.
For det andet er der problemer med delvis synkronisering. I AOF-tilstand kan der ved genopkobling af en slave udføres en fuld synkronisering i stedet for en delvis. Hvorfor dette sker, har jeg ikke kunnet forstå. Men det er værd at huske på.
Disse to punkter får allerede en til at tænke over, hvorvidt vi virkelig har brug for disse data på disken, hvis de allerede er duplikeret af slaverne. Man kan kun miste data, hvis alle slaverne fejler, og det er et problem af niveauet 'brand i datacenteret'. Som et kompromis kan man overveje kun at gemme data på slaverne, men i så fald skal man sikre sig, at disse slaver aldrig bliver master ved fejlgendannelse (til dette er der en indstilling for prioritering af slaver i deres konfiguration). I hvert enkelt tilfælde overvejer vi, om vi skal gemme data på disken, og vi svarer oftest 'nej'.
Konklusion
Afslutningsvis håber jeg, at jeg har givet et overordnet indblik i arbejdet med redis-cluster til dem, der ikke har hørt om det før, samt at jeg har påpeget nogle uvurderlige punkter for dem, der har brugt det i lang tid.
Tak for din tid, og som altid er kommentarer om emnet velkomne.
Kilde: habr.com
