

I denne artikel samles nogle almindelige skabeloner, der hjælper ingeniører med at arbejde med store tjenester, som millioner af brugere anmoder om.
Ud fra forfatterens erfaring er dette ikke en udtømmende liste, men faktisk effektive råd. Lad os komme i gang.
Oversat med støtte fra .
Basisniveau
De nedenfor nævnte foranstaltninger er forholdsvis nemme at implementere, men giver et højt afkast. Hvis du ikke har foretaget dem før, vil du blive overrasket over de betydelige forbedringer.
Infrastruktur som kode
Den første del af rådene handler om at implementere infrastruktur som kode. Det betyder, at du skal have en programmeret måde at implementere hele infrastrukturen på. Det lyder komplekst, men vi taler faktisk om følgende kode:
Implementering af 100 virtuelle maskiner
- med Ubuntu
- 2 GB RAM på hver
- de vil have følgende kode
- med sådanne parametre
Du kan spore ændringer i infrastrukturen og hurtigt vende tilbage til dem med et versionsstyringssystem.
Den modernistiske del af mig siger, at man kan bruge Kubernetes/Docker til at gøre alt ovenstående, og det har ret.
Desuden kan automatiseringen sikres med Chef, Puppet eller Terraform.
Kontinuerlig integration og levering
For at skabe en skalerbar tjeneste er det vigtigt at have en byggetestpipeline for hver pull-request. Selv hvis testen er den simpleste, garanterer den i det mindste, at den kode, du implementerer, kan kompileres.
Hver gang på dette punkt stiller du spørgsmålet: kan min bygning kompilere og bestå testene, er den gyldig? Det kan virke som en lav tærskel, men det løser mange problemer.
Der er intet bedre end at se disse ikoner
For denne teknologi kan du overveje Github, CircleCI eller Jenkins.
Lastbalancere
Så vi ønsker at starte en lastbalancer for at omdirigere trafik og sikre jævn belastning på alle noder eller tjenester i tilfælde af fejl:
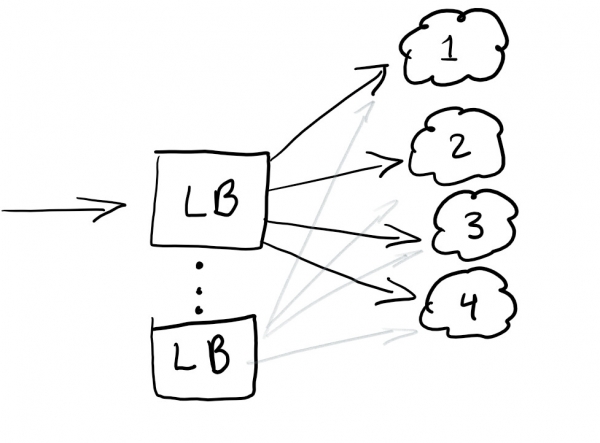
Lastbalanceren hjælper typisk godt med at fordele trafikken. Den bedste praksis er redundans i lastbalanceringen, så du ikke har et enkelt fejlpunkt.
Som regel konfigureres lastbalancere i den cloud, du bruger.
RayID, korrelations-ID eller UUID for forespørgsler
Har du nogensinde stødt på en fejl i en applikation med en meddelelse som den følgende: «Noget gik galt. Gem denne ID og send den til vores supporttjeneste»?
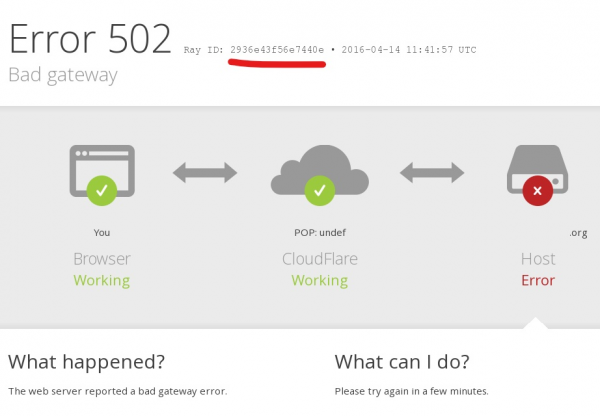
En unik identifikator, korrelations-ID, RayID eller en hvilken som helst af varianterne — er en unik identifikator, der gør det muligt at spore en forespørgsel gennem dens livscyklus. Dette gør det muligt at følge hele vejen for forespørgslen i loggene.
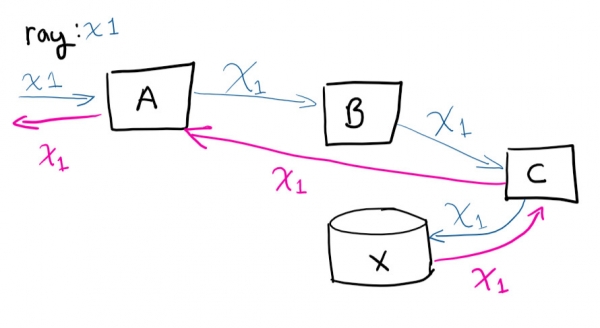
Brugeren sender en forespørgsel til system A, derefter kontakter A B, som kontakter C, gemmer i X, og så returneres forespørgslen til A
Hvis du skulle oprette en fjernforbindelse til virtuelle maskiner og forsøge at spore vejen for forespørgslen (og manuelt sammenligne hvilke opkald der sker), ville du blive sindssyg. At have en unik identifikator gør livet meget lettere. Dette er en af de nemmeste ting, du kan gøre for at spare tid, når tjenesten vokser.
Mellemniveau
Her er rådene sværere end de tidligere, men de rigtige værktøjer gør opgaven lettere, hvilket sikrer investeringsafkast selv for små og mellemstore virksomheder.
Centraliseret logføring
Tillykke! Du har opsat 100 virtuelle maskiner. Næste dag kommer direktøren og klager over en fejl, han fik under test af tjenesten. Han giver det relevante ID, som vi talte om ovenfor, men du bliver nødt til at gennemgå loggene for 100 maskiner for at finde den, der forårsagede fejlen. Og den skal findes før præsentationen i morgen.
Selvom det lyder som et sjovt eventyr, er det bedre at sikre sig, at du har mulighed for at søge i alle loggene fra ét sted. Jeg løste opgaven med centralisering af logene ved hjælp af den indbyggede funktionalitet i ELK-stakken: her understøttes logindsamling med mulighed for søgning. Det vil virkelig hjælpe med at løse problemet med at finde en specifik log. Som bonus kan du også lave diagrammer og lignende sjove ting.
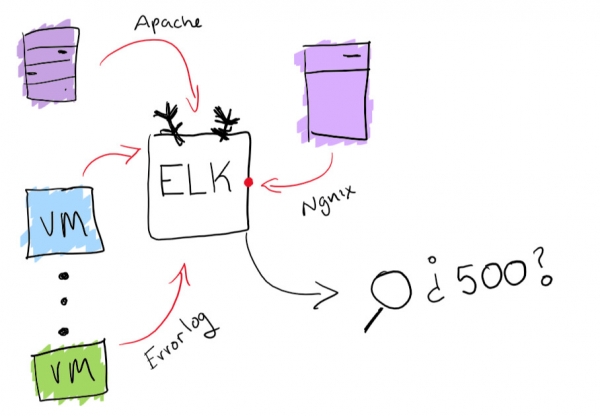
Funktionaliteten i ELK-stakken
Overvågningsagenter
Nu hvor din tjeneste er sat i drift, skal du sikre dig, at den fungerer uden problemer. Den bedste måde at gøre dette på er at køre flere agenter, der kører parallelt og tjekker, at den fungerer, og at grundlæggende operationer udføres.
På dette stadium tjekker du, at den kørende opbygning fungerer godt og fungerer normalt.
For små og mellemstore projekter anbefaler jeg Postman til overvågning og dokumentation af API'er. Men generelt bør du blot sikre dig, at du har en metode til at vide, hvornår noget går galt, og få rettidige beskeder.
Automatisk skalering baseret på belastning
Det er meget simpelt. Hvis du har en virtuel maskine, der betjener forespørgsler, og den nærmer sig 80% hukommelse i brug, kan du enten øge dens ressourcer eller tilføje flere virtuelle maskiner til klyngen. Automatisk udførelse af disse operationer er fremragende til elastisk ændring af kapacitet under belastning. Men du skal altid være forsigtig med, hvor mange penge du bruger, og sætte rimelige grænser.
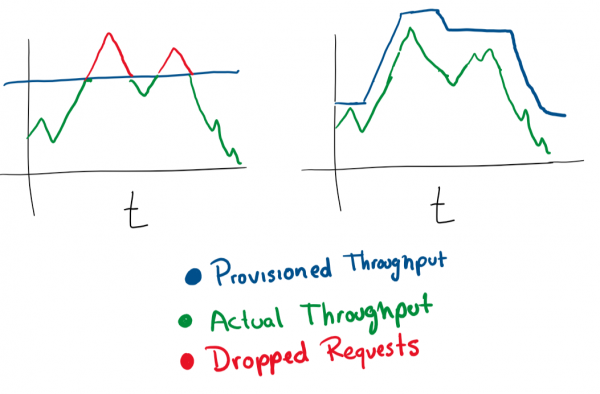
I de fleste cloud-tjenester kan du konfigurere automatisk skalering ved at bruge flere servere eller mere kraftfulde servere.
Eksperimenteringssystem
En god måde at rulle opdateringer sikkert ud på vil være at have mulighed for at teste noget for 1% af brugerne i en time. Du har selvfølgelig set sådanne mekanismer i aktion. For eksempel viser Facebook dele af publikum en anden farve eller ændrer skrifttypestørrelsen for at se, hvordan brugerne reagerer på ændringerne. Dette kaldes A/B-testning.
Selv lanceringen af en ny funktion kan udføres som et eksperiment og derefter bestemme, hvordan man skal rulle den ud. Du får også mulighed for at "tilbagekalde" eller ændre konfigurationen i realtid i tilfælde af en funktion, der forårsager forringelse af din tjeneste.
Avanceret niveau
Her er tips, der er ret svære at implementere. Du vil sandsynligvis have brug for lidt flere ressourcer, så det vil være svært for en lille eller mellemstor virksomhed at håndtere dette.
Blå-grønne udrulninger
Det er, hvad jeg kalder den "erlangske" udrulningsmetode. Erlang blev meget anvendt, da telefonfirmaer opstod. Programmatisk switching blev anvendt til at rute telefonopkald. Den primære opgave for softwaren i disse switchere var at sikre, at opkald ikke blev afbrudt under systemopdateringer. Erlang har en fantastisk metode til at indlæse en ny modul uden at nedlægge den tidligere.
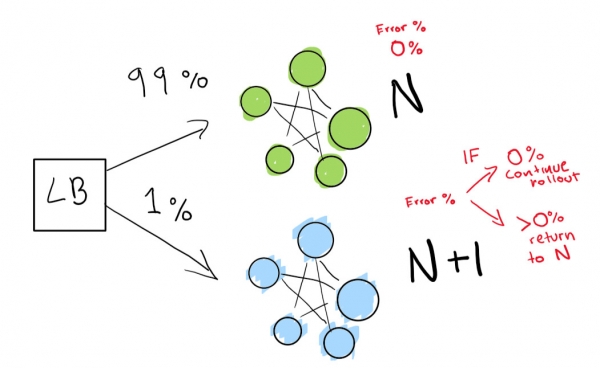
Dette trin afhænger af tilgængeligheden af en load balancer. Lad os sige, at du har version N af din software, og nu ønsker du at implementere version N+1.
Du kunne du bare stoppe tjenesten og udrulle den næste version på et tidspunkt, der passer dig og dine brugere, og få lidt nedetid. Men lad os antage, at du har faktisk strenge SLA-betingelser. Så en SLA på 99,99 % betyder, at du kan være offline kun i 52 minutter om året.
Hvis du virkelig ønsker at opnå sådanne resultater, skal der to udrulninger til samtidig:
- den, der er i drift lige nu (N);
- den næste version (N+1).
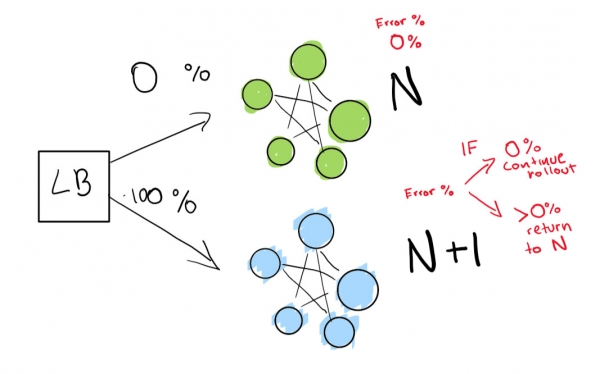
Du beder load balancer om at omdirigere en procentdel af trafikken til den nye version (N+1), mens du aktivt overvåger for regressioner.
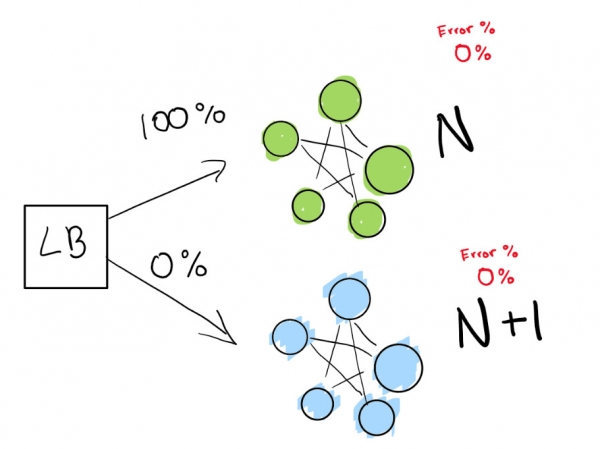
Her har vi en grøn udrulning N, der fungerer normalt. Vi forsøger at gå videre til den næste version af denne udrulning.
Først sender vi virkelig en lille test for at se, om vores udrulning N+1 fungerer med en lille mængde trafik:
Endelig har vi et sæt automatiserede kontroller, som vi til sidst kører, indtil vores udrulning er komplet. Hvis du er meget, meget forsigtig, kan du også beholde din udrulning N for evigt for en hurtig tilbageførelse i tilfælde af en dårlig regression:
Hvis du vil tage det til et endnu mere avanceret niveau, så lad alt i den blå-grønne udrulning køre automatisk.
Opdagelse af anomalier og automatisk afbødning
Med centraliseret logføring og god logindsamling kan du allerede sætte højere mål. For eksempel proaktivt forudsige fejl. Monitorer og logs sporer funktioner og opbygger forskellige diagrammer – og man kan på forhånd forudsige, hvad der vil gå galt:
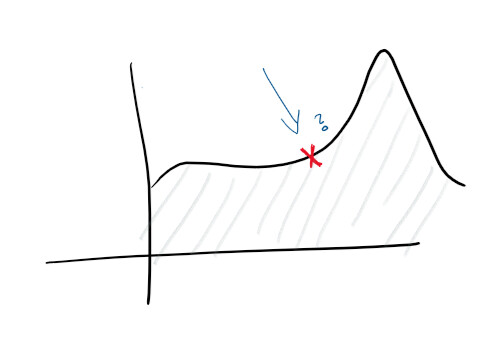
Med opdagelse af anomalier begynder du at studere nogle tips, som tjenesten giver. For eksempel kan en stigning i CPU-belastningen indikere, at harddisken er ved at svigte, mens en stigning i antal forespørgsler betyder, at du skal skalere op. Denne type statistikker gør det muligt at gøre tjenesten proaktiv.
Med disse analytiske data kan du skalere i alle dimensioner, proaktivt og reaktivt ændre egenskaber for maskiner, databaser, forbindelser og andre ressourcer.
Det var det!
Denne prioritetsliste vil befri dig for mange problemer, når du opgraderer din cloud service.
Forfatteren af den oprindelige artikel inviterer læserne til at efterlade deres kommentarer og bidrage med ændringer. Artiklen distribueres som open source, pull-requests forfatteren .
Hvad andet at læse om emnet:
Kilde: habr.com
