

Udvikling af et datalager er en lang og seriøs opgave.
Meget i projektets liv afhænger af, hvor godt den objektmodel og database-struktur er planlagt fra starten.
Den almindeligt accepterede tilgang har været og forbliver forskellige kombinationsvarianter af stjerneskemaet med tredje normalform. Som regel følger den princippet: rådata - 3NF, datavarehuse - stjerne. Denne tilgang, som er blevet bevist gennem tiden og understøttet af mange undersøgelser, er det første (og nogle gange det eneste), der kommer til at tænke på for en erfaren DWH-udvikler, når man overvejer, hvordan et analytisk datalager burde se ud.
På den anden side har både forretningen generelt og kundens krav i særdeleshed en tendens til hurtigt at ændre sig, og data kan vokse både "i dybden" og "i bredden". Her viser stjernens hovednederlag sig — dens begrænsede fleksibilitet. fleksibilitet.
Hvis der pludselig i det stille og hyggelige liv for en DWH-udvikler opstår et:
- behov for at "få gjort noget hurtigt, så må vi se senere";
- et hastigt voksende projekt, med tilslutning af nye kilder og en ændring af forretningsmodellen mindst en gang om ugen;
- en kunde, der ikke har en idé om, hvordan systemet skal se ud, og hvilke funktioner det til slut skal udføre, men er åben for eksperimenter og gradvis præcisering af ønsket resultat med en tilsvarende tilgang;
- en projektleder, der kommer med den glædelige nyhed: "Og nu har vi Agile!".
Eller hvis du bare er interesseret i at høre om, hvordan man ellers kan bygge datalagre — så er du velkommen til at læse videre!
Hvad betyder "fleksibilitet"?
For at starte med, lad os definere, hvilke egenskaber et system skal have for at blive kaldt "fleksibelt".
Det skal nævnes, at de beskrevne egenskaber specifikt skal relateres til netværksstyringssystemet og CI/CD bliver et fuldstændigt versionsstyret konfiguration., og ikke til udviklingsprocessen. Derfor, hvis du ønskede at læse om Agile som udviklingsmetodologi, er det bedre at kigge på andre artikler. For eksempel, her på Habré, er der mange interessante materialer (både og , og ).
Det betyder ikke, at udviklingsprocessen og DWH-strukturen slet ikke har noget at gøre med hinanden. Generelt bør det være betydeligt lettere at udvikle et fleksibelt datalager med en Agile-arkitektur. Dog møder man i praksis oftere tilfælde af udvikling af et klassisk DWH efter Kimballs metode og DataVault — efter vandfaldsmetoden, end glade sammenfald af fleksibilitet i de to former i ét projekt.
Og hvilke muligheder bør et fleksibelt datalager så have? Her kan man fremhæve tre punkter:
- Tidlig levering og hurtig forbedring — det betyder, at ideelt set bør det første forretningsresultat (for eksempel de første fungerende rapporter) opnås så tidligt som muligt, dvs. før systemet er fuldt designet og implementeret. Hver efterfølgende forbedring bør også tage så lidt tid som muligt.
- Iterativ forbedring — det betyder, at hver efterfølgende forbedring ideelt set ikke bør påvirke den allerede fungerende funktionalitet. Dette punkt bliver ofte det største mareridt i store projekter — før eller senere begynder enkelte objekter at få så mange forbindelser, at det bliver lettere at gentage logikken i en kopi ved siden af, end at tilføje et felt i eksisterende tabel. Og hvis det forundrer dig, at analysen af forbedringens indflydelse på eksisterende objekter kan tage længere tid end selve forbedringen — har du sandsynligvis endnu ikke arbejdet med store DWH i bank- eller telekomsektoren.
- Konstant tilpasning til ændrede forretningskrav — den generelle objektstruktur skal være designet ikke bare med mulighed for udvidelse in mente, men med det overordnede mål, at retningen for denne næste udvidelse ikke engang burde kunne være forestillet på designstadiet.
Og ja, overholdelse af alle disse krav i ét system er muligt (naturligvis under visse forhold og med nogle forbehold).
Nedenfor vil jeg se nærmere på to af de mest populære metoder til fleksibel design for DWH — Anchor model og Data Vault. For the sake of clarity, some excellent techniques such as EAV, 6NF (in its pure form), and everything related to NoSQL solutions are left out — not because they are worse or because the article might have ended up being the length of an average thesis. It’s simply that all of this pertains to solutions of a somewhat different class — either to techniques that you can apply in specific cases, regardless of the overall architecture of your project (like EAV), or to completely different paradigms of data storage (such as graph databases and other NoSQL options).
Problems of the 'classical' approach and their solutions in agile methodologies
By 'classical' approach, I mean the old reliable star (regardless of the specific implementation of the underlying layers, forgive me, followers of Kimball, Inmon, and CDM).
1. Rigid cardinality of relationships
The foundation of such a model rests on a clear separation of data into dimensions (Dimension) og facts (Fact). And this is, damn it, logical — because data analysis in the vast majority of cases boils down to analyzing specific numeric indicators (facts) in specific contexts (dimensions).
At the same time, the relationships between objects are established in the form of links between tables through a foreign key. This seems quite natural, but it immediately leads to the first limitation of flexibility — a rigid definition of the cardinality of relationships..
This means that at the design stage of tables you must accurately determine for each pair of related objects whether they can relate as many-to-many or only one-to-many, and 'in which direction'. This directly affects which table will have the primary key and which will have the foreign key. Changing this relationship when new requirements arise will very likely lead to a redesign of the database.
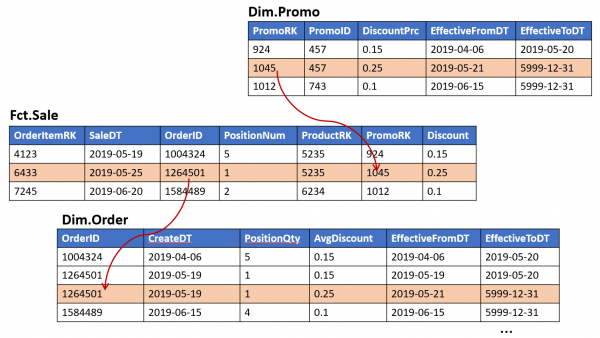
For example, when designing the object 'cash receipt', relying on the solemn assurances of the sales department, you laid the possibility of one promotional action applying to several receipt items (but not vice versa): And after some time, the colleagues introduced a new marketing strategy where multiple promotional actions can apply to the same item simultaneously.
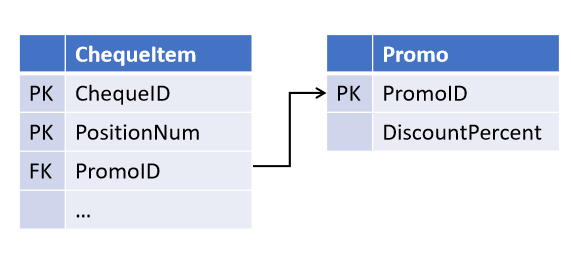
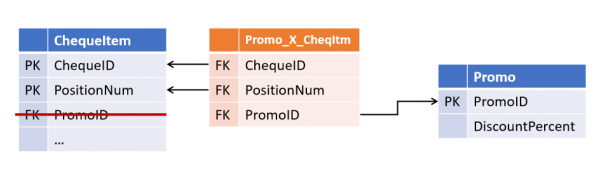
And now you need to refine the tables, isolating the relationship into a separate object. ..
(Alle afledte objekter, hvor der sker en join check på promo, skal nu også revideres).
Forbindelser i Data Vault og Anchor Model
Det viste sig at være ret simpelt at undgå en sådan situation: man skal ikke stole på salgsafdelingen for dette. Alle forbindelser skal oprindeligt opbevares i separate tabeller og behandles som mange-til-mange.
Denne tilgang blev foreslået af Dan Linstedt som en del af paradigmet Data Vault og blev fuldt ud støttet af Lars Rönnbäck i Anchor Model.
Resultatet er den første karakteristiske egenskab ved fleksible metoder:
Forbindelserne mellem objekterne opbevares ikke i attributterne af de parent entity'er, men udgør en separat type objekter.
I Data Vault Sådanne forbindelsestabeller kaldes Forbindelse, og der sendes noget til den, vil flytning af denne task til sektionen Anchor Model — Tie. Ved første øjekast ligner de hinanden meget, selvom deres navne ikke fuldt ud dækker forskellene (som vil blive diskuteret nedenfor). I begge arkitekturer kan forbindelsestabeller forbinde et hvilket som helst antal enheder (ikke nødvendigvis 2).
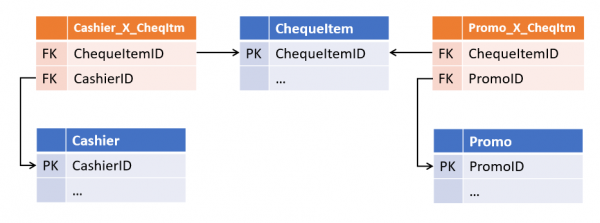
Denne tilsyneladende overdrevenhed giver betydelig fleksibilitet ved revideringer. Denne struktur bliver tolerant ikke kun over for ændringer i kardinaliteterne for eksisterende forbindelser, men også tilføjelse af nye — hvis der nu vil være et link til den kasserer, der behandlede kvitteringen, bliver tilføjelsen af en sådan forbindelse blot en forstærkning af de eksisterende tabeller uden indflydelse på nogen eksisterende objekter og processer.
2. Dateneduplication
Det andet problem, som fleksible arkitekturer løser, er mindre åbenlyst og er primært karakteristisk for SCD2-type målinger (langsomt skiftende dimensioner af anden type), selvom dette ikke kun gælder dem.
I et klassisk datalager repræsenterer en dimension normalt en tabel, der indeholder en surrogatnøgle (som PK) samt en række forretningsnøgler og attributter i separate kolonner.
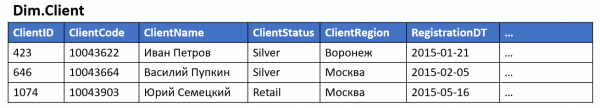
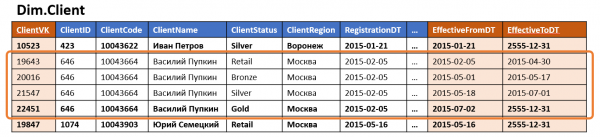
Hvis dimensionen understøtter versionsstyring, tilføjes der tidsgrænser for versionens gyldighed til standardferien, og til en række i kilden optræder der flere versioner i lageret (én for hver ændring af de versions-baserede attributter).
Hvis dimensionen indeholder blot én ofte ændret versioneret attribut, vil antallet af versioner af denne dimension være betydeligt (selv hvis de øvrige attributter ikke er versionerede eller aldrig ændres), og hvis der er flere sådanne attributter, kan antallet af versioner vokse eksponentielt i forhold til deres antal. En sådan dimension kan optage en betydelig mængde diskplads, selvom størstedelen af de gemte data blot er duplikater af værdier fra uændrede attributter fra andre rækker.
Samtidig anvendes meget ofte også denormalisering — en del af attributterne gemmes bevidst som en værdi i stedet for en henvisning til et opslagsord eller en anden dimension. Denne tilgang fremskynder adgangen til dataene og reducerer antallet af joins, når der henvendes til dimensionen.
Som regel fører det til, at den samme information gemmes samtidigt flere steder. For eksempel kan information om bopælsregion og kategori tilhørsforhold samtidig gemmes i dimensionerne "Kunde" og faktaene "Køb", "Levering" og "Henvendelser til callcenteret", samt i forbindelsestabellen "Kunde — Kundeansvarlig."
Generelt gælder det ovenstående også for almindelige (ikke-versionerede) dimensioner, men i versionerede kan det have en anden skala: fremkomsten af en ny version af et objekt (især retrospektivt) fører ikke blot til opdatering af alle de relaterede tabeller, men til en kaskade af nye versioner af de relaterede objekter — når Tabel 1 bruges i opbygningen af Tabel 2, og Tabel 2 — i opbygningen af Tabel 3 osv. Selv hvis ingen attribut fra Tabel 1 deltager i opbygningen af Tabel 3 (men andre attributter fra Tabel 2, der er opnået fra andre kilder, deltager), vil en versionering af denne konstruktion mindst føre til yderligere overhead, og i værste fald til unødvendige versioner i Tabel 3, som slet ikke er "relevant" her, og så videre ad kæden.
3. Ikke-lineær kompleksitet af tilpasning
Samtidig øger hver ny datavisning, der bygges på grundlag af en anden, antallet af steder, hvor dataene kan "slå fejl" ved indførelsen af ændringer i ETL. Dette fører i sin tur til en stigning i kompleksiteten (og varigheden) af hver følgende tilpasning.
Hvis det ovenfor beskrevne gælder systemer med sjældent modificerede ETL-processer, kan man leve i et sådant paradigme — det er tilstrækkeligt blot at sikre, at nye modifikationer bliver korrekt indført i alle relaterede objekter. Hvis modifikationerne derimod sker ofte, stiger sandsynligheden for uheldigt at "miste" flere relationer betydeligt.
Hvis man derudover overvejer, at "versionsbaseret" ETL er væsentligt mere kompleks end "ikke versionsbaseret", bliver det ret vanskeligt at undgå fejl ved hyppige ændringer af hele dette system.
Opbevaring af objekter og attributter i Data Vault og Anchor Model
Den tilgang, der foreslås af forfatterne til fleksible arkitekturer, kan formuleres således:
Det er nødvendigt at adskille det, der ændres, fra det, der forbliver uændret. Det vil sige, at nøgler skal opbevares separat fra attributter.
Man skal dog ikke forveksle ikke versionsbaseret attribut med uændret: den første opbevarer ikke historien om ændringer, men kan ændres (for eksempel ved rettelse af indtastningsfejl eller modtagelse af nye data); den sidste — ændres aldrig.
Der er forskellige synspunkter på, hvad der præcist kan betragtes som uændret i Data Vault og Anchor modellen.
Set fra et arkitekturperspektiv Data Vault, kan man betragte hele sæt af nøgler — naturlige (CVR-nummer for virksomheder, produktkode i kildesystemet osv.) og surrogate. Herudover kan de øvrige attributter opdeles i grupper efter kilde og/eller ændringsfrekvens og for hver gruppe føre en separat tabel med uafhængigt sæt af versioner.
I paradigmet Anchor Model betegnes uændret kun den surrogate nøgle af entitet. Alt andet (inklusive naturlige nøgler) er blot en særlig form for dens attributter. Herudover er alle attributter som standard uafhængige af hinanden, derfor skal der oprettes en separat tabel.
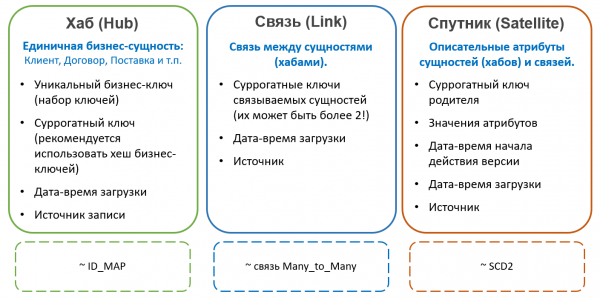
I Data Vault tabeller, der indeholder entitetsnøgler, kaldes Hubs.Hubs indeholder altid et fast sæt felter:
- Naturlige nøgler for entitet
- Surrogatnøgle
- Reference til kilde
- Tidspunkt for oprettelse af post
Poster i Hubs bliver aldrig ændret og har ikke versioner.. Eksternt ligner hubs meget på ID-map-tabeller, der anvendes i nogle systemer til generering af surrogater, men i Data Vault anbefales det at anvende hash fra et sæt af forretningsnøgler som surrogater i stedet for en heltalssekvens. Denne tilgang forenkler indlæsning af relationer og attributter fra kilder (man skal ikke join'e til hub'en for at få surrogatet, det er tilstrækkeligt blot at beregne hashen af den naturlige nøgle), men kan medføre andre problemer (for eksempel relateret til kollisioner, skrifttegn og usynlige tegn i strengnøgler osv.), og derfor er den ikke almindeligt accepteret.
Alle andre attributter for entiteter opbevares i specielle tabeller, kaldet satellitter (Satellit). Én hub kan have flere satellitter, der opbevarer forskellige sæt af attributter.
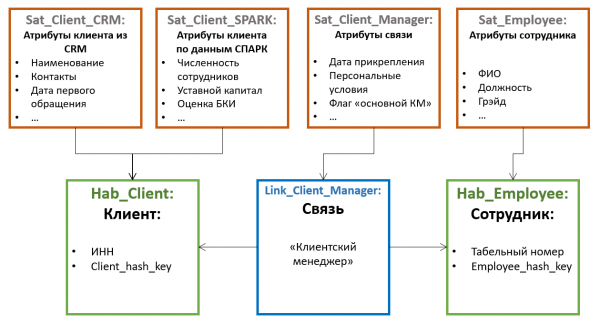
Fordelingen af attributter på satellitter sker efter princippet om samlet ændring — i en satellit kan der opbevares ikke-versionerede attributter (for eksempel fødselsdato og CPR-nummer for en privatperson), i en anden — sjældent ændrede versionerede (for eksempel efternavn og pasnummer), i en tredje — ofte ændrede (for eksempel leveringsadresse, kategori, dato for den seneste ordre osv.). Versioneringen føres på niveauet af de enkelte satellitter og ikke entiteten som helhed, så fordelingen af attributter er hensigtsmæssig at foretage, så overgangen mellem versioner inden for en satellit er minimal (hvilket reducerer det samlede antal gemte versioner).
Desuden, for at optimere dataindlæsningsprocessen, udskilles ofte attributter, der modtages fra forskellige kilder, i separate satellitter.
Satellitterne forbindes med hub'en via fremmednøgler (hvilket svarer til kardinaliteten 1-til-mange). Det betyder, at flere værdier af attributter (for eksempel flere kontakttelefonnumre for én kunde) understøttes som standard af denne arkitektur.
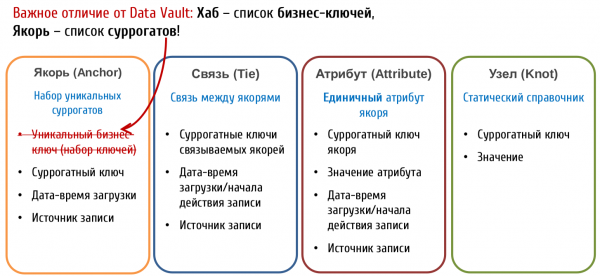
I Anker modellen (Anchor Model) tabeller, der opbevarer nøglerne, kaldes Ankre (Anchor). Og de opbevarer:
- Kun surrogatnøgler
- Reference til kilde
- Tidspunkt for oprettelse af post
Naturlige nøgler betragtes i Anker Modellen som almindelige attributter. Denne variant kan synes mere kompleks at forstå, men den giver meget mere plads til identifikation af objektet.
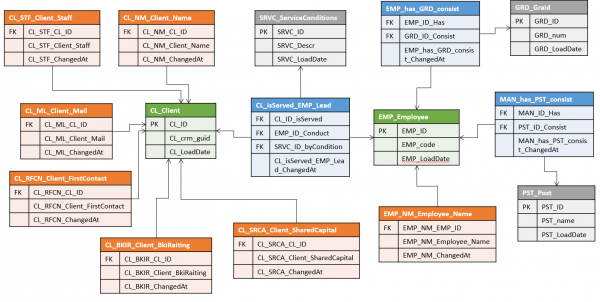
For eksempel, hvis data om den samme enhed kan komme fra forskellige systemer, hvor hver bruger sin egen naturlige nøgle. I Data Vault kan dette føre til ret besværlige opbygninger af flere hubs (én per kilde + en sammenbindende master-version), mens i Anker-modellen indgår den naturlige nøgle fra hver kilde i sin egen attribut og kan bruges ved indlæsning uafhængigt af alle andre.
Men her gemmer sig et snedigt punkt: hvis attributter fra forskellige systemer kombineres i en enhed, er der sandsynligvis nogle regler for 'sammenkvalificering', hvor efter systemet skal forstå, at poster fra forskellige kilder svarer til en enkelt instans af enheden.
I Data Vault Disse regler vil sandsynligvis definere dannelsen af 'surrogathub'en' af master-enheden og vil på ingen måde påvirke Hubs, der opbevarer de naturlige nøgler fra kilderne og deres oprindelige attributter. Hvis reglerne for sammenkvalificering ændres på et tidspunkt (eller en opdatering af attributterne, der anvendes til den, kommer), vil det være tilstrækkeligt at omstrukturere surrogat-hubbene.
I Anker-modellen vil derimod sandsynligvis opbevare en sådan enhed i den eneste anker.Det betyder, at alle attributter, uanset hvilken kilde de er hentet fra, vil blive knyttet til den samme surrogat. At adskille fejlagtigt sammenkoblede poster og generelt overvåge aktualiteten af sammenkvalificeringen i et sådant system kan vise sig at være betydeligt sværere, især hvis reglerne er relativt komplekse og ofte ændres, og den samme attribut kan fås fra forskellige kilder (selvom det bestemt er muligt, da hver version af attributten gemmer en reference til sin kilde).
Under alle omstændigheder, hvis din system forudser implementeringen af funktionalitet deduplicering, sammenlægning af poster og andre MDM-elementer, er det værd at se særligt nøje på aspekterne af opbevaring af naturlige nøgler i fleksible metodologier. Det er sandsynligt, at den mere besværlige Data Vault-struktur pludselig viser sig at være mere sikker i forhold til fejl ved sammenlægning.
Anker-modellen forudser også en ekstra type objekt kaldet Knude (Knot) som i bund og grund er en speciel degenereret form af ankeret, som kun kan have én attribut. Noderne er beregnet til at opbevare flade registre (f.eks. køn, civilstand, kundepleje kategori osv.). I modsætning til Anker, har Nodens ikke tilknyttede attributtabeller, og dens eneste attribut (navn) gemmes altid i én tabel med nøglen. Noderne forbindes med Anker tilknyttede mellemtabeller (Tie) på samme måde som ankerne imellem hinanden.
Der er ikke en entydig holdning til brugen af Noder. For eksempel, , som aktivt fremmer brugen af Anker-modellen i Rusland, mener (ikke uden grund), at der for ingen registre kan fastslås, at det altid vil være statisk og enkelt niveau, så for alle objekter er det bedre straks at bruge et fuldt Anker.
En anden vigtig forskel mellem Data Vault og Anker-modellen er tilstedeværelsen af attributter ved relationer:
I Data Vault Relationer er lige så fuldgyldige objekter som Hubs og kan have egne attributter. I Anker-modellen Relationer bruges kun til at forbinde Anker og kan ikke have egne attributter. Denne forskel giver væsentligt forskellige tilgange til modellering af fakta, hvilket vil blive diskuteret senere.
Opbevaring af fakta
Indtil nu har vi hovedsageligt talt om modellering af dimensioner. Med fakta er situationen lidt mindre entydig.
I Data Vault et typisk objekt til opbevaring af fakta er Relation (Link), hvor Satellitterne opsamler de konkrete målinger.
Denne tilgang virker intuitivt forståelig. Den giver nem adgang til de analyserede målinger og ligner generelt en traditionel faktatabel (kun målingerne opbevares ikke i selve tabellen, men i den 'nabo'). Men der er også faldgruber: en typisk tilpasning af modellen — udvidelse af faktanøglen — kræver tilføjelse af en ny udenlandsk nøgle i Link. Og dette 'bryder' modulariteten og kan potentielt kræve tilpasninger af andre objekter.
I Anker-modellen Relationen kan ikke have egne attributter, så denne tilgang vil ikke være bæredygtig — absolut alle attributter og målinger skal være bundet til et specifikt anker. Konklusionen er simpel — for hvert faktum er der også behov for sit eget anker. For some of what we consider facts, this might seem natural — for example, the fact of a purchase easily reduces to the “order” or “receipt” object, and visiting a website corresponds to a session, etc. However, there are also facts for which finding such a natural “object carrier” is not so straightforward — for instance, the stock levels in warehouses at the start of each day.
Consequently, there are no issues with modularity when expanding the fact key in the Anchor model (it’s simply enough to add a new Relationship to the corresponding Anchor), but the design of the model to display facts is less straightforward; “artificial” Anchors may appear, representing a business object model in a non-obvious way.
How flexibility is achieved
The resulting construct in both cases contains significantly more tables, than traditional measures. But it can occupy significantly less disk space with the same set of versioned attributes as traditional measures. There’s no magic here, of course — it’s all about normalization. By distributing attributes across Satellites (in Data Vault) or separate tables (Anchor Model), we reduce (or completely eliminate) the duplication of values of certain attributes when others are changed..
For Data Vault The gain will depend on the distribution of attributes across Satellites, and for Anker-modellen — it’s practically directly proportional to the average number of versions per measurement object.
However, the space-saving advantage is important, but not the main advantage of separate storage of attributes. Along with the separate storage of relationships, this approach makes the repository a modular structure.This means that adding both individual attributes and entire new subject areas to such a model looks like an extension over the existing set of objects without changing them. And this is precisely what makes the described methodologies flexible.
This also resembles the transition from piece production to mass production — if in the traditional approach each table of the model is unique and requires individual attention, then in flexible methodologies, it is already a set of standard “parts.” On one hand, there are more tables, and the processes of data loading and querying must appear more complex. On the other — they become standardized.Which means they can be automatiserede og styres af metadata. Spørgsmålet "hvordan skal vi klare det?", hvis svar kunne tage en væsentlig del af arbejdet med designet af ændringerne, er nu simpelthen ikke relevant (ligesom spørgsmålet om, hvordan ændringen af modellen påvirker de fungerende processer).
Det betyder ikke, at analytikere i et sådant system slet ikke er nødvendige — nogen skal stadig arbejde med et sæt objekter og attributter og finde ud af, hvor og hvordan alle disse data skal indlæses. Men omfanget af arbejdet samt sandsynligheden og prisen for fejl reduceres betydeligt. Både i analysen og ved udvikling af ETL, som i væsentlig grad kan reduceres til redigering af metadata.
Den mørke side
Alt det ovenstående gør begge tilgange virkelig fleksible, teknologiske og egnede til iterativ udvikling. Selvfølgelig er der også en "fætter modbydelighed", som jeg tror, du allerede har en fornemmelse af.
De-kompositionen af data, som ligger til grund for modulariteten i fleksible arkitekturer, fører til en stigning i antallet af tabeller og derfor overhead for joins ved forespørgsel. For blot at få alle attributterne til en dimension er det i et klassisk datalager tilstrækkeligt med en enkelt SELECT, mens en fleksibel arkitektur kræver en hel række joins. Og hvis disse joins kan skrives på forhånd til rapporterne, vil analytikere, der er vant til at skrive SQL selv, lide dobbelt.
Der er flere fakta, der letter denne situation:
Når man arbejder med store dimensioner, bruges næsten aldrig alle dets attributter på én gang. Det betyder, at antallet af joins kan være mindre, end det umiddelbart ser ud til, når man ser på modellen. I Data Vault kan man også tage højde for den forventede hyppighed af samtidig brug ved at fordele attributter på satellitter. Selve Hub eller Anker er primært nødvendige til generering og kortlægning af surrogate på indlæsningsstadiet og bruges sjældent i forespørgsler (især gælder dette for Anker).
Alle joins — efter nøgle. Desuden reducerer en "komprimeret" datastruktur omkostningerne ved at scanne tabeller, hvor det er nødvendigt (f.eks. ved filtrering efter attribut-værdi). Dette kan medføre, at forespørgsler fra en normaliseret database med mange joins endda kan være hurtigere end at scanne en enkelt tung dimension med mange versioner pr. række.
For eksempel er der i artiklen en detaljeret sammenligningstest af præstationen for Anchor-modellen med forespørgsler fra en enkelt tabel.
Meget afhænger af motoren. Mange moderne platforme har interne mekanismer til optimering af joins. For eksempel kan MS SQL og Oracle "springe" joins over til tabeller, hvis deres data ikke bruges andre steder end i andre joins og ikke påvirker den endelige forespørgsel (table/join elimination), mens MPP Vertica ifølge , har vist sig at være en fremragende motor til Anchor-modellen med lidt manuel optimering af forespørgselsplanen. På den anden side virker det ikke som en god idé at lagre Anchor-modellen på Click House, som har begrænset support for joins.
Derudover findes der specielle teknikker, der letter adgangen til data (både hvad angår forespørgselspræstation og slutbrugere). For eksempel Point-In-Time-tabeller i Data Vault eller specialiserede tabel-funktioner i Anchor-modellen.
I alt
Essensen af de nævnte fleksible arkitekturer ligger i modulariteten i deres "konstruktion".
Netop denne egenskab gør det muligt at:
- Efter en initial forberedelse, der involverer udrulning af metadata og skrivning af grundlæggende ETL-algoritmer, hurtigt levere den første løsning til kunden i form af et par rapporter, der indeholder data fra blot nogle få datakilder. Det er ikke nødvendigt at tænke hele objektmodellen grundigt igennem (selv på et overordnet niveau) for dette.
- Datamodellen kan begynde at arbejde (og være nyttig) med bare 2-3 objekter, og derefter gradvist vokse (i forhold til Anchor-modellen anvendte Nikolaj De fleste tilpasninger, herunder udvidelse af emneområdet og tilføjelse af nye datakilder,
- påvirker ikke eksisterende funktionalitet og udgør ikke en risiko for at ødelægge noget, der allerede fungerer. не затрагивает существующий функционал и не вызывает опасность сломать что-то уже работающее.
- Takket være dekompositionen i standardelementer fremstår ETL-processerne i sådanne systemer ensartede, deres skrivning kan algoritmiseres og i sidste ende automatiseres.
Prisen for denne fleksibilitet er ydelse. Det betyder ikke, at det er umuligt at opnå acceptabel ydeevne med sådanne modeller. Ofte kræver det blot mere indsats og opmærksomhed på detaljer for at nå de ønskede målinger.
Applikationer
Entity-typer Data Vault
Læs mere om Data Vault:
Entity-typer Anchor Model
Læs mere om Anchor Model:
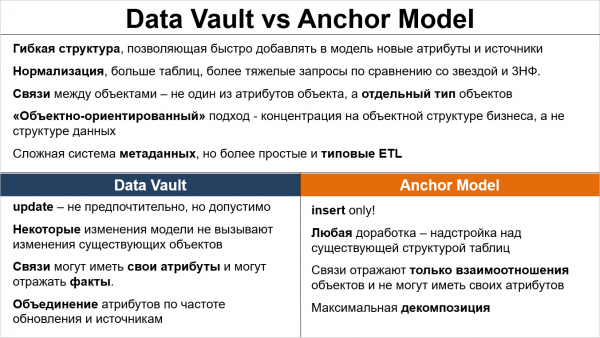
Oversigtstabel med fælles træk og forskelle på de betragtede tilgange:
Kilde: habr.com
