

Vi lever i en fantastisk tid, hvor man hurtigt og nemt kan koble flere færdige, åbne værktøjer sammen, konfigurere dem med 'slukket sind' baseret på råd fra stackoverflow, uden at gå ind i 'mange bogstaver', og sætte dem i kommerciel drift. Og når der er behov for at opdatere/udvide, eller nogen tilfældigt genstarter et par maskiner — at indse, at der er begyndt en eller anden påtrængende skør drøm i virkeligheden, alt er pludselig blevet ugenkendeligt kompliceret, der er ingen vej tilbage, fremtiden er uklar og sikrere, i stedet for at programmere, at holde bier og lave ost.
Ikke for ingenting, har mere erfarne kolleger med frodighed af bugs og derfor allerede grå hår, når de betragter det usandsynligt hurtige deployment af stakke af 'containere' i 'terninger' på dusinvis af servere med 'moderne sprog' med indbygget støtte til asynkron ikke-blokerende input-output — beskedent smiler. Og stille fortsætter de med at læse 'man ps', fordyber sig indtil øjnene bløder i kildekoden til 'nginx' og skriver-skriver-skriver enhedstest. Kollegerne ved, at det mest interessante vil komme senere, når 'alt dette' en nat bliver til noget uforudset ved nytår. Og kun en dyb forståelse af unix-naturen, den indlærte TCP/IP-tilstandstabel og grundlæggende sorterings- og søgealgoritmer kan hjælpe dem med at genoplive systemet ved klokken tolv.
Åh, ja, lidt afveksling, men jeg håber, at jeg fik overbragt fornemmelsen af forventning.
I dag vil jeg dele vores erfaring med at implementere et praktisk og billigt stack til DataLake, der løser de fleste analytiske opgaver i virksomheden for helt forskellige afdelinger.
For nogen tid siden indså vi, at virksomhederne i stigende grad har brug for resultatet af både produkt- og teknisk analyse (for ikke at nævne kirsebær på kagen i form af maskinlæring), og for at forstå trends og risici — er det nødvendigt at indsamle og analysere flere og flere metrikker.
Grundlæggende teknisk analyse i 'Bitrix24'
For several years now, alongside the launch of the "Bitrix24" service, we have actively invested time and resources in creating a simple and reliable analytical platform that helps quickly identify problems in the infrastructure and plan the next steps. Naturally, it was preferable to use ready-made tools that were as simple and understandable as possible. As a result, we chose Nagios for monitoring and Munin for analytics and visualization. Now we have thousands of checks in Nagios, hundreds of graphs in Munin, and our colleagues use them daily and successfully. The metrics are clear, the graphs are understandable, the system has been running reliably for several years, and new tests and graphs are regularly added: when we introduce a new service, we add several tests and graphs. Safe travels.
Keeping a Finger on the Pulse - Advanced Technical Analytics
The desire to receive information about issues "as quickly as possible" led us to actively experiment with simple and understandable tools—Pinba and XHProf.
Pinba sent us statistics about the speed of PHP web page components in UDP packets, allowing us to view a short list of issues in the MySQL storage (Pinba comes with its own MySQL engine for fast event analytics) in real-time and respond accordingly. Meanwhile, XHProf automatically allowed us to gather execution graphs of the slowest PHP pages from clients and analyze what might have caused this—calmly, while enjoying tea or something stronger.
Some time ago, our toolkit was supplemented with another quite simple and understandable engine based on the inverse indexing algorithm, excellently implemented in the legendary Lucene library—Elastic/Kibana. The simple idea of multi-threaded document recording into Lucene's inverted index based on log events and quick searches using faceted search turned out to be genuinely useful.
Despite the rather technical appearance of visualizations in Kibana, with low-level concepts like "bucket" and a rediscovered language of the long-forgotten relational algebra—this tool has helped us well in the following tasks:
- How many PHP errors did the Bitrix24 client have on portal p1 in the last hour, and what were they? To understand, forgive, and quickly fix.
- Hvor mange videoopkald blev der foretaget på portalerne i Tyskland i de sidste 24 timer, hvilken kvalitet havde de, og var der nogen problemer med kanalen/netværket?
- Hvor godt fungerer systemfunktionaliteten (vores C-udvidelse til PHP), som blev kompileret fra kildekoden i den seneste opdatering af tjenesten og rullet ud til kunderne? Er der ikke nogen segfaults?
- Bliver kundedata gemt i PHP's hukommelse? Er der ikke nogen fejl med overskridelse af den allokerede hukommelse: «out of memory»? Find og neutraliser.
Her er et konkret eksempel. På trods af grundig og flerlagstestning, opstod der en irriterende og uventet fejl hos kunden under et meget usædvanligt scenarie med beskadigede inddata, alarmen gik, og processen med hurtig rettelse blev iværksat:
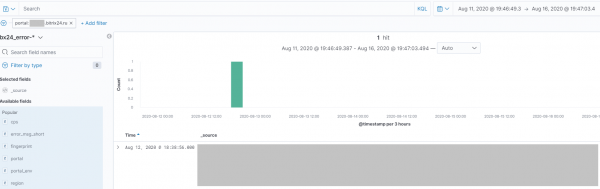
Derudover giver Kibana mulighed for at organisere advarsler for bestemte hændelser, og på kort tid blev værktøjet taget i brug af dusinvis af medarbejdere fra forskellige afdelinger - fra support og udvikling til QA.
Aktiviteten i enhver afdeling inden for virksomheden er blevet let at overvåge og måle - i stedet for manuel analyse af serverlogfiler, er det tilstrækkeligt at opsætte logparsing og deres sendelse til Elastic-klyngen én gang for at nyde, for eksempel at betragte på Kibana-dashboardet, antallet af solgte tohovede katte, der blev printet på 3D-printer i den sidste måneds cyklus.
Grundlæggende forretningsanalyse
Alle ved, at forretningsanalysen i virksomheder ofte starter med ekstremt aktiv brug af, ja, ja, Excel. Men vigtigst af alt, at den ikke slutter der. Det skader ikke at hælde lidt olie på bålet med cloud-baseret Google Analytics - man vænner sig hurtigt til det gode.
I vores harmonisk udviklende virksomhed begyndte der at opstå 'profeter' for mere intensivt arbejde med større data. Behovet for dybere og mere mangfoldige rapporter dukkede regelmæssigt op, og takket være indsatsen fra folk fra forskellige afdelinger blev der for nogen tid siden organiseret en simpel og praktisk løsning - en kobling mellem ClickHouse og PowerBI.
I lang tid hjalp denne fleksible løsning os meget, men gradvist kom der en forståelse af, at ClickHouse ikke er elastisk, og man kan ikke misbruge det.
Det er vigtigt at forstå godt, at ClickHouse, ligesom Druid, Vertica og Amazon RedShift (som er baseret på Postgres), er analytiske motorer, der er optimeret til ret praktisk analyse (summationer, aggregationer, minimum-maximum på kolonner og lidt join), da de er organiseret til effektiv opbevaring af kolonnerne i relationelle tabeller, i modsætning til det velkendte MySQL og andre (row-oriented) databaser.
I bund og grund er ClickHouse blot en mere rummelig "database", med ikke så praktisk punktvis indsættelse (det er sådan, det er designet, alt er i orden), men med en behagelig analyse og en række interessante kraftfulde funktioner til arbejde med data. Ja, man kan endda oprette et cluster — men du forstår, at det ikke er helt korrekt at slå søm i med et mikroskop, så vi begyndte at lede efter andre løsninger.
Efterspørgslen efter Python og analytikere
I vores virksomhed er der mange udviklere, der skriver kode næsten hver dag i 10-20 år i PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash. Der er også mange erfarne systemadministratorer, der har overlevet mere end en fuldstændig usædvanlig katastrofe, der ikke kan forklares med statistik (for eksempel når de fleste diske i raid-10 bliver ødelagt ved et kraftigt lynnedslag). Under sådanne forhold var det længe uklart, hvad en "analytiker i Python" egentlig var. Python er ligesom PHP, blot med et lidt længere navn og færre spor af stoffer, der ændrer bevidstheden, i kildekoden til fortolkerens. Men efterhånden, som der blev skabt flere og flere analytiske rapporter, blev erfarne udviklere mere og mere opmærksomme på vigtigheden af snævre specialiseringer i værktøjer som numpy, pandas, matplotlib, seaborn.
Den afgørende rolle blev sandsynligvis spillet af pludselige besvimelser blandt medarbejderne ved kombinationen af ordene "logistisk regression" og demonstrationen af effektiv rapportbygning på store datamængder ved hjælp af, ja, pyspark.
Apache Spark, dets funktionelle paradigme, som passer perfekt til relationel algebra og dets muligheder, gjorde et så stort indtryk på udviklerne, der var vant til MySQL, at behovet for at forstærke de erfarne analytikere blev klart som dagen.
Yderligere forsøg på, at Apache Spark/Hadoop kunne få succes og hvad der ikke gik helt efter planen
Men blev det hurtigt klart, at der åbenbart var noget systematisk galt med Spark, eller at man blot skulle være bedre til at vaske hænder. Hvis Hadoop/MapReduce/Lucene-stakken blev lavet af tilstrækkeligt erfarne programmører, noget der er indlysende, hvis man ser nærmere på Java-kildeteksterne eller Doug Cutting’s idéer i Lucene, så er Spark pludselig skrevet i et meget omstridt sprog, Scala, som set fra en praktisk synsvinkel ikke rigtig er i udvikling. Regelmæssige nedbrud af beregninger på Spark-klyngen på grund af den illogiske og ikke særlig gennemsigtige håndtering af hukommelse under reduce-operationer (mange nøgler ankommer pludselig) har givet det et ry som noget, der har potentiale til at vokse. Ydermere forværrede et stort antal mærkelige åbne porte, midlertidige filer, der voksede på de mest uforståelige steder, og adskillige jar-afhængigheder situationen – hvilket fremkaldte et velkendt og barndomsagtigt følelser blandt systemadministratorer: en frygtelig had (eller måske skulle man have været bedre til at vaske hænder med sæbe).
Vi har derfor "overlevet" flere interne analytiske projekter, der aktivt benytter Apache Spark (herunder Spark Streaming, Spark SQL) og Hadoop-økosystemet (og meget andet). Selvom vi med tiden har lært at "tilberede" dette temmelig godt og overvåge det, og "det" praktisk talt er holdt op med at falde pludseligt på grund af ændringer i datakarakteren og ubalanceret jævn hashing af RDD, voksede ønsket om at anvende et færdigt, opdateret og administreret system et eller andet sted i skyen bare stærkere og stærkere. Det var netop på dette tidspunkt, at vi forsøgte at bruge den færdige cloud-løsning fra Amazon Web Services — og forsøgte derefter at løse opgaverne på den. EMR er Amazons version af Apache Spark med ekstra software fra økosystemet, omtrent som Cloudera/Hortonworks-opstillingerne.
Et "gummihåndtering" filopbevaringssystem til analytiske behov – en akut nødvendighed
Erfaringen med at "tilberede" Hadoop/Spark med forskellige forbrændinger er ikke gået tabt. Behovet for at skabe et enkelt, billigt og pålideligt filopbevaringssystem er blevet mere og mere klart, et system der ville være modstandsdygtigt over for hardwarefejl, og hvor man kunne opbevare filer i forskellige formater fra forskellige systemer og udføre effektive dataudtræk til rapporter inden for rimelig tid.
Det ville også være rart, hvis opdateringen af softwaren på denne platform ikke blev til et nytårsmareridt med at læse 20-siders Java-tracebacks og analysere kilometerlange detaljerede logfiler fra klyngens Spark History Server ved hjælp af en lup. Man ønsker et simpelt og gennemskueligt værktøj, der ikke kræver, at man regelmæssigt skal nørde under motorhjelmen, hvis en standard MapReduce-forespørgsel ophører med at fungere, når reduktionsdataene fra en worker falder ud af hukommelsen på grund af et ikke særligt godt valgt partitioneringsalgoritme til de oprindelige data.
Er Amazon S3 en kandidat til DataLake?
Erfaringen med Hadoop/MapReduce har lært mig, at der er behov for en skalerbar og pålidelig filsystem og skalerbare workere, der "kommer" tættere på dataene, så man ikke skal overføre dataene gennem netværket. Workerne skal være i stand til at læse data i forskellige formater, men helst ikke læse unødvendige oplysninger, og der bør være en mulighed for at gemme data i formater, der er bekvemme for workerne.
En gang til – den grundlæggende idé. Der er ikke lyst til at "læsse" store data ind i en enkelt klyngeanalytisk motor, som alligevel før eller siden vil kvæles, og man bliver nødt til at shard'ere det på en grim måde. Man ønsker at gemme filer, bare filer, i et forståeligt format og udføre effektive analytiske forespørgsler med forskellige, men forståelige værktøjer. Og antal filer i forskellige formater vil stige. Og det er bedre at shard'e de oprindelige data end motoren. Vi har besluttet, at vi har brug for en udvidelsesvenlig og universel DataLake...
Hvad hvis man gemmer filer i det velkendte og for mange kendte skalerbare sky-lager Amazon S3, uden at skulle forberede boller fra Hadoop selv?
Klart, persondata "må ikke", men hvad med andre data, hvis man kan flytte dem derhen og "effektivt køre" dem?
Den kluster-baserede big data-analytiske økosystem Amazon Web Services – meget enkelt sagt
Ifølge vores erfaring med AWS har Apache Hadoop/MapReduce længe været aktivt brugt under forskellige former, for eksempel i service DataPipeline (jeg misundrer kollegerne, de har lært at forberede det korrekt). Her har vi indstillet backups fra forskellige tjenester fra tabellerne DynamoDB:
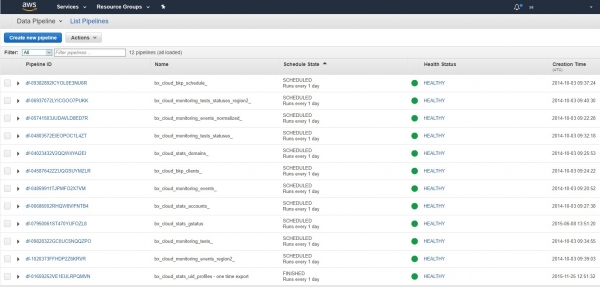
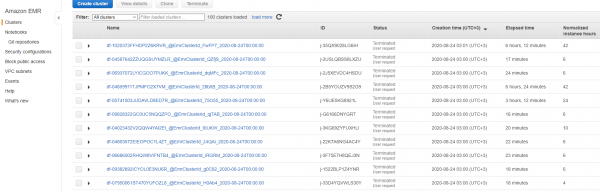
Og de udføres regelmæssigt på de indbyggede klynger af Hadoop/MapReduce som ure i flere år. "Indstillet og glemt":
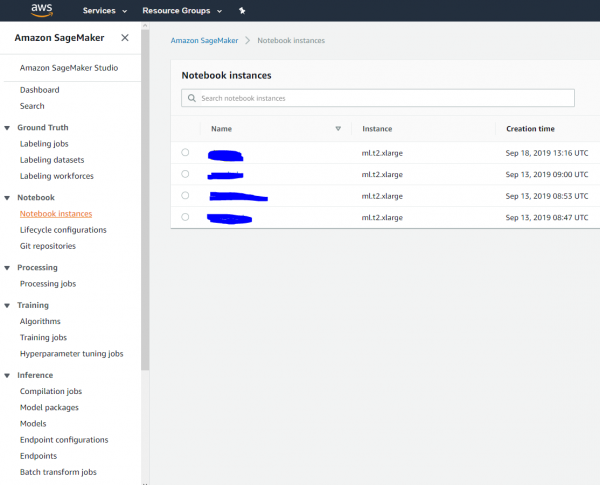
Desuden kan man effektivt arbejde med datascience ved at opsætte Jupiter-notebooks i skyen for analytikere og bruge dem til træning og implementering af AI-modeller med AWS SageMaker. Sådan ser det ud hos os:
Og ja, man kan opsætte en notebook i skyen til sig selv eller analytikeren og tilslutte den til et Hadoop/Spark-kluster, beregne og så 'lave rent':
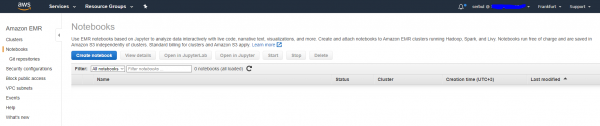
Det er virkelig praktisk til enkelte analytiske projekter, og til nogle af dem har vi med succes brugt EMR-tjenesten til storstilede beregninger og analyser. Men hvad med et systemløsning til DataLake, vil det være muligt? På dette tidspunkt var vi tæt på håb og fortvivlelse og fortsatte søgningen.
AWS Glue er en pænt pakket version af Apache Spark 'på steroider'.
Det viste sig, at AWS har sin egen version af stakken 'Hive/Pig/Spark'. Hive's rolle, altså kataloget for filer og deres typer i DataLake, varetages af 'Data catalog'-tjenesten, som ikke skjuler sin kompatibilitet med Apache Hive-formatet. Her skal man tilføje information om, hvor dine filer ligger, og i hvilket format de er. Data kan ikke kun være i s3, men også i databaser, men det er ikke emnet for dette indlæg. Sådan er DataLake-datakataloget organiseret hos os:
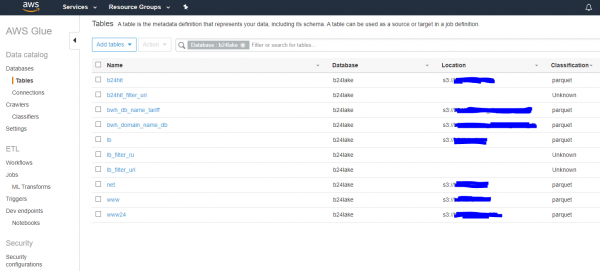
Filerne er registreret, perfekt. Hvis filer er blevet opdateret — starter vi enten manuel eller efter tidsplan crawlers, der opdaterer informationen fra søen og gemmer den. Derefter kan dataene fra søen behandles, og resultaterne kan eksporteres et sted hen. I det simpleste tilfælde eksporterer vi også til s3. Data kan behandles hvor som helst, men det anbefales at konfigurere behandlingsprocessen på et Apache Spark-kluster med udvidede funktioner via AWS Glue API. Man kan i princippet tage den gamle gode og velkendte Python-kode med pyspark-biblioteket og indstille dens udførelse på N noder i klustret af en bestemt kapacitet med overvågning, uden at skulle rode i Hadoop's indre og slæbe docker-containerne rundt og løse afhængighedskonflikter.
Endnu en gang — en simpel idé. Man skal ikke konfigurere Apache Spark, man skal blot skrive kode i Python til pyspark, teste den lokalt på skrivebordet og derefter køre den på et stort kluster i skyen, ved at angive hvor de oprindelige data ligger, og hvor resultatet skal placeres. Nogle gange er det nødvendigt og nyttigt, og sådan er det konfigureret hos os:
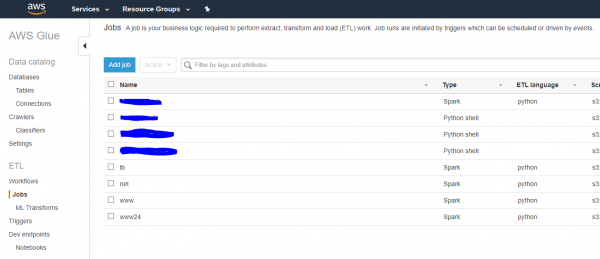
Derfor, hvis man skal beregne noget på Spark-klusteret med dataene i s3 — skriver vi Python/pyspark-koden, tester den og sender den afsted til skyen.
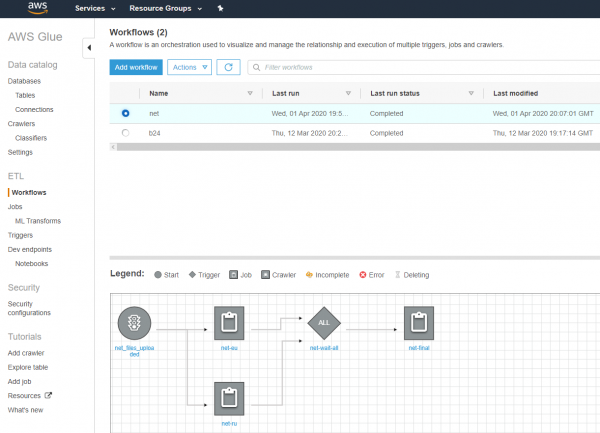
Hvad med orkestreringen? Hvad hvis opgaven falder ud og forsvinder? Ja, man foreslår at lave en flot pipeline i stil med Apache Pig, og vi har endda prøvet dem, men vi har besluttet at bruge vores dybt tilpassede orkestrering lavet i PHP og JavaScript (jeg forstår, der kan opstå kognitiv dissonans, men det virker, i årevis og uden fejl).
Formatet for de gemte filer i søen er nøglen til ydeevnen.
Det er meget, meget vigtigt at forstå endnu to nøglepunkter. For at forespørgsler om datafiler i søen kan udføres så hurtigt som muligt, og ydeevnen ikke forringes ved tilføjelse af nye oplysninger, skal man:
- Opbevare kolonnerne i filer separat (så man ikke skal læse alle rækker for at forstå, hvad der er i kolonnerne). Til dette har vi valgt parquet-formatet med komprimering.
- Det er meget vigtigt at shard'e filer i mapper i stil med: sprog, år, måned, dag, uge. Motorer, der forstår denne type sharding, vil kun kigge i de nødvendige mapper i stedet for at skulle håndtere alle dataene på én gang.
I princippet lægger man på denne måde de oprindelige data ud på den mest effektive måde til de analytiske motorer ovenover, som også kan tilgå sharded mapper og kun læse de nødvendige kolonner fra filerne. Der er ingen grund til at "indlejre" data andre steder (for opbevaringen vil simpelthen briste) — læg dem bare straks fornuftigt i filsystemet i det rigtige format. Selvfølgelig bør det være klart, at det ikke er særlig fornuftigt at gemme en kæmpe csv-fil i DataLake, som først skal læses linje for linje af klyngen for at udtrække kolonnerne — overvej de to ovenstående punkter endnu en gang, hvis du stadig ikke forstår, hvorfor alt dette er nødvendigt.
AWS Athena — "djævelen" fra tobaksdåsen.
Og her, mens vi opretter en sø, stødte vi på Amazon Athena. Det viste sig pludselig, at ved omhyggeligt at organisere vores enorme logfiler i sharder-mapper i det rigtige (parquet) kolonneformat, kan man meget hurtigt lave yderst informative udtræk og generere rapporter UDEN, uden en Apache Spark/Glue-klynge.
Motoren Athena, der arbejder med data i s3, er baseret på den legendariske — en repræsentant for MPP (massive parallel processing) tilgangene til databehandling, der henter data, hvor de ligger, fra S3 og Hadoop til Cassandra og almindelige tekstfiler. Man skal bare bede Athena om at udføre en SQL-forespørgsel, så „fungerer det hurtigt og af sig selv“. Det er vigtigt at bemærke, at Athena er „intelligent“, den går kun ind i de nødvendige sharded mapper og læser kun de relevante kolonner i forespørgslen.
Forespørgsler til Athena prissættes også interessant. Vi betaler for . Det vil sige, det er ikke prisen pr. maskine i klyngen pr. minut, men… for de reelt scannede data, der er nødvendige for at udføre forespørgslen på 100-500 maskiner.
Og ved kun at anmode om de nødvendige kolonner fra de korrekt sharded mapper, viste det sig, at Athena-tjenesten koster os kun et par hundrede dollars om måneden. Det er jo fantastisk, næsten gratis sammenlignet med analyse på klynger!
Her er, hvordan vi sharder vores data i S3:
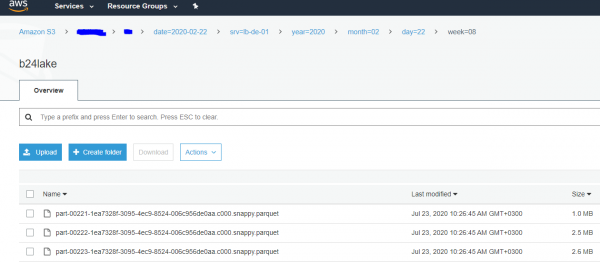
Som et resultat af dette begyndte forskellige afdelinger i virksomheden, fra informationssikkerhed til analyse, hurtigt at lave forespørgsler til Athena og modtage nyttige svar fra „store“ data for ret lange perioder: måneder, halve år osv.
Men vi gik videre og begyndte at hente svar i skyen : analytikeren skriver SQL-forespørgslen i det velkendte konsol, som på 100-500 maskiner „for en slik“ gennemsøger data i S3 og returnerer svaret normalt inden for få sekunder. Praktisk. Og hurtigt. Det er stadig svært at tro.
Som følge af beslutningen om at opbevare data i S3 i et effektivt kolonneformat med fornuftig sharding af data i mapper… har vi fået et DataLake og en hurtig og billig analytisk motor – gratis. Og den er blevet meget populær i virksomheden, da den forstår SQL og fungerer væsentligt hurtigere end gennem opstart/stoppelse/konfiguration af klynger. „Og hvis resultatet er det samme, hvorfor betale mere?“
En forespørgsel til Athena ser omtrent sådan ud. Hvis ønskes, kan man naturligvis formulere en temmelig , men vi vil nøjes med en simpel gruppering. Lad os se, hvilke svarkoder kunden havde for et par uger siden i webserverens logfiler og sikre os, at der ikke er nogen fejl:
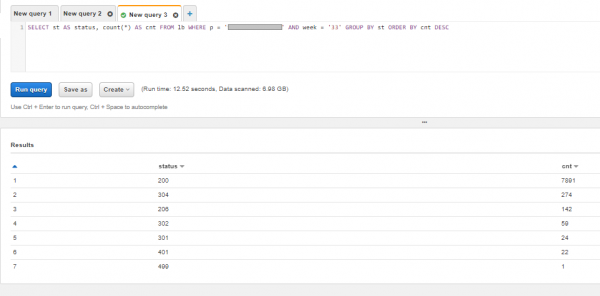
Konklusioner
Efter at have gennemgået en ikke så lang, men smertefuld vej, konstant vurderende risici, kompleksitet og omkostninger ved vedligeholdelse, fandt vi en løsning til DataLake og analyse, som fortsat glæder os både med hastighed og ejeromkostninger.
Det viste sig, at det at bygge et effektivt, hurtigt og billigt DataLake til behovene i helt forskellige afdelinger i virksomheden er muligt selv for erfarne udviklere, der aldrig har arbejdet som arkitekter og ikke ved, hvordan man tegner firkanter med pile og kender 50 termer fra Hadoop-økosystemet.
I begyndelsen gjorde det ondt i hovedet fra mængden af vilde open source og proprietære værktøjer og ansvaret overfor de kommende generationer. Begynd blot at bygge dit DataLake fra de enkleste værktøjer: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3 …, indsamle feedback og forstå fysikken i de forekommende processer. Lad alt det komplicerede og uklare gå til fjender og konkurrenter.
Hvis du ikke vil i skyen og kan lide at vedligeholde, opdatere og patch'e open source-projekter, kan du bygge et lignende setup lokalt på billige kontormaskiner med Hadoop og Presto ovenpå. Det vigtigste er ikke at stoppe, men at fortsætte fremad, regne, finde simple og klare løsninger, og så vil det helt sikkert lykkes! Held og lykke til alle, og vi ses igen!
Kilde: habr.com
