

Vi gennemgår grundlæggende logning i Docker og Kubernetes og ser derefter på to værktøjer, der kan anvendes i produktionen: Grafana Loki og EFK-stakken (Elasticsearch + Fluent Bit + Kibana).
Materialet i artiklen er et uddrag fra . Hvis der er interesse, og endnu mere volumen skal der til, kan man tage et fuldt kursus — tilmeld dig kursuset om .
Logning i Docker
På Kubernetes-niveauet køres applikationer i pods, men på et lavere niveau fungerer de stadig typisk i Docker. Derfor skal logning konfigureres således, at logs indsamles fra containere. Containere startes af Docker — derfor skal man forstå, hvordan logning fungerer på Docker-niveauet.
Jeg håber, at hver læser ved: applikationens logs skal skrives til stdout/stderr, og ikke ind i containeren. Logs aggregeres af Docker Daemon, og den arbejder kun med de logs, der sendes til stdout/stderr. Derudover kan det at skrive logs ind i containeren føre til problemer: containeren bliver tung af de voksende logs (da der formentlig ikke er nogen Logrotate i containeren), og Docker Daemon har ikke kendskab til denne log.
Docker har flere logdrivere eller plugins til at samle logs fra containere. I den gratis Docker Community Edition (CE) er der færre logdrivere end i den kommercielle Docker Enterprise Edition (EE).
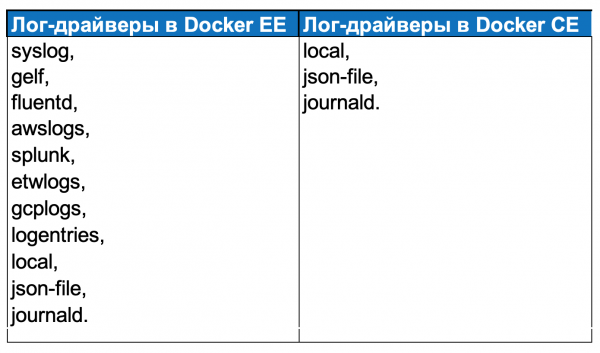
Jeg har aldrig brugt Docker EE i praksis: hos Southbridge forsøger vi at holde os til Open Source-løsninger, og de fleste af de ekstra funktioner i Docker EE er ikke nødvendige for kunderne.
Logdrivere i Docker CE:
local — registrering af logs i Docker Daemons interne filer;
json-file — oprettelse af json-log i hver containers mappe;
journald — sending logs til journald.
Indstillingerne for logning i Docker findes i filen daemon.json.
I feltet "log-driver" angiver man pluginet, og i feltet "log-opts" angiver man dets indstillinger. I eksemplet ovenfor er pluginet "json-file" angivet, logstørrelsesgrænsen er "max-size": "10m"; grænsen for antallet af filer (roteringsindstillinger) er "max-file": "3"; samt værdier, der vil blive knyttet til logs.
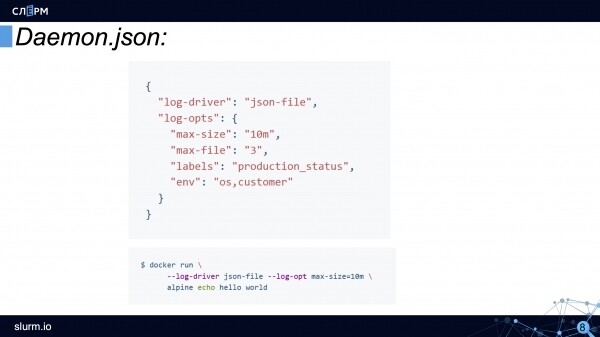
Nogle indstillinger for logdrivere kan angives via kommandolinjeværktøjet. Dette er praktisk, hvis en bestemt container skal startes med en anden logdriver.
Sådan ser logningsskemaet i Docker ud:
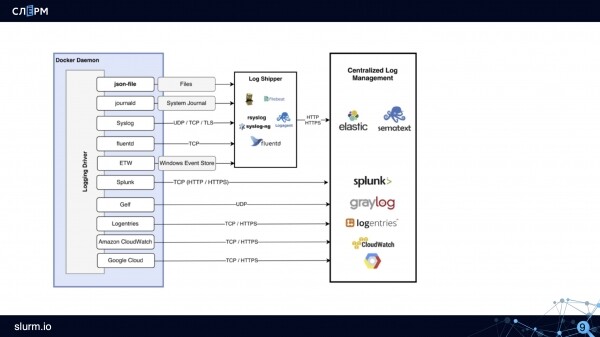
Hvordan skemaet fungerer: log-driveren, for eksempel json-file, opretter filer. Log-samlere (Rsyslog, Fluentd, Logagent og andre) indsamler disse filer og sender dem til opbevaring i Elastic, Sematext eller andre lagringssteder.
Funktioner ved logning i Kubernetes
Forenklet ser logningsskemaet i Kubernetes således ud: der er en pod, i hvilken der kører en container, containeren sender logs til stdout/stderr. Derefter opretter Docker en fil og registrerer loggene, som derefter kan roteres.
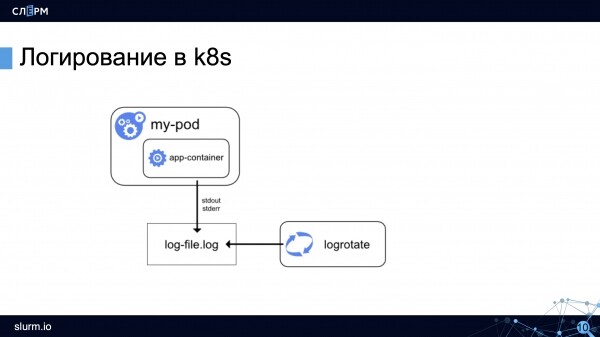
Lad os se på funktionerne ved logning i Kubernetes.
Bevare loggene mellem deployment. Det er et obligatorisk krav for korrekt konfiguration af logning. Hvis loggene ikke bevares mellem deployment, vil de tidligere logs blive overskrevet ved udgivelsen af en ny version af applikationen, og genstart af containeren vil også medføre tab af logs. Kubernetes har en nøgle —previous, som gør det muligt at se logs for applikationen før den seneste genstart af Pod, men ikke dybere.
Aggregere logs fra alle instanser. Hvis mikrotjenesterne hostes i skyen, er det cloud-udbyderen, der står for systemovervågningen. Hvis mikrotjenesterne kører på egen hardware, skal man ud over logs fra containerne også samle systemlogs.
Tidligere var der ikke gode værktøjer til at indsamle logs fra både systemet og mikrotjenesterne. Som regel indsamlede et værktøj systemlogs (for eksempel Rsyslog), mens et andet indsamlede logs fra Docker (for eksempel journal-bit med log-driver-konfigurationen indstillet til journald). Man prøvede at bruge journal-bit — til at indsamle logs fra både containerne (i log-driveren fra Docker angive, at logs skal skrives til journald) og fra systemet (i CentOS 7 er der allerede systemd og journald). Løsningen er funktionel, men ikke perfekt. Hvis der er mange logs, begynder journal-bit at lagge, og beskeder går tabt.
Eksperimenterne fortsatte — og der blev fundet en anden metode. I CentOS 7 bliver de primære systemlogs (messages, audit, secure) duplikeret i var-logs i filform. I Docker kan man også konfigurere loggene til at blive gemt i json-filer. Derfor kan disse filer fra CentOS 7 og Docker samles sammen.
Over tid blev løsningen ELK Stack populær. Det er en kombination af flere værktøjer: Elasticsearch, Logstash og Kibana.
Elasticsearch gemmer logs fra containerne, Logstash indsamler logs fra instanser, Kibana muliggør behandling af de indsamlede logs og opbygning af grafer baseret på dem. I nogen tid blev ELK Stack aktivt brugt, men efter min mening er dens tid ved at være forbi. Jeg vil senere forklare hvorfor.
Tilføje metadata. Pods, apps og containere kan køre hvor som helst. Desuden kan en applikation have flere instanser. Logfilerne bliver logget i et format, og vi skal forstå, hvilken replik det er, hvilken Pod der skriver, og hvilket namespace den befinder sig i. Derfor skal metadata tilføjes til logfilerne.
Parse logfiler. Det er sjovt, men omkostningerne til at understøtte loggings- og overvågningssystemet kan overstige omkostningerne til den primære applikation. Når du har ti- og hundrede tusinde logs per sekund, virker det som en selvfølge, men man skal stadig kende grænsen. En måde at finde den grænse på er at parse logfiler.
Som regel er det ikke nødvendigt at samle og gemme alle logs, man bør kun sende en del til gemmes, for eksempel logs med status 'warning' eller 'error'. Hvis det handler om logs fra nginx eller ingress-kontrollere, kan man kun sende dem til opbevaring, hvis statusen adskiller sig fra 200. Men det er ikke et universelt råd: hvis du på en eller anden måde bygger analyser baseret på logs fra Nginx, er det åbenlyst, at de skal samles.
Det anbefales ikke at filtrere logs tankeløst, fordi de filtrerede data muligvis ikke er tilstrækkelige til normal analyse. På den anden side kan det være, at analysen bør udføres ikke på log-niveau, men på niveauet for metrics. Så vil man ikke behøve at gemme hundredtusinder af linjer med kode 200. En tilgang er at få information om trafik og fejl fra metrics fra ingress-kontrollere.
Generelt skal man tænke grundigt over, hvad man ønsker at gemme, og hvor længe, fordi ellers kan man ende i en situation, hvor logningssystemet optager flere ressourcer end det primære projekt.
Der er endnu ingen standardløsning for logging. I modsætning til overvågning, hvor der er én mest almindeligt anvendte løsning, Prometheus, eksisterer der ingen standard for logging.
I denne lektion vil vi se på to værktøjer: et populært og et andet, der vinder frem. Derudover findes der andre, men vi vil ikke berøre dem i denne artikel.
Tager man højde for alle de nævnte aspekter, kan logging i Kubernetes nu fremvises i sådan en skitse:
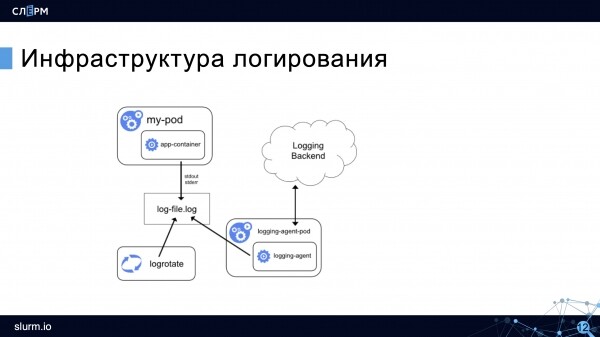
Containerens log er tilbage, rotation, men der tilføjes en agent-samler, der henter logs og sender dem til opbevaring (i skitsen - til Logging Backend). Agenten kører på hver node og er normalt startet i Kubernetes.
Lad os nu se på redskaberne til logføring.
Grafana Loki
er relativt nyt, men er allerede blevet ret kendt. Dets fordele inkluderer: nem installation, lav ressourcetræk og ingen nødvendighed for at installere Elasticsearch, da det gemmer data i en TSDB (tidsseriedatabase). I den tidligere artikel skrev jeg, at Prometheus gemmer data i sådan en database, og det er et af de mange ligheder mellem de to produkter. Udviklerne hævder endda, at Loki er "Prometheus for logverdenen."
En kort bemærkning om TSDB for dem, der ikke har læst det. : TSDB håndterer opbevaring af store mængder data og tidsserier godt, men er ikke designet til langvarig opbevaring. Hvis du af en eller anden grund skal opbevare logs i mere end to uger, er det bedre at konfigurere deres overførsel til en anden database.
En anden fordel ved Loki er, at Grafana bruges til visualisering af data. Meget praktisk: i Grafana ser vi data til overvågning, og ved at tilslutte Loki kan vi også se logs. Gennem logs kan man opbygge grafer.
Arkitekturen af Loki ser nogenlunde sådan ud:
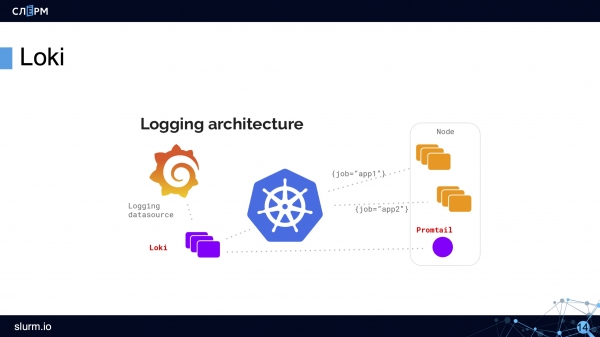
Ved hjælp af DaemonSet deployeres en agent – Promtail eller Fluent Bit – på alle servere i klyngen. Agenten indsamler logs. Loki henter disse og opbevarer dem i TSDB. Metadata tilføjes straks til logs, hvilket er praktisk: man kan filtrere efter Pods, namespaces, container-navne og endda labels.
Loki fungerer i det velkendte Grafana-interface. Loki har endda sit eget forespørgselssprog, der hedder LogQL – navngivet og syntaktisk ligesom PromQL i Prometheus. I Loki's interface er der hints med forespørgsler, så man behøver ikke at lære dem udenad.
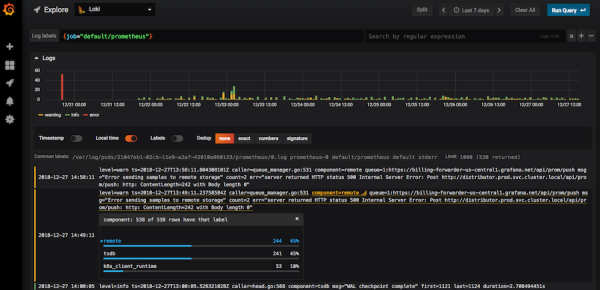
Loki i Grafana-interface
Ved at bruge filtre kan man i Loki finde koder (“400”, “404” og enhver anden); se logs fra hele noden; eller filtrere alle logs, hvor ordet “error” forekommer. Hvis man klikker på en log, åbnes et kort med alle oplysninger om begivenheden.
Loki har de nødvendige værktøjer til at trække de ønskede logs, selvom jeg ærligt talt kunne have ønsket flere tekniske funktioner. Loki udvikler sig aktivt og vinder popularitet.
Elastic + Fluent Bit + Kibana (EFK Stack)
EFK Stack er et mere klassisk, men stadig populært logføring værktøj.
I begyndelsen af artiklen blev ELK-stakken (Elasticsearch + Logstash + Kibana) nævnt, men denne stak er blevet forældet på grund af den ikke særlig effektive og samtidig ressourcekrævende Logstash. I stedet er der blevet brugt den lettere og mere effektive Fluentd, og efter et stykke tid kom der også hjælp til den. — en endnu lettere og endnu mere effektiv indsamler-agent.
Hvis man skal tro udviklerne, så er Fluent Bit mere end 100 gange bedre med hensyn til ydeevne end Fluentd: «der, hvor Fluentd bruger 20 MB RAM, vil Fluent Bit bruge 150 KB» — et direkte citat fra dokumentationen. I lyset af dette er Fluent Bit blevet brugt oftere.
Fluent Bit har færre funktioner end Fluentd, men de grundlæggende behov dækkes, så vi bruger hovedsageligt Fluent Bit.
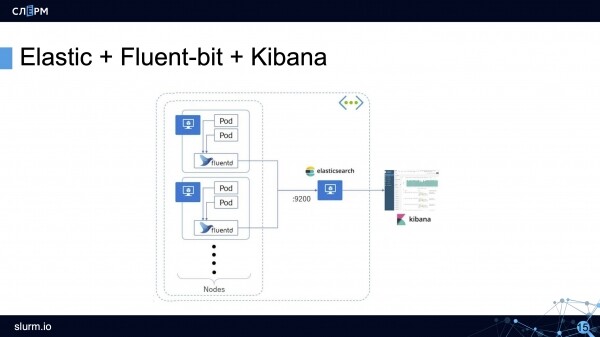
Arbejdsschemaet for EFK-stakken: agenten indsamler logs fra alle pods (normalt en DaemonSet, der kører på alle servere i klyngen) og sender dem til lageret (Elasticsearch, PostgreSQL eller Kafka). Kibana forbinder til lageret og henter alle de nødvendige oplysninger derfra.
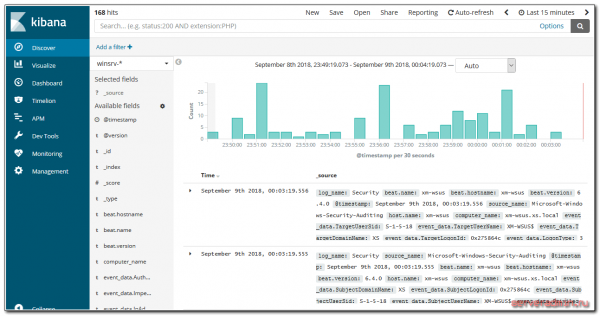
præsenterer oplysningerne i et brugervenligt webinterface. Der er diagrammer, filtre og meget mere.
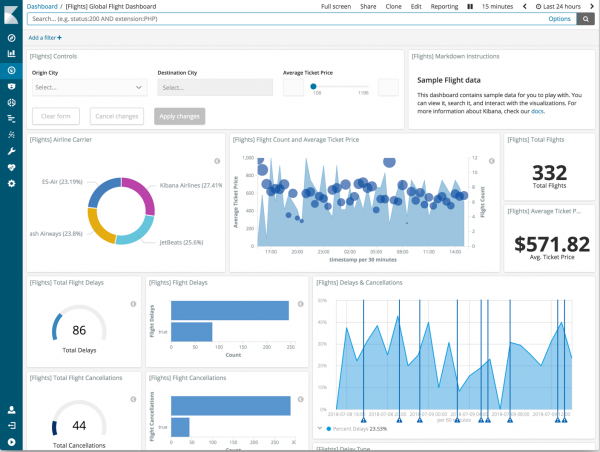
På baggrund af logs kan man oprette hele dashboards.
Mulighederne i Fluent Bit
Da Fluent Bit som regel er mindre kendt end Logstash, vil vi se nærmere på det. Fluent Bit kan logisk opdeles i 6 moduler, hvor nogle moduler kan have plugins, som udvider mulighederne for Fluent Bit.
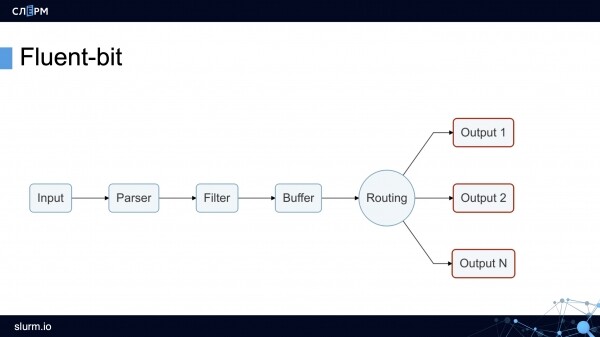
Input-modulet indsamler logs fra filer, systemd-tjenester og endda fra tcp-socket (man skal blot angive endpoint, og Fluent Bit vil begynde at hente data derfra). Disse funktioner er tilstrækkelige til at indsamle logs fra både systemet og containere.
I produktionen bruger vi oftest plugins (man kan pege den på en mappe med logs) og (man kan angive, fra hvilke tjenester der skal indsamles logs).
Parser-modulet normaliserer logs. Som standard repræsenterer Nginx-logs en streng. Ved hjælp af en plugin kan man omdanne denne streng til JSON: definere felter og deres værdier. At arbejde med JSON er meget nemmere end med streng-logs, fordi der er mere fleksible sorteringsmuligheder.
Filter-modulet. På dette niveau filtreres unødvendige logs fra. For eksempel sendes kun logs med værdien "warn" eller med bestemte labels til opbevaring. De udvalgte logs går ind i bufferen.
Buffer-modulet. Fluent Bit har to typer buffere: hukommelsesbuffer og diskbuffer. Buffered er et midlertidigt lager til logs, der er nødvendigt i tilfælde af fejl eller nedbrud. Alle ønsker at spare på RAM, så man vælger normalt diskbufferen. Men det er vigtigt at overveje, at logs stadig skrives til hukommelsen, før de går til disken.
Routing/Output-modul indeholder regler og adresser for sending af logs. Som nævnt kan logs sendes til Elasticsearch, PostgreSQL eller f.eks. Kafka.
Interessant nok kan logs fra Fluent Bit sendes til Fluentd. Da den første er lettere og mindre funktionel, kan man samle logs og sende dem til Fluentd, hvor de derefter kan behandles yderligere og sendes til lagringssystemer ved hjælp af ekstra plugins.
Hvis du planlægger at bruge Elasticsearch…
Til sidst to råd til dem, der planlægger at bruge Elasticsearch som loglager i produktion.
- Indstil alarmer ved hjælp af . Dette program udtrækker vigtige meddelelser fra den samlede logstrøm og opretter alarmer via e-mail eller en anden kanal. Dog er der for nylig kommet .
- Rotér logs ved hjælp af applikationen eller ved at tilgå Elasticsearch API. Elastic tager for alvor skridt til at styre livscyklussen af indekser uden tredjeparts værktøjer. Generelt set giver det ikke mening at opbevare logs i lang tid: Det er usandsynligt, at nogen log vil være nødvendigt efter to uger — hvis den er virkelig kritisk, vil den helt sikkert være blevet håndteret inden for to uger. I værste fald kan gamle logs arkiveres og opbevares et sted til langtidslagring. Jeg har hørt om specifikke logs, der ifølge loven skal opbevares i op til 5 år. Personligt har jeg ikke oplevet det, men jeg ville ikke sammenligne disse logs med almindelige logs, og jeg ville muligvis endda opbevare dem separat.
Fortsætter…
Forfatter: Marsel Ibraev, certificeret Kubernetes-administrator, praktiserende ingeniør i firmaet , taler og kursusudvikler .
Kilde: habr.com
