

Mange af dem, der allerede bruger — vores visualiseringstjeneste for PostgreSQL-planer, er muligvis ikke klar over en af dens superkræfter — at omdanne et svært læseligt stykke serverlog…
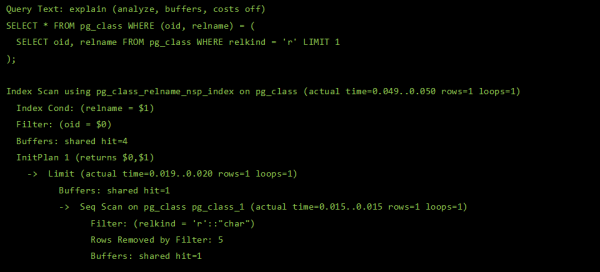
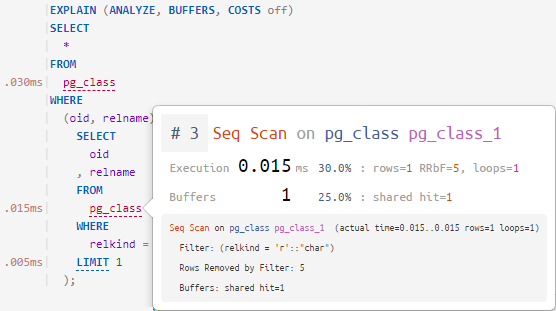
… til en velformateret forespørgsel med kontekstuelle tips til de relevante planlægningsnoder:
I denne afkodning af den anden del af sin vil jeg fortælle, hvordan vi lykkedes med det.
Transskriptionen af den første del, der handler om typiske problemer med forespørgselsydelse og deres løsninger, kan findes i artiklen .
Lad os først tage fat på farvelægningen — og vi vil ikke farvelægge planen, da vi allerede har gjort den smuk og forståelig, men forespørgslen.
Det virker som om, at et så uformateret stykke visnet fra loggen ser meget grimt ud og derfor — ubehageligt.
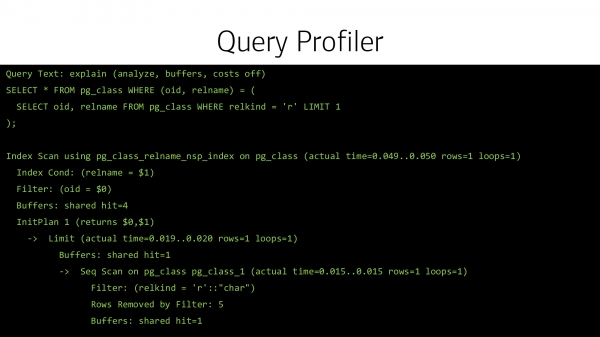
Især når udviklere 'limer' forespørgselens krop i koden (det er selvfølgelig et antipattern, men det sker) i én linje. Frygteligt!
Lad os tegne det noget mere smukt.
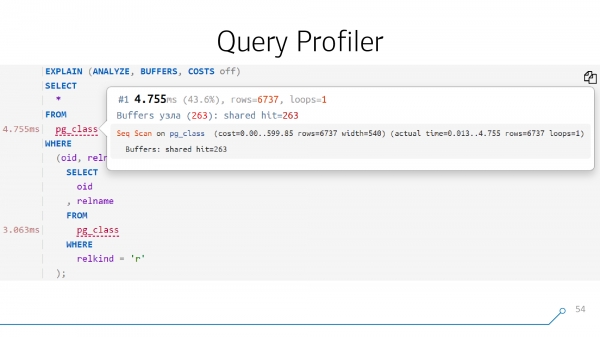
Og hvis vi kan tegne det smukt, altså analysere og samle forespørgselens krop igen, så kan vi også 'hæfte' tips til hvert objekt i denne forespørgsel — hvad der skete på det relevante punkt i planen.
Syntaktisk træ for forespørgslen
For at gøre dette skal forespørgslen først analyseres.
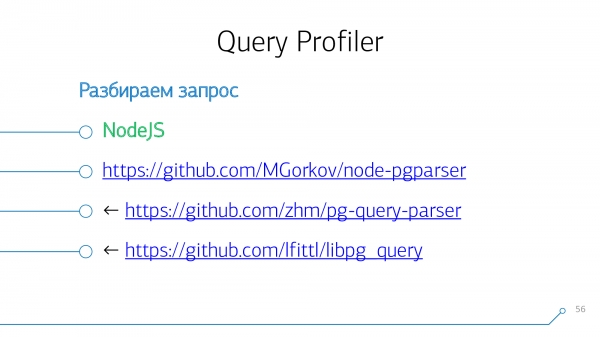
Da vi har , har vi lavet en lille modul til det, som du kan . Faktisk er det udvidede 'bindinger' til indersiden af PostgreSQL-parseren. Så det er blot en binær-kompileret grammatik, og der er lavet bindinger fra NodeJS-siden. Vi tog udgangspunkt i andres moduler — der er ikke nogen stor hemmelighed her.
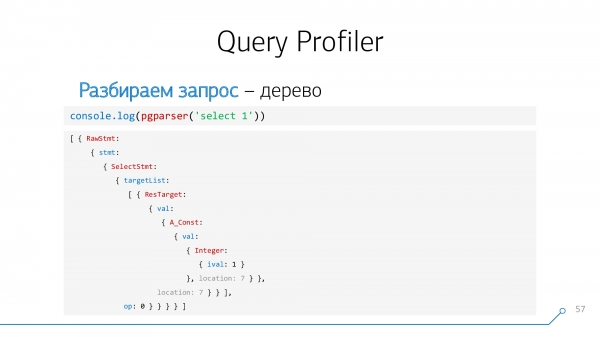
Vi indtaster forespørgselens krop i vores funktion — og får et analyseret syntaktisk træ i form af et JSON-objekt.
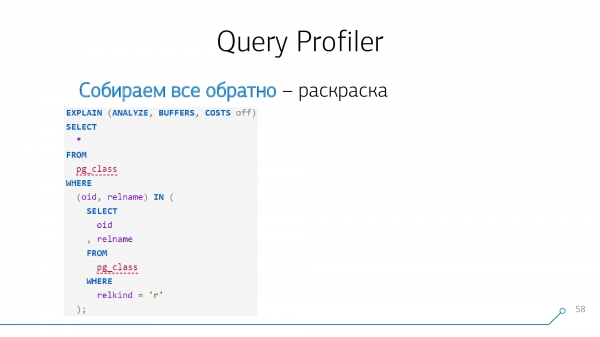
Nu kan vi gå tilbage gennem dette træ og samle forespørgslen med de indrykninger, farver og formatering, som vi ønsker. Nej, det kan ikke konfigureres, men vi mente, at det ville være praktisk at gøre det på denne måde.
Sammenkobling af forespørgsels- og planlægningsnoder
Nu ser vi på, hvordan vi kan kombinere planen, som vi analyserede i første trin, og forespørgslen, som vi analyserede i det andet.
Lad os tage et simpelt eksempel — vi har en forespørgsel, der danner en CTE og læser fra den to gange. Den genererer en sådan plan.
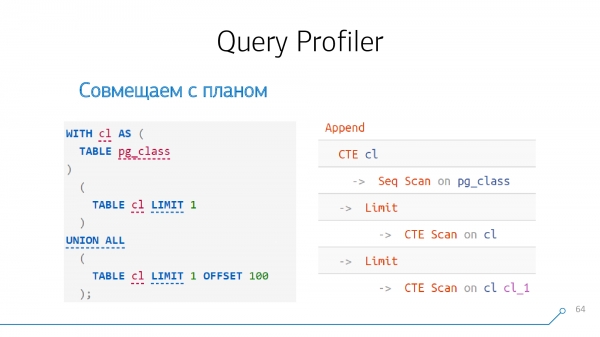
CTE
Hvis man ser tæt på, hvad der er før version 12 (eller begyndende med denne med nøgleordet MATERIALIZED) dannelse .
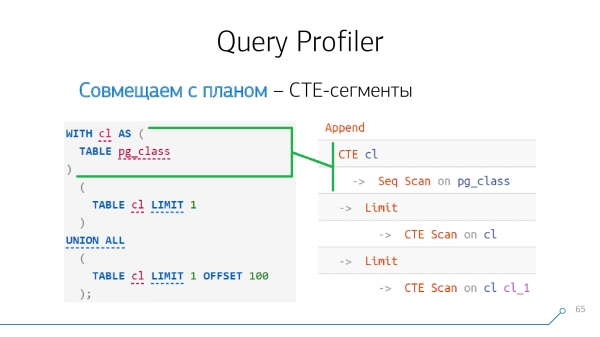
Og så, hvis vi ser et sted i forespørgslen, at der genereres en CTE, og et sted i planen er der en node CTE, så slår disse noder uden tvivl sammen. Vi kan straks kombinere dem.
Opgaven med en stjerne: CTE'er kan være indlejrede.
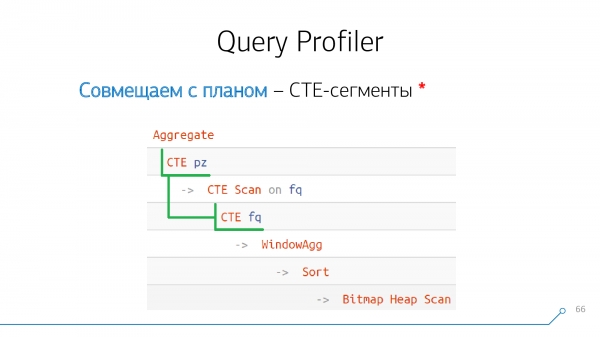
De kan være meget dårligt indlejrede og endda bære samme navn. For eksempel kan du inde i CTE A oprette CTE X, og på samme niveau indeni CTE B kan du igen oprette CTE X:
WITH A AS (
  WITH X AS (...)
  SELECT ...
)
, B AS (
  WITH X AS (...)
  SELECT ...
)
...
Når du sammenligner, skal du forstå dette. At forstå det "med øjnene" — selv når man ser planen, selv når man ser forespørgselens krop — er meget svært. Hvis du har en kompleks, indlejret CTE-generering, store forespørgsler — så er det slet ikke bevidst.
UNION
Hvis der er et nøgleord i vores forespørgsel, UNION [ALL] (operatør til at forbinde to udvalg), så svarer det i planen enten til en node Vedhæft, eller en eller anden Rekursiv forening.
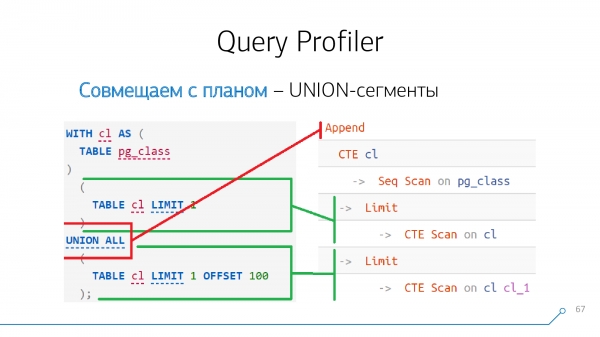
Det, der er "ovenfor" over UNION — det er den første efterkommer af vores node, hvad "nedenfor" — det er den anden. Hvis der er "klistret" flere blokke sammen, så UNION -noden vil stadig kun være en, men den vil have flere børn — i den rækkefølge, som de er i, henholdsvis: Vedhæft(...) -- #1 UNION ALL (...) -- #2 UNION ALL (...) -- #3
  Append
  -> ... #1
  -> ... #2
  -> ... #3
: inden for genereringen af rekursiv udvælgelse (
Opgaven med en stjerneWITH RECURSIVE) kan der også være mere end en. Men det er altid kun den sidste blok efter den sidste, der er rekursiv. UNIONAlt, hvad der er ovenfor — dette er én, men en anden. UNIONWITH RECURSIVE T AS( (...) -- #1 UNION ALL (...) -- #2, her slutter genereringen af det startende rekursive tilstand UNION ALL (...) -- #3, kun denne blok er rekursiv og kan indeholde henvisninger til T ) ... UNION:
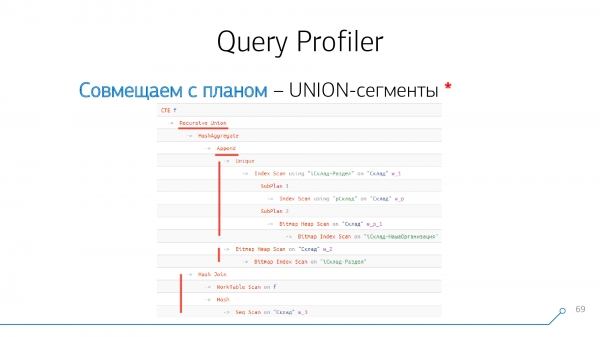
Sådanne eksempler skal også kunne "klistres" sammen. I dette eksempel ser vi, at -segmenterne i vores forespørgsel var 3 stykker. Følgelig svarer den ene UNION-node til den anden — UNION svarer til Vedhæft-noden, og den anden — Rekursiv forening.
Læsning-skrivning af data.
Sådan, vi har opdelt, nu ved vi, hvilken del af forespørgslen der svarer til hvilken del af planen. Og i disse dele kan vi nemt finde de objekter, der "læses".
Fra forespørslens synspunkt ved vi ikke — er det en tabel eller CTE, men de betegnes med den samme node. RangeVar. I planen 'læses' er det også en ret begrænset samling af noder:
Sekvensscanning på [tbl]Bitmap Heap Scan på [tbl]Indeks [Kun] Scan [Bagfra] ved hjælp af [idx] på [tbl]CTE Scan på [cte]Indsæt/Opdater/Slet på [tbl]
Vi kender strukturen af planen og forespørgslen, vi kender blokoverenskomsterne, vi kender objektnavnene — vi foretager en entydig sammenkædning.
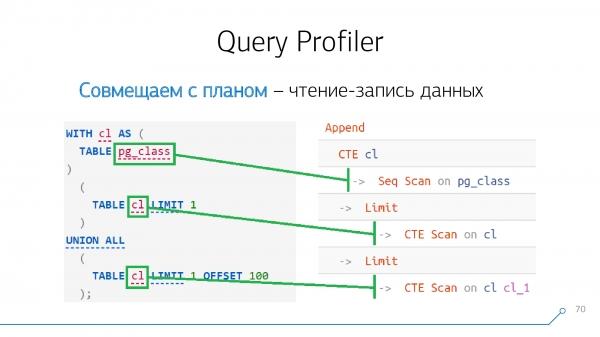
Igen opgaven 'med en stjerne'. Vi tager forespørgslen, udfører den, vi har ingen aliasser — vi har blot læst to gange fra én CTE.
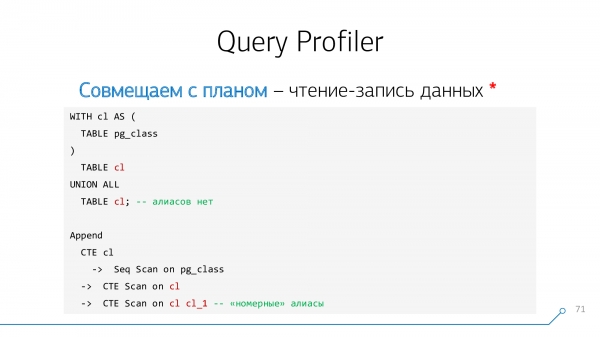
Vi kigger i planen — hvad er problemet? Hvorfor dukker aliaset op? Vi bestilte det ikke. Hvor kommer det 'nummererede' fra?
PostgreSQL tilføjer det selv. Man skal bare forstå, at netop dette alias ikke har nogen betydning for vores formål med at sammenkæde med planen, det er blot tilføjet her. Lad os ikke bekymre os om det.
Anden opgaven 'med en stjerne': hvis vi læser fra en sektioneret tabel, vil vi få en node Vedhæft eller Flet Append, som vil bestå af et stort antal 'børn', og hver af dem vil være en slags Scan' fra sektionstabel: Sekvensscanning, Bitmap Heap Scan eller Index Scan. Men i hvert fald vil disse 'børn' ikke være komplekse forespørgsler — sådan kan disse noder adskilles fra Vedhæft når UNION.
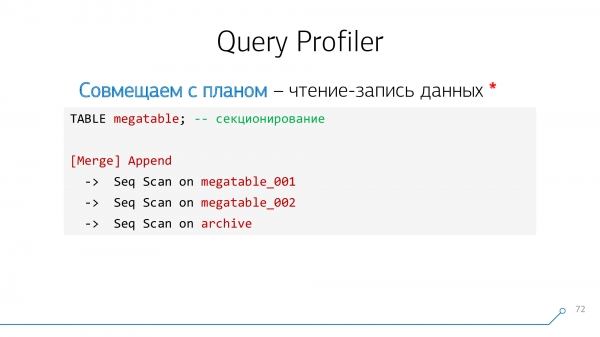
Sådanne noder forstår vi også, samler dem 'i en bunke' og siger: "alt det, du læste fra megatable — det er her og længere nede i træet".
'Enkle' datanoder
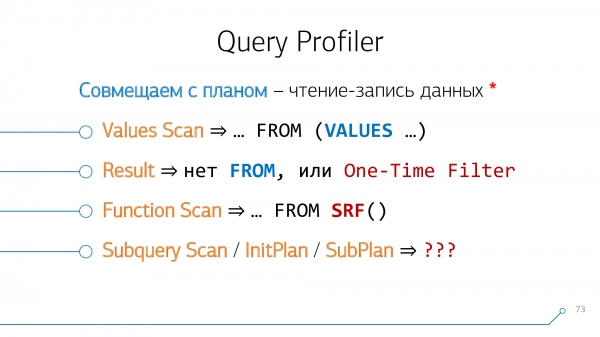
Værdiskanning i planen svarer til VALUES i forespørgslen.
Result — det er en forespørgsel uden FROM sådan set SELECT 1. Eller når du har en bevidst falsk betingelse i HVOR-blokken (så opstår der attributten One-Time Filter):
EXPLAIN ANALYZE
SELECT * FROM pg_class WHERE FALSE; -- eller 0 = 1
Resultat (omkostning=0.00..0.00 rækker=0 bredde=230) (aktuel tid=0.000..0.000 rækker=0 loops=1)
One-Time Filter: false
Funktionsscan 'mappes' til identiske SRF.
Men det er mere kompliceret med indlejrede forespørgsler — desværre bliver de ikke altid til InitPlan/SubPlan. Nogle gange bliver de til ... Join eller ... Anti Join, især når du skriver noget som WHERE NOT EXISTS .... Og der kan det være svært at kombinere — i tekstplanen er der ingen overensstemmelse mellem noderne i planen.
Igen opgaven 'med en stjerne': flere VALUES i forespørgslen. I dette tilfælde får du også flere noder i planen Værdiskanning.
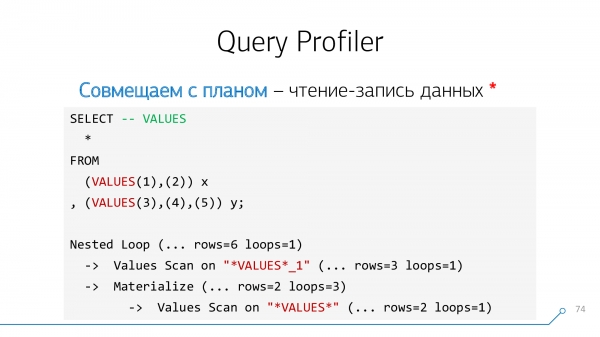
At skelne dem fra hinanden vil hjælpe 'nummererede' suffikser — de tilføjes præcis i rækkefølge, som de relevante VALUES-blokke findes nedad i forespørgslen.
Behandling af data
Det ser ud til, at vi har gennemgået alt i vores forespørgsel — der er kun Grænse.
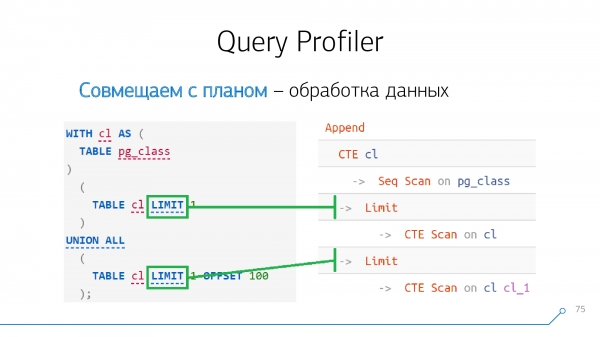
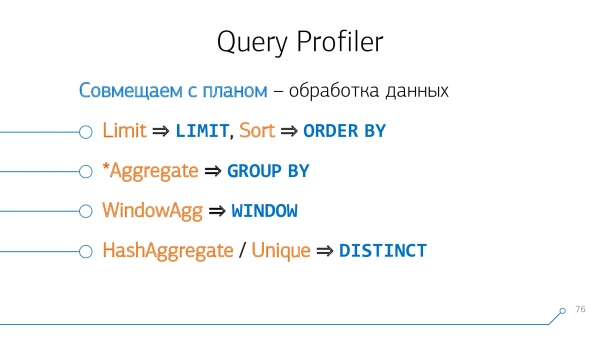
Men her er alt simpelt — sådanne noder som Grænse, Sorter, Aggregere, WindowAgg, Unique 'mappes' one-to-one på de tilsvarende operatorer i forespørgslen, hvis de findes. Her er der ingen 'stjerner' eller kompleksitet.
JOIN
Kompleksiteter opstår, når vi vil kombinere JOIN med hinanden. Det er ikke altid muligt, men det kan lade sig gøre.
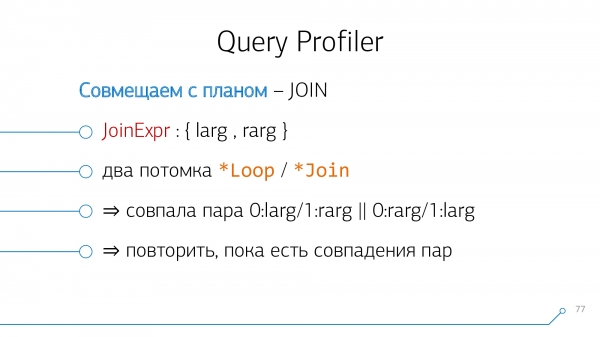
Set fra forespørgselsparserens synspunkt, har vi en node JoinExpr, som har præcis to børn - et venstre og et højre. Dette er henholdsvis det, der er "over" dit JOIN og det, der er "under" det, der er skrevet i forespørgslen.
Og set fra planens synspunkt, er det to børn af en eller anden * Løkke/* Deltag-node. Nested Loop, Hash Anti Join,… - sådan noget.
Lad os bruge en enkel logik: hvis vi har tabellerne A og B, der "joins" med hinanden i planen, så kunne de i forespørgslen være placeret enten A-JOIN-B, eller B-JOIN-A. Lad os prøve at kombinere dem på den måde, lad os prøve at kombinere dem omvendt, og sådan fortsætte, indtil sådanne par er udtømt.
Lad os tage vores syntaktiske træ, tage vores plan, se på dem... de ligner ikke hinanden!
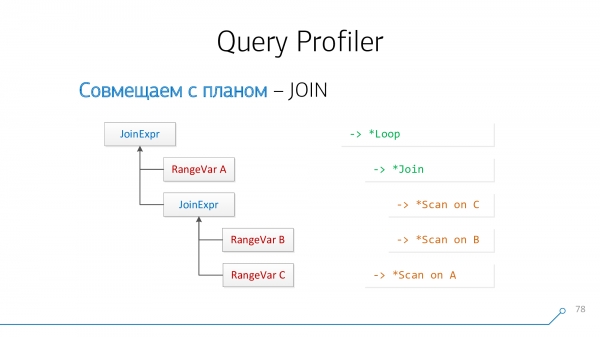
Lad os tegne dem som grafer - åh, nu ligner det noget!
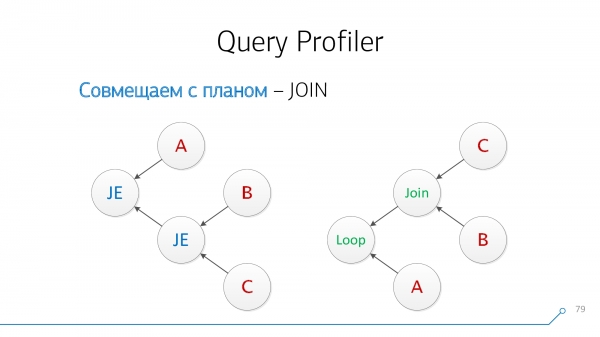
Lad os være opmærksomme på, at vi har noder, som samtidig har børn B og C - vi er ligeglade med rækkefølgen. Vi kombinerer dem og vender billedet af noden.
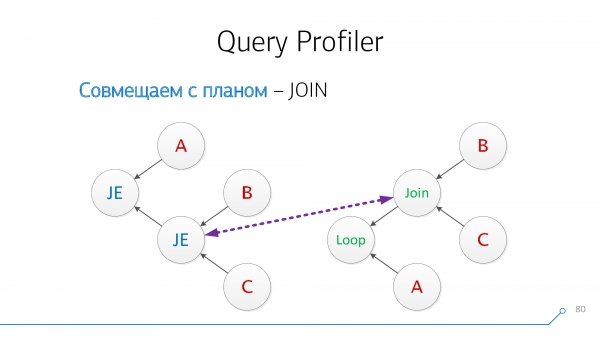
Lad os se på det igen. Nu har vi noder med børn A og parret (B + C) - lad os også kombinere dem.
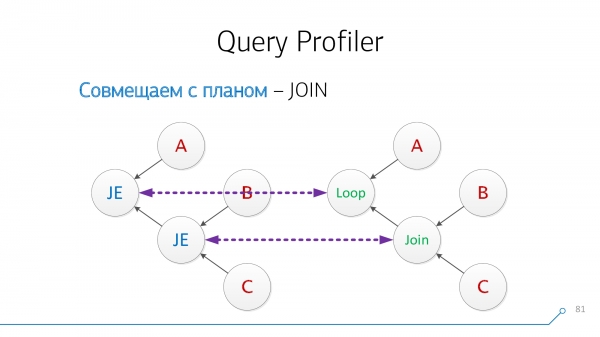
Flot! Det viser sig, at vi har kombineret disse to JOIN fra forespørgslen med planens noder med held.
Desværre er denne opgave ikke altid løselig.
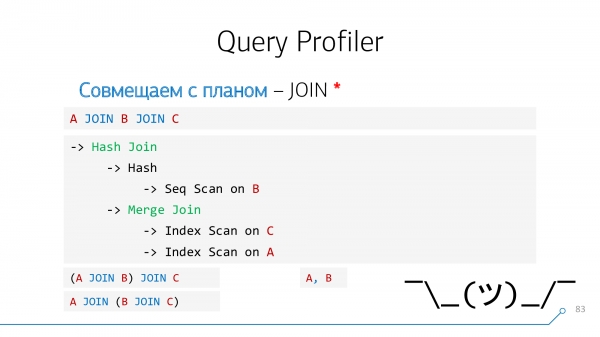
For eksempel, hvis i forespørgslen A JOIN B JOIN C, og i planen først blev de "ydre" noder A og C forbundet. Og der er ikke en sådan operator i forespørgslen, så vi kan ikke fremhæve noget, der er ikke noget at knytte en ledetråd til. Det samme gælder for "kommatallet", når du skriver A, B.
Men i de fleste tilfælde kan næsten alle noder "afvikles" og få en sådan profiling til venstre efter tid - bogstaveligt som i Google Chrome, når du analyserer din JavaScript-kode. Du ser, hvor lang tid hver linje og hver operator "blev udført".
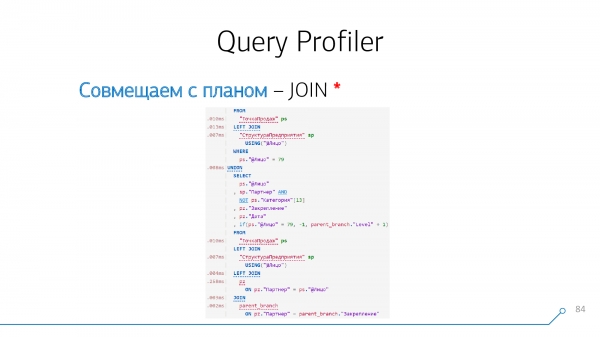
Og for at det skal være lettere for dig at bruge det hele, har vi lavet opbevaring , hvor du kan gemme og senere finde dine planer sammen med de tilknyttede forespørgsler eller dele et link med nogen.
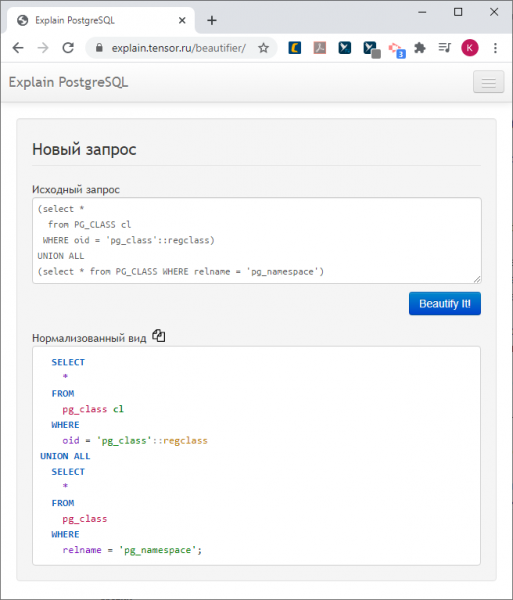
Hvis du blot skal bringe en uforståelig forespørgsel i en passende form, så brug .
Kilde: habr.com
