

Mange kender til databasesystemet PostgreSQL, som har vist sig at være fremragende til små installationer. Dog er tendensen til at bevæge sig mod Open Source blevet mere og mere tydelig, selv når det gælder store virksomheder og enterprise krav. I denne artikel vil vi nævne, hvordan man integrerer Postgres i en virksomhedsmiljø og dele erfaringer om oprettelsen af et backup-system (BK) for denne database ved hjælp af Commvault backup-system.
PostgreSQL har allerede bevist sin værdi — databasesystemet fungerer fremragende, det anvendes af trendy digitale virksomheder som Alibaba og TripAdvisor, og fraværet af licensafgifter gør det til et lokkende alternativ til monstre som MS SQL eller Oracle DB. Men så snart vi begynder at overveje PostgreSQL i enterprise-landskabet, støder vi på strenge krav: "Hvordan er det med konfigurationens fejltolerance? katastrofe-resiliens? hvor er den omfattende overvågning? hvad med automatiseret backup? og brugen af båndbiblioteker både direkte og som sekundær lagring?"
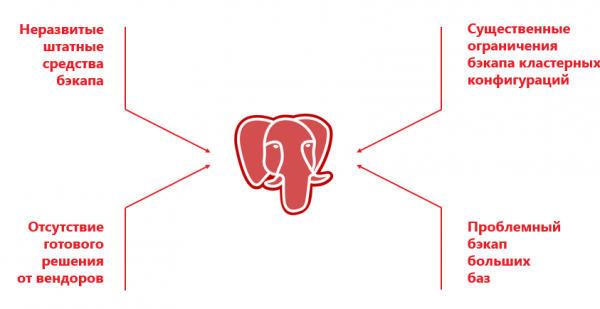
På den ene side har PostgreSQL ikke indbyggede backup-midler som "voksne" databasesystemer som RMAN fra Oracle DB eller SAP Database Backup. På den anden side understøtter leverandørerne af enterprise backup-løsninger (Veeam, Veritas, Commvault) selvom PostgreSQL, men de virker faktisk kun med bestemte (normalt standalone) konfigurationer og et sæt forskellige begrænsninger.
Backup-systemer som Barman, Wal-g, pg_probackup, specielt designet til PostgreSQL, er meget populære i små PostgreSQL-installationer eller der, hvor tunge backup-løsninger til andre elementer i IT-landskabet ikke er nødvendige. For eksempel kan der i infrastrukturen være både fysiske og virtuelle servere, OpenShift, Oracle, MariaDB, Cassandra osv. Alle disse bør bakkes op med et fælles værktøj. At installere en separat løsning udelukkende til PostgreSQL er en dårlig idé: data vil blive kopieret et sted til en disk, og derefter skal de overføres til tape. Denne dobbeltbagage til backup øger både tiden for backup og, hvad der er mere kritisk, - for gendannelsen.
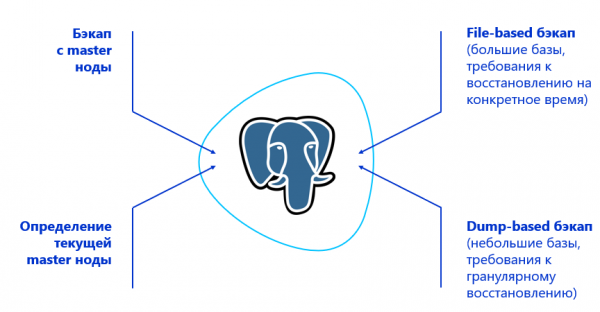
I enterprise-løsningen bliver backup af installationen udført med et antal noder fra det dedikerede klynge. For eksempel kan Commvault kun arbejde med en to-nodes klynge, hvor Primary og Secondary er strengt knyttet til bestemte noder. Der er også kun mening i at tage backup fra Primary, fordi backup fra Secondary har sine begrænsninger. På grund af databasens særlige egenskaber oprettes der ikke en dump på Secondary, og derfor er der kun mulighed for fil-backup.
For at reducere risikoen for nedetid, dannes der en "levende" klyngekonstruktion, når der oprettes et højtilgængeligt system, og Primary kan gradvist migrere mellem forskellige servere. For eksempel starter software som Patroni selv Primary på en tilfældigt valgt node i klyngen. SRK har ingen måde at spore dette "ud af boksen", og hvis konfigurationen ændrer sig, brydes processerne. Det vil sige, at implementeringen af ekstern styring hindrer SRK i at arbejde effektivt, fordi den styrende server simpelthen ikke forstår, hvilke data der skal kopieres, og hvorfra.
En anden udfordring er implementeringen af backup i Postgres. Det er muligt gennem dump, og det fungerer på små databaser. Men i store databaser tager dump lang tid, kræver mange ressourcer og kan føre til nedbrud af databasens instans.
Fil-backup løser situationen, men i store databaser går det langsomt, fordi det kører i en enkelt tråd. Desuden opstår der en række ekstra begrænsninger fra leverandørerne. Nogle gange må man ikke bruge både fil- og dump-backup samtidig, eller deduplication understøttes ikke. Der er mange problemer, og oftest er det lettere at vælge en dyr, men pålidelig database frem for Postgres.
Der er ikke plads til tilbagetrækning! Bagved er Moskva udviklerne!
Men for nylig stod vores team over for en vanskelig udfordring: i projektet om oprettelse af AIS OSAGO 2.0, hvor vi lavede IT-infrastrukturen, valgte udviklerne PostgreSQL til det nye system.
Store softwareudviklere har meget lettere ved at bruge "moderne" open-source løsninger. Hos Facebook er der tilstrækkeligt med specialister ansat til at understøtte driften af denne database. I tilfælde af RSA blev alle opgaverne 'den anden dag' lagt på vores skuldre. Vi skulle sikre højtilgængelighed, samle klyngen og selvfølgelig etablere backup. Handlingslogikken var sådan:
- Lære SRK at tage backup fra primærnoden i klyngen. For at gøre dette skal SRK kunne finde den — det betyder, at der er behov for integration med en eller anden løsning til administrationssystemet for PostgreSQL-klynger. I tilfældet med RSA blev softwareløsningen Patroni brugt.
- Bestem type backup baseret på datamængder og krav til gendannelse. For eksempel, når det er nødvendigt at gendanne sider granulært, skal der bruges en dump-fil, men hvis databaserne er store, og der ikke er behov for granulær gendannelse — arbejde på filniveau.
- Tilføj muligheden for blokbackup til løsningen, så der kan oprettes sikkerhedskopier i multitrådet tilstand.
Fra starten havde vi som mål at skabe et effektivt og enkelt system uden monsterbelastning fra ekstra komponenter. Jo færre klodser, jo mindre belastning på personalet og lavere risiko for, at SRK fejler. Tilgange, hvor Veeam og RMAN blev brugt, udelukkede vi straks, fordi pakken med to løsninger allerede antyder en usikkerhed i systemet.
Lidt magi til enterprise
Så vi skulle garantere pålidelig backup for 10 klynger med hver 3 noder, samtidig med at der i det sekundære datacenter ligger en spejl-infrastruktur. Datacentrene arbejder i forhold til PostgreSQL ud fra princippet om aktiv-passiv. Den samlede databasestørrelse var 50 TB. Enhver enterprise-niveau SRK kan nemt håndtere dette. Men det interessante er, at der oprindeligt ikke er nogen forbindelse i Postgres for fuld og dyb kompatibilitet med backup-systemerne. Derfor måtte vi finde en løsning, der oprindeligt havde maksimalt funktionalitet i forbindelse med PostgreSQL og videreudvikle systemet.
Vi har afholdt 3 interne hackathons — gennemgået mere end halvtreds udarbejdede løsninger, testet dem, foretaget ændringer baseret på vores hypoteser og derefter tjekket dem igen. Efter at have analyseret de tilgængelige muligheder valgte vi Commvault. Dette produkt kunne allerede "ud af boksen" arbejde med en simpel klyngeinstallation af PostgreSQL, og dets åbne arkitektur gav håb (som viste sig at være berettiget) om en vellykket videreudvikling og integration. Commvault kan også udføre backup af PostgreSQL-logfiler. For eksempel kan Veritas NetBackup kun tage fulde backups for PostgreSQL.
Mere om arkitekturen. Commvault's kontrolservere blev installeret i hver af de to datacentre i en CommServ HA-konfiguration. Systemet er spejlet, styres gennem et enkelt kontrolpanel og opfylder alle krav til HA på virksomhedsniveau.
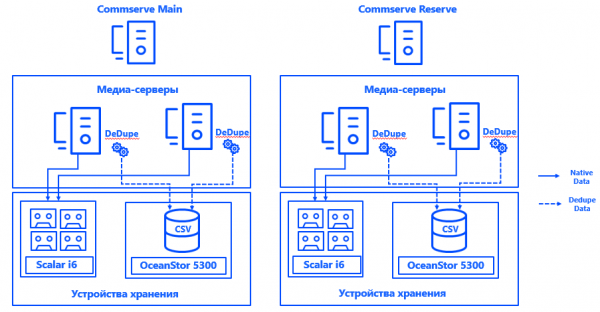
Derudover har vi i hvert datacenter startet to fysiske medieservere, som er tilsluttet dedikerede diskarrays og båndbiblioteker specielt til back-ups via SAN over Fibre Channel. De distribuerede dedupliceringslagre sikrer medieservernes fejltolerance, og tilslutningen af hver server til hver CSV muliggør kontinuerlig drift, selv hvis en hvilken som helst komponent fejler. Systemarkitekturen tillader fortsat backup, selvom et af datacentrene går ned.
Patroni bestemmer Primary-noden for hver klynge. Det kan være enhver ledig node i datacenteret - men kun i det primære. I det sekundære er alle noder - Secondary.
For at Commvault skulle forstå, hvilken node i klyngen der var Primary, integrerede vi systemet (tak til den åbne arkitektur) med Postgres. Der blev oprettet et script, der rapporterer den nuværende placering af Primary-noden til kontrolsystemet. server Commvault.
Generelt ser processen således ud:
Patroni vælger Primary → Keepalived opretter IP-klyngen og kører scriptet → Commvault-agenten på den valgte node i klyngen modtager besked om, at dette er Primary → Commvault omkonfigurerer automatisk backuppen inden for pseudo-klienten.
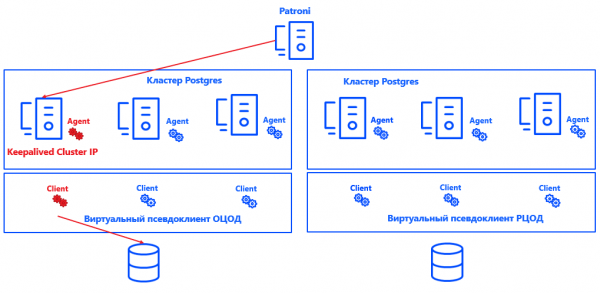
Fordelen ved denne tilgang er, at løsningen ikke påvirker hverken konsistensen eller korrektheden af loggene eller gendannelsen af Postgres-instansen. Den er også let at skalere, fordi det nu ikke er nødvendigt at fastlægge Primary- og Secondary-noderne for Commvault. Det er tilstrækkeligt, at systemet forstår, hvor Primary er, og antallet af noder kan øges praktisk talt til enhver værdi.
Løsningen gør ikke anspråk på at være perfekt og har sine nuancer. Commvault kan kun sikkerhedskopiere hele instansen, ikke enkelte databaser. Derfor er der oprettet en separat instans for hver database. Rigtige kunder er samlet i virtuelle pseudo-kunder. Hver pseudo-kunde i Commvault repræsenterer et UNIX-klynge. De noder i klyngen, hvor Commvault-agenten er installeret til Postgres, føjes til den. Som resultat sikkerhedskopieres alle virtuelle noder i pseudo-kunden som én instans.
Inden i hver pseudokunde er der angivet en aktiv node i klyngen. Det er netop denne, som vores integrationsløsning til Commvault identificerer. Princippet bag løsningen er ganske enkelt: hvis der oprettes en klynge-IP på noden, indstiller scriptet parameteren "aktiv node" i binaryen for Commvault-agenten – med andre ord indstiller scriptet "1" i den relevante del af hukommelsen. Agenten sender disse data til CommServe, og Commvault udfører backup fra den pågældende node. Derudover kontrolleres konfigurationens korrekthed på script-niveau, hvilket hjælper med at undgå fejl ved opstart af sikkerhedskopiering.
Store databaser sikkerhedskopieres blokvist i flere tråde for at opfylde kravene til RPO og backupvinduet. Systembelastningen er ubetydelig: Full-kopier udføres ikke så ofte, de andre dage samles kun logs, og det sker i perioder med lav belastning.
For øvrigt har vi anvendt separate politikker til sikkerhedskopiering af arkivlogs fra PostgreSQL – disse opbevares efter andre regler, kopieres efter en anden tidsplan, og der aktiveres ikke deduplication for dem, da disse logs indeholder unikke data.
For at sikre konsistens i hele IT-infrastrukturen er der installeret separate filklienter fra Commvault på hver af klyngens noder. De ekskluderer Postgres-filer fra sikkerhedskopierne og er kun beregnet til backup af OS og applikationer. For denne del af dataene er der også fastsat en egen politik og en specifik opbevaringsperiode.
I øjeblikket påvirker SRK ikke produktive tjenester, men hvis situationen ændrer sig, kan systemet for belastningsbegrænsning aktiveres i Commvault.
Godt nok? Godt nok!
Så vi har fået ikke bare en fungerende, men også en helt automatiseret backup til den klyngede installation af PostgreSQL, som svarer til alle kravene fra enterprise-udfordringer.
Parametrene RPO og RTO på 1 time og 2 timer er dækket med et pænt overskud, hvilket betyder, at systemet vil opfylde dem, selv ved betydelig vækst i lagrede data. På trods af mange tvivl viste PostgreSQL sig at være fuldt kompatibel med enterprise-miljøet. Og nu ved vi af egen erfaring, at backup for sådanne DBMS'er er mulig i de mest forskellige konfigurationer.
Selvfølgelig har vi på denne rejse været nødt til at slide syv par jernstøvler, overvinde en række udfordringer, træde på et par rake og rette en del fejl. Men nu er metoden afprøvet og kan anvendes til implementering af Open Source i stedet for proprietære DBS'er under barske enterprise-forhold.
Har du prøvet at arbejde med PostgreSQL i en virksomhedsmiljø?
Forfattere:
Oleg Lavrenov, systemdesigner for datalagringssystemer hos «Infostymer Jet»
Dmitry Erykin, systemdesigner for beregningskomplekser hos «Infostymer Jet»
Kilde: habr.com
