

Hej.
Jeg har besluttet at dele min opdagelse - et resultat af overvejelser, prøvelser og fejl.
I det store hele: det er bestemt ikke nogen opdagelse - alt dette burde være kendt af dem, der beskæftiger sig med anvendt statistikbehandling af data og optimering af systemer, ikke nødvendigvis kun DBMS.
Og: ja, de kender det, skriver interessante artikler om deres forskning, (UPD.: i kommentarerne blev der nævnt et meget interessant projekt: )
På den anden side: umiddelbart ser jeg ikke noget bredt nævnt om, eller udbredelse af denne tilgang, på internettet blandt IT-specialister og DBA'er.
Så, til sagen.
Lad os antage, at vi har en opgave: at indstille et eller andet servicessystem til at håndtere et bestemt arbejde.
Om dette arbejde - det er kendt: hvad det er, hvordan kvaliteten af dette arbejde måles, og hvad kriteriet for måling af denne kvalitet er.
Lad os også antage, at det er mere eller mindre kendt, hvordan arbejdet udføres i (eller med) dette servicessystem.
"Mere eller mindre" - det betyder, at der er mulighed for at forberede (eller finde et sted) et værktøj, en utility, en service, som kan syntetisere og påføre systemet en testbelastning, der er tilstrækkelig relevant til det, der vil være i produktion, under betingelser, der er tilstrækkelige til at arbejde i produktion.
Og, hvad problemet er - der er ikke en tilstrækkelig forståelse af dette servicessystem, sådan at det gør det muligt at eksperimentere med indstillinger for dette system til den kommende belastning på denne platform og opnå den ønskede produktivitet.
Nå. Sådan er det næsten altid.
Hvad kan der gøres her?
Det første, der kommer til at tænke på: at kigge i dokumentationen for dette system. Forstå - hvilke acceptable intervaller der er for værdierne af de reguleringsparametre. Og, for eksempel, ved hjælp af en metode med koordinatnedstigning, finde værdierne for systemets parametre under testene.
Altså, give systemet en eller anden konfiguration i form af et konkret sæt værdier af dens indstillingsparametre.
Påføre den testbelastning med dette værktøj/utility, load-generator.
Og se på størrelsen - responsen, eller kvaliteten af systemets præstation.
Den anden tanke kan være konklusionen at - dette er jo meget tidskrævende.
En anden tanke kan være, at konklusionen er, at det tager meget lang tid.
Det vil sige: hvis der er mange indstillingsparametre, hvis de værdier, vi kan dække, er store, og hvis hver enkelt belastningstest tager lang tid at udføre, så ja, det hele kan tage uacceptabelt lang tid.
Og her kan vi forstå og huske, hvad der kan gøres.
Vi kan få information om, i sættet af værdier for indstillingsparametrene i servicesystemet — en vektor, som en sekvens af visse værdier.
Hver sådan vektor, under forudsætning af at alt andet er lige (i den forstand, at denne vektor ikke bliver påvirket), svarer til en ganske bestemt værdi af metrikken — kvalitetsindikatoren for systemets funktion under testbelastning.
Det vil sige.
Lad os definere konfigurationsvektoren for systemet som  , hvor
 ; Hvor
 — antallet af systemkonfigurationsparametre, hvor mange af dem er der.
Og værdien af metrikken, der svarer til denne  lad os definere som
 , så får vi en funktion:

Så alt dette fører straks tilbage til, i mit tilfælde: næsten glemte algoritmer fra studietiden til at finde ekstremum af funktionen.
Godt, men her opstår et organisatorisk og praktisk spørgsmål: hvilken algoritme skal vi bruge.
- Med andre ord — for at kode så lidt som muligt.
- Og så det fungerer, dvs. finder ekstremum (hvis det findes), i hvert fald — hurtigere end koordinatnedstigning.
Det første punkt antyder, at vi skal se på nogle midler, hvor sådanne algoritmer allerede er implementeret og findes i en eller anden form, klar til brug i koden.
Jeg kender følgende python og cran-r
Det andet punkt betyder, at vi skal læse om selve algoritmerne, hvilke der findes, hvilke krav og arbejdsforskelle de har.
Og hvad de giver, kan være nyttige bivirkninger eller resultater, enten direkte fra selve algoritmen.
Eller de kan opnås fra resultaterne af algoritmens arbejde.
Meget afhænger af indgangsbetingelserne.
For eksempel, hvis vi af en eller anden grund har brug for hurtigere at få et resultat, så må vi se på algoritmer til gradientnedstigning og vælge en af dem.
Eller, hvis tiden ikke er så vigtig, kan vi eksempelvis benytte metoder til stokastisk optimering, som f.eks. genetiske algoritmer.
Jeg foreslår at overveje arbejdet med denne tilgang til at vælge systemkonfigurationen ved hjælp af en genetisk algoritme i det næste, så at sige: laboratoriearbejde.
Kilder:
- Lad os sige, at vi har et servicesystem:
oracle xe 18c - Lad os antage, at det håndterer transaktionsaktivitet og målet er at opnå den højest mulige throughput for databasen, pr. transaktioner/sek.
- Transaktioner kan variere betydeligt i deres karakter i forhold til databehandling og konteksten af arbejdet.
Lad os blive enige om, at dette er transaktioner, der ikke behandler store mængder tabeldata.
I den forstand genererer de ikke mere undo-data end redo og behandler ikke store procentdele af rækker i store tabeller.
Dette er transaktioner, der ændrer én række i en mere eller mindre stor tabel med et begrænset antal indeks over denne tabel.
I dette scenario vil databasens produktivitet ved behandlingen af transaktioner, under forudsætning, blive bestemt af kvaliteten af behandlingen af redo-dataene.
Forudsætningen er, at vi taler om indstillingerne af databasen.
Fordi der generelt kan være, for eksempel, transaktionslåsninger mellem SQL-sessioner, på grund af designet af brugerens arbejde med tabeldata og/eller tabelmodellen.
Disse vil naturligvis have en undertrykkende indflydelse på tps-metrikken, og dette vil være en eksogen faktor i forhold til databasen: sådan er tabelmodellen og databehandlingen designet, at der opstår låsninger.
Derfor, for eksperimentets renhed, vil vi udelukke denne faktor, som jeg vil præcisere nedenfor.
- Lad os antage, at 100% af de SQL-kommandoer, der sendes til databasen, er DML-kommandoer.
Lad os sige, at karakteristika for brugerens arbejde med databasen er de samme i testene.
Nemlig: antallet af SQL-sessioner, tabeldata og hvordan SQL-sessionerne arbejder med dem. - Databasen fungerer i
FORCE LOGGING,ARCHIVELOGtilstande. Flashback-database mode er deaktiveret på databaseniveau. - Redo-logfilerne er placeret i et separat filesystem, på en separat "disk";
Hele den øvrige del af den fysiske databasekomponent er i et andet, separat fs, på en separat "disk":
Mere om opbygningen af den fysiske komponent i laboratoriumdatabasen
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Oprindeligt planlagde jeg at bruge en database til denne belastningsbehandling.
Den har en så fantastisk funktion, jeg vil citere forfatteren:
Kernen i SLOB er ‘SLOB-metoden.’ SLOB Metoden har til formål at teste platforme
uden applikationskonkurrence. Man kan ikke opnå maksimal hardwareydelse
ved hjælp af applikationskode, der for eksempel er bundet af applikationslåsning eller endda
deling af Oracle Database-blokke. Ja, der er overhead, når man deler data
i datablocks! Men SLOB - i sin standardimplementering - er immun over for sådan konkurrence.
Denne erklæring: det er korrekt, og det er sandheden.
Det er praktisk at justere graden af parallelisme for SLOB-sessions, det er nøglen -t til at starte værktøjet runit.sh fra SLOB-sættet
Det reguleres procentdelen af DML-kommandoer, blandt det antal SLOB'er, som hver SLOB-session sender til databasen, parameteren UPDATE_PCT
For sig selv og meget praktisk: SLOB selv, før og efter belastningssessionen - forbereder statspak, eller AWR-snapshots (hvad der er angivet til at blive forberedt).
Men det viste sig, at SLOB den ikke understøtter SLOB-sessioner med en varighed på mindre end 30 sekunder.
Derfor kodede jeg først min, håndværkerens version af belastningsgeneratoren, og derefter forblev den i brug.
Jeg vil præcisere, hvad belastningsgeneratoren gør, for klarhedens skyld.
I det væsentlige ser belastningsgeneratoren sådan ud:
Worker-kode
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Workere startes således:
Start af workere
echo "starter test, varighed: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "venter..." >> "$v_logfile"
vent
Og tabellerne til arbejderne forberedes således:
Oprettelse af tabeller
function createtable() {
source "\/home\/oracle\/testingredotracе\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\n
create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Det vil sige, at der for hver arbejdere (praktisk talt: en separat SQL-session i databasen) oprettes en særskilt tabel, som arbejdere arbejder med.
Dette opnås ved at undgå transaktionelle låsninger mellem SQL-sessioner for arbejderne.
Hver arbejder udfører det samme med sin egen tabel, og tabellerne er alle ens.
Arbejderne udfører alle arbejdet i løbet af den samme tid.
Og dette er en tilstrækkelig lang tid, så der f.eks. med sikkerhed er sket log-switching, og ikke kun én gang.
Og i takt med dette opstår der relaterede omkostninger og effekter.
I mit tilfælde har jeg sat varigheden for arbejdernes arbejde til 8 minutter.
Et udsnit af statspak-rapporten, der beskriver, hvordan databasen arbejder under belastning.
Database    DB Id    Instans     Inst Num  Opstartstid   Udgivelse     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NEJ

Værtsnavn             Platform                CPU'er Cores Sockets   Hukommelse (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Snapshot       Snap Id     Snap Tid      Sessioner Curs/Sess Kommentar
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Start Snap:       1630 07-Sep-20 23:12:27       55        .7
  Slut Snap:       1631 07-Sep-20 23:20:29       62        .6
   Forløb:       8.03 (min) Gennemsnitlig aktiv session:       8.4
   DB tid:      67.31 (min)      DB CPU:      15.01 (min)

Cache Størrelser            Start        Slut
~~~~~~~~~~~       ---------- ----------
    Buffer Cache:     1,392M              Std Block Size:         8K
     Shared Pool:       288M                  Log Buffer:   103,424K

Belastningsprofil              Per Sekunde    Per Transaktion    Per Kørsel    Per Opringning
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      DB tid(s):                8.4                0.0        0.00        0.20
       DB CPU(s):                1.9                0.0        0.00        0.04
       Redo størrelse:        7,685,765.6              978.4
   Logiske læsninger:           60,447.0                7.7
   Blockændringer:           47,167.3                6.0
  Fysiske læsninger:                8.3                0.0
 Fysiske skriverier:              253.4                0.0
      Brugeropkald:               42.6                0.0
          Parser:               23.2                0.0
     Hårde parser:                1.2                0.0
W/A MB behandlet:                1.0                0.0
          Logon:                0.5                0.0
        Udførelser:           15,756.5                2.0
       Tilbagerulninger:                0.0                0.0
    Transaktioner:            7,855.1
Tilbage til opstillingen af laboratoriearbejdet.
Vi vil, under ellers lige betingelser, variere værdierne af sådanne parametre for det laboratorium-system:
- Størrelse på loggruppe i databasen. værdiområde: [32, 1024] Mbyte;
- Antal loggrupper i databasen. værdiområde: [2,32];
log_archive_max_processesværdiområde: [1,8];commit_loggingto værdier er tilladt:batch|immediate;commit_waitto værdier er tilladt:wait|nowait;log_bufferværdiområde: [2,128] Mbyte.log_checkpoint_timeoutværdiområde: [60,1200] sekunderdb_writer_processesværdiområde: [1,4]undo_retentionværdiområde: [30;300] sekundertransactions_per_rollback_segmentværdiområde: [1,8]disk_asynch_ioto værdier er tilladt:true|false;filesystemio_optionsdisse værdier er tilladt:none|setall|directIO|asynch;db_block_checkingdisse værdier er tilladt:OFF|LOW|MEDIUM|FULL;db_block_checksumdisse værdier er tilladt:OFF|TYPICAL|FULL;
En person med erfaring i vedligeholdelse af oracle-databaser kan uden tvivl nu sige — hvad og hvilke værdier der skal indstilles af de angivne parametre og deres tilladte værdier for at opnå større produktivitet i systemet for det arbejde med data, der er angivet, i den anvendte kode, her, ovenfor.
Men.
Formålet med laborationen er at vise, at optimeringsalgoritmen fungerer hurtigt og effektivt.
Vi skal blot kigge i dokumentationen for det konfigurerbare system, lige præcis så meget som nødvendigt for at finde ud af, hvilke parametre og i hvilke intervaller der skal ændres.
Og også: kode det script, der vil implementere arbejdet med det konfigurerbare system for den valgte optimeringsalgoritme.
Så, nu om koden.
Ovenfor nævnt cran-r, dvs.: alle manipulationer med det konfigurerbare system koordineres i form af et R-script.
Selve opgaven, analysen, udvælgelsen baseret på metrikværdi og systemtilstandsvektorer: det er pakken GA ()
Pakken passer i dette tilfælde ikke så godt, fordi den forventer at én vektorer (kromosomer, i pakkens termer) gives som en sekvens af reelle tal med decimalkomponent.
Og min vektor, bestående af de indstillede parametre: det er 14 værdier — hele tal og strenge.
Problemet kan selvfølgelig nemt løses ved at tildele bestemte tal til de strenge værdier.
Således ser den centrale del af R-scriptet således ud:
Kald GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Her, med hjælp fra lower og upper attributterne i underprogrammet ga defineres i princippet søgeområdet, inden for hvilket vektoren (eller vektorerne) findes, for hvilke den maksimale værdi for fitness-funktionen opnås.
ga-underprogrammet udfører søgningen ved at maksimere fitness-funktionen.
Således, i dette tilfælde, skal det sikres, at fitness-funktionen forstår vektoren som et sæt værdier for bestemte databaser og opnår en metrik fra databasen.
Det vil sige: hvor mange transaktioner pr. sekund baseret på denne indstilling af databasen og denne belastning.
Det vil sige, lad os uddybe, at fitness-funktionen skal udføre følgende kompleksitet:
- Behandling af det indkommende vektor af tal — konvertering af det til værdier for databasen.
- Et forsøg på at oprette det angivne antal redo-grupper, i en angivet størrelse. Og forsøget kan være mislykket.
De eksisterende journalgrupper i databasen, uanset antal og størrelse, skal fjernes for at sikre eksperimentets rene forhold. - Ved succes med det forrige punkt: opgaven med at sætte værdibasen af konfigurationsparametre (igen: der kan være fejl)
- Ved succes med det forrige punkt: stop databasen, start databasen igen, så de nye angivne parameterværdier træder i kraft. (igen: der kan være fejl)
- Ved succes med det forrige punkt: udfør belastningstest. få metrik fra databasen.
- Returner databasen til den oprindelige tilstand, dvs. fjern de ekstra journalgrupper, og bring den oprindelige konfiguration af databasen tilbage.
Koden til fitnessfunktionen
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," forsøger at evaluere vektor: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups mislykkedes",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," kan ikke starte db med den vektor af indstillinger",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," kan ikke starte db med den vektor af indstillinger",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("resultat: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Således udføres alt arbejde i fitness-funktionen.
ga-underprogrammet, behandler vektorer, eller mere korrekt sagt - kromosomer.
Hvor vi især er interesserede i: selektionen af kromosomer med de gener, hvor fitness-funktionen giver store værdier.
Dette er i princippet processen med at søge efter det optimale sæt af kromosomer i et N-dimensionelt søgeområde.
Meget klart, detaljeret , med eksempler på R-kode, der arbejder med den genetiske algoritme.
Jeg vil særskilt bemærke to tekniske punkter.
Hjælpeopkald fra funktionen evaluate, for eksempel stop-start, indstilling af værdien af databasens parameter, udføres på basis af cran-r funktionen system2
Hvorved: en eller anden bash-script eller kommando kaldes.
For eksempel:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotrace/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Det andet punkt - strengen, evaluate funktionen, med bevarelsen af den specifikke værdi af metrikken og den tilsvarende indstillingsvektor i logfilen:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)Det er vigtigt, fordi fra dette datasæt kan vi få yderligere information om, hvilken af komponenterne i indstillingsvektoren der påvirker værdien af metrikken mest eller mindst.
Det vil sige: en attribut-sværhedsgrad analyse kan udføres.
Så hvad kan der komme ud af det.
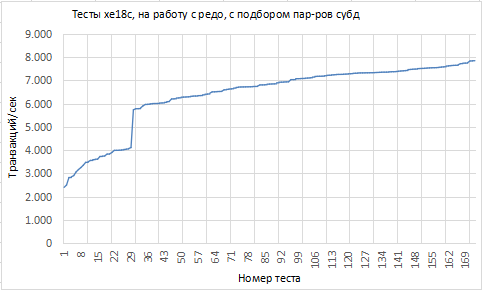
I form af et diagram, hvis vi sorterer testene efter stigende metrik, ser billedet således ud:
Nogle data, der svarer til de ekstreme værdier af metrikken:
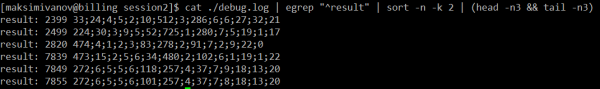
Her, på skærmbilledet med resultaterne, præciserer jeg: værdierne af indstillingsvektoren - gives i termer af fitness-funktionskoden, ikke i termer af nummerlisten af parametre/range for værdierne af parametrene, som tidligere blev formuleret i teksten.
Nå. Er det meget eller lidt, ~8K tps: et separat spørgsmål.
I rammerne af laborationsarbejdet - er dette tal ikke så vigtigt, det vigtige er dynamikken, hvordan denne værdi ændrer sig.
Dynamikken her er god.
Det er åbenlyst, at der mindst er én faktor, der signifikant påvirker værdien af metrikken, ga-algoritmen, som gennemgår vektorer-kromosomer: blev dækket.
If we consider the fairly brisk dynamics of the curve values, there is at least one more factor that, although significantly smaller, still has an impact.
Here we need a attribute-importance analysis to understand which attributes (in this case, the components of the tuning vector) and how strongly they influence the value of the metric.
From this information, we can understand which factors were affected by changes in significant attributes.
Execute attribute-importance in various ways.
For these purposes, I like the algorithm randomForest of the same name R package ()
randomForest, as I understand its overall operation and its approach to assessing the importance of attributes in particular, builds a model of the dependency of the response variable on the attributes.
In our case, the response variable is the metric obtained from the database system, in load tests: tps;
And the attributes are the components of the tuning vector.
So it randomForest assesses the importance of each attribute of the model with two numbers: %IncMSE — how the presence/absence of this attribute in the model changes the MSE quality of this model (Mean Squared Error);
And IncNodePurity is a number that reflects how well, based on the values of this attribute, you can split the dataset of observations so that one part has data with one value of the explained metric, and the other part has another metric value.
So, that is: how much of a classifying attribute this is (the most clear explanation in Russian I found on random forest is ).
Working-peasant R code for processing the dataset with load test results:
x=NULL
v_data_file=paste('\/tmp\/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
You can manually adjust the hyperparameters of the algorithm, guided by the quality of the model, to select a more precise model for making predictions on the validation dataset.
You can write a function for this work (by the way — again, using some optimization algorithm).
You can use the R package caret, det betyder ikke noget.
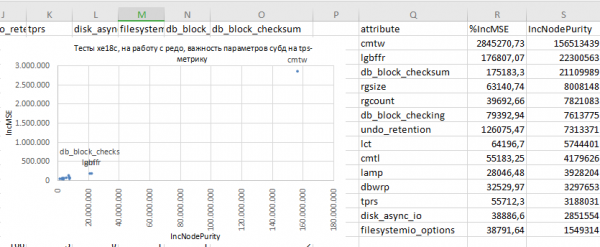
I sidste ende fås følgende resultat til vurdering af betydningen af attributterne:
Nå. Således kan man begynde at tænke stort:
- Det viser sig, at den mest betydningsfulde parameter i de givne testforhold er
commit_wait
Teknisk set angiver den, hvordan io-operationen til skrivning af redo-data fra log-bufferen i database systemet til den nuværende journalgruppe udføres: synkron eller asynkron.
Værdinowaithvorved der opnås en næsten vertikal, multipliceret stigning i værdien af tps-metrikken: det er aktiveringen af asynkron io i redo-grupper.
Et særskilt spørgsmål — er det nødvendigt at gøre sådan i produktionsdatabasen? Her limiterer jeg mig kun til at konstatere: dette er en betydningsfuld faktor. - Det er logisk, at størrelsen på log-bufferen for database systemet viser sig at være en betydningsfuld faktor.
Jo mindre størrelsen på log-bufferen er, desto mindre er dens bufferingskapacitet, hvilket resulterer i, at overfyldning og/eller manglende mulighed for at tildele ledig plads til en portion nye redo-data sker oftere.
Og det betyder: forsinkelser forbundet med tildeling af plads i log-bufferen og/eller tømning af redo-data fra den til redo-grupperne.
Disse forsinkelser skal selvfølgelig påvirke og påvirker databassystemets throughput for transaktioner. - Parameter
db_block_checksum: Nå, det er også generelt klart — behandlingen af transaktioner fører til dannelse af dirty-blokke i databassens buffer-cache.
Som, når kontrol af datablokkechecksums er aktiveret, må databasen behandle — beregne disse checksums fra indholdet af datablokken, sammenligne dem med det, der står i headeren af datablokken: stemmer overens/ikke stemmer overens.
Sådan et arbejde kan igen ikke undgå at forsinke databehandlingen, og tilsvarende bliver parametrene og mekanismerne, der definerer disse parametre, betydningsfulde.
Derfor foreslår leverandøren i dokumentationen til denne parameter forskellige værdier af den (parameteren) og bemærker, at — ja, der vil være indvirkning, men der er forskellige værdier, helt ned til 'slukket' og forskellige indvirkninger, som du kan vælge.
Nå, og den overordnede konklusion.
Tilgangen viser sig at være ret funktionel.
Den tillader ganske enkelt, i de tidlige faser af belastningstestning af et tjenestesystem, at vælge den optimale konfiguration til belastning uden at skulle dykke dybt ind i systemets konfigurationsspecifikationer til belastning.
Men udelukker ikke helt - i det mindste på niveauet for forståelse: "justeringsknapper" og de acceptable rotationsområder for disse knapper skal systemet kende til.
Dernæst kan tilgangen hurtigt finde den optimale konfiguration af systemet.
Og man kan efter testningen få information om naturen af forholdet mellem kvalitetsmålingen af systemets arbejde og værdierne for systemets justeringsparametre.
Dette bør naturligvis fremme den dybe forståelse af systemet og dets drift, i det mindste under den pågældende belastning.
Praktisk set: at afveje omkostningerne til at sætte sig ind i det konfigurerbare system imod omkostningerne til at forberede sådan en test af systemets arbejde.
Jeg vil gerne fremhæve: i denne tilgang er testens tilstrækkelighed i forhold til de arbejdsforhold, systemet vil have i produktionsdrift, kritisk vigtig.
Tak for jeres opmærksomhed og tid.
Kilde: habr.com
