

Det er muligt at konfigurere datalagring for applikationer, der kører i Kubernetes-klynger, på flere måder. Nogle af dem er allerede forældede, mens andre er helt nye. I denne artikel vil vi se på konceptet med tre forskellige måder at tilslutte lagersystemer (S3) på, herunder den nyeste: tilslutning via Container Storage Interface.
Metode 1. Angivelse af PV i pod-manifestet
Et typisk manifest, der beskriver en pod i Kubernetes-klysten:
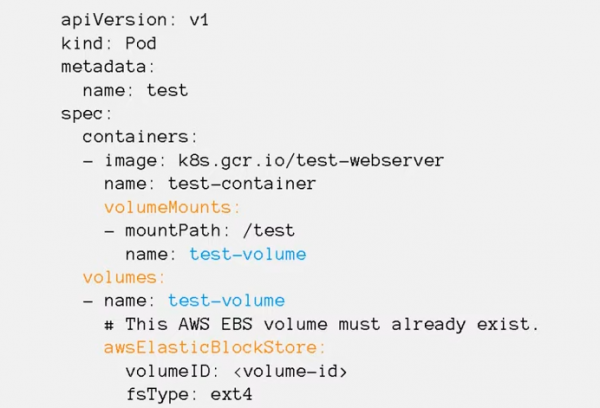
De farvede sektioner i manifestet angiver, hvilken volumen der forbindes til hvor.
I sektionen volumeMounts angiver monteringspunkter (mountPath) - hvilken mappe inden i containeren det permanente volumene vil blive monteret, samt navnet på volumenen.
I sektionen x angiver alle volumener, der bruges i pod'en. De angiver navnet på hvert volumen, typen (i vores tilfælde: awsElasticBlockStore) og tilslutningsparametrene. Hvilke parametre der angives i manifestet, afhænger af typen af volumen.
Det samme volumen kan monteres i flere containere i pod'en samtidig. Således kan forskellige applikationsprocesser få adgang til de samme data.
Denne metode tilslutning blev opfundet i starten, da Kubernetes lige var begyndt, og i dag er metoden forældet.
Brugen af denne metode medfører flere problemer:
- alle volumener skal oprettes manuelt, Kubernetes kan ikke oprette noget for os;
- adgangsparametrene for hvert af volumenerne er unikke, og de skal angives i manifestet for alle pods, der bruger volumenen;
- for at ændre lagersystemet (for eksempel at flytte fra AWS til Google Cloud) skal indstillingerne og typen af tilsluttede volumener ændres i alle manifests.
Alt dette er meget besværligt, så i praksis bruges denne metode kun til at forbinde nogle specifikke typer volumener: configMap, secret, emptyDir, hostPath:
configMap og secret - systemvolumener, der gør det muligt at oprette et volumen i containeren med filer fra Kubernetes-manifestet.
emptyDir - et midlertidigt volumen, der kun oprettes i pod'ens levetid. Det er praktisk til testformål eller til at opbevare midlertidige data. Når pod'en slettes, bliver emptyDir-volumenet også slettet, og alle data går tabt.
hostPath - giver mulighed for at montere enhver mappe fra serverens lokale disk, hvor applikationen kører, ind i containeren med applikationen, herunder /etc/kubernetes. Dette er en usikker funktion, derfor forbyder sikkerhedspolitikker normalt brugen af denne type volumener. Ellers kan en ondsindet applikation montere kataloget HTC Kubernetes inde i sin container og stjæle alle klyngens certifikater. Generelt tillades hostPath volumener kun for systemapplikationer, der kører i kube-system namespace.
er angivet i dokumentationen.
Metode 2. Tilslutning til pod'er SC/PVC/PV
Et alternativ til tilslutning er konceptet Storage class, PersistentVolumeClaim, PersistentVolume.
Storage class opbevarer forbindelsesparametre til lagringssystemet.
PersistentVolumeClaim beskriver kravene til det volumen, som applikationen har brug for.
PersistentVolume opbevarer adgangsparametre og status for volumen.
Kernen i ideen: i pod-manifestet angives volumen af typen PersistentVolumeClaim, og navnet på denne enhed angives i parameteren claimName.
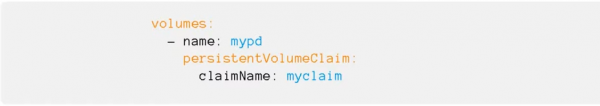
I manifestet for PersistentVolumeClaim beskrives kravene til de data, der er nødvendige for applikationen. Herunder:
- diskstørrelse;
- adgangsmåde: ReadWriteOnce eller ReadWriteMany;
- henvisning til Storage class - hvilket lagringssystem vi ønsker at oprette volumen i.
I manifestet for Storage class opbevares type og forbindelsesparametre til lagringssystemet. Disse er nødvendige for kubelet til at montere volumen til sin node.
I manifesterne for PersistentVolume angives Storage class og adgangsparametre til det specifikke volumen (volumen ID, sti, osv.).
Når der oprettes en PVC, ser Kubernetes, hvilket volumen der kræves i hvilken størrelse, og fra hvilken Storage class, og vælger et ledigt PersistentVolume.
Hvis der ikke er sådanne PV'er tilgængelige, kan Kubernetes starte et særligt program - Provisioner (navnet angives i Storage class). Dette program tilslutter sig lagringssystemet, opretter et volumen i den krævede størrelse, modtager et ID og skaber et manifest for PersistentVolume i Kubernetes-klyngen, som er forbundet med PersistentVolumeClaim.
Alt dette netværk af abstraktioner gør det muligt at fjerne information om, hvilket lagringssystem applikationen arbejder med, fra niveauet for applikationsmanifestet til administrationsniveauet.
Alle forbindelsesparametre til lagringssystemet findes i Storage class, som administreres af clusteradministratorer. Det, man skal gøre ved overgangen fra AWS til Google Cloud, er at ændre navnet på Storage class i PVC i applikationsmanifestet. Persistent Volume til datalagring vil blive oprettet automatisk i klyngen ved hjælp af Provisioner-programmet.
Metode 3. Container Storage Interface
Al koden, der interagerer med forskellige lagringssystemer, er en del af kernen i Kubernetes. Udgivelse af fejlrettelser eller nye funktioner er knyttet til nye versioner, og koden skal ændres for alle understøttede versioner af Kubernetes. Alt dette er vanskeligt at vedligeholde og tilføje nye funktioner.
For at løse problemet skabte udviklerne fra Cloud Foundry, Kubernetes, Mesos og Docker Container Storage Interface (CSI) — et enkelt, ensartet grænseflade, der beskriver samspillet mellem containerhåndteringssystemet og en specifik driver (CSI Driver), der arbejder med et bestemt lagringssystem. Al kode, der interagerer med lagringssystemet, blev flyttet fra kernen i Kubernetes til et separat system.
.
Som regel består CSI Driver af to komponenter: Node Plugin og Controller plugin.
Node Plugin kører på hver node og er ansvarlig for montering af volumes og operationer på dem. Controller plugin interagerer med lagringssystemet: opretter eller sletter volumes, tildeler adgangsrettigheder mv.
Der findes stadig gamle drivere i kernen i Kubernetes, men det anbefales ikke at bruge dem, og alle rådes til at installere CSI Driver specifikt til det system, de skal arbejde med.
Innovationer kan skræmme dem, der allerede er vant til at konfigurere datalagring via Storage class, men der er faktisk ikke sket noget skræmmende. For programmører ændrer det sig ikke — de vil fortsat arbejde med navnet på Storage class. For administratorer er der tilføjet installation af helm chart og strukturen for indstillingerne er ændret. Tidligere blev indstillingerne indtastet direkte i Storage class, men nu skal de først angives i helm chart og derefter i Storage class. Når man ser nærmere på det, er der ikke sket noget skræmmende.
Lad os med et eksempel se på, hvilke fordele man kan få ved at skifte til tilslutning af Ceph-lagringssystemet via CSI-driveren.
Når man arbejder med Ceph, giver CSI-pluginet flere muligheder for arbejde med lagringssystemet end de indbyggede drivere.
- Dynamisk oprettelse af diske. Normalt bruges RBD-diskene kun i RWO-tilstand, mens CSI til Ceph tillader brug i RWX-tilstand. Flere pods på forskellige noder kan montere den samme RBD-disk til deres noder og arbejde med den parallelt. For retfærdighedens skyld skal det siges, at ikke alt er rosenrødt - denne disk kan kun tilsluttes som et blokkeringsdevice, hvilket betyder, at applikationen skal tilpasses for at arbejde med den i tilstand med flere adgang.
- Oprettelse af snapshots. I Kubernetes-klyngen kan man oprette et manifest, der kræver oprettelse af et snapshot. CSI-pluginet vil bemærke det og tage et snapshot af disken. På baggrund af dette kan der laves enten en backup eller en kopi af PersistentVolume.
- Forøgelse af diskstørrelsen på SAN og PersistentVolume i Kubernetes-klyngen.
- Kvoter. De indbyggede CephFS-drivere i Kubernetes understøtter ikke kvoter, mens de nyeste CSI-plugins med den nyeste Ceph Nautilus kan aktivere kvoter på CephFS-partitioner.
- Metrikker. CSI-pluginet kan give Prometheus en række metrikker om, hvilke volumener der er tilsluttet, hvilke interaktioner der foregår, osv.
- Topology aware. Tillader angivelse i manifester, hvordan klyngen er geografisk fordelt, og undgår tilslutning til pods, der kører i London, fra datalagringssystemet, der ligger i Amsterdam.
Hvordan man tilslutter Ceph til Kubernetes-klyngen via CSI, se . Man kan også tilmelde sig , som starter den 15. oktober.
Artiklen er skrevet af Sergey Bondarev, praktiserende arkitekt hos Southbridge, Certified Kubernetes Administrator, en af udviklerne af kubespray.
Lidt Post Scriptum ikke reklame, men for nytte...
P.S. Sergey Bondarev leder to intensive kurser: den opdaterede 28-30 september og det avancerede 14-16 oktober.
Kilde: habr.com
