

Bem. overs.: tilpasningen af Kubernetes i GitLab betragtes som en af de to vigtigste faktorer, der bidrager til virksomhedens vækst. Indtil for nylig var infrastrukturen for online-tjenesten GitLab.com bygget på virtuelle maskiner, og først for omkring et år siden begyndte migreringen til K8s, som stadig ikke er afsluttet. Vi er glade for at præsentere oversættelsen af en nylig artikel af SRE-ingeniøren fra GitLab om, hvordan dette forløber, og hvilke konklusioner ingeniørerne, der deltager i projektet, drager.
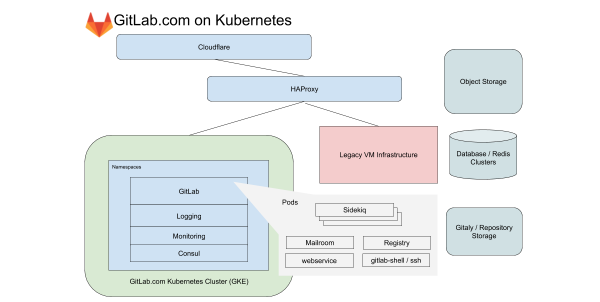
I snart et år har vores infrastrukturelle afdeling arbejdet på at migrere alle tjenester, der kører på GitLab.com, til Kubernetes. I løbet af denne tid har vi stødt på problemer, der ikke kun vedrører flytningen af tjenester til Kubernetes, men også håndteringen af hybrid deployment under overgangen. Denne artikel vil omhandle de værdifulde lektioner, vi har lært.
Fra starten har GitLab.coms servere kørt i skyen på virtuelle maskiner. Disse virtuelle maskiner administreres af Chef, og deres installation sker via vores . i tilfælde af at en opdatering af applikationen er nødvendig, består i simpelthen at opdatere serverparken i en koordineret sekventiel rækkefølge ved hjælp af en CI-pipeline. Denne metode - omend langsom og lidt — sikrer, at GitLab.com bruger de samme installa- tions- og konfigurationsmetoder som brugerne af de selvadministrerede (self-managed) installationer af GitLab, der anvender vores Linux-pakker.
Vi bruger denne metode, fordi det er yderst vigtigt at opleve alle de sorger og glæder, som de almindelige medlemmer af fællesskabet føler, når de installerer og konfigurerer deres egen GitLab. Denne tilgang har fungeret godt i et stykke tid, men da antallet af projekter på GitLab oversteg 10 millioner, indså vi, at den ikke længere opfylder vores behov for skalering og udrulning.
De første skridt mod Kubernetes og cloud-native GitLab
I 2017 blev projektet til at forberede GitLab til implementering i skyen samt at give brugerne mulighed for at installere GitLab i Kubernetes-klynger. Dengang vidste vi, at flytningen af GitLab til Kubernetes ville øge skaleringsmulighederne for vores SaaS-platform, forenkle implementeringen og forbedre udnyttelsen af beregningressourcer. Samtidig var mange funktioner i vores applikation afhængige af monterede NFS-partitioner, hvilket hæmmede overgangen fra virtuelle maskiner.
Stræben efter cloud-native og Kubernetes har gjort det muligt for vores ingeniører at planlægge en gradvis overgang, hvor vi har afvist nogle applikationsafhængigheder til netværkslagring, mens vi fortsat har udviklet nye funktioner. Siden vi begyndte at planlægge migrationen sommeren 2019, er mange af disse begrænsninger blevet elimineret, og processen med at overføre GitLab.com til Kubernetes er nu i fuld gang!
Funktionerne i GitLab.com i Kubernetes
Til GitLab.com bruger vi en enkelt regional GKE-klynge, der håndterer al applikationens trafik. For at minimere kompleksiteten i den allerede komplekse migration fokuserer vi på tjenester, der ikke afhænger af lokal lagring eller NFS. GitLab.com bruger primært en monolitisk kodebase bygget på Rails, og vi dirigerer trafikken baseret på karakteristika fra arbejdsbelastningen til forskellige endpoints, der er isoleret i deres egne nodepuljer.
I tilfælde af frontend opdeles disse typer i forespørgsler til web, API, Git SSH/HTTPS og Registry. I tilfælde af backend opdeler vi jobs i køerne baseret på forskellige karakteristika alt efter , som gør det muligt for os at sætte servicemål (Service-Level Objectives, SLOs) for forskellige belastninger.
Alle disse tjenester på GitLab.com er konfigureret ved hjælp af den uændrede Helm-chart for GitLab. Konfigurationen udføres i subcharts, der selektivt kan aktiveres, efterhånden som vi gradvist flytter tjenester til klyngen. Selvom det er besluttet ikke at inkludere nogle af vores stateful-tjenester, såsom Redis, Postgres, GitLab Pages og Gitaly, i migrationen, tillader brugen af Kubernetes os at reducere antallet af VM'er, som Chef for tiden administrerer, radikalt.
Transparens og konfigurationsstyring i Kubernetes
Alle indstillinger håndteres af GitLab selv. Der bruges tre konfigurationsprojekter baseret på Terraform og Helm. Vi forsøger overalt at bruge GitLab til at starte GitLab, men til driftsopgaver har vi en separat installation af GitLab. Denne er nødvendig for at undgå afhængighed af tilgængeligheden af GitLab.com ved udrulninger og opdateringer af GitLab.com.
Selvom vores pipelines til Kubernetes-klyngen kører på en separat installation af GitLab, har kode-repositorierne spejle, der er offentligt tilgængelige på følgende adresser:
- — konfiguration af GitLab.com til Helm-diagrammet GitLab;
- — indeholder konfigurationer til tjenester, der ikke er direkte relateret til applikationen GitLab. Disse inkluderer konfigurationer til logføring og overvågning af klyngen samt til integrerede værktøjer som PlantUML;
- — Terraform-konfiguration for Kubernetes og den gamle (legacy) VM-infrastruktur. Her konfigureres alle ressourcer, der er nødvendige for at starte klyngen, herunder selve klyngen, nodepuljer, servicekonti, og reservation af IP-adresser.

Når der foretages ændringer, vises en offentlig med et link til en detaljeret diff, som SRE analyserer, før ændringerne anvendes i klyngen.
For SRE fører linket til en detaljeret diff i den GitLab-installation, der bruges til drift, og hvor adgangen er begrænset. Dette giver medarbejdere og fællesskabet uden adgang til driftsprojektet (som kun er åbent for SRE) mulighed for at se de foreslåede ændringer i konfigurationen. Ved at kombinere den offentlige GitLab-forekomst til kode med en privat forekomst til CI-pipelines, opretholder vi en samlet arbejdsproces, samtidig med at vi sikrer uafhængighed fra GitLab.com ved konfigurationsopdateringer.
Hvad vi har lært under migrationen
I løbet af flytningen er der opnået erfaring, som vi anvender på nye migrationer og implementeringer i Kubernetes.
1. Stigning i omkostninger på grund af trafik mellem tilgængelighedszoner
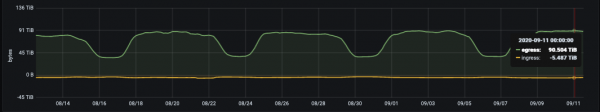
Daglig egress-statistik (byte pr. dag) for parken af Git-lager på GitLab.com
Google opdeler sit netværk i regioner. Disse deles videre op i tilgængelighedszoner (AZ). Git-hosting er forbundet med store datamængder, så det er vigtigt for os at kontrollere netværks-egress. Egress er gratis for intern trafik, hvis den forbliver inden for en enkelt tilgængelighedszone. På tidspunktet for denne artikels skrivning overfører vi cirka 100 TB data på en almindelig arbejdsdag (og det er kun for Git-repositories). Tjenester, som i vores gamle VM-baserede topologi var på de samme virtuelle maskiner, kører nu i forskellige Kubernetes-pods. Det betyder, at en del af trafikken, der tidligere var lokal for VM, potentielt kan overskride grænserne for tilgængelighedszoner.
Regionale GKE-klynger muliggør dækning af flere tilgængelighedszoner for redundans. Vi overvejer muligheden for for tjenester, der genererer store mængder trafik. Dette vil reducere omkostningerne ved egress samtidig med, at klynge-niveauet for redundans opretholdes.
2. Grænser, ressourceanmodninger og skalering
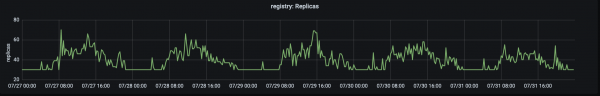
Antallet af replikaer, der håndterer produktionstrafik på registry.gitlab.com. Trafikken tager mest fart omkring kl. 15:00 UTC.
Vores migrationshistorie begyndte i august 2019, da vi flyttede den første tjeneste - GitLab Container Registry - til Kubernetes. Denne kritiske tjeneste med høj trafik var ideel til første migration, da den er en stateless-applikation med få eksterne afhængigheder. Det første problem, vi stødte på, var et stort antal udstødte pods på grund af manglende hukommelse på noderne. På grund af dette måtte vi justere anmodningerne og grænserne.
Det blev konkluderet, at for applikationer, hvor hukommelsesforbruget vokser over tid, førte lave værdier for anmodningerne (der reserverer hukommelse for hver pod) sammen med en 'generøs' hård grænse for brug til mætning (saturation) af noderne og et højt niveau af udstødnings. For at tackle dette problem blev det . Dette har lettet presset på noderne og sikret en livscyklus for pod'erne, der ikke lægger for meget pres på noden. Nu begynder vi migrationerne med generøse (og næsten ensartede) værdier for request og limits, og justerer dem efter behov.
3. Metrier og logfiler
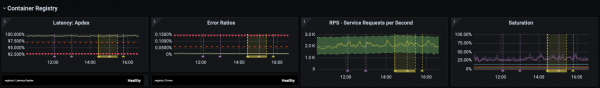
Infrastrukturafdelingen fokuserer på latens, fejlrater og saturation med fastsatte (SLO), knyttet til .
I det forgangne år har en af de nøglebegivenheder i infrastrukturafdelingen været forbedringerne i overvågning og arbejde med SLO. SLO har gjort det muligt for os at fastsætte mål for de enkelte tjenester, som vi nøje har overvåget under migrationen. Men selv med en sådan forbedret synlighed er det ikke altid muligt at se problemer med det samme ved hjælp af metrier og alarmer. For eksempel, ved at fokusere på latens og fejlrater dækker vi ikke fuldt ud alle brugsscenarier for tjenesten, der gennemgår migrationen.
Dette problem blev opdaget næsten med det samme efter overførslen af en del af arbejdsbelastningen til klyngen. Det kom især til udtryk, når der skulle kontrolleres funktioner, hvor antallet af forespørgsler er lille, men som har meget specifikke konfigurationsafhængigheder. En af de vigtigste læringer fra migrationen var nødvendigheden af at tage hensyn til ikke kun metrier, men også logfiler og 'lange haler' (det handler om på grafen — bem. overs.) af fejl. Nu for hver migration inkluderer vi en detaljeret liste over forespørgsler til logfilerne (log queries) og planlægger klare tilbageføringsprocedurer, som i tilfælde af problemer kan overføres fra et skift til et andet.
Parallel betjening af de samme forespørgsler på den gamle VM-infrastruktur og den nye baseret på Kubernetes udgjorde en unik udfordring. I modsætning til en lift-and-shift migration (hurtig overførsel af applikationer 'som de er' til den nye infrastruktur; mere info kan findes, for eksempel, — red. anm.), parallel arbejdet på "gamle" VM og Kubernetes kræver, at overvågningsværktøjerne er kompatible med begge miljøer og kan kombinere målinger i én visning. Det er vigtigt, at vi bruger de samme dashboards og logforespørgsler for at opnå konsistent synlighed i overgangsperioden.
4. Omdannelse af trafikken til det nye cluster
For GitLab.com tildeles en del af serverne til . Kanariefarmen betjener vores interne projekter, og det kan også . Men først og fremmest er den beregnet til at teste de ændringer, der foretages i infrastrukturen og applikationen. Den første overførte service begyndte med at modtage et begrænset volumen intern trafik, og vi fortsætter med at bruge denne metode for at sikre, at SLO overholdes, før vi sender al trafik til clustret.
I tilfælde af migration betyder det, at anmodninger til interne projekter først sendes til Kubernetes, hvorefter vi gradvist skifter resten af trafikken til clustret ved at justere vægten for backend via HAProxy. I overgangen fra VM til Kubernetes blev det klart, at det var meget fordelagtigt at have en enkel metode til at omdirigere trafik mellem den gamle og den nye infrastruktur og dermed holde den gamle infrastruktur klar til tilbagevenden i de første par dage efter migrationen.
5. Reservekapacitet for pods og deres anvendelse
Næsten med det samme blev følgende problem identificeret: pods til Registry-tjenesten startede hurtigt, men det tog op til . Den langvarige opstart af pods for Sidekiq blev et problem, da vi begyndte at migrere arbejdsbyrder for workers i Kubernetes, som skal behandle job hurtigt og skaleres hurtigt.
I dette tilfælde var lektien, at selvom Horizontal Pod Autoscaler (HPA) i Kubernetes er god til at håndtere en stigning i trafikken, er det vigtigt at tage hensyn til karakteristika for arbejdsbyrderne og afsætte reservekapacitet for pods (især under ujævn efterspørgsel). I vores tilfælde blev der observeret en pludselig stigning i job, hvilket førte til hurtig skalering, der resulterede i mætning af CPU-ressourcer, før vi kunne skalere nodepuljen.
Der er altid en fristelse for at 'maksimere' udbyttet fra klyngen, men vi, der oprindeligt stødte på problemer med ydeevnen, starter nu med et generøst pod-budget og reducerer det senere, mens vi nøje overvåger SLO. At starte pod'er til Sidekiq-tjenesten er blevet markant hurtigere og tager nu i gennemsnit omkring 40 sekunder. fik både GitLab.com og vores self-managed installationsbrugere, der arbejder med den officielle Helm-chart fra GitLab, glæde af det.
Konklusion
Efter at have flyttet hver tjeneste, nød vi fordelene ved at bruge Kubernetes i produktion: hurtigere og mere sikker deployment af applikationer, skalering og mere effektiv ressourcefordeling. Desuden strækker fordelene ved migrationen sig ud over tjenesten GitLab.com. Alle forbedringer af den officielle Helm-chart gavner også dens brugere.
Jeg håber, at I nød historien om vores oplevelser med migrationen til Kubernetes. Vi fortsætter med at flytte flere og flere tjenester til klyngen. Yderligere information kan findes i følgende publikationer:
- «»;
- «»;
- .
P.S. fra oversætteren
Læs også på vores blog:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
