

Som bekendt tilbyder SAP en komplet vifte af software til både håndtering af transaktionsdata og behandling af disse data i analyse- og rapporteringssystemer. Især er SAP Business Warehouse (SAP BW) en platform, der fungerer som værktøj til dataopbevaring og analyse med omfattende tekniske muligheder. På trods af sine objektive fordele har systemet SAP BW en betydelig ulempe. Det er de høje omkostninger ved opbevaring og behandling af data, hvilket især er tydeligt, når man bruger cloud-løsningen SAP BW on HANA.
Hvad nu hvis vi begyndte at bruge et non-SAP lager, helst et OpenSource produkt? Vi i X5 Retail Group har valgt GreenPlum. Dette løser selvfølgelig omkostningsproblemet, men der opstår straks spørgsmål, som næsten blev løst automatisk ved brug af SAP BW.
Især hvordan man henter data fra kilde-systemer, som for det meste er SAP-løsninger?
"HR-metrics" blev det første projekt, hvor denne udfordring skulle løses. Vores mål var at oprette et lager af HR-data og udvikle analytiske rapporter om arbejdet med ansatte. Den primære datakilde er SAP HCM, som håndterer alle personalemæssige, organisatoriske og lønrelaterede aktiviteter.
Dataekstraktion
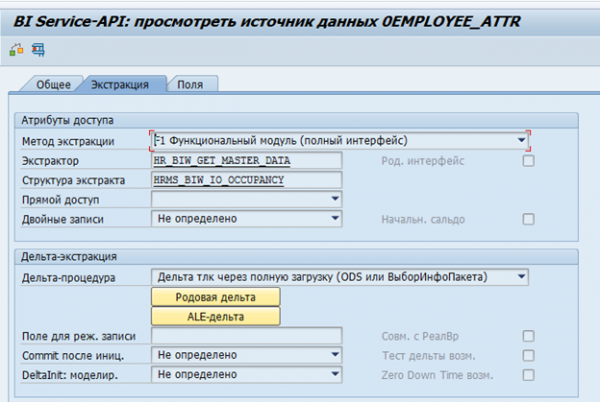
I SAP BW findes der standard dataekstraktorer til SAP-systemer. Disse ekstraktorer kan automatisk indsamle de nødvendige data, overvåge deres integritet og bestemme ændringsdeltaer. Her er for eksempel en standard datakilde for medarbejderattributter 0EMPLOYEE_ATTR:
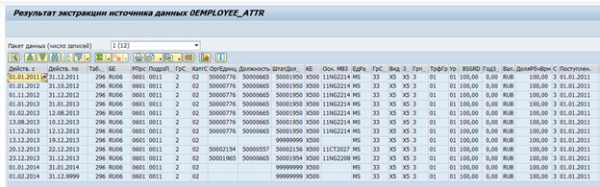
Resultatet af dataekstraktionen for én medarbejder:
Om nødvendigt kan en sådan ekstraktor tilpasses specifikke krav, eller der kan oprettes en egen ekstraktor.
Ideen om muligheden for genbrug opstod først. Desværre viste det sig at være en urealiserbar opgave. Størstedelen af logikken er implementeret på SAP BW-siden, og det var ikke muligt at adskille ekstraktoren på kilden fra SAP BW uden problemer.
Det blev klart, at der var behov for at udvikle en egen mekanisme til dataudtræk fra SAP-systemer.
Dataopbevaringsstrukturen i SAP HCM
For understanding the requirements for such a mechanism, we must first determine which specific data we will need.
Most data in SAP HCM is stored in flat SQL tables. Based on this data, SAP applications visualize organizational structures, employees, and other HR information to the user. For example, this is what the organizational structure looks like in SAP HCM:
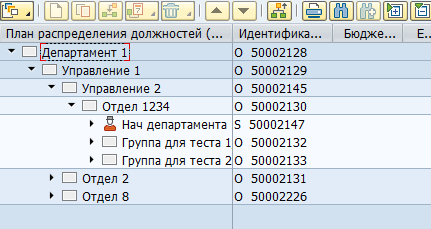
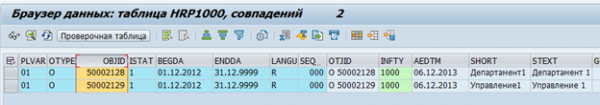
Physically, such a tree is stored in two tables — in hrp1000 objects and in hrp1001 the links between these objects.
Objects "Department 1" and "Management 1":
The link between objects:
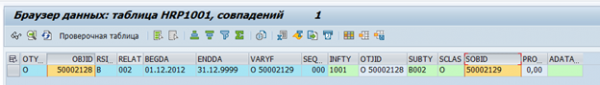
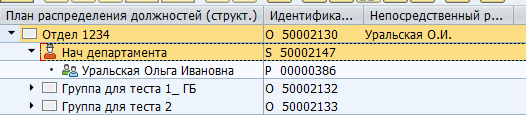
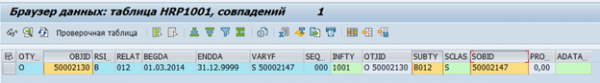
There can be a vast number of both object types and connection types between them. There are standard connections between objects as well as customized ones for specific needs. For example, the standard connection B012 between an organizational unit and a position indicates the manager of the department.
Displaying the manager in SAP:
Storage in the database table:
Employee data is stored in tables pa*. For example, data on employee personnel events is stored in the table pa0000.
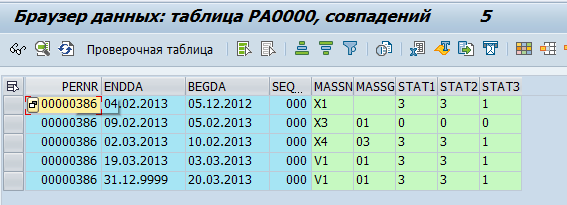
We decided that GreenPlum will fetch the "raw" data, i.e. simply copy it from the SAP tables. And directly in GreenPlum, it will be processed and converted into physical objects (for instance, Department or Employee) and metrics (for example, average headcount).
Approximately 70 tables were identified, the data from which needs to be transferred to GreenPlum. After this, we began working on the method of transferring this data.
SAP offers a significant number of integration mechanisms. However, the simplest way — direct access to the database is prohibited due to licensing restrictions. Thus, all integration flows must be implemented at the level of server applications.
The next problem was the absence of data on deleted records in the SAP database. When a row is deleted in the database, it is physically removed. That is, forming a delta of changes over the time of change was not possible.
Of course, SAP HCM has mechanisms for recording data changes. For subsequent transmission to receiving systems, there are change pointers that record any changes and based on which Idoc (an object for transferring to external systems) is generated.
Eksempel på IDoc ændring af infotypen 0302 for en medarbejder med personalenummer 1251445:
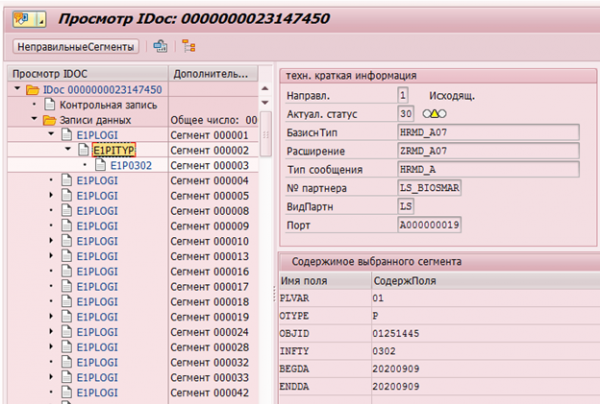
Eller logføring af ændringer i data i tabellen DBTABLOG.
Eksempel på log for sletning af posten med nøgle QK53216375 fra tabellen hrp1000:
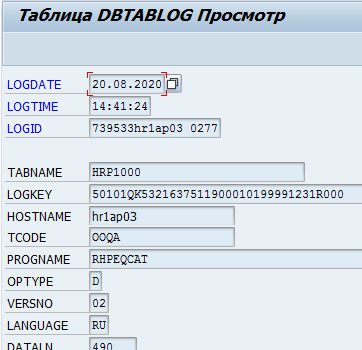
Men disse mekanismer er ikke tilgængelige for alle nødvendige data, og deres behandling på serverniveau kan kræve en del ressourcer. Derfor kan en massiv aktivering af logføring for alle nødvendige tabeller føre til mærkbar degradering af systemets ydeevne.
Et næste alvorligt problem var klyngede tabeller. Data vedrørende tidsbedømmelse og lønberegning i RDBMS version SAP HCM opbevares som et sæt logiske tabeller for hver medarbejder pr. beregning. Disse logiske tabeller gemmes som binære data i tabellen pcl2.
Klynge for lønberegning:
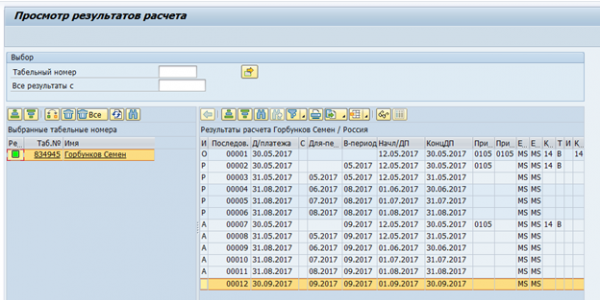
Data fra klyngetabeller kan ikke læses med en SQL-kommando, men kræver brug af SAP HCM makrobefalinger eller specielle funktionsmoduler. Derfor vil læsehastigheden for sådanne tabeller være relativt lav. På den anden side indeholder sådanne klynger data, der kun er nødvendige en gang om måneden – den samlede lønberegning og tidsbedømmelse. Så hastigheden er ikke så kritisk i dette tilfælde.
Ved at vurdere mulighederne for dannelse af ændringsdeltaer besluttede vi også at se på muligheden for en fuld eksport. Muligheden for dagligt at overføre gigabyte af uændrede data mellem systemerne ser ikke særlig appetitlig ud. Men den har også flere fordele – der er ikke behov for hverken at implementere deltaen på kildesiden eller at integrere denne delta på modtagerens side. Dette reducerer omkostningerne og tidsrammerne for implementeringen samt øger pålideligheden af integrationen. Det blev konstateret, at næsten alle ændringer i SAP HR finder sted inden for en periode på tre måneder før den nuværende dato. Dermed blev beslutningen truffet om at stoppe ved en daglig fuld eksport af data fra SAP HR for N måneder før den nuværende dato og om en månedlig fuld eksport. Parameteren N afhænger af den specifikke tabel
og varierer fra 1 til 15.
Der blev foreslået følgende skema for datakstraktion:
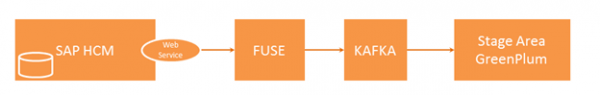
Det eksterne system genererer en forespørgsel og sender den til SAP HCM, hvor forespørgslen kontrolleres for dataløshed og adgangsretter til tabellerne. Ved en vellykket kontrol udføres et program i SAP HCM, som indsamler de nødvendige data og sender dem til integreringsløsningen Fuse. Fuse bestemmer det nødvendige emne i Kafka og sender dataene dertil. Derefter overføres dataene fra Kafka til Stage Area GP.
I denne kæde er vi interesserede i spørgsmålet om dataudvinding fra SAP HCM. Lad os se nærmere på det.
Samarbejdsschema for SAP HCM-FUSE.
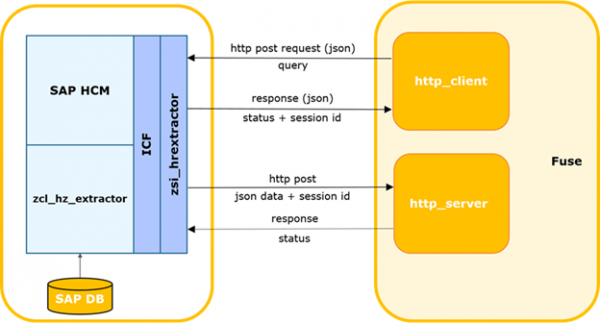
Det eksterne system bestemmer tidspunktet for den seneste vellykkede forespørgsel til SAP.
Processen kan startes ved timer eller en anden begivenhed, inklusiv at der kan være en timeout for at vente på svar med data fra SAP og initiering af en gentagen forespørgsel. Derefter dannes en delta-forespørgsel, som sendes til SAP.
Dataene i forespørgslen sendes i body i json-format.
Http-metode: POST.
Eksempel på forespørgsel:
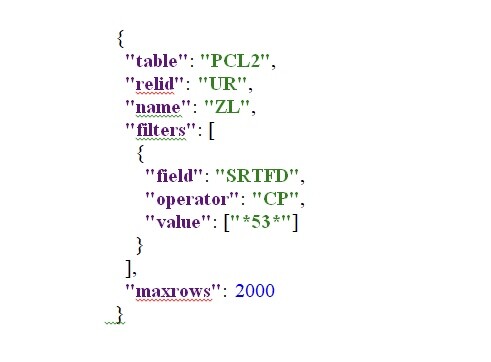
SAP-tjenesten udfører kontrol af forespørgslen for fuldstændighed, overensstemmelse med den nuværende struktur for SAP, samt tilstedeværelsen af adgangstilladelse til den anmodede tabel.
I tilfælde af fejl returnerer tjenesten et svar med den relevante kode og beskrivelse. Ved vellykket kontrol opretter den en baggrundsproces for at generere en dataudtræk, genererer og synkront returnerer en unik session-id.
Det eksterne system registrerer en fejl i loggen i tilfælde af en fejl. Ved et vellykket svar overfører det session-id'et og navnet på tabellen, som forespørgslen blev lavet til.
Det eksterne system registrerer den aktuelle session som åben. Hvis der er andre sessioner på den pågældende tabel, lukkes de med registrering af en advarsel i loggen.
Den baggrundsopgave i SAP danner en cursor baseret på de givne parametre og et datarapport i en given størrelse. Størrelsen af datapakken er det maksimale antal poster, som processen læser fra databasen. Standardværdien er 2000. Hvis der i databasens udtræk er flere poster end den anvendte pakke størrelse, dannes næste blok med den relevante offset og inkrementerede pakkenummer efter overførsel af den første pakke. Numrene inkrementeres med 1 og sendes strikt sekventielt.
Derefter sender SAP pakken til indgangen af en webservice i et eksternt system. Dette system kontrollerer den indkommende pakke. Der skal være registreret en session med det modtagne id, og den skal være i åben status. Hvis pakkenummeret > 1, skal der være registreret en succesfuld modtagelse af den forrige pakke (package_id-1).
Ved en vellykket kontrol parser det eksterne system data fra tabellen og gemmer den.
Derudover, hvis pakken indeholder flaget final, og serialiseringen er lykkedes, sendes der en meddelelse til integrationsmodulet om, at sessionen er blevet behandlet med succes, og modulet opdaterer sessionens status.
I tilfælde af fejl ved kontrollerne/parsing logges fejlen, og pakkerne for denne session vil blive afvist af det eksterne system.
Og omvendt, når det eksterne system returnerer en fejl, logges den, og overførslen af pakker stoppes.
For at anmode om data fra SAP HCM er der blevet implementeret en integrationsservice. Servicen er bygget på ICF-rammeværket (SAP Internet Communication Framework - ). Den gør det muligt at anmode om data fra SAP HCM-systemet fra bestemte tabeller. Når dataanmodningen oprettes, er der mulighed for at angive en liste over specifikke felter og filtreringsparametre for at opnå de nødvendige data. Implementeringen af servicen inkluderer ikke nogen forretningslogik. Algoritmer til beregning af delta, anmodningsparametre, integritetskontrol osv. implementeres også i det eksterne system.
Denne mekanisme gør det muligt at samle og overføre alle nødvendige data på få timer. Denne hastighed er på grænsen til acceptabel, så denne løsning betragtes af os som midlertidig, og den har dækket behovet for et ekstraktionsværktøj i projektet.
I det målrettede billede for løsningen af dataekstraktionsopgaven undersøges mulighederne for at bruge CDC-systemer som Oracle Golden Gate eller ETL-værktøjer som SAP DS.
Kilde: habr.com
