

Mange mener, at det er tilstrækkeligt at flytte applikationen til Kubernetes (enten via Helm eller manuelt) - så vil lykken være gjort. Men det er ikke så enkelt.
Kommandoen Jeg har oversat artiklen fra DevOps-ingeniør Julian Gindi. Han fortæller om de faldgruber, hans virksomhed stødte på under migrationen, så du ikke skal træde i de samme fælder.
Trin et: konfiguration af pod-forespørgsler og grænser
Lad os starte med at indstille et rent miljø, hvor vores pods vil fungere. Kubernetes håndterer pod-planlægning og fejlhåndtering fremragende. Men det viste sig, at planlæggeren nogle gange ikke kan placere en pod, hvis den har svært ved at vurdere, hvor mange ressourcer der er nødvendige for korrekt drift. Her kommer forespørgsler på ressourcer og grænser ind i billedet. Der er mange diskussioner om den bedste tilgang til at konfigurere forespørgsler og grænser. Nogle gange forekommer det, at det snarere er en kunst end en videnskab. Her er vores tilgang.
Pod-forespørgsler (pod requests) er den vigtigste værdi, der anvendes af planlæggeren til optimal placering af pod'en.
Af : i filtreringstrinnet bestemmes det sæt noder, hvor pod'en kan planlægges. For eksempel kontrollerer filteret PodFitsResources, om der er tilstrækkelige ressourcer på noden til at opfylde pod'ens specifikke ressourcønsker.
Vi bruger applikationsforespørgsler, så vi kan vurdere, hvor mange ressourcer har vi virkelig applikationen har brug for for at fungere korrekt. På den måde kan planlæggeren realistisk placere noderne. Oprindeligt ønskede vi at sætte forespørgsler med en margen for at sikre, at der var tilstrækkelige ressourcer til hver pod, men vi bemærkede, at planlægningstiden steg betydeligt, og nogle pods blev aldrig helt planlagt, som om der ikke var nogen ressourcerequest for dem.
I sådanne tilfælde 'pressede' planlæggeren ofte pods og kunne ikke planlægge dem igen, fordi kontrolplanet ingen anelse havde om, hvor mange ressourcer applikationen ville kræve, og det er en nøglekomponent i planlægningsalgoritmen.
Pod-grænser (pod limits) er en klarere grænse for pod'en. Den repræsenterer det maksimale beløb af ressourcer, som klyngen vil tildele containeren.
Igen, fra : hvis der er sat en hukommelsesgrænse på 4 GiB for containeren, så vil kubelet (og container runtime) tvinge denne grænse. Runtime tillader ikke containeren at bruge mere end den angivne ressourcegrænse. For eksempel, når en proces i containeren forsøger at bruge mere hukommelse end tilladt, afslutter systemets kerne denne proces med fejlen 'out of memory' (OOM).
En container kan altid bruge mere ressourcer end angivet i ressourceanmodningen, men kan aldrig bruge mere end angivet i grænsen. Det er svært at fastsætte denne værdi korrekt, men det er meget vigtigt.
Ideelt set ønsker vi, at ressourcekravene for pod'en ændres i løbet af proceslivscyklussen, uden at det påvirker andre processer i systemet — dette er målet med at sætte grænser.
Desværre kan jeg ikke give konkrete retningslinjer for, hvilke værdier der skal indstilles, men vi følger selv disse regler:
- Ved hjælp af et belastningstestværktøj modellerer vi det grundlæggende trafikniveau og observerer ressourceforbruget for pod'en (hukommelse og CPU).
- Vi indstiller pod'ens anmodninger til et vilkårligt lavt niveau (med ressourcestyring cirka 5 gange højere end anmodningsværdierne) og observerer. Når anmodningerne er for lave, kan processen ikke starte, hvilket ofte forårsager mystiske runtime-fejl i Go.
Jeg vil gerne påpege, at højere ressourcegrænser komplicerer planlægningen, eftersom pod'en har brug for en målknude med tilstrækkelige tilgængelige ressourcer.
Forestil dig en situation, hvor du har en letvægts webserver med en meget høj ressourcegrænse, for eksempel 4 GB hukommelse. Sandsynligvis skal denne proces skaleres horisontalt, og hver ny enhed skal planlægges på en knude med mindst 4 GB tilgængelig hukommelse. Hvis en sådan knude ikke findes, skal klyngen introducere en ny knude for at håndtere denne pod, hvilket kan tage noget tid. Det er vigtigt at minimere forskellen mellem ressourceanmodninger og grænser for at sikre hurtig og glidende skalering.
Trin to: opsætning af Liveness- og Readiness-tests
Dette er et andet komplekst emne, der ofte diskuteres i Kubernetes-fællesskabet. Det er vigtigt at have en god forståelse for livstest (Liveness) og beredskabstest (Readiness), da de sikrer en stabil drift af softwaren og minimerer nedetid. Men de kan have en alvorlig indvirkning på ydeevnen af din applikation, hvis de ikke er korrekt konfigureret. Nedenfor er et kort overblik over, hvad begge prøver indebærer.
Liveness viser, om containeren fungerer. Hvis den fejler, dræber kubelet containeren, og genstartspolitikken træder i kraft. Hvis containeren ikke er udstyret med en Liveness-prøve, vil standardstatus være succes — som nævnt i .
Liveness-prøver skal være billige, dvs. de må ikke forbruge mange ressourcer, da de kører ofte og skal informere Kubernetes om, at applikationen er i gang.
Hvis du indstiller parameteren til at køre hvert sekund, tilføjer det 1 anmodning pr. sekund, så vær opmærksom på, at yderligere ressourcer vil være nødvendige for at håndtere denne trafik.
I vores virksomhed kontrollerer Liveness-testene de grundlæggende komponenter i applikationen, selv når data (f.eks. fra en ekstern database eller cache) ikke er helt tilgængelige.
Vi har konfigureret en 'livstest'-endepunkt i applikationerne, der simpelthen returnerer statuskode 200. Det er et tegn på, at processen er i gang og i stand til at håndtere anmodninger (men endnu ikke trafik).
Prøve Readiness angiver, om containeren er klar til at håndtere anmodninger. Hvis beredskabstesten fejler, fjerner endpointcontrolleren pod'ens IP-adresse fra endpoints for alle tjenester, der svarer til pod'en. Dette er også nævnt i Kubernetes-dokumentationen.
Readiness-prøver forbruger flere ressourcer, da de skal nå backend på en måde, der viser, at applikationen er klar til at modtage anmodninger.
I samfundet er der mange diskussioner om, hvorvidt man skal kontakte databasen direkte. Given overheadet (kontroller udføres ofte, men det kan justeres), har vi besluttet, at for nogle applikationer tæller beredskabsberedskab kun, efter at det er bekræftet, at databasen returnerer poster. Velovervejede tests af beredskab har sikret et højere niveau af tilgængelighed og fjernet nedetid under implementering.
Hvis du beslutter dig for at lave en databaseforespørgsel for at bekræfte applikationens beredskab, skal du sørge for, at den er så omkostningseffektiv som muligt. Lad os tage denne forespørgsel:
SELECT small_item FROM table LIMIT 1Her er et eksempel på, hvordan vi konfigurerer disse to værdier i Kubernetes:
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
Der kan tilføjes nogle ekstra konfigurationsparametre:
initialDelaySeconds— hvor mange sekunder der går mellem containerens opstart og starten af prøvningen.periodSeconds— ventetiden mellem prøver.timeoutSeconds— antal sekunder, hvorefter pod'en betragtes som defekt. En almindelig timeout.failureThreshold— antal testfejl, før pod'en får et reboot signal.successThreshold— antal succesfulde prøver, før pod'en overgår til beredskabsstatus (efter et nedbrud, når pod'en starter op eller genoprettes).
Trin tre: konfiguration af standard netværkspolitikker for pod.
I Kubernetes er den "flade" netværkstopologi, at alle pods som standard kan kommunikere direkte med hinanden. I nogle tilfælde er dette uønsket.
Et potentielt sikkerhedsproblem er, at en angriber kan udnytte et enkelt sårbart program til at sende trafik til alle pods i netværket. Som i mange områder af sikkerhed gælder princippet om den mindste privilegium her. Ideelt set skal netværkspolitikker klart angive, hvilke forbindelser mellem pods der er tilladt, og hvilke der ikke er.
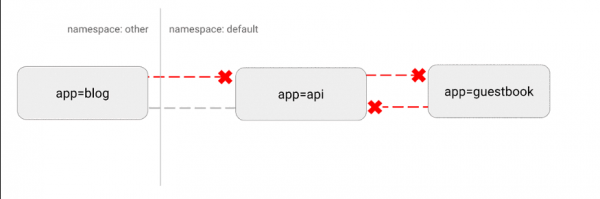
For eksempel er her en simpel politik, der forbyder al indgående trafik til et specifikt navnerum:
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Visualisering af denne konfiguration:
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Mere detaljeret .
Fjerde trin: brugerdefineret adfærd med hooks og init-containere
En af vores største opgaver var at sikre deployment i Kubernetes uden nedetid for udviklere. Dette er svært på grund af de mange måder, applikationer kan stoppe og frigive de ressourcer, de har brugt.
Særlige vanskeligheder opstod med . Vi bemærkede, at aktive forbindelser blev afbrudt, før disse pods blev afsluttet med succes.
Efter omfattende undersøgelser på internettet fandt vi ud af, at Kubernetes ikke venter på, at Nginx-forbindelserne er udtømt, inden det afslutter pod'en. Med pre-stop hook'en implementerede vi denne funktionalitet og helt eliminerede nedetid:
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
Og her nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
En anden ekstremt nyttig paragdigme er brugen af init-containere til at håndtere opstart af specifikke applikationer. Dette er især nyttigt, hvis du har en ressourcekrævende database migrationsproces, som skal køres inden applikationen starter. For denne proces kan du også angive en højere ressourcelimit uden at sætte en sådan grænse for hovedapplikationen.
En anden almindelig ordning indebærer adgang til hemmeligheder i init-containeren, som leverer disse legitimationsoplysninger til hovedmodulet, hvilket forhindrer uautoriseret adgang til hemmeligheder fra selve hovedmodulet.
Som sædvanligt, et citat fra dokumentationen: init-containere kører sikkert brugerdefineret kode eller værktøjer, der ellers ville kompromittere sikkerheden i applikationens containerbillede. Ved at opbevare unødvendige værktøjer separat begrænser du angrebsoverfladen af applikationens containerbillede.
Femte trin: konfiguration af kernen
Til sidst vil vi tale om en mere avanceret teknik.
Kubernetes er en ekstremt fleksibel platform, der giver dig mulighed for at køre arbejdsbelastninger, som du ønsker. Vi har en række højtydende applikationer, der kræver ekstremt mange ressourcer. Efter omfattende belastningstestning fandt vi ud af, at en af applikationerne havde svært ved at håndtere den forventede trafikbelastning, når standard Kubernetes-indstillingerne var aktive.
Kubernetes giver dog mulighed for at køre en privilegeret container, der ændrer kernelparametre kun for den specifikke pod. Her er hvad vi brugte til at ændre det maksimale antal åbne forbindelser:
initContainers:
  - name: sysctl
     image: alpine:3.10
     securityContext:
         privileged: true
      command: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
Dette er en mere avanceret teknik, der ofte ikke er nødvendig. Men hvis din applikation har svært ved at klare et stort belastning, kan du forsøge at justere nogle af disse parametre. Mere information om denne proces og justering af forskellige værdier – som altid .
Afslutningsvis
Selvom Kubernetes kan synes som en færdig løsning 'ud af boksen', er det nødvendigt at tage nogle nøgletrin for at sikre applikationers stabil drift.
Under hele migreringen til Kubernetes er det vigtigt at følge 'cyklussen for belastningstestning': du starter applikationen, tester den under belastning, overvåger metrics og opførsel under skalering, justerer konfigurationen baseret på disse data og gentager derefter cyklussen.
Evaluer realistisk den forventede trafik og prøv at presse den til det yderste for at se, hvilke komponenter der går i stykker først. Med en iterativ tilgang kan det være tilstrækkeligt med blot nogle få af de nævnte anbefalinger for at opnå succes. Alternativt kan der være behov for mere dybdegående justering.
Spørg dig selv altid disse spørgsmål:
- Hvor mange ressourcer forbruger applikationerne, og hvordan vil dette volumen ændre sig?
- Hvad er de reelle krav til skalering? Hvor meget trafik vil applikationen i gennemsnit håndtere? Hvad med spidsbelastning?
- Hvor ofte vil tjenesten have brug for horisontal skalering? Hvor hurtigt skal nye pods være klar til at modtage trafik?
- Hvor korrekt afsluttes pods? Er det nødvendigt? Kan der opnås udrulning uden nedetid?
- Hvordan kan man minimere sikkerhedsrisici og begrænse skaderne fra eventuelle kompromitterede pods? Har nogle tjenester tilladelser eller adgang, de ikke har brug for?
Kubernetes tilbyder en fantastisk platform, der muliggør brugen af bedste praksis til implementering af tusindvis af tjenester i et cluster. Alligevel er alle applikationer forskellige. Nogle gange kræver implementeringen lidt mere arbejde.
Heldigvis giver Kubernetes de nødvendige indstillinger for at opnå alle tekniske mål. Ved at bruge en kombination af ressourceanmodninger og grænser, Liveness og Readiness probes, init-containere, netværkspolitikker og tilpasset kernekonfiguration kan du opnå høj ydeevne sammen med fejltolerance og hurtig skalerbarhed.
Yderligere læsning:
- .
- .
- .
Kilde: habr.com
