

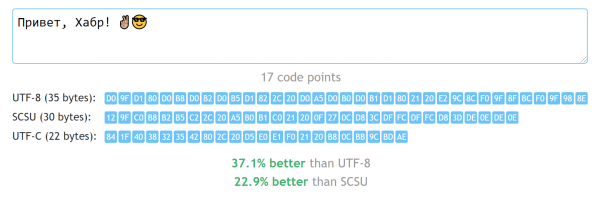
Hvis du er udvikler, og det er tid til at vælge en kodning, er det næsten altid den rigtige løsning at vælge Unicode. Den specifikke repræsentationsmetode afhænger af konteksten, men oftest er svaret også her universelt — UTF-8. Det er godt, fordi det tillader brug af alle Unicode-tegn uden at bruge for mange bytes i de fleste tilfælde. Sandt nok, for sprog der ikke kun bruger det latinske alfabet, er “ikke for mange” mindst to bytes per tegn. Er der en bedre løsning, uden at vende tilbage til forhistoriske kodninger, der begrænser os til kun 256 tilgængelige tegn?
Nedenfor vil jeg præsentere mit forsøg på at besvare dette spørgsmål samt implementeringen af en relativt enkel algoritme, der tillader opbevaring af strenge på de fleste verdenes sprog uden at tilføje den redundans, der findes i UTF-8.
Fraskrivelse. Lad mig straks komme med et par vigtige forbehold: den beskrevne løsning er ikke ment som en universel erstatning for UTF-8, den er kun velegnet i en snæver liste af tilfælde (mere om dette nedenfor), og den må under ingen omstændigheder bruges til at interagere med tredjeparts API'er (som ikke engang kender den). Ofte vil algoritmer til generel komprimering (f.eks. deflate) være passende til kompakt opbevaring af store mængder tekstdata. Desuden fandt jeg allerede under udviklingen af min løsning en eksisterende standard inden for selve Unicode, som løser den samme opgave — den er noget mere kompleks (og ofte værre), men er trods alt et accepteret standard og ikke noget, der er samlet hurtigt. Jeg vil også fortælle om det.
Om Unicode og UTF-8
For at begynde — et par ord om, hvad Unicode og UTF-8.
Som bekendt havde 8-bit kodninger tidligere popularitet. Med dem var alt enkelt: 256 tegn kan nummereres fra 0 til 255, og tallene fra 0 til 255 kan åbenlyst repræsenteres som én byte. Hvis vi ser tilbage til de tidligste dage, er ASCII-kodningen faktisk begrænset til 7 bits, så det højeste bit i dens byte-repræsentation er lig med nul, og de fleste 8-bit kodninger er kompatible med den (de adskiller sig kun i den “øverste” del, hvor det højeste bit er én).
Hvordan adskiller Unicode sig fra disse kodninger, og hvorfor knytter der sig mange specifikke repræsentationer til den — UTF-8, UTF-16 (BE og LE), UTF-32? Lad os tage det skridt for skridt.
Den grundlæggende Unicode-standard beskriver kun overensstemmelsen mellem tegn (og i nogle tilfælde — enkelte komponenter af tegn) og deres numre. Og der er mange mulige numre i denne standard — fra 0x00 op til 0x10FFFF (1 114 112 stykker). Hvis vi ønskede at placere et tal i dette interval i en variabel, ville hverken 1 eller 2 byte være tilstrækkeligt. Da vores processorer ikke er meget tilpasset til arbejde med tre-byte tal, ville vi være nødt til at bruge hele 4 byte til et enkelt tegn! Dette er UTF-32, men netop af denne "give" bruges dette format ikke populært.
Heldigvis er tegnene inden for Unicode ikke sorteret tilfældigt. Hele deres mængde er opdelt i 17 "planer", hvor hver indeholder 65536 (0x10000) «kodepunkter". Begrebet "kodepunkt" her er blot nummeret på tegnet, tildelt det af Unicode. Men som nævnt ovenfor er ikke kun individuelle tegn i Unicode nummereret, men også deres komponenter og kontrolmærker (og nogle gange svarer et nummer slet ikke til noget — måske indtil videre, men det er ikke så vigtigt for os), så det er mere korrekt altid at tale om antallet af selve numrene, ikke tegnene. Men for kortheds skyld vil jeg ofte bruge ordet "tegn", hvilket refererer til termen "kodepunkt".
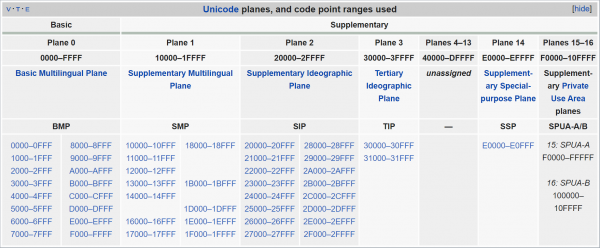
Unicode-planer. Som det kan ses, er størstedelen (planer fra 4 til 13) stadig ikke brugt.
Det mest bemærkelsesværdige er, at hele den grundlæggende "kerne" ligger i den nul-tegneplan, der hedder "Basic Multilingual Plane". Hvis strengen indeholder tekst på et af de moderne sprog (inklusive kinesisk), vil du ikke gå ud over denne plan. Men du kan heller ikke udelukke den resterende del af Unicode — for eksempel ligger emoji for det meste i slutningen af den følgende plan, "Supplementary Multilingual Plane" (den strækker sig fra 0x10000 op til 0x1FFFF). Derfor håndterer UTF-16 det sådan: Alle tegn, der falder inden for Basic Multilingual Plane, kodes "som de er" med det tilsvarende to-byte nummer. Dog betegner nogle tal i dette område slet ikke specifikke tegn, men angiver, at der efter dette byte-par skal overvejes endnu et — kombinerer man værdierne af disse fire byte, får man et tal, der dækker hele den tilladte rækkevidde af Unicode. Denne repræsentation kaldes "surrogatpar" — du har måske hørt om dem.
Dermed kræver UTF-16 to eller (i meget sjældne tilfælde) fire byte pr. "kodepunkt". Det er bedre end konstant at bruge fire byte, men latinske bogstaver (og andre ASCII-tegn) bruger i denne kodning halvdelen af rummet på nuller. UTF-8 er designet til at rette dette: ASCII optager i det kun én byte, som før; koder fra 0x80 op til 0x7FF — to byte; fra 0x800 op til 0xFFFF — tre, og fra 0x10000 op til 0x10FFFF — fire. På den ene side er det godt for latin: kompatibilitet med ASCII er tilbage, og fordelingen er mere jævnt "fordelt" fra 1 til 4 byte. Men alfabetter, der adskiller sig fra det latinske, vinder desværre ikke noget sammenlignet med UTF-16, og mange kræver nu faktisk tre byte i stedet for to — området dækket af den to-bytede repræsentation er blevet indsnævret med 32 gange, fra 0xFFFF op til 0x7FF, og det dækker ikke længere hverken kinesisk eller for eksempel georgisk. Kyrillisk og yderligere fem alfabetter — hurra — er heldige, 2 byte pr. tegn.
Hvorfor sker dette? Lad os se på, hvordan UTF-8 repræsenterer koderne for tegnene:
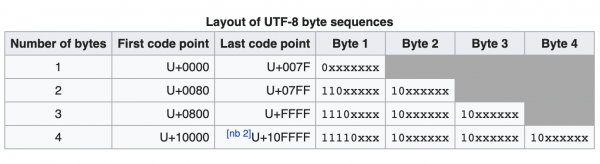
Her er bits, der er mærket med symbolet x, direkte brugt til at repræsentere numre. Det er tydeligt, at der kun er 11 af sådanne bits i den to-bytede repræsentation (ud af 16). De førende bits har kun en servicefunktion. I tilfælde af den fire-bytede repræsentation er der overhovedet afsat 21 bits ud af 32 til kodepunktsnummeret — det kunne tilsyneladende have været tilstrækkeligt med tre byte (som giver i alt 24 bits), men service-markørerne spiser for meget.
Er dette dårligt? Faktisk, ikke rigtig. På den ene side — hvis vi er meget bekymrede for det pladskrav, har vi komprimeringsalgoritmer, der let kan fjerne al overflødig entropi og redundans. På den anden side var målet med Unicode at give en så universel kodning som muligt. For eksempel kan vi stole på en tekst, der er kodet i UTF-8, til kode, der tidligere kun arbejdede med ASCII, og vi behøver ikke frygte, at den vil se et tegn fra ASCII-området, som ikke egentlig er der (for i UTF-8 er alle bytes, der starter med den nulbit, netop ASCII). Og hvis vi pludselig vil skære et lille hale af en stor streng, uden at dekode den fra starten (eller genskabe en del af informationen efter et beskadiget område) — er det ikke svært at finde den forskydning, hvor et bestemt tegn begynder (det er nok at springe over bytes, der har en bitpræfiks 10).
Hvorfor skulle man så finde på noget nyt?
Samtidig er der lejlighedsvis situationer, hvor kompressionsalgoritmer som deflate er dårligt anvendelige, men man ønsker at opnå kompakt lagring af strenge. Personligt har jeg stødt på en sådan opgave, mens jeg overvejede konstruktionen af til et stort ordforråd, der inkluderer ord på vilkårlige sprog. På den ene side er hvert ord meget kort, så at komprimere det ville være ineffektivt. På den anden side var implementeringen af træet, som jeg overvejede, beregnet til, at hvert byte af den gemte streng genererede et separat trænod, så det var meget nyttigt at minimere deres antal. I mit bibliotek (ligesom i , som det er baseret på) løses et lignende problem simpelt — strenge pakket ind i -ordbogen gemmes der i . Men som det ikke er svært at forstå, fungerer det godt kun for et begrænset alfabet — en streng på kinesisk kan ikke indgås i en sådan ordbog.
Jeg vil også nævne en anden ubehagelig nuance, der opstår ved brug af UTF-8 i en sådan datstruktur. På billedet ovenfor kan man se, at når et tegn er skrevet med to bytes, så ligger bitene vedrørende dets nummer ikke frit sammen, men er splittet af et par bit 10 i midten: 110xxxxx 10xxxxxx. På grund af dette, når de nederste 6 bit af den anden byte i tegnkoden overfyldes (dvs. når der sker et skift 10111111 → 10000000), ændres også den første byte. Det viser sig, at bogstavet «п» angives med bytes 0xD0 0xBF, og det efterfølgende «р» — allerede 0xD1 0x80. I præfikstræet fører det til deling af forælderknuden i to — en for præfikset 0xD0, og en anden for 0xD1 (selvom hele kyrillisk kunne kodes kun med den anden byte).
Hvad jeg fik
Stødt på denne opgave besluttede jeg at øve mig med bit-manipulation, og til gengæld lære lidt bedre om strukturen af Unicode generelt. Resultatet blev UTF-C kodningsformatet («C» for compact), som bruger ikke mere end 3 bytes per code point, og som ofte tillader at bruge kun et ekstra byte for hele den kodede streng. Dette fører til, at på mange ikke-ASCII alfabeter viser sådan kodning sig at være 30-60% mere kompakt end UTF-8.
Jeg har formateret eksempler på implementeringen af kodnings- og dekodingsalgoritmer i form af , du kan frit bruge dem i din kode. Men jeg vil stadig understrege, at i nogle henseender forbliver dette format en slags "cykel", og jeg anbefaler ikke at bruge det uden at forstå, hvorfor det er nødvendigt for dig. Det er trods alt mere et eksperiment end en seriøs "forbedring af UTF-8". Ikke desto mindre er koden der skrevet pænt, kortfattet, med mange kommentarer og testdækning.
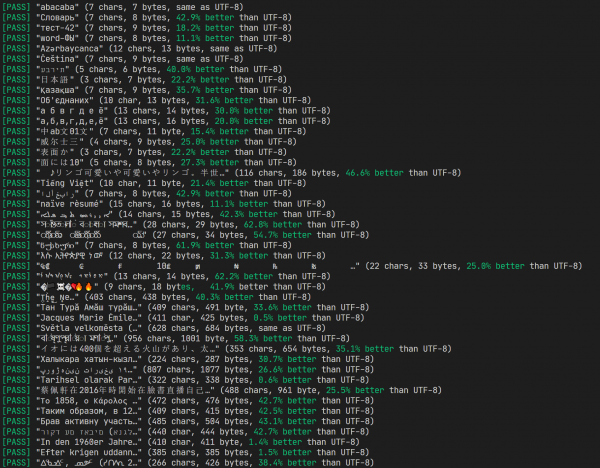
Resultatet af testene og sammenligningen med UTF-8
Jeg har også lavet , hvor du kan vurdere algoritmens arbejde, og senere vil jeg fortælle mere om dens principper og udviklingsprocessen.
Vi fjerner overflødige bits
Som grundlag tog jeg selvfølgelig UTF-8. Det første og mest åbenlyse, man kan ændre — er at reducere antallet af kontrolbits i hver byte. For eksempel starter den første byte i UTF-8 altid enten med 0, eller med 11 — mens præfikset 10 kun findes i de følgende bytes. Lad os erstatte præfikset 11 og få en fungerende kommando. 1, og fjerne præfikserne helt fra de følgende bytes. Hvad får vi så?
0xxxxxxx — 1 byte
10xxxxxx xxxxxxxx — 2 bytes
110xxxxx xxxxxxxx xxxxxxxx — 3 bytes
Stop, men hvor er den fire-byte repræsentation? Den er ikke længere nødvendig — med tre bytes har vi nu 21 bits tilgængelige, og det er mere end tilstrækkeligt til alle tal op til 0x10FFFF.
Hvad har vi ofret her? Det vigtigste — er opdagelsen af grænserne for symboler fra en vilkårlig position i bufferen. Vi kan ikke pege på en vilkårlig byte og finde starten på det næste symbol derfra. Dette er en begrænsning af vores format, men i praksis opstår behovet for det ikke ofte. Normalt kan vi løbe gennem bufferen fra begyndelsen (især når det drejer sig om korte strenge).
Situationen med dækning af sprog med 2 bytes er også blevet bedre: nu giver det to-byte format et interval på 14 bits, hvilket svarer til koder op til 0x3FFF. Kineserne har ikke held (deres tegn ligger primært i intervallet fra 0x4E00 op til 0x9FFF), men georgierne og mange andre folk har fået det sjovere — deres sprog passer også indenfor 2 bytes pr. symbol.
Vi introducerer encoderens tilstand
Lad os nu tænke på egenskaberne ved selve strenge. I ordbogen ligger de fleste ord skrevet med tegn fra samme alfabet, og dette gælder også for mange andre tekster. Det ville være godt at angive dette alfabet én gang og derefter kun angive nummeret på bogstavet inden i det. Lad os se, om placeringen af tegn i Unicode-tabellen hjælper os.
Som nævnt tidligere er Unicode opdelt i planer op til 65536 koder hver. Men dette er ikke en særlig nyttig opdeling (som allerede sagt, befinder vi os oftest i den nul-planet). En mere interessant opdeling er på blokke. Disse intervaller har ikke længere en fast længde og bærer mere mening - som regel samler hver af dem tegn fra det samme alfabet.
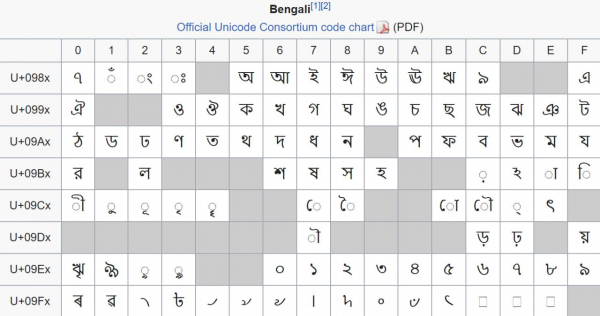
En blok, der indeholder tegn fra det bengalske alfabet. Desværre, af historiske grunde, er dette et eksempel på en ikke særlig tæt pakning - 96 tegn er spredt tilfældigt over 128 kodepunkter i blokken.
Startpunkter for blokke og deres størrelser er altid multippel af 16 - dette gøres bare for bekvemmelighed. Desuden starter og slutter mange blokke på værdier, der er multipler af 128 eller endda 256 - for eksempel optager den grundlæggende kyrilliske 256 bytes fra 0x0400 op til 0x04FF. Det er ret praktisk: hvis vi en gang gemmer et præfiks 0x04, kan ethvert kyrillisk tegn derefter skrives med én byte. Men så mister vi muligheden for at vende tilbage til ASCII (og til alle andre tegn overhovedet). Derfor gør vi det sådan:
- To bytes
10yyyyyy yxxxxxxxangiver ikke kun et tegn med nummeretyyyyyy yxxxxxxx, men ændrer også det aktuelle alfabet og få en fungerende kommando.yyyyyy y0000000(dvs. vi gemmer alle bits undtagen de laveste 7 bits); - En byte
0xxxxxxxer et tegn fra det aktuelle alfabet. Det skal blot lægges sammen med det skift, som vi huskede i trin 1. Så længe vi ikke har ændret alfabetet, er skiftet lig med nul, så vi har bevaret kompatibiliteten med ASCII.
Tilsvarende for koder, der kræver 3 bytes:
- Tre bytes
110yyyyy yxxxxxxx xxxxxxxxangiver et tegn med nummeretyyyyyy yxxxxxxx xxxxxxxx, ændrer det aktuelle alfabet og få en fungerende kommando.yyyyyy y0000000 00000000(vi huskede alt, undtagen de laveste 15 bits), og sætter et flag, at vi nu er i lang tilstand (ved tilbageveksling til det to-byte alfabet vil vi nulstille dette flag); - To bytes
0xxxxxxx xxxxxxxxi lang tilstand er det et tegn fra det aktuelle alfabet. På samme måde lægger vi det sammen med skiftet fra trin 1. Den eneste forskel er, at nu læser vi to bytes (fordi vi skiftede til denne tilstand).
Det lyder godt: nu, så længe vi skal kodificere tegn fra det samme 7-bit Unicode-område, bruger vi 1 ekstra byte i starten og kun en byte til hvert tegn.
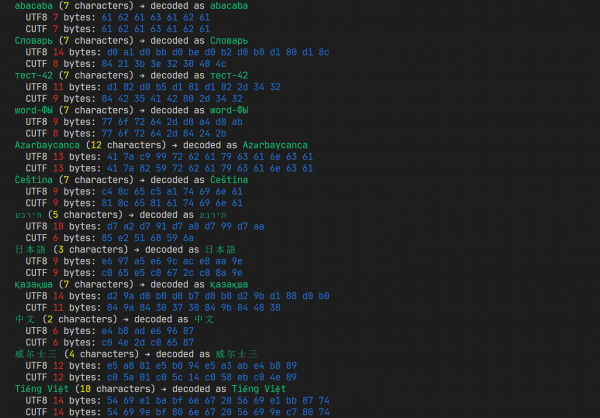
Arbejdet med en af de tidlige versioner. Undersøger ofte UTF-8, men der er stadig meget, der kan forbedres.
Hvad er blevet værre? For det første, er der kommet en tilstand, nemlig det aktuelle alfabet skift og flaget lang tilstandDette begrænser os yderligere: nu kan de samme tegn kodes forskelligt i forskellige kontekster. Søgning efter understrenge skal for eksempel gøres med dette in mente, ikke bare ved at sammenligne bytes. For det andet, så snart vi skiftede alfabet, blev ASCII-tegnkodningen et problem (og det inkluderer ikke kun det latinske alfabet, men også grundlæggende tegnsæt, herunder mellemrum) — de kræver en ny alfabetændring ved 0, dvs. endnu en byte (og derefter endnu en for at vende tilbage til vores hoved).
Én alfabet er godt, to er bedre
Lad os prøve at ændre vores bitpræfikser lidt ved at presse endnu en ind sammen med de tre ovenfor beskrevne:
0xxxxxxx — 1 byte i normal tilstand, 2 i lang tilstand
11xxxxxx — 1 byte
100xxxxx xxxxxxxx — 2 bytes
101xxxxx xxxxxxxx xxxxxxxx — 3 bytes
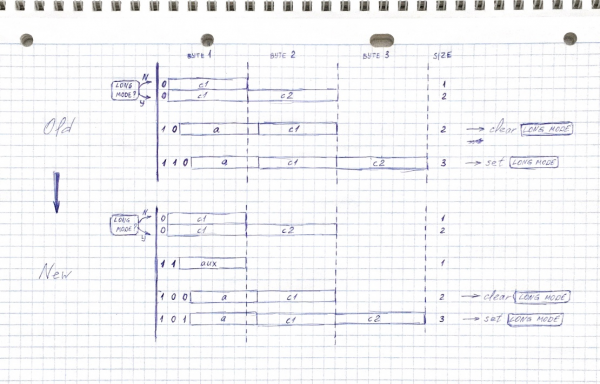
Nu er der blevet en bygbar mindre i den to-byte optagelse — kodepunkter kan nu rumme op til 0x1FFF, ikke 0x3FFF. Men der er stadig mærkbart flere end i to-byte UTF-8 koder; de fleste almindelige sprog kan stadig rummes, den mest mærkbare tab er og , japanerne er triste.
Hvad er den nye kode 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) alfabet. Når vi skifter det nuværende alfabet, bliver en del af det gamle alfabet til en hjælpealfabet. For eksempel, når vi skifter fra ASCII til kyrillisk — er der nu 64 tegn i "depotet", som indeholder det latinske alfabet, cifre, mellemrum og komma (de mest almindelige indsatser i ikke-ASCII tekster). Når vi skifter tilbage til ASCII — vil det hjælpe alfabet omfatte hovedparten af det kyrilliske alfabet.
Takket være adgangen til to alfabeter kan vi håndtere en større mængde tekster med minimale omkostninger til alfabetændringer (punktuation vil oftest føre tilbage til ASCII, men efter dette kan vi hente mange ikke-ASCII tegn fra det ekstra alfabet uden at skifte tilbage igen).
Bonus: ved at definere det ekstra alfabet med et præfiks 11xxxxxx og vælge dets initiale forskydning som 0xC0, får vi delvis kompatibilitet med CP1252. Med andre ord, mange (men ikke alle) vesteuropæiske tekster, der er kodet i CP1252, vil se ens ud i UTF-C.
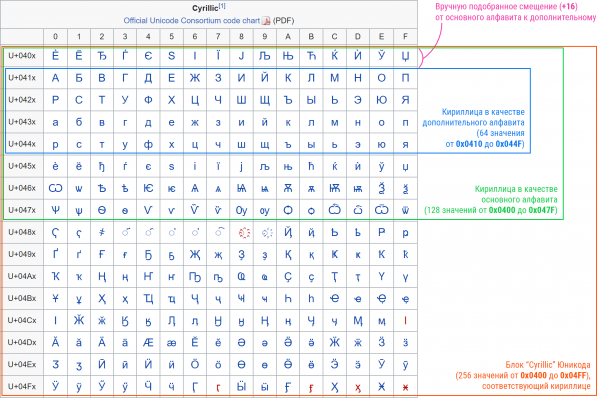
Her opstår der dog et problem: hvordan får man det hjælpealphabet ud fra det primære alfabet? Man kan lade det samme forskydning blive, men — desværre — her spiller Unicode-strukturen allerede imod os. Ofte findes hovedparten af alfabetet ikke i begyndelsen af blokken (for eksempel har det russiske store "А" koden 0x0410, selvom det kyrilliske blok starter med 0x0400). Således, ved at tage de første 64 tegn i "reserven", kan vi muligvis miste adgangen til den afsluttende del af alfabetet.
For at løse dette problem har jeg manuelt gennemgået nogle blokke, der svarer til forskellige sprog, og angivet offset for det hjælpealfabet inden for hovedet. Latinske bogstaver har jeg i undtagelsestilfælde omorganiseret som base64.
De sidste detaljer
Lad os til sidst overveje, hvor vi stadig kan finjustere noget.
Vi bemærker, at formatet 101xxxxx xxxxxxxx xxxxxxxx giver mulighed for at kode tal op til 0x1FFFFF, mens Unicode slutter tidligere, ved 0x10FFFF. Med andre ord, den sidste kodepunkt vil blive repræsenteret som 10110000 11111111 11111111. Så vi kan sige, at hvis det første byte har form som 1011xxxx (hvor xxxx større end 0), betyder det noget andet. For eksempel kan vi tilføje yderligere 15 tegn, som konstant er tilgængelige for kodning med ét byte, men jeg har valgt at gøre det anderledes.
Lad os se på de Unicode blokke, der i øjeblikket kræver tre byte. Hovedsageligt, som allerede nævnt, er det kinesiske tegn — men det er svært at gøre noget med, da der er 21 tusinde. Men også hiragana og katakana er blevet inkluderet — og der er ikke så mange, mindre end to hundrede. Og da vi nu har nævnt japanerne — der ligger også emoji (faktisk er de spredt mange steder i Unicode, men de vigtigste blokke ligger i området 0x1F300 – 0x1FBFF). Hvis vi tænker på, at der nu findes emoji, der sammensættes af flere kodepunkter (for eksempel, emoji består af hele 7 koder!), så bliver det virkelig trist at bruge tre byte på hver (7×3 = 21 byte for én karakter, det er skrækkeligt).
Så vi vælger nogle udvalgte intervaller, der svarer til emoji, hiragana og katakana, omnummererer dem i en kontinuerlig liste og koder dem med to byte i stedet for tre:
1011xxxx xxxxxxxx
Perfekt: ovennævnte emoji , der består af 7 kodepunkter, fylder 25 byte i UTF-8, men vi fik plads til det i 14 (præcis to byte pr. kodepunkt). For øvrigt nægtede Habr at behandle det (både i den gamle og den nye editor), så jeg måtte indsætte det som et billede.
Lad os prøve at løse et andet problem. Som vi husker, er hovedalfabetet i første omgang de højeste 6 bit, som vi har i tankerne, og klæber til koden af hver enkelt dekodet tegn. I tilfælde af kinesiske tegn, der befinder sig i blokken 0x4E00 – 0x9FFF, er det enten bit 0 eller 1. Det er ikke særlig praktisk: vi skal konstant skifte alfabet mellem disse to værdier (dvs. bruge tre byte). Men lad os bemærke, at i lang tilstand kan vi fra selve koden trække antallet af tegn, som vi koder med den korte tilstand (efter alle de tidligere beskrevne finesser er det 10240) — så vil området af tegn flytte sig til 0x2600 – 0x77FF, og i dette tilfælde vil de øverste 6 bits (ud af 21) i hele dette område være lig med 0. Således vil tegnsekvenserne bruge to byte pr. tegn (hvilket er optimalt for et så stort område), uden at der opstår skift af alfabetet.
Alternativ løsninger: SCSU, BOCU-1
Kenderne af Unicode, efter kun at have læst titlen på artiklen, vil sandsynligvis hurtigt minde om, at der blandt Unicode-standarderne findes (SCSU), som beskriver en kodningsmetode, der ligner den, der er beskrevet i artiklen.
Jeg må ærligt indrømme: jeg fandt først ud af eksistensen af det, da jeg var dybt inde i at skrive min løsning. Havde jeg kendt til det fra starten, ville jeg sandsynligvis have forsøgt at skrive dens implementation i stedet for at finde på min egen tilgang.
Det interessante er, at SCSU bruger ideer, der ligner dem, jeg kom frem til selv (i stedet for begrebet 'alfabeter' bruges der 'vinduer', og der er flere tilgængelige end hos mig). Samtidig har dette format også ulemper: det ligger lidt tættere på komprimeringsalgoritmer snarere end kodning. Standardet giver mange måder at repræsentere på, men siger ikke noget om, hvordan man vælger den optimale — til det skal encoder bruge nogle heuristikker. Således vil en SCSU-encoder, der giver god komprimering, være mere kompleks og besværlig end min algoritme.
Til sammenligning har jeg overført en relativt simpel implementering af SCSU til JavaScript — den viste sig at være sammenlignelig med mit UTF-C i kodevolumen, men i nogle tilfælde præsterede den betydeligt dårligere (nogle gange kan den dog overgå den, men ikke med meget). For eksempel kodede UTF-C tekster på hebraisk og græsk hele 60% bedre end SCSU (sandsynligvis på grund af deres kompakte alfabeter).
Jeg vil gerne tilføje, at udover SCSU findes der også en anden metode til kompakt repræsentation af Unicode — , men det sigter mod kompatibilitet med MIME (hvilket ikke var nødvendigt for mig), og anvender en lidt anden tilgang til kodning. Jeg har ikke vurderet dens effektivitet, men jeg tror ikke, den vil være højere end SCSU.
Mulige forbedringer
Den algoritme, jeg har præsenteret, er ikke universel by design (heri adskiller mine mål sig sandsynligvis mest fra Unicode-konsortiumets mål). Jeg har allerede nævnt, at den primært blev udviklet til et specifikt formål (opbevaring af flersprogede ordlister i et præfiks-træ), og nogle af dens egenskaber kan være mindre velegnede til andre opgaver. Men det faktum, at den ikke er en standard, kan også være en fordel — du kan nemt tilpasse den til dine behov.
For eksempel kan man helt klart fjerne tilstedeværelsen af tilstand, gøre kodningen stateless — blot ved ikke at opdatere variablerne afslag, auxOffs og is21Bit i encoder og decoder. I så fald vil det ikke være muligt at pakke sekvenser af tegn fra det samme alfabet effektivt, men der vil være garanti for, at det samme tegn altid kodes med de samme bytes, uanset konteksten.
Derudover kan encoderens konfiguration tilpasses til et bestemt sprog ved at ændre standardtilstanden — for eksempel, ved at basere sig på russiske tekster, indstille i starten af encoder og decoder offs = 0x0400 og auxOffs = 0. Dette giver især mening i tilfælde af stateless-tilstand. Generelt vil det minde om brugen af den gamle ottebiters kodning, men det fjerner ikke muligheden for at indsætte tegn fra hele Unicode efter behov.
En anden ulempe, som tidligere nævnt — i en omfattende tekst kodet i UTF-C, er der ingen hurtig måde at finde grænsen for det tegn, der er tættest på et vilkårligt byte. Hvis du skærer de sidste, lad os sige, 100 bytes fra den kodede buffer, risikerer du at få skrammel, som ikke kan bruges til noget. Kodningen er ikke beregnet til opbevaring af multigigabyte logfiler, men generelt kan dette rettes. Et byte 0xBF må aldrig forekomme som det første byte (men kan være det andet eller tredje). Derfor kan man under kodning indsætte en sekvens 0xBF 0xBF 0xBF hvis vi siger 10 KB — så vil det være tilstrækkeligt at scanne det valgte stykke, indtil en lignende markør findes. Efter den sidste 0xBF vil der garanti være begyndelsen af et tegn. (Ved dekodning skal denne sekvens af tre bytes selvfølgelig ignoreres.)
Sammenfattende
Hvis du har læst dette langt, tillykke! Jeg håber, at du, ligesom jeg, har lært noget nyt (eller genopfrisket det gamle) om Unicode-systemet.
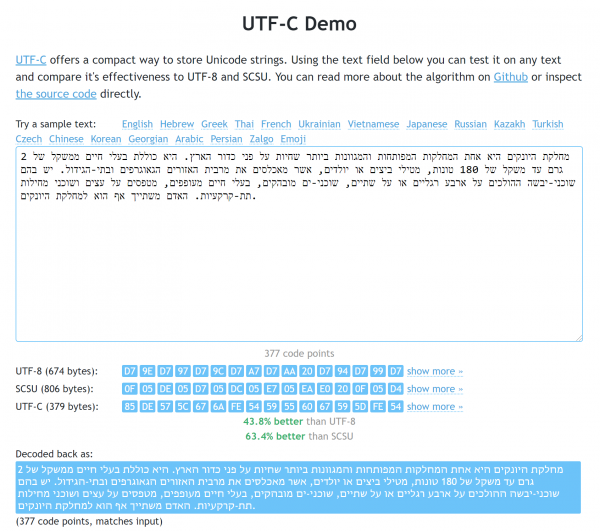
Demonstrationssiden. På eksempel med hebraisk er fordelene både i forhold til UTF-8 og SCSU tydelige.
Det er ikke hensigtsmæssigt at betragte de ovenfor beskrevne undersøgelser som indgreb i standarderne. Men jeg er generelt tilfreds med resultaterne af mit arbejde, så jeg er glad for at : for eksempel vejer JS-biblioteket i minimeret form kun 1710 bytes (og har naturligvis ingen afhængigheder). Som jeg nævnte før, kan du finde ud af, hvordan det fungerer på (der er også en samling tekster, hvor den kan sammenlignes med UTF-8 og SCSU).
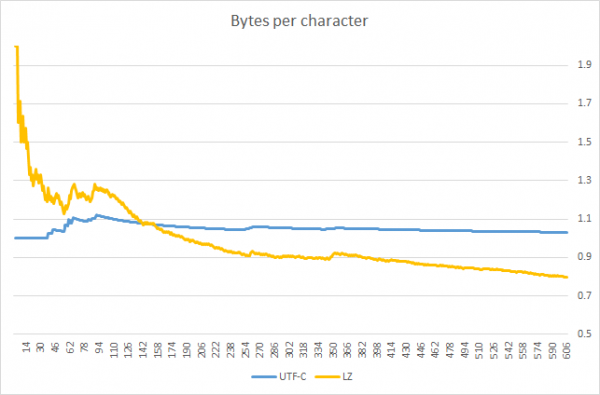
Til sidst vil jeg igen påpege de situationer, hvor det ikke er værd at bruge UTF-C hvis dine strenge er lange nok (fra 100-200 tegn). I så fald bør du overveje at anvende komprimeringsalgoritmer som deflate.:
- Hvis du har brug for
- ASCII transparency , det vil sige, at det er vigtigt for dig, at der ikke opstår ASCII-koder i de kodede sekvenser, som ikke var i den oprindelige streng. Behov for dette kan undgås, hvis du ved interaktion med tredjeparts-API'er (for eksempel når du arbejder med databaser) sender resultatet af kodningen som et abstrakt sæt bytes og ikke som strenge. Ellers risikerer du at få uventede sårbarheder.Hvis du ønsker at kunne finde grænserne for tegn hurtigt ved en vilkårlig forskydning (for eksempel ved beskadigelse af en del af strengen). Dette kan gøres, men kun ved at scanne strengen fra starten (eller ved at anvende den tilpasning, der er beskrevet i det forrige afsnit).
- Hvis du hurtigt har brug for at foretage operationer på indholdet af strenge (sortere dem, søge efter understrenge, konkatere dem). For dette skal strenge først dekodes, hvilket gør UTF-C langsommere end UTF-8 i disse tilfælde (men hurtigere end komprimeringsalgoritmer). Da den samme streng altid kodes ens, kræver præcise sammenligninger af dekodningen ikke det; det kan udføres byte for byte.
- Hvis du hurtigt skal udføre operationer på strenge (sortere dem, søge efter delstrenge, konkatere). For dette skal strenge først dekodes, så UTF-C vil være langsommere end UTF-8 i disse tilfælde (men hurtigere end komprimeringsalgoritmer). Da den samme streng altid kodes ens, kræver præcist dekodningssammenligning ikke, det kan udføres byte-for-byte.
Opdatering: bruger har offentliggjort en graf, der fremhæver grænserne for anvendeligheden af UTF-C. Det kan ses, at UTF-C er mere effektiv end generelle kompressionsalgoritmer (variationer af LZW), så længe den pakkede streng er kortere ~140 tegn (dog bemærker jeg, at sammenligningen blev udført på én tekst; for andre sprog kan resultatet variere).
Kilde: habr.com
