

Høj ydeevne er et af de vigtigste krav, når man arbejder med store data. I dataload-management hos Sber håndterer vi stort set alle transaktioner i vores Data Cloud baseret på Hadoop, hvilket betyder, at vi arbejder med virkelig store mængder information. Det er klart, at vi konstant søger måder at forbedre ydeevnen på, og nu vil vi fortælle, hvordan vi har lykkes med at patche RegionServer HBase og HDFS-klienten, hvilket har øget læsehastigheden betydeligt.
Men før vi går i dybden med ændringerne, er det vigtigt at tale om de begrænsninger, der i sagens natur ikke kan omgås, når man arbejder med HDD.
Hvorfor HDD og hurtige Random Access-læsninger er uforenelige
Som bekendt gemmer HBase og mange andre databaser data i blokke, der er størrelse i flere titalls kilobyte. Som standard er det omkring 64 KB. Forestil dig nu, at vi skal hente kun 100 byte, og vi beder HBase om at give os disse data baseret på en nøgle. Da størrelsen på blokken i HFiles er 64 KB, vil der blive anmodet om 640 gange mere (bare for at understrege!) end hvad der er nødvendigt.
Da anmodningen går gennem HDFS og dens mekanisme til cache af metadata ShortCircuitCache (som tillader direkte adgang til filer), fører dette til, at der læses allerede 1 MB fra disken. Dog kan dette reguleres af parameteren dfs.client.read.shortcircuit.buffer.size og i mange tilfælde giver det mening at reducere denne værdi, for eksempel til 126 KB.
Lad os antage, at vi gør det, men når vi begynder at læse data via java API, med funktioner som FileChannel.read, og beder operativsystemet om at læse den specifikke mængde data, læser det "for en sikkerheds skyld" 2 gange mere, dvs. i 256 KB i vores tilfælde. Dette sker, fordi der i java ikke er en enkel mulighed for at sætte flaget FADV_RANDOM, som forhindrer sådan adfærd.
I sidste ende, for at få vores 100 byte, bliver der læst 2600 gange mere under overfladen. Det kan synes åbenlyst — lad os reducere blokstørrelsen til en kilobyte, sætte det nævnte flag og opnå en fantastisk hastighedsforøgelse. Men problemet er, at hvis vi halverer blokstørrelsen, reducerer vi også antallet af læste byte pr. tidsenhed med det samme i 2 gange.
Der er en vis gevinst ved at aktivere flaget FADV_RANDOM, men kun ved høj grad af multitrådning og en blokstørrelse på mindst 128 KB, og det er kun et par dusin procent maksimalt.
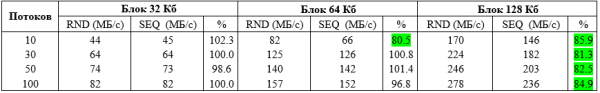
Testene blev gennemført på 100 filer, hver med en størrelse på 1 GB og placeret på 10 HDD-diske.
Lad os beregne, hvad vi overhovedet kan forvente med sådan en hastighed:
Antag, at vi læser fra 10 diske med en hastighed på 280 MB/s, dvs. 3 millioner gange 100 byte. Men som vi husker, er de data, vi har brug for, 2600 gange mindre, end det vi har læst. Derfor dividerer vi 3 millioner med 2600 og får 1100 poster pr. sekund.
Det er nedslående, ikke sandt? Sådan er naturen for Random Access dataadgang på HDD — uanset blokstørrelsen. Dette er den fysiske grænse for tilfældig adgang, og ingen database kan presse mere ud under disse forhold.
Hvordan kan databaser så opnå langt højere hastigheder? For at svare på dette spørgsmål lad os se på, hvad der sker på det næste billede:
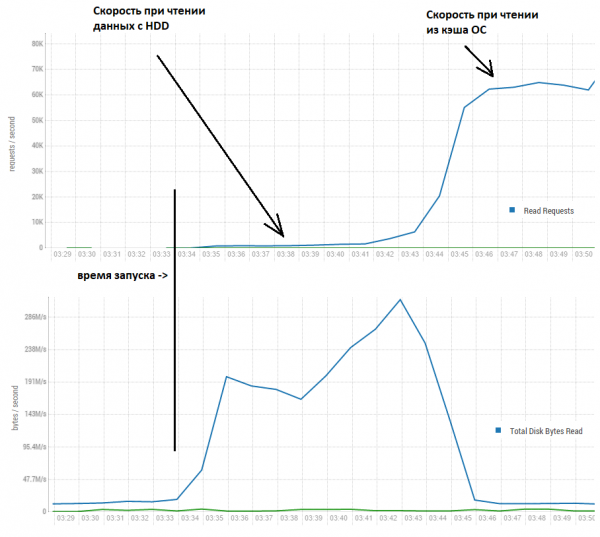
Her ser vi, at de første par minutter er hastigheden faktisk omkring tusind poster pr. sekund. Men senere, da der læses meget mere end der er blevet anmodet om, bliver dataene lagret i buff/cache i operativsystemet (Linux), og hastigheden stiger til mere respektable 60.000 pr. sekund.
Derfor vil vi senere fokusere på at accelerere adgangen til kun de data, der er i OS-cache eller findes i sammenlignelige hurtige lager som SSD/NVMe.
I vores tilfælde vil vi udføre test på et setup bestående af 4 servere, hver konfigureret på følgende måde:
CPU: Xeon E5-2680 v4 @ 2,40GHz 64 tråde.
Hukommelse: 730 GB.
Java-version: 1.8.0_111
Her er det væsentlige punkt — størrelsen på de data i tabellerne, som skal læses. Hvis dataene kan passe helt ind i HBase-cache, når vi slet ikke at læse fra buff/cache i operativsystemet. HBase allokerer som standard 40% af hukommelsen til en struktur, der kaldes BlockCache. Det er reelt en ConcurrentHashMap, hvor nøglen er filnavnet + offset for blokken, og værdien er de data, som svarer til dette offset.
Når vi derfor kun læser fra denne struktur, , omtrent en million forespørseler i sekundet. Men la oss forestille oss at vi ikke kan gi hundrevis av gigabyte minne bare til databasen, fordi det kjører mye annet nyttig på disse serverne.
For eksempel er volumet av BlockCache på en RS rundt 12 GB. Vi har distribuert to RS på en node, dvs. at det er tildelt 96 GB til BlockCache på alle noder. Og dataene er mange ganger mer, for eksempel la oss anta at det er 4 tabeller, hver med 130 regioner, der filene er 800 MB store, komprimert med FAST_DIFF, dvs. totalt 410 GB (dette er rene data, dvs. uten hensyntagen til replikasjonsfaktoren).
Dermed utgjør BlockCache bare omtrent 23% av det totale datavolumet, og dette er mye nærmere de reelle forholdene som kalles BigData. Og her begynner det mest interessante — klart, jo færre treff i cachen, jo dårligere ytelse. For i tilfelle et bom har vi masse arbeid å gjøre — dvs. gå ned til å kalle systemfunksjoner. Men dette er uunngåelig, så la oss se på et helt annet aspekt — hva skjer med dataene inne i cachen?
La oss forenkle situasjonen og anta at vi har en cache som bare kan inneholde 1 objekt. Her er et eksempel på hva som skjer når vi prøver å arbeide med datavolum som er 3 ganger større enn cachen, vi må:
1. Legge inn blokk 1 i cachen
2. Fjerne blokk 1 fra cachen
3. Legge inn blokk 2 i cachen
4. Fjerne blokk 2 fra cachen
5. Legge inn blokk 3 i cachen
Fem handlinger fullført! Men vi kan på ingen måte kalle denne situasjonen normal; i praksis tvinger vi HBase til å utføre masse helt unyttig arbeid. Den leser konstant data fra OS-cachen, legger det inn i BlockCache, for deretter å nesten umiddelbart kaste det ut fordi en ny mengde data har ankommet. Animasjonen i begynnelsen av innlegget viser kjernen i problemet — Garbage Collector går amok, atmosfæren varmes opp, lille Greta i fjerne og varme Sverige blir opprørt. Og vi IT-folk liker veldig lite når barn er triste, så vi begynner å tenke på hva vi kan gjøre med dette.
Hva om vi ikke legger inn alle blokkene i cachen, men bare en viss prosentandel av dem, slik at cachens kapasitet ikke overskrides? La oss først bare legge til noen få linjer med kode i begynnelsen av funksjonen for å legge data til BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Meningen her er, at offsetten er blokens placering i filen, og de sidste cifre er tilfældigt og ligeligt fordelt fra 00 til 99. Derfor vil vi kun springe over de, der falder inden for det ønskede interval.
For eksempel, lad os sætte cacheDataBlockPercent = 20 og se, hvad der sker:
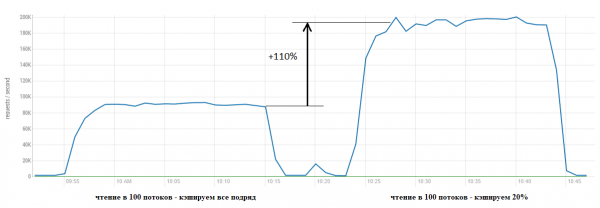
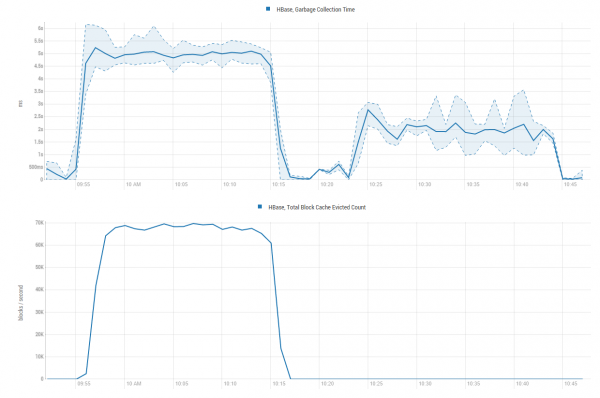
Resultatet er tydeligt. På graferne nedenfor bliver det klart, hvad der har forårsaget denne acceleration — vi sparer en masse GC-ressourcer ved ikke at udføre det sisyfos-lignende arbejde med at placere data i cachen kun for straks at smide dem til Martianske hunde under halen:
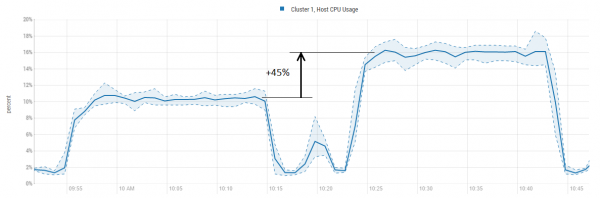
CPU-udnyttelsen stiger, men meget mindre end ydelsen:
Det er også vigtigt at nævne, at blokke, der opbevares i BlockCache, kan være forskellige. Størstedelen, omkring 95%, er faktisk data. Og resten er metadata, som Bloom-filtre eller LEAF_INDEX og . Disse data er få, men meget nyttige, da HBase, før den direkte tilgår dataene, henviser til metadataene for at forstå, om den skal lede efter yderligere oplysninger, og hvis ja, hvor den interesserede blok i så fald findes.
Derfor ser vi i koden betingelsen om at tjekke buf.getBlockType().isData() og takket være denne metadata vil vi i hvert fald lade den være i cachen.
Lad os nu øge belastningen og samtidig finjustere funktionen lidt. I den første test satte vi afskæringsprocenten til 20, og BlockCache var lidt underbelastet. Nu sætter vi 23% og tilføjer 100 tråde hver femte minut for at se, hvornår metningen sker:
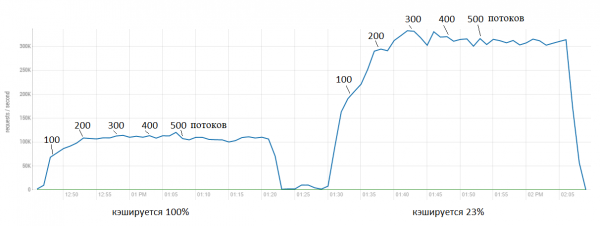
Her ser vi, at den oprindelige version næsten straks rammer loftet på omkring 100.000 forespørgsler pr. sekund. Mens patchen giver en acceleration op til 300.000. Samtidig er det klart, at yderligere acceleration ikke er så "gratis", og CPU-udnyttelsen stiger også.
Dog er det ikke en særlig elegant løsning, da vi på forhånd ikke ved, hvor stor en procentdel af blokkene der skal caches; det afhænger af belastningsprofilen. Derfor blev der implementeret en mekanisme til automatisk justering af denne parameter i forhold til aktiviteten i læseoperationer.
For at styre dette er der tilføjet tre parametre:
hbase.lru.cache.heavy.eviction.count.limit — fastsætter, hvor mange gange dataudvælgelsesprocessen skal køres, før vi begynder at anvende optimering (dvs. springe blokke over). Som standard er det MAX_INT = 2147483647, hvilket faktisk betyder, at funktionen aldrig vil begynde at fungere ved denne værdi. Fordi dataudvælgelsesprocessen kører hvert 5-10 sekund (afhængigt af belastningen), og 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 år. Vi kan dog sætte denne parameter til 0 og få funktionen til at arbejde straks efter opstart.
Men der er også en nyttig belastning i denne parameter. Hvis vi har en belastning, hvor kortvarige læsninger (lad os sige om dagen) og langvarige (om natten) konstant veksler, så kan vi gøre det, at funktionen kun aktiveres, når der er vedvarende læseoperationer.
For eksempel ved vi, at kortvarige læsninger normalt varer omkring 1 minut. Så der er ikke behov for at begynde at smide blokke ud, da cachen ikke vil kunne blive forældet, og vi kan sætte denne parameter til for eksempel 10. Dette vil føre til, at optimeringen kun begynder at fungere, når der er startet langvarige aktive læsninger, dvs. efter 100 sekunder. På den måde, hvis vi har kortvarige læsninger, så vil alle blokke komme i cachen og være tilgængelige (undtagen dem, der evt. smides ud af den standardalgoritme). Og når vi laver langvarige læsninger, aktiveres funktionen, og vi får en meget højere ydeevne.
hbase.lru.cache.heavy.eviction.mb.size.limit — fastsætter, hvor mange megabyte vi gerne vil lægge i cachen (og naturligvis smide ud) på 10 sekunder. Funktionen vil forsøge at nå denne værdi og opretholde den. Ideen er, at hvis vi propper gigabyte ind i cachen, så skal vi også smide gigabyte ud, og dette, som vi så før, er ret kostbart. Men det er ikke nødvendigt at forsøge at sætte det for lavt, da dette vil føre til en for tidlig udgang fra tilstanden med at springe blokke over. For kraftige servere (omkring 20-40 fysiske kerner) er det optimalt at sætte det til omkring 300-400 MB. For mellemkraftige systemer (~10 kerner) 200-300 MB. For svage systemer (2-5 kerner) kan 50-100 MB være acceptabelt (ikke testet på sådanne).
Lad os se på, hvordan det fungerer: lad os antage, at vi har indstillet hbase.lru.cache.heavy.eviction.mb.size.limit = 500, der er noget belastning (læsning), og så beregner vi hver ~10 sekunder, hvor mange byte der er blevet »udvist« efter følgende formel:
Overhead = Frigivne bytes sum (MB) * 100 / Grænse (MB) — 100;
Hvis der faktisk er blevet udvist 2000 MB, så er Overhead lig med:
2000 * 100 / 500 — 100 = 300%
Algoritmerne forsøger at holde forbruget under et vist niveau, så funktionen vil reducere procentdelen af cachede blokke, hvilket realiserer en auto-tuning mekanisme.
Men hvis belastningen falder, lad os sige, at kun 200 MB er blevet udvist, og Overhead er blevet negativt (såkaldt overshooting):
200 * 100 / 500 — 100 = -60%
Så vil funktionen derimod øge procentdelen af cachede blokke, indtil Overhead bliver positiv.
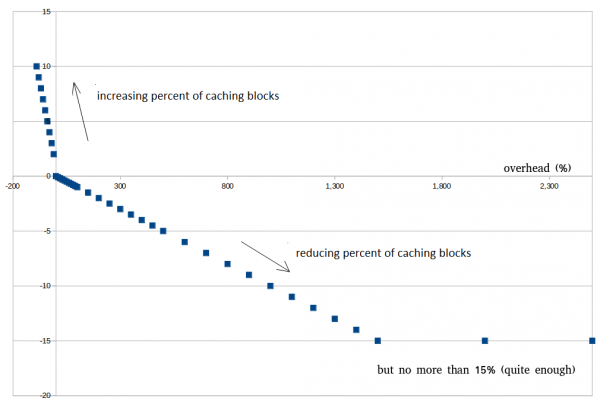
Nedenfor vil et eksempel vise, hvordan det ser ud med reelle data. Forsøg ikke at opnå 0%, det er umuligt. Det er meget godt, når vi ligger omkring 30 — 100%, det hjælper med at undgå for tidlig udgang fra optimeringstilstand under kortvarige stigninger.
hbase.lru.cache.heavy.eviction.overhead.coefficient — angiver, hvor hurtigt vi ønsker at få resultater. Hvis vi er sikre på, at vores læsninger hovedsageligt er langvarige og vi ikke ønsker at vente, kan vi øge denne faktor og opnå højere ydeevne hurtigere.
For eksempel, hvis vi indstiller denne faktor = 0.01. Det betyder, at Overhead (se ovenfor) vil blive ganget med dette tal, når resultatet er opnået, og procentdelen af cachede blokke vil blive reduceret. Antag, at Overhead = 300%, og faktoren = 0.01, så vil procentdelen af cachede blokke blive reduceret med 3%.
En lignende logik for "Backpressure" er implementeret for negative værdier af Overhead (overshooting). Da der altid kan være kortvarige udsving i læse- og udvisningsvolumen, gør denne mekanisme det muligt at undgå en for tidlig udgang fra optimeringstilstand. Backpressure har en omvendt logik: jo mere overshooting, desto flere blokke caches.
Implementeringskode
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Nogle gange læser vi mere data, end der kan være i BlockCache
        * og det er årsagen til en høj sats af eviktioner.
        * Dette fører til tungt arbejde for Garbage Collector.
        * Så mange blokke puts ind i BlockCache, men bliver aldrig læst,
        * men bruger mange CPU-ressourcer.
        * Her vil vi analysere, hvor mange bytes der blev frigivet og beslutte
        * om tiden er inde til at reducere antallet af caching-blokke.
        * Det hjælper med at undgå at putte for mange blokke i BlockCache
        * når evict() kører meget aktivt og spare CPU til andre opgaver.
        * Mere detaljer: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Først og fremmest skal vi kontrollere, hvor meget tid
        // der er gået siden sidste evict() blev lanceret
        // Dette bør være næsten samme tid (+/- 10s)
        // fordi vi får sammenlignelige mængder af frigivne bytes hver gang.
        // 10s fordi dette er standardperioden for at køre evict() (se ovenfor this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Her skal vi beregne, hvilken situation vi har.
          // Vi har grænsen "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // og kan beregne overbelastningen på den.
          // Vi vil bruge denne information til at beslutte,
          // hvordan vi skal ændre procentdelen af caching-blokke.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Nu er vi i den situation, hvor vi er over grænsen
            // Men måske ignorerer vi det, fordi det vil ende ret snart
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Det har stået på længe, og vi skal reducere caching
              // af blokke nu. Så vi beregner her, hvor mange blokke vi vil springe over.
              // Det afhænger af:
              // 1. Overbelastning - hvis overbelastningen er stor, kan vi være mere aggressive
              // med at reducere antallet af caching-blokke.
              // 2. Hvor hurtigt vi vil have resultatet. Hvis vi ved, at vores
              // tunge læsning vil vare lang tid, ønsker vi ikke at vente og kan
              // øge koefficienten og få god ydeevne ret hurtigt.
              // Men hvis vi ikke er sikre, kan vi gøre det langsomt og det kan forhindre
              // for tidlig afslutning fra denne tilstand. Så, når koefficienten er
              // højere, kan vi få bedre ydeevne, når tung læsning er stabil.
              // Men når læsningen ændrer sig, kan vi tilpasse os til det og indstille
              // koefficienten til lavere værdi.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Men praksis viser, at 15% reduktion er ganske tilstrækkeligt.
              // Vi er ikke grådige (det kan føre til for tidlig afslutning).
              change = Math.min(15, change);
              change = Math.max(0, change); // Jeg tror ikke, det nogensinde vil ske, men check for sikkerhed
              // Så dette er det nøglepunkt, her reducerer vi % af caching-blokke
              cache.cacheDataBlockPercent -= change;
              // Hvis vi går for dybt, skal vi stoppe her, 1% bør altid være.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Nå, vi har fået overshoot.
            // Måske er det bare kortvarig svingning, og vi kan blive i denne tilstand.
            // Det hjælper med at undgå for tidlig afslutning under kortvarige svingninger.
            // Hvis overshootet er mindre end 90%, vil vi prøve at øge procentdelen af
            // caching-blokke og håbe, det er tilstrækkeligt.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Simpel logik: mere overshoot - flere caching-blokke (tilbageslag)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Men det kan ikke være mere end 100%, så tjek det.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Ser ud som om tung læsning er slut.
              // Bare afslut denne tilstand.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache evicted (MB): {}, overhead (%): {}, " +
            "heavy eviction counter: {}, " +
            "current caching DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Lad os nu se på dette med et konkret eksempel. Vi har følgende testscenario:
- Vi begynder at køre Scan (25 tråde, batch = 100)
- Efter 5 minutter tilføjer vi multi-gets (25 tråde, batch = 100)
- Efter 5 minutter slukker vi for multi-gets (kun scan er tilbage)
Vi laver to gennemførsler, først hbase.lru.cache.heavy.eviction.count.limit = 10000 (som faktiske slukker for funktionen), og derefter sætter vi limit = 0 (som tænder den).
I loggene nedenfor ser vi, hvordan funktionen aktiveres, og Overshooting nulstilles til 14-71%. Af og til falder belastningen, hvilket aktiverer Backpressure, og HBase cacher igen flere blokke.
RegionServer-log
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, heavy eviction counter: 1, current caching DataBlock (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, heavy eviction counter: 2, current caching DataBlock (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, heavy eviction counter: 3, current caching DataBlock (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, heavy eviction counter: 4, current caching DataBlock (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, heavy eviction counter: 5, current caching DataBlock (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, heavy eviction counter: 6, current caching DataBlock (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, heavy eviction counter: 7, current caching DataBlock (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, heavy eviction counter: 8, current caching DataBlock (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, heavy eviction counter: 9, current caching DataBlock (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, heavy eviction counter: 10, current caching DataBlock (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, heavy eviction counter: 11, current caching DataBlock (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, heavy eviction counter: 12, current caching DataBlock (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, heavy eviction counter: 13, current caching DataBlock (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, heavy eviction counter: 14, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 15, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 16, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, heavy eviction counter: 17, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, heavy eviction counter: 18, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, heavy eviction counter: 19, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, heavy eviction counter: 20, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, heavy eviction counter: 21, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, heavy eviction counter: 22, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, heavy eviction counter: 23, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, heavy eviction counter: 24, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, heavy eviction counter: 25, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, heavy eviction counter: 26, current caching DataBlock (%): 19
forvist (MB): 456, forhold 0.17, overhead (%): 128, tung forvisnings tæller: 27, nuværende caching DataBlock (%): 18 < tilføjede hentninger (men tabellen den samme)
forvist (MB): 456, forhold 0.15, overhead (%): 128, tung forvisnings tæller: 28, nuværende caching DataBlock (%): 17
forvist (MB): 342, forhold 0.13, overhead (%): 71, tung forvisnings tæller: 29, nuværende caching DataBlock (%): 17
forvist (MB): 342, forhold 0.11, overhead (%): 71, tung forvisnings tæller: 30, nuværende caching DataBlock (%): 17
forvist (MB): 342, forhold 0.09, overhead (%): 71, tung forvisnings tæller: 31, nuværende caching DataBlock (%): 17
forvist (MB): 228, forhold 0.08, overhead (%): 14, tung forvisnings tæller: 32, nuværende caching DataBlock (%): 17
forvist (MB): 228, forhold 0.07, overhead (%): 14, tung forvisnings tæller: 33, nuværende caching DataBlock (%): 17
forvist (MB): 228, forhold 0.06, overhead (%): 14, tung forvisnings tæller: 34, nuværende caching DataBlock (%): 17
forvist (MB): 228, forhold 0.05, overhead (%): 14, tung forvisnings tæller: 35, nuværende caching DataBlock (%): 17
forvist (MB): 228, forhold 0.05, overhead (%): 14, tung forvisnings tæller: 36, nuværende caching DataBlock (%): 17
forvist (MB): 228, forhold 0.04, overhead (%): 14, tung forvisnings tæller: 37, nuværende caching DataBlock (%): 17
forvist (MB): 109, forhold 0.04, overhead (%): -46, tung forvisnings tæller: 37, nuværende caching DataBlock (%): 22 < tilbageholdelse
forvist (MB): 798, forhold 0.24, overhead (%): 299, tung forvisnings tæller: 38, nuværende caching DataBlock (%): 20
forvist (MB): 798, forhold 0.29, overhead (%): 299, tung forvisnings tæller: 39, nuværende caching DataBlock (%): 18
forvist (MB): 570, forhold 0.27, overhead (%): 185, tung forvisnings tæller: 40, nuværende caching DataBlock (%): 17
forvist (MB): 456, forhold 0.22, overhead (%): 128, tung forvisnings tæller: 41, nuværende caching DataBlock (%): 16
forvist (MB): 342, forhold 0.16, overhead (%): 71, tung forvisnings tæller: 42, nuværende caching DataBlock (%): 16
forvist (MB): 342, forhold 0.11, overhead (%): 71, tung forvisnings tæller: 43, nuværende caching DataBlock (%): 16
forvist (MB): 228, forhold 0.09, overhead (%): 14, tung forvisnings tæller: 44, nuværende caching DataBlock (%): 16
forvist (MB): 228, forhold 0.07, overhead (%): 14, tung forvisnings tæller: 45, nuværende caching DataBlock (%): 16
forvist (MB): 228, forhold 0.05, overhead (%): 14, tung forvisnings tæller: 46, nuværende caching DataBlock (%): 16
forvist (MB): 222, forhold 0.04, overhead (%): 11, tung forvisnings tæller: 47, nuværende caching DataBlock (%): 16
forvist (MB): 104, forhold 0.03, overhead (%): -48, tung forvisnings tæller: 47, nuværende caching DataBlock (%): 21 < afbrudte hentninger
forvist (MB): 684, forhold 0.2, overhead (%): 242, tung forvisnings tæller: 48, nuværende caching DataBlock (%): 19
forvist (MB): 570, forhold 0.23, overhead (%): 185, tung forvisnings tæller: 49, nuværende caching DataBlock (%): 18
forvist (MB): 342, forhold 0.22, overhead (%): 71, tung forvisnings tæller: 50, nuværende caching DataBlock (%): 18
forvist (MB): 228, forhold 0.21, overhead (%): 14, tung forvisnings tæller: 51, nuværende caching DataBlock (%): 18
forvist (MB): 228, forhold 0.2, overhead (%): 14, tung forvisnings tæller: 52, nuværende caching DataBlock (%): 18
forvist (MB): 228, forhold 0.18, overhead (%): 14, tung forvisnings tæller: 53, nuværende caching DataBlock (%): 18
forvist (MB): 228, forhold 0.16, overhead (%): 14, tung forvisnings tæller: 54, nuværende caching DataBlock (%): 18
forvist (MB): 228, forhold 0.14, overhead (%): 14, tung forvisnings tæller: 55, nuværende caching DataBlock (%): 18
forvist (MB): 112, forhold 0.14, overhead (%): -44, tung forvisnings tæller: 55, nuværende caching DataBlock (%): 23 < tilbageholdelse
forvist (MB): 456, forhold 0.26, overhead (%): 128, tung forvisnings tæller: 56, nuværende caching DataBlock (%): 22
forvist (MB): 342, forhold 0.31, overhead (%): 71, tung forvisnings tæller: 57, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 58, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 59, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 60, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 61, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 62, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 63, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.32, overhead (%): 71, tung fraværs tæller: 64, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 65, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 66, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.32, overhead (%): 71, tung fraværs tæller: 67, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 68, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.32, overhead (%): 71, tung fraværs tæller: 69, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.32, overhead (%): 71, tung fraværs tæller: 70, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 71, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 72, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 73, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 74, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 75, nuværende caching DataBlock (%): 22
fraflyttet (MB): 342, forhold 0.33, overhead (%): 71, tung fraværs tæller: 76, nuværende caching DataBlock (%): 22
fraflyttet (MB): 21, forhold 0.33, overhead (%): -90, tung fraværs tæller: 76, nuværende caching DataBlock (%): 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
Scans var nødvendige for at vise den samme proces i form af en graf, der viser forholdet mellem to sektioner af cachen – single (hvor blokke, som ingen har anmodet om, havner) og multi (her opbevares data, der er blevet "efterspurgt" mindst én gang):
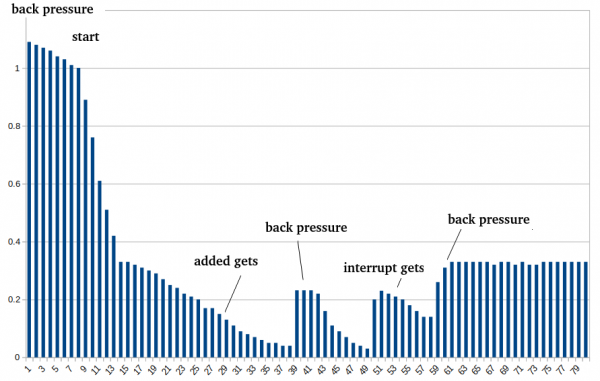
Og endelig, hvordan arbejdet med parametre ser ud i form af graf. For sammenligning blev cachen helt slået fra i starten, hvorefter HBase blev startet med caching og udsættelse af optimeringsstart med 5 minutter (30 cykler af afvisning).
Den fulde kode kan findes i Pull Request på github.
Men 300.000 læsninger pr. sekund er ikke alt, hvad der kan udnyttes på dette hardware i disse forhold. Problemet er, at når data skal tilgås gennem HDFS, anvendes mekanismen ShortCircuitCache (herefter SSC), som muliggør direkte adgang til data og undgår netværksinteraktion.
Profileringsundersøgelsen viste, at denne mekanisme, selvom den giver en stor fordel, også på et tidspunkt bliver en flaskehals, fordi næsten alle tunge operationer foregår inde i lock, hvilket fører til blokeringer det meste af tiden.
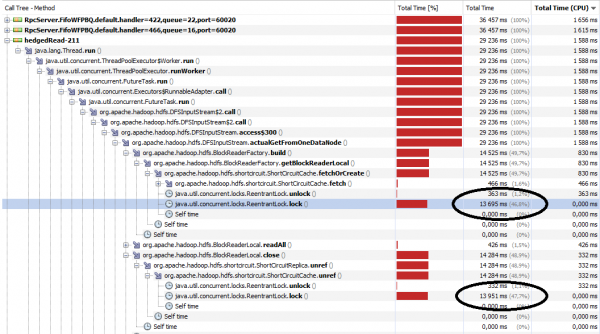
Da vi indså dette, forstod vi, at problemet kunne omgås ved at oprette et array af uafhængige SSC:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Og derefter arbejde med dem, mens man ekskluderer overlap også ved hjælp af den sidste cifre af offset:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Nu kan vi begynde testene. Til dette vil vi læse filer fra HDFS med en simpel multitråd applikation. Vi indstiller parametrene:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // som standard = 1 MB, og det bremser læsningen, så det er bedre at tilpasse det til de faktiske behov
conf.set("dfs.client.short.circuit.num", num); // fra 1 til 10
Og vi læser bare filer:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Denne kode udføres i separate tråde, og vi vil øge antallet af samtidigt læste filer (fra 10 til 200 — den vandrette akse) og antallet af caches (fra 1 til 10 — grafen). Den vertikale akse viser accelerationen, som øgningen af SSC giver i forhold til tilfælde, hvor der kun er en cache.
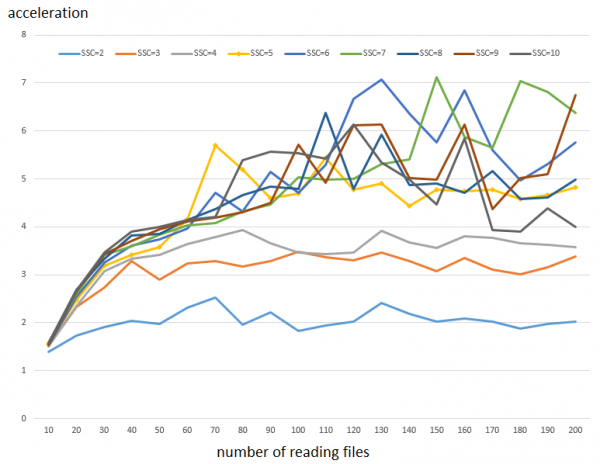
Sådan læses grafen: tiden for at udføre 100.000 læsninger i blokke af 64 KB med en enkelt cache tager 78 sekunder. Mens det med 5 caches udføres på 16 sekunder. Altså er der en acceleration på ~5 gange. Som det ses i grafen, er effekten ikke særlig mærkbar ved et lille antal parallelle læsninger, det begynder at spille en betydelig rolle, når læsningerne er mere end 50. Det er også tydeligt, at en stigning i antallet af SSC fra 6 og højere giver betydeligt mindre gevinster i ydeevne.
Bemærkning 1: Da testresultaterne er ret volatile (se nedenfor), blev der udført 3 kørsel, og de opnåede værdier blev gennemsnitlige.
Bemærkning 2: Ydelsesforøgelsen fra konfigurationen til tilfældig adgang er den samme, selvom selve adgangen er lidt langsommere.
Det er dog vigtigt at præcisere, at i modsætning til tilfældet med HBase, er denne acceleration ikke altid gratis. Her 'unlocker' vi mere CPU'ens muligheder til at udføre opgaver i stedet for at hænge i lås.
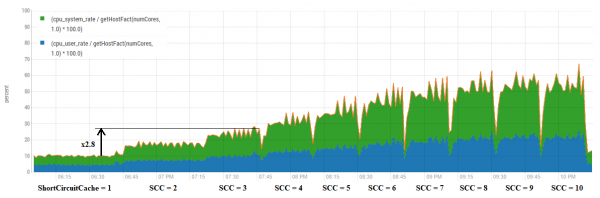
Her kan man observere, at generelt set giver en stigning i antallet af caches omtrent en proportional stigning i CPU-udnyttelsen. Der er dog nogle mere fordelagtige kombinationer.
Lad os for eksempel se nærmere på indstillingen SSC = 3. Stigningen i ydeevne i dette interval er cirka 3,3 gange. Nedenfor er resultaterne fra de tre separate kørsel.
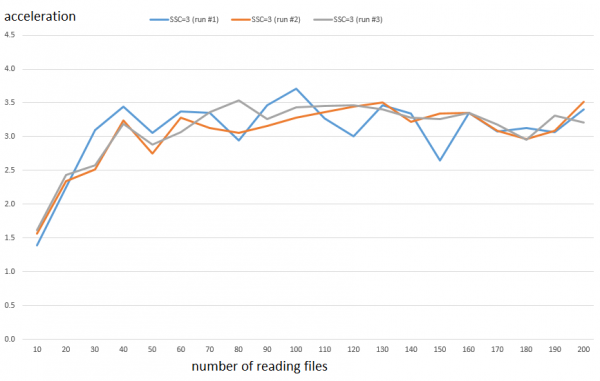
Mens CPU-forbruget vokser med cirka 2,8 gange. Forskellen er ikke så stor, men lille Greta vil allerede være glad, og der kan være tid til at besøge skole og lektioner.
Dermed vil dette have en positiv effekt for ethvert værktøj, der bruger massiv adgang til HDFS (for eksempel Spark osv.), forudsat at applikationskoden er let (dvs. at flaskehalsen rent faktisk er på HDFS-klientsiden) og der er ledige CPU-ressourcer. For at teste dette, lad os undersøge, hvilken effekt det vil give at kombinere optimering af BlockCache og tuning af SSC til læsning fra HBase.
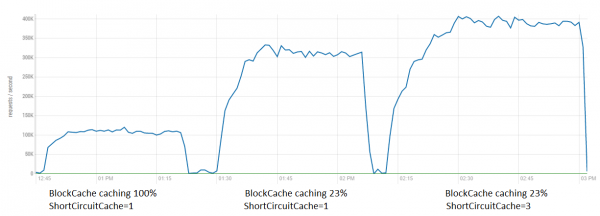
Her kan man se, at effekten ikke er så stor under sådanne forhold, som i raffinerede tests (læsning uden nogen behandling), men det er helt muligt at presse yderligere 80K ud. Sammen giver begge optimeringer en acceleration på op til 4 gange.
Et PR blev også lavet for denne optimering. , som blev flettet ind, og denne funktionalitet vil være tilgængelig i de kommende udgivelser.
Så til sidst var det interessant at sammenligne læseydelsen for en lignende wide-column database Cassandra og HBase.
For dette blev der kørt instanser af standard stress-test værktøjet YCSB fra to værter (800 tråde i alt). På serversiden var der 4 instanser af RegionServer og Cassandra på 4 værter (ikke de samme, hvor klienterne kører, for at undgå påvirkning). Læsningerne blev udført fra tabeller af størrelsen:
HBase — 300 GB på HDFS (100 GB rene data)
Cassandra — 250 GB (replication factor = 3)
Det vil sige volumen var omtrent det samme (HBase har lidt mere).
HBase-parametre:
dfs.client.short.circuit.num = 5 (optimering af HDFS-klienten)
hbase.lru.cache.heavy.eviction.count.limit = 30 — det betyder, at patchen begynder at fungere efter 30 udsættelser (~5 minutter)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — målvolumen for caching og udsættelse
Logs fra YCSB blev parse og sammenfattet i Excel-grafer:
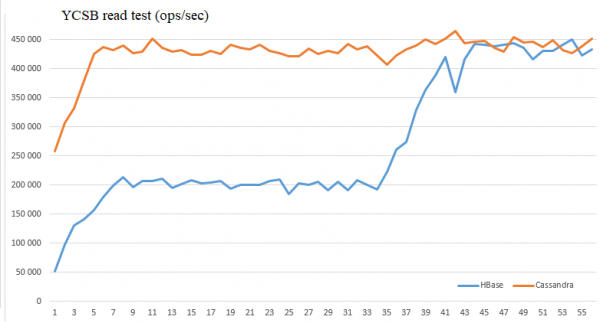
Som det fremgår, gør disse optimeringsdata det muligt at udligne ydeevnen for disse databaser under de givne forhold og nå op på 450.000 læsninger pr. sekund.
Vi håber, at denne information kan være nyttig for nogen i den spændende kamp om ydeevne.
Kilde: habr.com
