

I mit arbejde støder jeg ofte på nye tekniske løsninger/softwareprodukter, hvor informationer på dansk internettet er ret begrænsede. I denne artikel vil jeg forsøge at udfylde et sådant hul med et eksempel fra min seneste praksis, hvor jeg skulle konfigurere sending af CDC-begivenheder fra to populære databaser (PostgreSQL og MongoDB) til et Kafka-kluster ved hjælp af Debezium. Jeg håber, at denne oversigtsartikel, som er resultatet af det udførte arbejde, vil være nyttig for andre.
Hvad er Debezium og hvad er CDC overhovedet?
— en repræsentant for kategorien CDC-software (), og mere præcist er det et sæt af connectorer til forskellige databaser, der er kompatible med Apache Kafka Connect-rammen.
Dette der bruger Apache License v2.0 og sponsoreres af Red Hat. Udviklingen startede i 2016, og der er i øjeblikket officiel støtte til følgende databaser: MySQL, PostgreSQL, MongoDB, SQL Server. Der findes også connectorer til Cassandra og Oracle, men de er i øjeblikket i 'early access'-status, og nye udgivelser garanterer ikke bagudkompatibilitet.
Sammenlignet med traditionelle metoder (hvor applikationen læser data direkte fra databasen), er dens største fordele implementeringen af ændringsdata streamning på række-niveau med lav forsinkelse, høj pålidelighed og tilgængelighed. De sidstnævnte punkter opnås gennem brugen af et Kafka-kluster som lager for CDC-begivenheder.
En anden fordel er det faktum, at der anvendes en ensartet model til lagring af begivenheder, så den endelige applikation ikke behøver at bekymre sig om nuanceforskelle ved brug af forskellige databaser.
Endelig åbner brugen af en meddelelsesbroker mulighed for horisontal skalering af applikationer, der overvåger ændringer i data. Effekten på datakilden minimeres, da data ikke hentes direkte fra databasen, men fra Kafka-klusteret.
Om Debezium-arkitekturen
Brugen af Debezium kan opsummeres i en simpel diagram:
Database (som datakilde) → connector i Kafka Connect → Apache Kafka → consumer
Som illustration kan jeg nævne et diagram fra projektets hjemmeside:
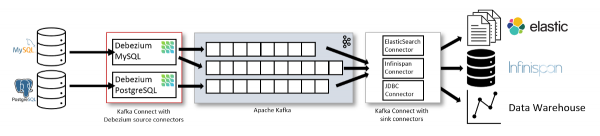
Dog kan jeg ikke rigtig lide dette diagram, da det giver indtryk af, at eneste mulige brug er af en sink-connector.
I virkeligheden er situationen anderledes: fyldningen af din Data Lake (det sidste led på skemaet ovenfor) — er ikke den eneste måde at anvende Debezium på. Begivenheder sendt til Apache Kafka kan bruges af dine applikationer til at løse forskellige situationer. For eksempel:
- fjerning af irrelevante data fra cachen;
- sending af notifikationer;
- opdateringer af søgeindekser;
- nogen form for revisionslister;
- …
Hvis du har en Java-applikation og ikke har behov for/mulighed for at bruge en Kafka-klynge, er der også mulighed for at arbejde gennem . Den åbenlyse fordel er, at du kan undgå ekstra infrastruktur (i form af konnektoren og Kafka). Dog er denne løsning blevet erklæret forældet (deprecated) fra version 1.1 og anbefales ikke længere til brug (støtten kan blive fjernet i fremtidige versioner).
Denne artikel vil gennemgå den anbefalede arkitektur fra udviklerne, som sikrer fejltolerance og skaleringsmuligheder.
Konnektor konfiguration
For at begynde at overvåge ændringer i den mest værdifulde ressource — data — har vi brug for:
- en datakilde, som kan være MySQL fra version 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- en Apache Kafka-klynge;
- en Kafka Connect-instans (version 1.x, 2.x);
- en konfigureret Debezium-konnektor.
Arbejdet med de to første punkter, det vil sige installationsprocessen for DBMS og Apache Kafka, går ud over artiklens rammer. Men for dem, der ønsker at opsætte alt i en sandkasse, er der i det officielle repository med eksempler en færdig .
Vi vil nu fokusere nærmere på de to sidste punkter.
0. Kafka Connect
I denne artikel og fremad vil alle eksempler på konfiguration blive betragtet i konteksten af Docker-billedet, der distribueres af Debezium-udviklerne. Det indeholder alle nødvendige plugin-filer (konnektorer) og muliggør konfiguration af Kafka Connect ved hjælp af miljøvariabler.
Hvis det forudsættes, at Kafka Connect fra Confluent anvendes, skal du selv tilføje de nødvendige konnektor-plugins til den mappe, der er angivet i plugin.path eller angivet via miljøvariablen CLASSPATH. Indstillingerne for Kafka Connect-worker og konnektorerne defineres gennem konfigurationsfiler, som gives som argumenter til kommandoen, der starter workeren. Læs mere i .
Hele processen for at konfigurere Debezium med en connector udføres i to faser. Lad os se på hver enkelt:
1. Konfiguration af Kafka Connect-rammeværket
Når man streamer data til et Apache Kafka-klynge gennem Kafka Connect-rammeværket, angives specifikke parametre som:
- forbindelsesparametre til klyngen,
- navne på emnerne, hvor konfigurationen af selve connectoren vil blive opbevaret,
- gruppenavn, hvor connectoren kører (i tilfælde af anvendelse af distributed-tilstand).
Det officielle Docker-billede af projektet understøtter konfiguration ved hjælp af miljøvariabler — det bruger vi. Lad os hente billedet:
docker pull debezium/connectSættet af minimum miljøvariabler, der er nødvendige for at starte connectoren, ser således ud:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— den indledende liste over Kafka-klynge-servere for at opnå den komplette liste over klyngemedlemmer; -
OFFSET_STORAGE_TOPIC=connector-offsets— emnet til opbevaring af positioner, hvor connectoren aktuelt befinder sig; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— emnet til opbevaring af connectorens status og dens opgaver; -
CONFIG_STORAGE_TOPIC=connector-config— emnet til opbevaring af connectorens og dens opgavers konfigurationsdata; -
GROUP_ID=1— identifikatoren for arbejdsgruppe, hvorpå connectorens opgave kan udføres; nødvendig ved brug af den distribuerede (distributed) tilstand.
Vi starter containeren med disse variabler:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Bemærkning omkring Avro
Som standard skriver Debezium data i JSON-format, hvilket er acceptabelt til sandkasser og små datamængder, men kan blive et problem i højbelastede databaser. Et alternativ til JSON-konverteren er at serialisere beskederne ved hjælp af til binært format, hvilket reducerer belastningen på I/O-underenheden i Apache Kafka.
For at bruge Avro kræves det at opsætte et separat (til opbevaring af skemaer). Variablerne for konverteren vil se således ud:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Detaljer om brugen af Avro og konfigurationen af registry falder uden for denne artikel — for klarhedens skyld vil vi senere bruge JSON.
2. Konfiguration af selve connectoren
Nu kan vi gå videre til konfigurationen af selve connectoren, der skal læse data fra kilden.
Vi vil tage et eksempel med connectors til to DBMS'er: PostgreSQL og MongoDB, — som jeg har erfaring med, og hvor der er forskelle (om end små, men i nogle tilfælde — betydelige!).
Konfigurationen beskrives i JSON-notation og indlæses i Kafka Connect ved hjælp af et POST-anmodning.
2.1. PostgreSQL
Eksempel på konfiguration af connectoren til PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Funktionsprincippet for connectoren efter denne konfiguration er ret simpelt:
- Ved første opstart opretter den forbindelse til databasen angivet i konfigurationen og starter i tilstand initial snapshot, der sender et initialt datasæt til Kafka, hentet ved hjælp af det betingede
SELECT * FROM table_name. - Når initialiseringen er afsluttet, skifter connectoren til at læse ændringer fra PostgreSQL's WAL-filer.
Om de anvendte muligheder:
-
name— navnet på connectoren, som konfigurationen nedenfor anvendes til; senere bruges dette navn til at arbejde med connectoren (dvs. se status/genstarte/opdatere konfigurationen) via REST API Kafka Connect; -
connector.class— klassen af DBMS connectoren, der skal bruges til den konfigurerede connector; -
plugin.name— navnet på pluginet til logisk dekodning af data fra WAL-filerne. Der er flere at vælge imellem:wal2json,decoderbuffsogpgoutput. De første to kræver installation af de relevante udvidelser i DBMS'en, menspgoutputPostgreSQL version 10 og højere ikke kræver yderligere manipulation; -
database.*— muligheder for at oprette forbindelse til databasen, hvordatabase.server.name— navnet på PostgreSQL instansen, der bruges til at danne emnenavnet i Kafka-klyngen; -
table.include.list— listen over tabeller, hvor vi ønsker at overvåge ændringer; angives i formatetschema.table_name; kan ikke bruges sammen medtable.exclude.list; -
heartbeat.interval.ms— interval (i millisekunder), som connectoren sender heartbeat-beskeder til det specielle emne; -
heartbeat.action.query— forespørgsel, der udføres ved hver sending af en heartbeat-besked (denne mulighed blev tilføjet i version 1.1); -
slot.name— navnet på replikationsslot, som connectoren vil bruge; publication.name— navn i PostgreSQL, som connectoren bruger. Hvis den ikke eksisterer, vil Debezium forsøge at oprette den. Hvis brugeren, som forbindelsen er oprettet med, ikke har tilstrækkelige rettigheder til denne handling, afslutter connectoren med en fejl;-
transformsbestemmer, hvordan navnet på det mål-emne ændres:-
transforms.AddPrefix.typeangiver, at vi vil bruge regulære udtryk; -
transforms.AddPrefix.regex— masken, som overstyrer navnet på det mål-emne; -
transforms.AddPrefix.replacement— det direkte, som vi overstyrer til.
-
Mere om heartbeat og transforms
Som standard sender connectoren data til Kafka ved hver kommitteret transaktion, og dens LSN (Log Sequence Number) registreres i et service-emne offset. Men hvad sker der, hvis connectoren er indstillet til at læse ikke hele databasen, men kun en del af dens tabeller (hvor datopdateringen ikke sker ofte)?
- Connectoren vil læse WAL-filer og ikke finde nogen kommittering af transaktioner i de tabeller, den overvåger.
- Derfor vil den ikke opdatere sin nuværende position hverken i emnet eller i replikationsslottet.
- Dette vil igen føre til "ophold" af WAL-filer på disken og muligvis udtømning af diskpladsen.
Og her kommer mulighederne til hjælp. heartbeat.interval.ms og heartbeat.action.query. Brug af disse muligheder i kombination gør det muligt at udføre en dataændringsforespørgsel i en separat tabel hver gang, der sendes en heartbeat-besked. Dermed opdateres LSN løbende, så connectoren befinder sig (i replikationsslottet). Dette gør det muligt for DBMS at slette WAL-filer, der ikke længere er nødvendige. Du kan lære mere om, hvordan mulighederne fungerer i .
En anden mulighed, der fortjener mere opmærksomhed, er transforms. Selvom den mere handler om bekvemmelighed og æstetik...
Som standard opretter Debezium emner baseret på følgende navngivningspolitik: serverName.schemaName.tableName. Dette kan ikke altid være praktisk. Mulighederne transforms man kan bruge regulære udtryk til at bestemme listen over tabeller, hvor hændelser skal dirigeres til et emne med et specifikt navn.
I vores konfiguration sker der følgende: Til slut i beskrivelsen af connectorens konfiguration for PostgreSQL bør vi nævne følgende funktionaliteter/begrænsninger: Lad os derfor indlæse vores konfiguration i connectoren: Vi kontrollerer, at indlæsningen var succesfuld, og at connectoren er startet: Fremragende: den er konfigureret og klar til brug. Nu vil vi opføre os som en forbruger og forbinde os til Kafka, hvorefter vi tilføjer og ændrer en post i tabellen: I vores emne vil dette blive vist som følger: Meget lang JSON med vores ændringer I begge tilfælde består posterne af nøglen (PK) for posten, der blev ændret, og selve essensen af ændringerne: hvordan posten så ud før, og hvordan den ser ud nu. Denne connector bruger den standard mekanisme til replikering i MongoDB, ved at læse information fra oplog'en på hovednoden af databasen. Ligesom den allerede beskrevne connector til PgSQL, tages der her også et primært snapshot af dataene ved første opstart, hvorefter connectoren skifter til oplog-læsning. Eksempel på konfiguration: Som man kan se, er der ingen nye muligheder sammenlignet med det tidligere eksempel, men antallet af muligheder, der har med forbindelse til databasen og deres præfikser at gøre, er blevet reduceret. Indstillinger Spørgsmålet om fejltolerance og høj tilgængelighed er mere aktuelt end nogensinde — især når vi taler om data og transaktioner, og overvågning af datændringer falder ikke uden for dette spørgsmål. Lad os se på, hvad der i princippet kan gå galt, og hvad der vil ske med Debezium i hver af situationerne. Der er tre former for fejl: Der er dog undtagelser. Hvis connectoren har været inaktiv i længere tid (eller ikke har kunnet nå MongoDB-instansen), og oplogget er blevet roteret i mellemtiden, vil connectoren upåvirket fortsætte med at læse data fra den første tilgængelige position, hvilket kan medføre, at nogle data i Kafka ikke bliver tabt. Debezium er min første erfaring med CDC-systemer, og den har i det hele taget været meget positiv. Projektet imponerer med sin støtte til de vigtigste databaser, enkel konfiguration, support til clustering og et aktivt fællesskab. Jeg anbefaler alle, der er interesserede i praksis, at tage et kig på vejledningerne for og . I sammenligning med JDBC-connectoren til Kafka Connect er den største fordel ved Debezium, at ændringerne læses fra databaserne logger, hvilket muliggør data med minimal forsinkelse. JDBC Connector (fra Kafka Connect-distributionen) laver forespørgsler til den overvågede tabel med faste intervaller og (af samme grund) genererer ikke meddelelser ved sletning af data (hvordan kan man anmode om data, der ikke eksisterer?). For similar tasks, you can consider the following solutions (besides Debezium): Læs også på vores blog: Kilde: habr.comtransforms alle CDC-hændelser fra den overvågede database vil komme ind i emnet med navnet data.cdc.dbname. Ellers (uden disse indstillinger) ville Debezium som standard oprette et emne for hver tabel af typen: pg-dev.public..
Begrænsninger for connectoren
Anvendelse af konfigurationen
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: værdien før (før) er lig med null, og efterfølgende er det strengen, der er blevet indsat. OPDATERING: i payload.before viser den tidligere tilstand af strengen, mens payload.after er den nye med essensen af ændringerne.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms denne gang gør følgende: omdanner navnet på det målrettede emne fra skemaet .. i data.cdc.mongo_.Fejltolerance
Konklusion
P.S.
