

Vi elsker logs hos Veeam. Og da de fleste af vores løsninger er modulære, skriver de en hel del logs. Da vores område er at sikre dine data (dvs. give dig ro i sindet), skal logs ikke kun registrere hver lille bevægelse, men også gøre det ret detaljeret. Dette er nødvendigt, så vi i tilfælde af problemer kan forstå, hvad der skete, hvem der var ansvarlig, og hvad der skal gøres næste gang. Her gælder det samme som i kriminologi: man ved aldrig, hvilken lille detalje der kan hjælpe dig med at finde morderen af Laura Palmer.
Derfor har jeg besluttet at kaste mig over en serie artikler, hvor jeg kronologisk vil fortælle om, hvad vi skriver i logs, hvor vi gemmer dem, hvordan man ikke mister besindelsen over deres struktur, og hvad man skal lede efter i dem.
Hvorfor en serie artikler, og hvorfor ikke beskrive alt på én gang?
Bare at liste, hvilken log der ligger hvor, og hvad der er gemt i den, er en ret håbløs opgave. Og tanken om at holde denne information opdateret er skræmmende. En simpel opstilling af alle mulige logtyper i Veeam Backup & Replication ville være et par sider med lille skrifttype. Og den ville kun være relevant på tidspunktet for offentliggørelsen, da der ved udgivelsen af den næste patch kan komme nye logs, logikken for de gemte informationer i de gamle kan ændre sig osv. Derfor vil det være meget mere fordelagtigt at forklare deres struktur og essensen af den information, de indeholder. Dette vil gøre det lettere at navigere i stedet for blot at huske navne.
For ikke at kaste os hovedkulds ind i tekststræk, lad os i denne artikel lave noget forberedende arbejde. Derfor vil vi ikke dykke ned i selve logs, men nærme os dem fra afstand: vi vil lave et glossar og diskutere strukturen af Veeam set fra loggenerering.
Glossar og jargon
Her skal jeg først undskylde til fortalerne for renheden i det danske sprog og til tilhængerne af Ožegov's ordliste. Vi elsker alle vores modersmål, men den forbandede IT-industri opererer på engelsk. Det var ikke os, der opfandt det, det er bare sådan, det historisk er blevet. Jeg kan ikke lastes for det, han kom selv.
I vores branche har problemet med anglicismer (og jargon) sin egen særlige karakter. Når man taler om uskyldige ord som "host" eller "gæst", forstår hele verden allerede helt konkrete ting, mens der på ⅙ af jordens overflade fortsat er en heroisk forvirring med at kigge i ordbøger. Og det strengt nødvendige argument "Men hos os på arbejdet…".
Derudover er der vores egen terminologi, som er specifik for Veeam produkter, selvom nogle ord og vendinger er blevet mere almindelige. Derfor vil vi nu blive enige om, hvad hvert term betyder, og fremover vil jeg under ordet "gæst" referere til det, der er skrevet i dette kapitel, ikke det, du er vant til på dit arbejde. Og ja, det er ikke blot mine personlige præferencer, det er etablerede begreber i branchen. At kæmpe imod dem er noget nær meningsløst. Men jeg er altid for en god diskussion i kommentarerne.
Desværre er der ekstremt mange termer i vores arbejde og produkter, så jeg vil ikke forsøge at opremse dem alle. Kun de mest grundlæggende og nødvendige for at overleve i havet af information om backup og logs. For dem, der er interesserede, kan jeg også fra mine kolleger om bånd, hvor han også førte en liste over termer, der relaterer til den del af funktionaliteten.
Host: I virtualiseringsverdenen er det en maskine med en hypervisor. Uanset om den er fysisk, virtuel eller i skyen — det er ligegyldigt. Hvis der kører en hypervisor (ESXi, Hyper-V, KVM etc.) på noget, kaldes det en host. Uanset om det er et cluster med ti rack eller din bærbare med en lab, der kører halvanden virtuel maskine — så længe der kører en hypervisor, er det blevet en host. Fordi hypervisoren hoster virtuelle maskiner. Der er endda en historie om, at VMware engang ønskede at etablere en stærk sammenhæng mellem ordet host og netop ESXi. Men det lykkedes dem ikke.
I dagens verden er begrebet "host" praktisk talt blevet synonymt med "server", hvilket skaber en vis forvirring i kommunikationen, især når det handler om Windows infrastruktur. Enhver maskine, som har nogen interessant service, kan trygt kaldes en host. For eksempel i WinSock logs er ordet host markeret for alt muligt. Det klassiske "Host not found" er et eksempel på dette. Så lad os udgå fra konteksten, men huske — i virtualiseringens verden er en host det, der hoster gæster (om dette to linjer nedenfor).
Fra lokale jargon (mere akronymer i dette tilfælde) huskes det, at VMware er VI, vSphere er VC, og Hyper-V er HV.
Gæst (Guest): En virtuel maskine, der kører på en vært. Det er så logisk og simpelt, at der knap er noget at forklare. Men mange insisterer på at bringe andre betydninger ind her.
Hvorfor? Jeg ved det ikke.
Guest OS er derfor operativsystemet på den gæstemaskine. Og så videre.
Backup/Replication Job (job): Ren VMware-jargon, der indikerer en af opgaverne. Backup job == Backup Job. Ingen har fundet en pæn oversættelse til dansk, så alle siger "job". Med tryk på den sidste stavelse.
Ja, sådan tager de bare og siger "job". Og selv i e-mails skrives det sådan, og alt er fint.
Diverse Backup-arbejder, Backup-opgaver osv., tak, men nej tak. Bare job, så forstår man det. Det vigtigste er at lægge trykket på den sidste stavelse.
Backup (Backup, bakket op. For de ægte oldschoolere tillades derivatet "bakup"): Udover den åbenlyse (en eller anden backup-kopi af data), betyder det også selve jobben (de tre sætninger tidligere, hvis man allerede har glemt det), som skaber den ønskede backup-fil. Sandsynligvis er de engelsktalende for dovne til at sige I ran my backup job hver gang, så de siger bare I ran my backup, og alle forstår hinanden glimrende. Jeg foreslår, at vi støtter dette vidunderlige initiativ.
Konsolidering (Consolidate): En betegnelse, der opstod i ESXi 5.0 En mulighed i menuen til arbejde med snapshots, der starter processen med at slette de såkaldte orphaned snapshots. Det vil sige snapshots, der fysisk eksisterer, men er faldet ud af den synlige logiske struktur. Teoretisk set burde denne proces ikke berøre de filer, der vises i snapshots manager, men der sker ofte uventede ting. Essensen af konsolideringsprocessen er, at data fra snapshotet (child disk) skrives tilbage til den primære (parent) disk. Processen med at slå plader sammen kaldes merging. Hvis der er givet en ordre til konsolidering, kan optegnelsen for snapshotet slettes fra databasen tidligere, end det faktiske snapshot er blevet smeltet sammen og slettet. Og hvis snapshotet ikke kunne slettes af en eller anden grund, opstår der de såkaldte orphaned snapshots. Der er et Og vi har også på et tidspunkt .
Datastore (Store eller storage): Et meget bredt begreb, men inden for virtualisering refererer det til et sted, hvor filer til virtuelle maskiner opbevares. Men uanset hvad, er det vigtigt at forstå konteksten meget klart og, ved mindste tvivl, præcisere, hvad din samtalepartner faktisk mente.
Proxy (Proxy): Det er vigtigt straks at forstå, at Veeam Proxy ikke helt er det samme, som vi er vant til i internettets verden. Inden for Veeam-produkter er det en slags enhed, der håndterer overførslen af data fra et sted til et andet. Uden at gå i detaljer er VBR en kommandoserver, mens proxy er dens arbejdsheste. Proxyen er med andre ord en maskine, som trafikken strømmer gennem, og hvor de nødvendige VBR-komponenter er installeret for at hjælpe med at styre denne trafik. For eksempel kan den flytte data fra en kanal til en anden eller blot tilslutte diske (HotAdd mode).
Repository (Repository): Teknisk set er det blot en post i VBR-databasen, der angiver, hvor sikkerhedskopierne opbevares, og hvordan man tilslutter sig dette sted. Faktisk kan det være både en simpel CIFS-share og en separat disk, server eller en bucket i skyen. Igen er det i konteksten, men vi forstår, at repository simpelthen er et sted, hvor dine sikkerhedskopier ligger.
Snapshot (Snapshot): Forkæmpere for Oxford-grammatik foretrækker at sige enten snEpShot eller snApShot, men det analfabetiske flertal vinder på grund af sin overvægt. Hvis nogen ikke ved det — det er en teknologi, der gør det muligt at genskabe tilstanden af disken på et bestemt tidspunkt. Dette gøres enten ved midlertidigt at omdirigere I/O-operationer væk fra den primære disk — det kaldes et RoW (Redirect on Write) snapshot — eller ved at flytte de overskrevne blokke fra din disk til en anden — dette kaldes et CoW (Copy on Write) snapshot. Netop på grund af de brede anvendelsesmuligheder af disse funktioner kan Veeam udføre sin backup-magi. Strengt taget gælder det ikke kun for Veeam, men også for kommende udgivelser.
I dokumentationen og loggene for ESXi hersker der kaos omkring dette udtryk, og i konteksten af snapshots kan man støde på både snapshots, redo logs og endda delta diske. I Veeam's dokumentation er der ikke sådanne uoverensstemmelser, og et snapshot er et snapshot, mens redo log er netop REDO-filen, der er oprettet af en uafhængig non-persistent disk. REDO-filer slettes, når den virtuelle maskine slukkes, så at forveksle dem med snapshots er en sikre vej til fiasko.
Syntetisk (Synthetics): Syntetiske backuper refererer til reverse incremental og forever forward backups. Hvis du ikke har stødt på dette udtryk før, så er det blot en af mekanismerne, der anvendes til at bygge omformningen af backupkæden. Dog kan man i loggene også se begrebet Transform, som bruges til at skabe komplette kopier ud fra inkrementer (synthetic full).
Opgave (Task): Dette er processen med at behandle hver enkelt maskine inden for en job. Det vil sige: hvis du har et backup-job, der inkluderer tre maskiner, vil hver maskine blive behandlet inden for en separat opgave. I alt vil der være fire logfiler: én hovedlog for jobbet og tre for opgaverne. Dog er der en vigtig nuance her: over tid er ordet "opgave" blevet alt for flertydigt. Når vi taler om generelle logfiler, forstår vi, at opgaven refererer til den virtuelle maskine. Men der er også "opgaver" på proxyen og på repositoryet. Der kan det henvise til både en virtuel disk, en virtuel maskine og hele jobbet. Så det er vigtigt at bevare konteksten.
Veeam %name% Service (Service): Til gavn for succesfulde backuper arbejder flere tjenester, hvis liste kan findes i den standard administrative konsol. Deres navne afspejler klart deres essens, men blandt ligestillede er den vigtigste — Veeam Backup Service, uden hvilken de andre ikke vil fungere.
VSS: Teknisk set bør VSS altid betyde Microsoft Volume Shadow Copy Service. Faktisk bruges det ofte som synonym for Application-Aware Image Processing. Hvilket selvfølgelig er helt forkert, men det er en historie af den slags: "Enhver SUV kan kaldes en jeep, og så forstår folk dig."
Fantastiske logfiler og steder, hvor de lever
Jeg vil begynde dette kapitel med at afsløre den store hemmelighed — hvornår vises tiderne i loggene?
Husk:
- ESXi skriver altid logfiler i UTC+0.
- vCenter fører logfiler i tiden for sin tidszone.
- Veeam fører logfiler ud fra tiden og tidszonen for den server, det er installeret på.
- Og kun Windows-events i EVTX-formatet er ikke bundet til noget. Ved åbning genberegnes tiden til den maskine, hvor de blev åbnet. Den mest praktiske løsning, selvom der nogle gange opstår problemer med den. Den eneste mærkbare vanskelighed er sprogindstillingerne. Det er næsten garanteret en vej til ulæselige logs. Ja, der er måder at løse dette på, men lad os ikke diskutere, at alt i IT fungerer på engelsk, og lad os blive enige om altid at indstille den engelske sprogindstilling på serverne. Vær så venlig.
Nu skal vi dog tale om, hvor logs gemmes, og hvordan man får fat i dem. I tilfælde af VBR er der to tilgange.
Den første mulighed er velegnet, hvis du ikke brænder for at lede efter filer, der specifikt relaterer sig til dit problem i bunken. Til dette har vi en separat wizard, hvor du kan angive et specifikt job og en specifik periode, for hvilken du har brug for logs. Derefter vil den selv gennemgå mapperne og samle alt nødvendigt i et enkelt arkiv. Hvor du kan finde det, og hvordan du arbejder med det, er der skrevet i .
Men wizarden samler ikke logs fra alle opgaver, og for eksempel, hvis du har brug for at undersøge logs for restaureringen, failover eller failback, så er din vej til mappen %ProgramData%/Veeam/Backup. Dette er det primære log-lager for VBR, og %ProgramData% er en skjult mappe, hvilket er normalt. Forresten kan standardplaceringen ændres ved hjælp af en registreringsnøgle af typen REG_SZ: LogDirectory i nøglen HKEY_LOCAL_MACHINESOFTWAREVeeamVeeam Backup and Replication.
På Linux-maskiner skal du lede efter logs fra arbejdsagenterne i /var/log/VeeamBackup/, hvis du bruger en root- eller sudo-konto. Hvis du ikke har sådanne privilegier, så søg logs i /tmp/VeeamBackup.
For Veeam agent for %OS_name% skal logs findes i %ProgramData%/Veeam/Endpoint (eller %ProgramData%/Veeam/Backup/Endpoint) og /var/log/veeam henholdsvis.
Hvis du bruger Application-Aware Image Processing (og det gør du sandsynligvis), så gør situationen sig lidt mere kompleks. Du får brug for logs fra vores hjælper, som er gemt inden i den virtuelle maskine, samt VSS-logs. Om hvordan og hvor man får fat i disse oplysninger, er der skrevet i . Og selvfølgelig er der om indsamling af nødvendige systemlogs.
Windows-begivenheder kan bekvemt indsamles i henhold til . Hvis du bruger Hyper-V, bliver det mere kompliceret, da du også får brug for alle logs fra sektionen Applications and Service Logs > Microsoft > Windows. Selvom du altid kan gå den mere klodsede vej og blot tage alle objekter fra %SystemRoot%System32winevtLogs.
Hvis noget går galt under installationen/opgraderingen, kan alt nødvendigt findes i mappen %ProgramData%/Veeam/Setup/Temp. Selvom jeg ikke vil skjule, at der i Windows-hændelserne kan findes mere nyttig information end i disse logs. Den resterende interessante information findes i %Temp%, men der ligger hovedsageligt installationslogs for tilknyttede programmer, som databaser, .Net-biblioteker og lignende. Husk, at Veeam installeres fra en msi, og alle dens komponenter også installeres som separate msi-pakker, selvom det ikke blev vist i GUI. Derfor, hvis installationen af en af komponenterne fejler, vil hele installationen af VBR blive stoppet. Så man skal gå ind i loggene og se, hvad der præcist gik galt og hvornår.
Og et lifesaver-trick til sidst: når du får en fejl under installationen, så skynd dig ikke med at trykke OK. Først hent loggene, og derefter tryk OK. På den måde får du en log, der slutter på tidspunktet for fejlen, uden skrald til slut.
Og nogle gange er det nødvendigt at dykke ned i vSphere-loggene. Det er en meget taknemmelig opgave, men når man slår ærmerne op, må man gøre selv det. I det enkleste tilfælde skal vi bruge logs med hændelser fra den virtuelle maskine vmware.log, som ligger ved siden af dens .vmx-fil. I mere komplekse tilfælde åbner vi Google og spørger, hvor loggene ligger for din version af værten, da VMware elsker at ændre dette fra udgivelse til udgivelse. Her er for eksempel , og her til . For vCenter-logger gentager vi proceduren med . Men generelt vil vi være interesseret i logs for værtens hændelser hostd.log, hændelser fra værter styret af vCenter vpxa.log, kernel-logs vmkernel.log og autentifikationslogs auth.log. I de mest avancerede tilfælde kan loggen for SSO, som ligger i SSO-mappen, være nyttig.
Omfangsrigt? Forvirrende? Skræmmende? Men det er ikke engang halvdelen af den information, som vores support arbejder med til daglig. Så de er virkelig meget dygtige.
Veeam-komponenter
Og som afslutning på denne indledende artikel, lad os tale lidt om komponenterne i Veeam Backup & Replication. For når man leder efter årsagen til problemer, er det godt at forstå, hvordan patienten er opbygget.
Så, som alle sikkert ved, er Veeam Backup en såkaldt SQL-baseret applikation. Det vil sige, at alle indstillinger, al information og generelt alt, hvad der er nødvendigt for normal funktion, findes i dens database. Rettere sagt i to databaser, når vi taler om kombinationen af VBR og EM: VeeamBackup og VeeamBackupReporting, henholdsvis. Sådan er det blevet: vi installerer endnu en applikation — der opstår endnu en database. For at undgå at opbevare alle æggene i én kurv.
Men for at hele dette system fungerer glat, har vi brug for et sæt tjenester og applikationer, der binder alle komponenter sammen. Som et eksempel ser det sådan ud i et af mine laboratorier:
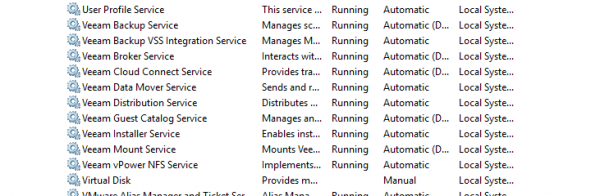
Som den primære dirigent fungerer Veeam Backup Service. Den har ansvaret for informationsudvekslingen med databaserne. Den har også ansvaret for at køre alle opgaver, orkestrere de tildelte ressourcer og fungerer som et kommunikationscenter for forskellige konsoller, agenter og meget mere. Med andre ord, uden den kan det slet ikke lade sig gøre, men det betyder bestemt ikke, at den klarer alt selv.
I udførelsen af dens opgaver hjælper Veeam Backup Manager. Dette er ikke en tjeneste, men en enhed, der håndterer opstarten af job og overvåger processen for deres udførelse. De arbejdende hænder af backup service, som forbinder den til værter, skaber snapshots, overvåger retention og så videre.
Men lad os vende tilbage til listen over tjenester. Veeam Broker Service. Introduceret i v9.5 (og det er ikke en kryptovaluta-miner, som nogle måske troede dengang). Den indsamler information om VMware-hosts og opretholder dens aktualitet. Men skynd dig ikke at skrive arrige kommentarer om, at vi spionerer på dig og lækker alle dine loginoplysninger. Det er noget enklere. Når du starter en backup, skal du først tilslutte dig hosten og opdatere alle data om dens struktur. Det er en ret langsommelig og besværlig proces. Bare tænk på, hvor lang tid det tager at logge ind via webgrænsefladen, og husk, at der kun tages højde for det øverste lag. Og så skal hele hierarkiet også åbnes op til det ønskede sted, ved du. På en måde er det skrækkeligt. Hvis du kører ti backups, skal hver job gennemføre denne procedure. Hvis vi taler om store infrastrukturer, kan denne proces tage ti minutter eller mere. Derfor blev det besluttet at dedikere en separat tjeneste til dette, hvor du altid kan få aktuel information. Den kontrollerer og scanner hele den tilføjede infrastruktur ved opstart, og derefter forsøger at arbejde kun på niveauet af inkrementelle ændringer. Så selv hvis du kører 100 backups samtidig, anmoder de alle om information fra vores broker og ikke plager hostene med deres forespørgsler. Hvis du er bekymret for ressourcerne, så viser vores beregninger, at 5000 virtuelle maskiner kun kræver cirka 100 Mb hukommelse.
Dernæst har vi Veeam Console. Også kendt som Veeam Remote Console, Veeam.Backup.Shell. Det er det GUI, vi ser på skærmbillederne. Det er enkelt og indlysende – konsollen kan startes fra hvor som helst, så længe det er Windows og der er forbindelse til VBR-serveren. Det eneste, der kan siges: FLR-processen vil montere punkter lokalt (dvs. på maskinen, hvor konsollen kører). Og de forskellige Veeam Explorers vil også blive startet lokalt, da de er en del af konsollen. Men det fører mig ind i dybderne…
Den næste interessante tjeneste er Veeam Backup Catalog Data Service. I listen to the service known as Veeam Guest Catalog Service. It indexes file systems on guest machines and fills this knowledge into the VBRCatalog folder. It is only used where indexing is enabled. And it makes sense to enable it only if you have an Enterprise Manager. Therefore, a piece of advice: don't enable indexing just like that if you don't have EM. Save your nerves and support time.
Also, among other important services, it is worth noting Veeam Installer Service, which is responsible for delivering and installing the necessary components on proxies, repositories, and other gateways. In fact, it transports the required .msi packages to the servers and conducts their installation.
Veeam Data Mover — which, through auxiliary agents running on proxies (and not only), handles the relocation of data. For example, during backup, one agent will read files from the host's datastores, while another will carefully write them into the backup.
I would like to point out an important thing that clients often react to — the discrepancy between the versions of services and the information in the Programs and Features snap-in. Yes, the list will be the same, but the versions may be completely different. This is not very healthy from a visual standpoint, but it's completely normal if everything works stably. For example, the version number of the Installer service lags considerably behind its neighbors. A nightmare? No, because it is not completely reinstalled but just its DLL is updated. In patch v9.5 U4, a nightmare for support happened: during the update, all services received new versions except for the most important one. In patch U4b, the transport service surpassed all others by two versions (if judged by the numbers). And this is also normal — a serious bug was found in it, which is why it received a bonus update relative to the others. Therefore, to summarize: the version difference MAY be a problem, but if the difference is present and everything works correctly, then probably it is supposed to be that way. But no one forbids you from checking with support.
These were the so-called mandatory services. There is also a whole batch of auxiliary services, such as Tape Service, Mount Service, vPowerNFS Service, and so on.
For Hyper-V, the same is true, but there is a specific Veeam Backup Hyper-V Integration Service and its own driver for working with CBT.
Og til sidst skal vi tale om, hvem der arbejder på virtuelle maskiner under backup. For at starte pre- og post-freeze scripts, oprette shadow copies, indsamle metadata, håndtere SQL-transaktion logfiler og andet bruges der Veeam Guest Helper. Og hvis der sker indeksering af filsystemer, Veeam Guest Indexer . Det er midlertidige tjenester, der implementeres under backup og fjernes efterfølgende.
I tilfælde af Linux-maskiner er det meget enklere på grund af det store antal indbyggede biblioteker og systemets muligheder. For eksempel foretages indeksering via mlocate.
Det er alt for nu
Jeg nægter at plage dig mere og den korte introduktion til Veeams indre funktioner anser jeg for afsluttet. Ja, vi har endda ikke været tæt på selve logfilerne, men tro mig, for at informationen, der præsenteres i dem, ikke skal virke som en usammenhængende strøm af bevidsthed, er en sådan indledning helt sikkert nødvendig. Jeg planlægger kun at gå videre til logfilerne i den tredje artikel, og planen for næste gang er at forklare, hvem der genererer logfilerne, hvad der præcist vises i dem, og hvorfor det ser sådan ud, og ikke på en anden måde.
Kilde: habr.com
