

Vi argumenterer grundigt for, hvad der gør OceanStor Dorado 18000 V6 til et virkelig high-end datalagringssystem med et solidt fundament for de kommende år. Samtidig afviser vi almindelig bekymring omkring All-Flash-lagring og viser, hvordan Huawei får maksimalt ud af dem: end-to-end NVMe, yderligere caching på SCM og en række andre løsninger.
Det nye datalandskab — ny datalagring
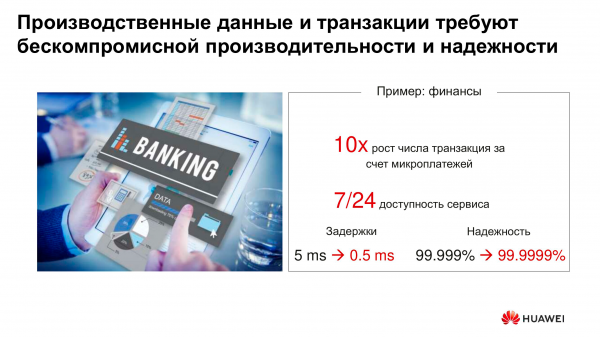
Intensiteten i databehandling stiger i alle brancher. Og banksektoren er den mest illustrative. I løbet af de seneste år er antallet af banktransaktioner steget med over ti gange. Som viser , kun i Rusland er antallet af kontantløse transaktioner via kreditkort steget mere end treogtyve gange — fra 5,8 til 172 per person om året fra 2010 til 2018. Det skyldes primært succesen med mikrobets: de fleste af os har vænnet sig til online banking, og vores bank er nu lige ved hånden — i telefonen.
IT-infrastrukturen i kreditinstitutionen skal være klar til sådan en udfordring. Og det er virkelig en udfordring. Blandt andet, hvis det tidligere var tilstrækkeligt for banken at sikre datatilgængelighed kun i sine arbejdstimer, så er det nu — 24/7. For ikke så længe siden blev 5 ms betragtet som en acceptabel forsinkelse, og hvad så? Nu er selv 1 ms for meget. For et moderne datalagringssystem er målværdien — 0,5 ms.
Det samme gælder pålidelighed: i 2010'erne blev der dannet en empirisk forståelse af, at det er tilstrækkeligt at nå et niveau på 'fem nicher' — 99,999%. Men denne forståelse er blevet forældet. I 2020 er det helt normalt for virksomheder at kræve 99,9999% for lagring og 99,99999% for det arkitektoniske design som helhed. Og det er ikke en luksus, men en nødvendig betingelse: enten er der ikke noget vindue til vedligeholdelse af infrastrukturen, eller også er det meget lille.
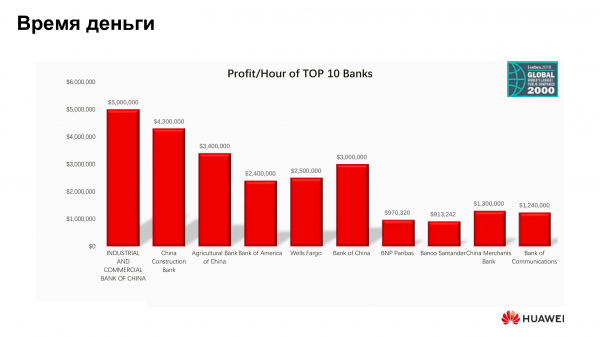
For clarity, it is convenient to project these indicators onto a monetary plane. The easiest way is to use the example of financial organizations. The diagram above shows how much each of the top 10 world banks earns in an hour. The Industrial and Commercial Bank of China alone makes a staggering $5 million. This is precisely how much an hour of downtime for the largest credit organization in China would cost (and only lost profits are taken into account in this calculation!). From this perspective, it becomes evident that reducing downtime and improving reliability is not just a matter of single percentage points — even fractions of a percent are entirely rational. This is not only due to the need to enhance competitiveness but also simply to maintain market positions.
Comparable changes are occurring in other industries. For example, in air transport: before the pandemic, aviation was only gaining momentum year after year, and many started using it almost like a taxi service. Regarding consumer patterns, society has developed a habit of total service availability: upon arrival at the airport, we require Wi-Fi access, access to payment services, maps, and so on. As a result, the load on infrastructure and services in public spaces has increased exponentially. The approaches to building this infrastructure that we considered acceptable just a year ago are rapidly becoming outdated.
Is it too early to switch to All-Flash?
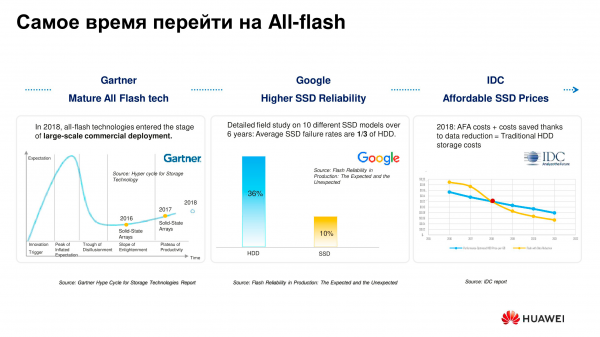
To solve the tasks mentioned above, AFA — all-flash arrays, which are entirely flash-based, are the best fit from a performance standpoint. Until recently, doubts remained about whether they are as reliable as those built on HDDs and hybrid systems. After all, solid-state flash memory has a metric known as mean time between failures (MTBF). Unfortunately, the degradation of cells due to input-output operations is a reality.
Derfor blev udsigterne ved All-Flash forstyrret af spørgsmålet om, hvordan man forhindrer datatab, hvis SSD'en skulle svigte. Backup er en velkendt mulighed, men genoprettelsestiden ville være uacceptabelt lang i henhold til moderne krav. En anden løsning er at etablere et sekundært lagring på roterende enheder, men med denne ordning går man glip af nogle af fordelene ved et "rent flash"-system.
Men tallene fortæller en anden historie: Statistikkene fra digitaløkonomiens giganter, herunder Google, viser de seneste år, at flash er langt mere pålideligt end harddiske. Både på kort og lang sigt: i gennemsnit holder flash-lagringsenheder fire til seks år, før de svigter. I forhold til datalagring pålidelighed er de ikke mindre end lagringsenheder på roterende magnetiske diske, og de overgår dem undertiden.
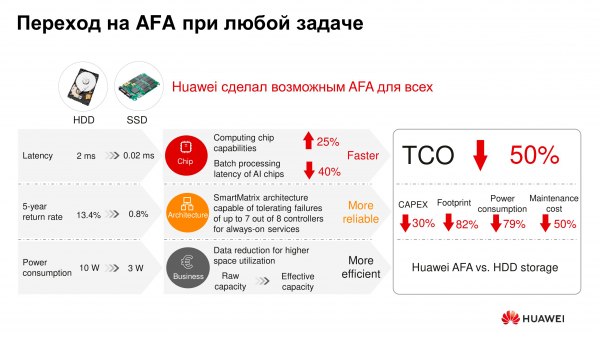
Et andet traditionelt argument for roterende lagringsenheder er deres prisvenlighed. Der er ingen tvivl om, at omkostningerne ved at opbevare en terabyte på en harddisk stadig er relativt lave. Og hvis man kun ser på udgifterne til udstyret, er det billigere at opbevare en terabyte på en roterende enhed end på en SSD. Men når det kommer til økonomisk planlægning, er det ikke kun prisen for det konkrete udstyr, der tæller, men også den samlede ejeromkostning i det lange løb - fra tre til syv år.
Set fra denne vinkel ser det helt anderledes ud. Selv hvis man ser bort fra deduplikation og kompression, som typisk anvendes på flash-enheder og gør dem økonomisk fordelagtige, er der stadig karakteristika som pladskrav i rack, varmeafgivelse og energiforbrug. Og her vinder flash over forgængerne. Resultatet er, at TCO for flash-lagringssystemer ofte er næsten halveret i forhold til systemer med roterende lagringsenheder eller hybrider.
Ifølge ESG-agenturets rapporter kan man med All-Flash lagringssystemer som Dorado V6 opnå en reduktion i ejeromkostningerne med op til 78% over en femårsperiode — herunder gennem effektiv deduplikation og kompression samt takket være lavt energiforbrug og varmeudvikling. Det tyske analysefirma DCIG anbefaler også deres brug som de mest optimale med hensyn til TCO blandt de tilgængelige løsninger i dag.
Brugen af solid-state drev giver mulighed for at spare plads, reducerer antal fejl, forkorter vedligeholdelsestiden for løsningen og mindsker energiforbruget og varmeudviklingen fra lagringssystemer. Det viser sig, at AFA økonomisk set i det mindste er sammenlignelig med traditionelle arrays baseret på roterende drev og ofte overgår dem.
Royal Flash fra Huawei
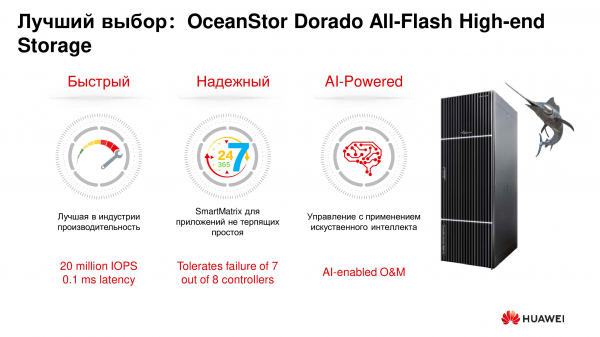
Blandt vores All-Flash lagringsløsninger besætter den høje ende OceanStor Dorado 18000 V6 en topplads. Ikke kun blandt vores, men i hele branchen har den rekord for hastighed — op til 20 millioner IOPS i den maksimale konfiguration. Derudover er den ekstremt pålidelig: selv hvis to controllere samtidig svigter, eller op til syv controllere én efter én, eller hvis en hel motor fejler — dataene forbliver intakte. De betydelige fordele ved 'atten tusinde' kommer også fra den indbyggede AI, herunder fleksibiliteten i styringen af interne processer. Lad os se på, hvordan alt dette opnås.
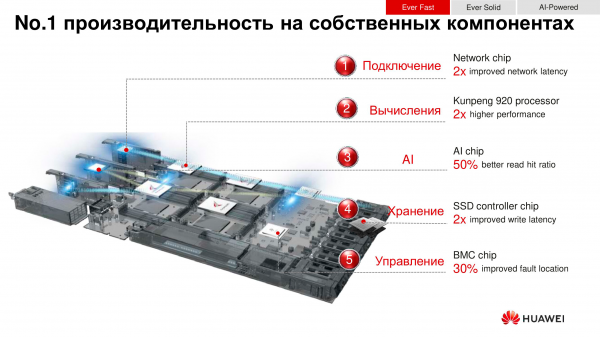
En væsentlig del af fordelene ved Huawei skyldes, at de er den eneste producent på markedet, der fuldt ud fremstiller lagringssystemer selv — fra bunden til slutproduktet. Vi har vores egen arkitektur, egen mikrocode og egen service.
Controlleren i OceanStor Dorado-systemerne er bygget på en processor, der er udviklet og produceret af Huawei — Kunpeng 920. Den inkluderer Intelligent Baseboard Management Controller (iBMC), som også er vores. AI-chips, specifikt Ascend 310, der optimerer fejlfrekvensprognoser og giver anbefalinger til indstillinger, er også fra Huawei, ligesom input-output-kortene — Smart I/O-modulet. Endelig er controllere i solid-state drev designet og fremstillet af vores egne ressourcer. Alt dette giver en base for at skabe en integreret, afbalanceret og højtydende løsning.
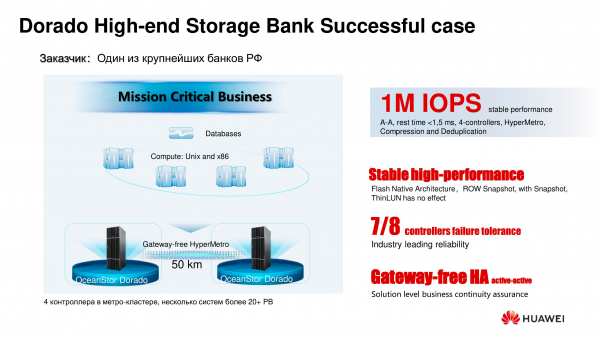
I det forløbne år har vi implementeret dette, vores mest avancerede storage-system, i en af de store russiske banker. Resultatet er mere end 40 enheder OceanStor Dorado 18000 V6 i et metro-kluster, der viser stabil ydeevne: fra hvert system kan der hentes over en million IOPS, selv under hensyntagen til forsinkelser på grund af afstand.
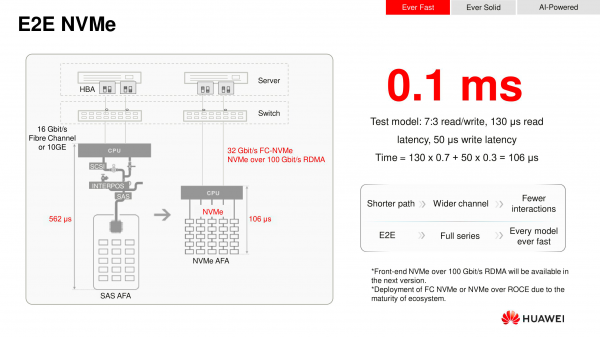
End-to-end NVMe
De nyeste datalagringssystemer fra Huawei understøtter end-to-end NVMe, hvilket vi naturligvis lægger vægt på. De traditionelt anvendte protokoller til adgang til lagerenheder blev udviklet i den fjerne it-fortid: i deres fundament ligger SCSI-kommandoer (hej, 1980'erne!), som medfører en række funktioner for at sikre bagudkompatibilitet. Hvilken adgangsmetode man end vælger, er protokoloverheadet enormt i sådanne tilfælde. Som følge heraf kan lagre, der bruger SCSI-baserede protokoller, ikke have en I/O-latens under 0,4–0,5 ms. På den anden side er NVMe — Non-Volatile Memory Express — en protokol skabt til at arbejde med flash-hukommelse og er fri for de nævnte begrænsninger for at opnå den berygtede bagudkompatibilitet; den reducerer latenstiden til 0,1 ms, ikke kun på lagringssystemet, men gennem hele stakken, fra værten til lagerenhederne. Det er ikke overraskende, at NVMe ligger i tråd med udviklingstendenserne inden for datalagring fremadskuende. Vi har også satset på NVMe og bevæger os gradvist væk fra SCSI. Alle de nuværende datalagringssystemer fra Huawei, inklusiv Dorado-serien, understøtter NVMe (dog er det kun i de avancerede modeller af Dorado V6, at det realiseres som end-to-end).
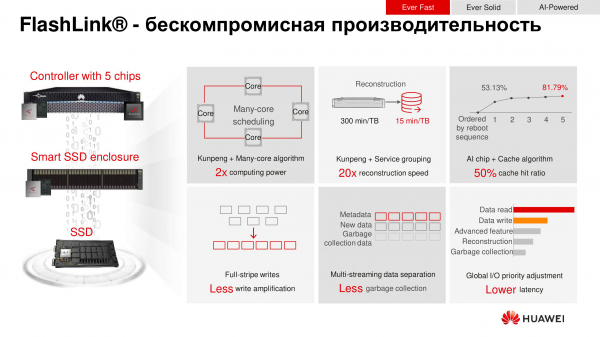
FlashLink: en håndfuld teknologier
FlashLink er grundpillen i hele OceanStor Dorado-serien. Mere præcist er det et udtryk, der dækker et integreret sæt teknologier, der sikrer høj ydeevne og pålidelighed. Dette inkluderer teknologier til deduplisering og kompression, datadistrubutionssystemet RAID 2.0+, adskillelse af 'kolde' og 'varme' data samt strimlet sekventiel skrivning af data (vilkårlige skrivninger, med nye og ændrede data, aggregeres i en stor bunke og skrives sekventielt, hvilket øger læse-skrive-hastigheden).
Derudover inkluderer FlashLink to vigtige komponenter — Wear Leveling og Global Garbage Collection. Disse fortjener en særlig omtale.
Faktisk er enhver SSD en mini-version af et SAN med et stort antal blokke og en controller, der sikrer datatilgængelighed. Dette opnås blandt andet ved, at data fra "slidte" celler flyttes til "uslidte". På den måde garanteres det, at de kan læses. Der findes forskellige algoritmer til sådan overførsel. Generelt forsøger controlleren at udligne slid på alle celler i drevet. Denne tilgang har en ulempe. Når der flyttes data inden i SSD'en, reduceres antallet af input-output operationer markant. På nuværende tidspunkt er dette et uundgåeligt onde.
Således, hvis der er mange SSD'er i systemet, danner ydeevnen en "sav", med skarpe toppe og dale. Problemet er, at en enkelt enhed i puljen kan udløse dataflytningen når som helst, og den samlede ydeevne aflæses samtidigt fra alle SSD'er i arrayet. Men ingeniører fra Huawei har fundet ud af, hvordan man undgår dannelsen af "savne".
Heldigvis er både controllerne i drevene, controlleren til lageret, og firmwaren hos Huawei "indfødte", disse processer i OceanStor Dorado 18000 V6 startes centralt og synkront på alle drev i arrayet. Og det sker på kommando af SAN-controlleren og netop når der ikke er stort input-output pres.
AI-chippen deltager også i at vælge det rette tidspunkt for dataflytning: baseret på statistikken fra de seneste par måneder kan den med høj sandsynlighed forudsige, om der snart forventes aktiv input-output, og hvis svaret er negativt, og systembelastningen på nuværende tidspunkt er lav, befaler controlleren alle drevene: dem der har brug for Wear Leveling, at udføre det på én gang og synkront.
Desuden kan systemets controller se, hvad der sker i hver celle af drevet, i modsætning til SAN-systemer fra konkurrenter: de er tvunget til at købe solid-state medier fra tredjepartsleverandører, hvilket gør celleniveau-detaljeringen utilgængelig for controllerne i sådanne lager.
Som konsekvens har OceanStor Dorado 18000 V6 en meget kort periode med præstationsnedgang under Wear Leveling-operationer, som primært udføres, når ingen andre processer forstyrrer. Dette giver en høj og stabil ydeevne over tid.
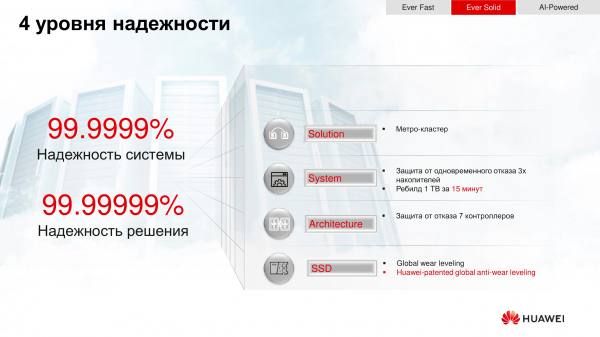
Hvad gør OceanStor Dorado 18000 V6 pålideligt
I moderne datalagringssystemer skelnes der mellem fire niveauer af pålidelighed:
- hardware, på lagerniveau;
- arkitektonisk, på udstyrs niveau;
- arkitektonisk sammen med software;
- kombineret, der vedrører løsningen som helhed.
Da vores virksomhed selv designer og fremstiller alle komponenter i SAN, sikrer vi pålidelighed på hver af de fire niveauer med mulighed for grundigt at overvåge, hvad der sker på hvert enkelt niveau i realtid.
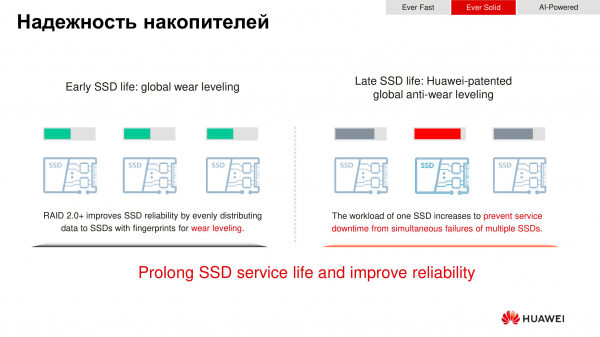
Pålideligheden af lagrene garanteres først og fremmest af de tidligere beskrevne Wear Leveling og Global Garbage Collection. Når SSD'en fremtræder som en sort boks for systemet, er det uvidende om, hvordan cellerne specifikt slides. For OceanStor Dorado 18000 V6 er lagrene gennemsigtige, hvilket gør det muligt at udføre jævn fordeling over alle lagrene i arrayet. Dette kan betydeligt forlænge SSD'ens levetid og sikre en høj grad af pålidelighed i deres funktion.
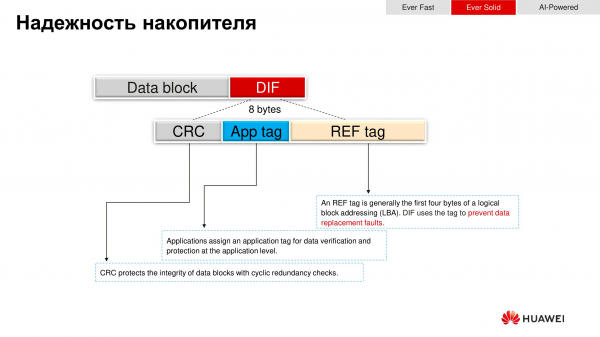
Desuden påvirker ekstra redundante celler i lageret pålideligheden. Ud over den enkle reserve benyttes der også såkaldte DIF-celler i SAN, hvor kontrolsummen samt ekstra koder opbevares for at beskytte hver blok mod enkeltfejl, i tillæg til beskyttelsen på RAID-array niveau.
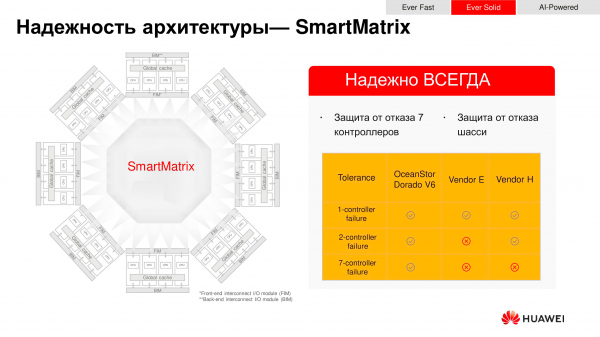
Nøglen til den arkitektoniske pålidelighed er SmartMatrix-løsningen. Kort sagt består den af fire controllere, der sidder på en passiv backplane i et enkelt motoranlæg. To sådanne motoranlæg — hver med otte controllere — forbindes til de fælles hylder med lager. Takket være SmartMatrix vil selv hvis syv controllere ud af otte stopper med at fungere, være der stadig adgang til alle data både til læsning og skrivning. Og ved tab af seks controllere ud af otte kan man endda fortsætte med caching-operationer.
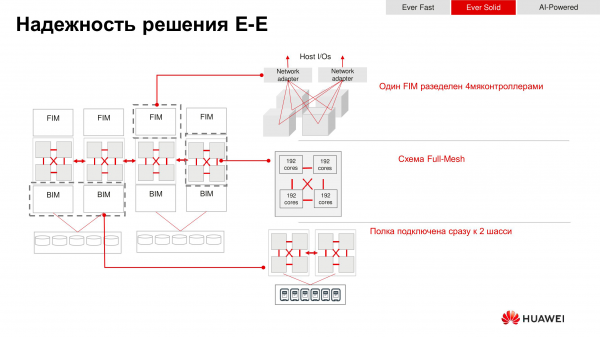
I/O-kort på det samme passive backplane er tilgængelige for alle controllere, både frontend og backend. Med denne fuld-mesh forbindelse er adgangen til lagringsenheder altid bevaret, uanset hvad der måtte gå i stykker.
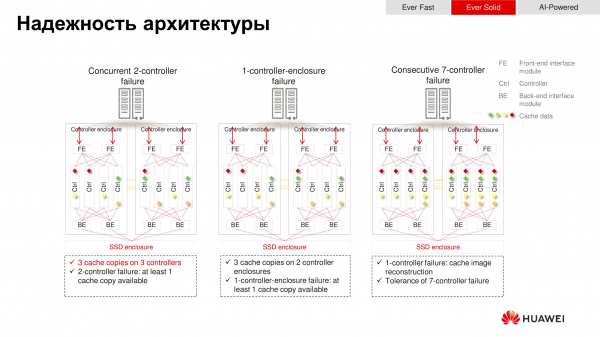
Det er mest relevant at tale om arkitekturens pålidelighed i konteksten af fejlscenarier, som datalagringssystemet er i stand til at beskytte mod.
Lagringssystemet vil overleve uden tab, hvis to controllere fejler, selv hvis det sker samtidig. Denne robusthed opnås ved at hver cacheblok nødvendigvis har to kopier på forskellige controllere, hvilket betyder, at den i alt eksisterer i tre kopier. Desuden er mindst en af dem på en anden controller. Således, selv hvis en hel controller går ned — med alle fire controllere — er det garanteret, at al information, der var i cachen, bevares, da cachen vil blivedupliceret på mindst én controller fra den resterende controller. Endelig kan man ved sekventiel tilslutning miste op til syv controllere, og selv med deres tab i par ad to, vil al I/O og alle data fra cachen stadig være sikret.
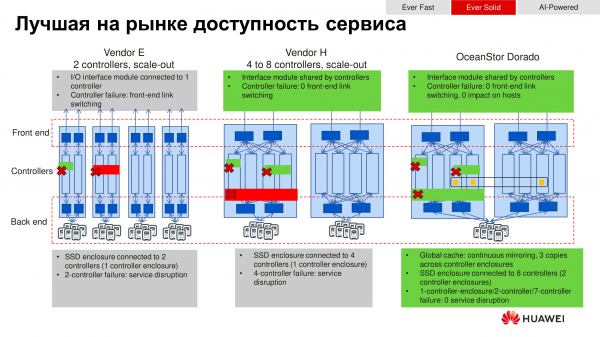
Sammenlignet med hi-end lagringssystemer fra andre producenter ses det, at kun Huawei sikrer fuld databeskyttelse og total tilgængelighed, selv efter tab af to controllere eller en hel controller. De fleste leverandører bruger en ordning med såkaldte controller-par, til hvilke lagringsenheder er tilsluttet. Desværre opstår der i en sådan konfiguration en risiko for tab af adgang til lagringsenheden ved I/O, hvis to controllere fejler.
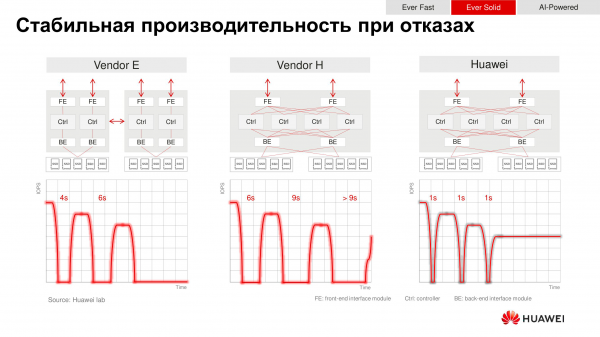
Desværre kan en enkelt komponents fiasko ikke udelukkes. I sådanne tilfælde vil ydeevnen falde i en periode: det er nødvendigt at rekonstruere vejene og genoptage adgangen til I/O-operationer vedrørende de blokke, der enten er kommet til skrivning, men endnu ikke er blevet skrevet, eller som er blevet anmodet om at blive læst. For OceanStor Dorado 18000 V6 er den gennemsnitlige rekonstrueringstid cirka et sekund — betydeligt mindre end den nærmeste analog i branchen (4 sekunder). Dette opnås takket være det passive backplane: når controlleren svigter, ser de andre straks dens I/O, og især hvilken datablok der ikke er blevet skrevet helt; i sidste ende overtager den nærmeste controller processen. Heraf muligheden for at genoprette ydeevnen på bogstaveligt talt et sekund. Det er værd at nævne, at intervallet er stabilt: et sekund på én controller, et sekund på en anden, osv.
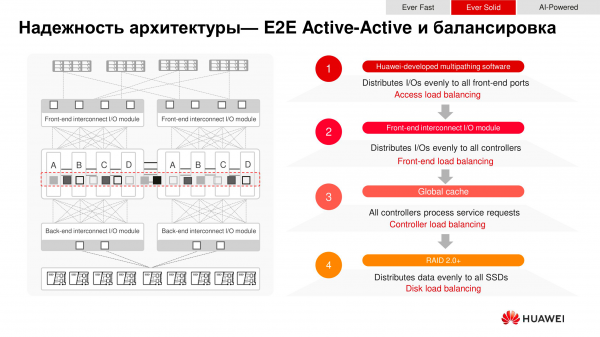
IOceanStor Dorado 18000 V6's passive backplane er alle kort tilgængelige for alle controllere uden nogen yderligere adressering. Det betyder, at enhver controller kan overtage I/O gennem enhver port. Uanset hvilken frontend-port I/O'en kommer til, er controlleren klar til at håndtere den. Heraf det minimale antal interne overførsler og en markant forenkling af balanceringen.
Balanceringen på frontend udføres ved hjælp af multipathing-driveren, og derudover udføres der balancering inden i selve systemet, da alle controllere kan se alle I/O-porte.
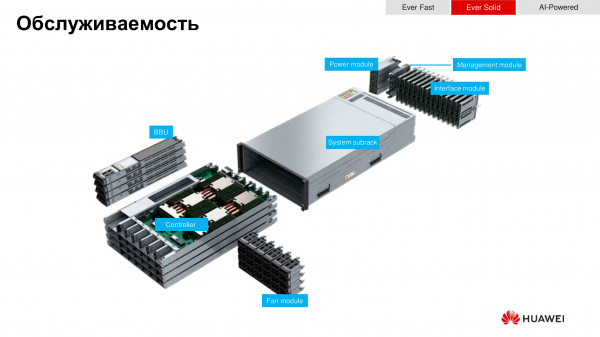
Traditionelt er alle Huawei-array udført på en måde, så de ikke har et enkelt fejlpunkt. Hot-swappable uden genstart af systemet er alle dens komponenter: controllere, strømmoduler, kølemoduler, I/O-kort osv.

Systemets pålidelighed generelt forbedres også af teknologier som RAID-TP. Dette er betegnelsen for RAID-gruppen, der gør det muligt at være sikret i tilfælde af samtidig svigt af op til tre lagringsenheder. Desuden tager en rebuild af 1 TB stabilt under 30 minutter. Det bedste registrerede resultat er otte gange hurtigere end med samme datamængde på en spindeldisk. På den måde er der mulighed for at bruge ekstremt store lagringsenheder, f.eks. på 7,68 eller endda 15 TB, uden at bekymre sig om systemets pålidelighed.
Det er vigtigt, at rebuild foregår ikke i spare drive, men i spare space — reservekapaciteten. Hver lagringsenhed har afsat plads til datarekonstruktion efter fejl. På den måde udføres genopretningen ikke efter "mange til en"-modellen, men efter "mange til mange"-modellen, hvilket væsentligt fremskynder processen. Og så længe der er ledig kapacitet, kan genopretningen fortsætte.
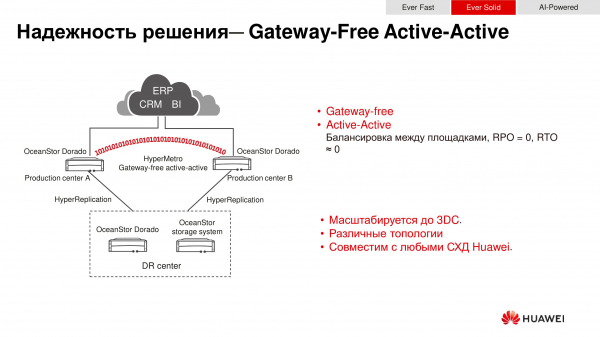
Det skal især nævnes, hvor pålideligt en løsning med flere lagringssystemer er — i metroklusteret, eller ifølge Huaweis terminologi, HyperMetro. Sådanne arkitekturer understøttes på hele vores modelrække af lagringssystemer og tillader både fil- og blokadgang. Desuden fungerer blokadgang både via Fibre Channel og Ethernet (inklusive iSCSI).
I bund og grund handler det om tovejsreplikation fra én SAN til en anden, hvor den replikerede LUN tildeles den samme LUN-ID som den primære. Teknologien fungerer især takket være konsistensen af cache mellem de to forskellige systemer. På den måde er det helt ligegyldigt for værten, hvilken side den befinder sig på: Den ser det samme logiske drev begge steder. Som følge heraf er der intet, der forhindrer implementeringen af et fejltolerant kluster, der strækker sig over to steder.
Til kvorum anvendes en fysisk eller virtuel Linux-maskine. Den kan være placeret på et tredje sted, og kravene til dens ressourcer er små. Et almindeligt scenarie er at leje et virtuelt sted udelukkende til hosting af kvorum-VM.
Teknologien tillader også skalering: to lagringssystemer — i metroklusteret, et ekstra sted — med asynkron replikation.
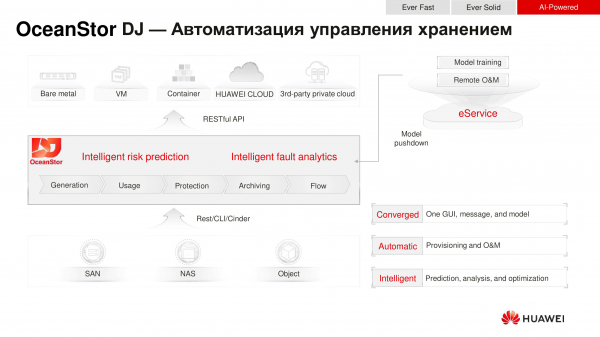
Historisk set har mange kunder dannet et "opbevaringszoo": en bunke SAN fra forskellige producenter, forskellige modeller, forskellige generationer, med forskellig funktionalitet. Samtidig kan antallet af værter være betydeligt, og ofte er de virtualiserede. Under sådanne forhold er en af de prioriterede opgaver i administrationen hurtigt, ensartet og bekvemt at tilbyde logiske diske til værterne, helst på en måde, så man ikke behøver at bekymre sig om, hvor disse diske fysisk befinder sig. Derfor er vores softwareløsning OceanStor DJ designet, som kan administrere forskellige datalagringssystemer ensartet og tilbyde tjenester uden at være bundet til en specifik lager model.
De samme og AI
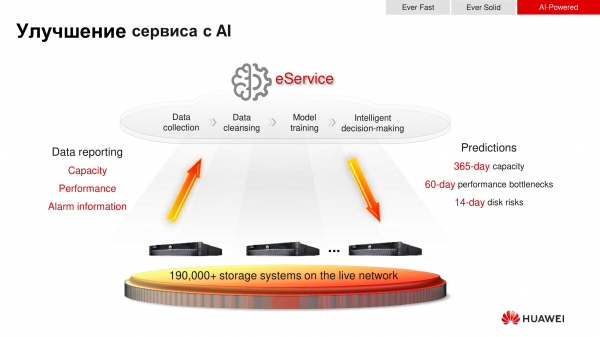
Som nævnt er der i OceanStor Dorado 18000 V6 indbyggede processorer med kunstig intelligens-algoritmer - Ascend. De bruges til at forudsige fejl og til at danne anbefalinger til konfiguration, hvilket også øger ydeevnen og pålideligheden af lagringen.
Forudsigelseshorizonten er to måneder: AI-maskineriet vurderer, hvad der med høj sandsynlighed vil ske i denne tidsramme, om det er tid til at foretage udvidelser, ændre adgangspolitikker osv. Anbefalinger gives på forhånd, hvilket muliggør tidlig planlægning af systemvedligeholdelsesvinduer.
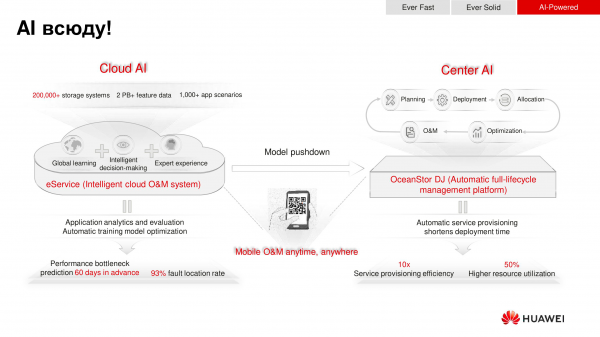
Næste trin i udviklingen af AI fra Huawei indebærer at bringe det til globalt niveau. Under servicevedligeholdelse - håndtering af fejl eller anbefalinger - aggregerer Huawei oplysninger fra logningssystemer fra alle vores kunders lagre. Baseret på de indsamlede oplysninger gennemføres en analyse af opståede eller potentielt mulige fejl, og globale anbefalinger gives - ikke baseret på funktionen af et enkelt SAN eller endda et dusin, men på, hvad der sker og er sket med tusinder af sådanne enheder. Datasetet er enormt, og med støtte fra det begynder AI-algoritmerne at lære ekstremt hurtigt, hvilket øger nøjagtigheden af forudsigelserne betydeligt.
Kompatibilitet
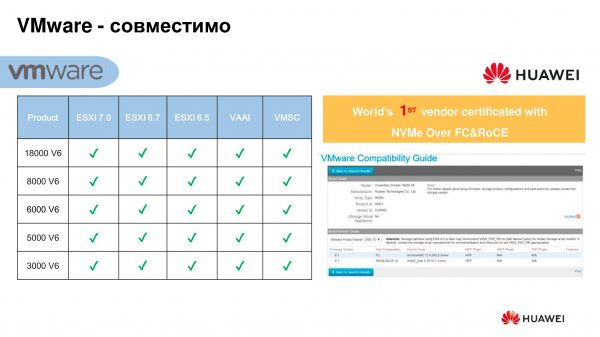
I 2019–2020 var der mange insinuationer om vores udstyrs interaktion med VMware-produkter. For at stoppe dette en gang for alle erklærer vi ansvarligt: VMware er partner med Huawei. Alle tænkelige kompatibilitetstest med vores hardware og deres software er blevet udført, og i dag er vores produktionslagre uden forbehold angivet på VMware's hjemmeside i hardware kompatibilitetslisten. Med andre ord, Huawei-lagringsløsninger, inklusive Dorado V6, kan bruges med VMware-software med fuld support.
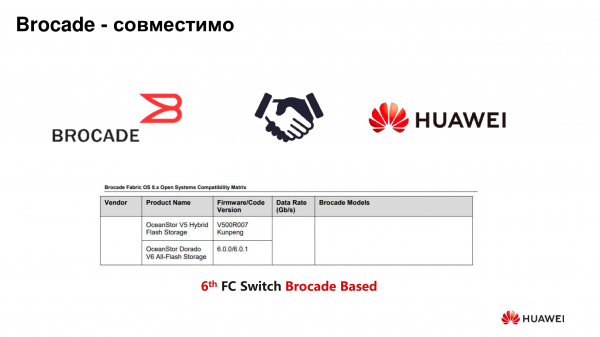
Det samme gælder for vores samarbejde med Brocade. Vi fortsætter med at interagere og gennemføre kompatibilitetstest af vores produkter — og baseret på deres resultater kan vi med fuld tillid påstå, at vores datalagringssystemer er fuldt kompatible med de nyeste FC-switche fra Brocade.
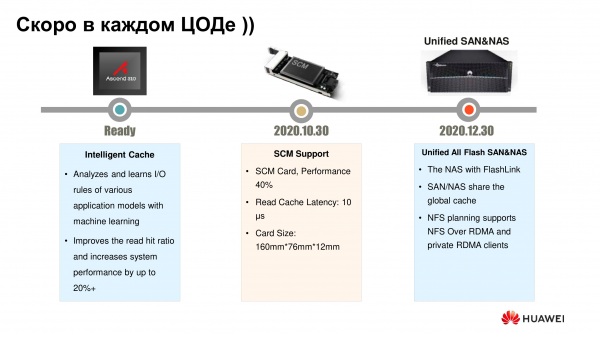
Hvad nu?
Vi fortsætter med at udvikle og forbedre vores processorer: de bliver hurtigere, mere pålidelige, og deres ydeevne stiger. Vi forbedrer også vores AI-chips — baseret på dem udgives moduler, der accelererer deduplisering og kompresion. De, der har adgang til vores konfigureringsværktøj, har måske bemærket, at disse kort allerede er tilgængelige til bestilling i Dorado V6-modellerne.
Vi bevæger os også i retning af yderligere caching på Storage Class Memory — ikke-flygtig hukommelse med ekstremt lave latenstider, omkring ti mikrosekunder til læsning. Desuden giver SCM en performanceforøgelse, især ved arbejde med big data og ved løsning af OLTP-opgaver. Efter den kommende opdatering bør SCM-kort være tilgængelige for bestilling.
Og selvfølgelig vil funktionaliteten til filadgang blive udvidet på hele Huawei-lagerproduktlinjen — hold øje med vores opdateringer.
Kilde: habr.com
