

De to modetrends, der er forbundet med Data Science, forvirrer mange mennesker. Data Mining misforstås ofte som dataudvinding og -indhentning, men i virkeligheden er det meget mere komplekst. I dette indlæg lad os klarlægge begreberne og finde ud af forskellen mellem Data Mining og Data Extraction.
Hvad er Data Mining?
Data mining, også kaldet Knowledge Discovery in Databases (KDD), er en metode, der ofte bruges til at analysere store datamængder ved hjælp af statistiske og matematiske metoder for at finde skjulte mønstre eller tendenser og udvinde værdi fra dem.
Hvad kan man gøre med Data Mining?
Ved at automatisere processen, kan gennemgå databaser og effektivt identificere skjulte mønstre. For virksomheder bruges data mining ofte til at tydeliggøre mønstre og sammenhænge i data, som hjælper med at træffe optimale forretningsbeslutninger.
Eksempler på anvendelse
Efter at data mining i 1990'erne blev populært, begyndte virksomheder i en bred vifte af brancher, herunder detailhandel, finans, sundhed, transport, telekommunikation, e-handel osv., at anvende data mining-metoder til at opnå indsigt baseret på data. Data mining kan hjælpe med at segmentere kunder, opdage svindel, forudsige salg og meget mere.
- Segmentering af kunder
Ved at analysere data om kunder og identificere træk ved målgrupper, kan virksomheder gruppere dem og tilbyde specialtilbud, der imødekommer deres behov. - Markedskurv-analyse
Denne metode er baseret på teorien om, at hvis du køber en bestemt gruppe varer, er du sandsynligvis også interesseret i at købe en anden gruppe varer. Et kendt eksempel er: når fædre køber bleer til deres babyer, køber de typisk også øl sammen med bleerne. - Salgsprognose
Det kan minde om markedskurv-analysen, men denne gang bruges dataanalyse til at forudsige, hvornår en kunde igen vil købe et produkt i fremtiden. For eksempel køber en træner en dåse protein, der skal række i 9 måneder. Butikken, der sælger dette protein, planlægger at lancere et nyt om 9 måneder, så træneren vil købe det igen. - Opdagelse af svindel
Data mining hjælper med at opbygge modeller til opdage svindel. Ved at samle prøver af svigagtige og ægte rapporter får virksomheder mulighed for at bestemme, hvilke operationer der er mistænkelige. - Opdagelse af mønstre i produktionen
I fremstillingsindustrien bruges data mining til at hjælpe med design af systemer ved at identificere sammenhængen mellem produktarkitektur, profil og kundernes behov. Data mining kan også forudsige tidsrammer for produktudvikling og omkostninger.
Og det er kun nogle få anvendelsesscenarier for data mining.
Faserne i Data Mining
Data mining er en helhedsproces, der omfatter indsamling, udvælgelse, rengøring, transformation og ekstraktion af data for at evaluere mønstre og i sidste ende trække værdi.
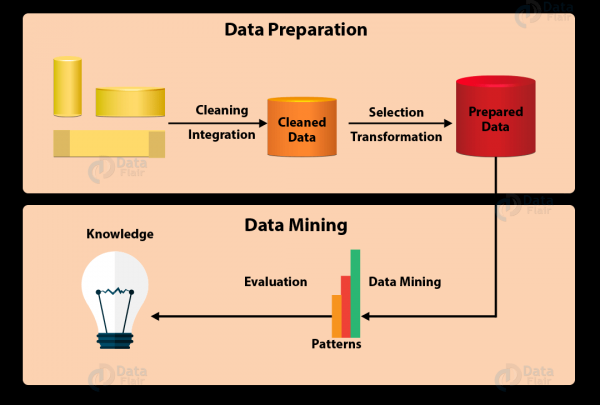
Generelt kan hele data mining-processen sammenfattes i 7 faser:
- Data rengøring
I den virkelige verden er data ikke altid renset og struktureret. De er ofte støjende, ufuldstændige og kan indeholde fejl. For at sikre, at resultatet af data mining er præcist, er det først nødvendigt at rense dataene. Nogle metoder til rengøring inkluderer udfyldning af manglende værdier, automatisk og manuel kontrol osv. - Data integration
Dette er den fase, hvor data fra forskellige kilder udvindes, kombineres og integreres. Kilderne kan være databaser, tekstfiler, regneark, dokumenter, multidimensionale datamængder, internettet og så videre. - Data udvælgelse
Normalt er ikke alle integrerede data nødvendige i data mining. Data udvælgelse er den fase, hvor kun nyttige data vælges og udvindes fra en stor database. - Data transformation
Efter dataudvælgelse transformeres de til former, der er egnede til minedrift. Denne proces omfatter normalisering, aggregering, generalisering osv. - Intelligent dataanalyse
Her kommer den vigtigste del af data mining — brugen af intellektuelle metoder til at finde mønstre i dem. Processen inkluderer regression, klassifikation, forudsigelse, klyngedannelse, associationsstudier og meget mere. - Modelvurdering
Denne fase har til formål at identificere potentielt nyttige, letforståelige mønstre samt mønstre, der bekræfter hypoteser. - Præsentation af viden
I den afsluttende fase præsenteres de indsamlede oplysninger i et tiltalende format ved hjælp af metoder til vidensrepræsentation og visualisering.
Ulemper ved Data Mining
- Store investeringer af tid og arbejde
Da dataudvinding er en langvarig og kompleks proces, kræver den betydelig arbejde fra produktive og kvalificerede personer. Specialister inden for dataanalyse kan drage fordel af kraftfulde dataudvindingsværktøjer, men de har også brug for fagfolk til at forberede dataene og forstå resultaterne. Som følge heraf kan det tage noget tid at behandle al information. - Privatliv og datasikkerhed
Da data mining indsamler oplysninger om kunder ved hjælp af markedsmetoder, kan det krænke brugernes fortrolighed. Desuden kan hackere få adgang til data, der opbevares i dataudvindingssystemer. Dette udgør en trussel mod kundernes datasikkerhed. Hvis stjålne data misbruges, kan det nemt skade andre.
Ovenstående er en kort introduktion til data mining. Som nævnt indeholder data mining processen med indsamling og integration af data, som inkluderer dataudvindingsprocessen. I dette tilfælde kan man med sikkerhed sige, at dataudvinding kan være en del af den langvarige data mining-proces.
Hvad er Data Extraction?
Også kendt som "web data extraction" og "web scraping", er denne proces en handling af at udvinde data fra (normalt uhævde eller dårligt strukturerede) datakilder til centraliserede steder og samle dem på ét sted til opbevaring eller videre behandling. Især inkluderer ikke-strukturerede datakilder websteder, e-mails, dokumenter, PDF-filer, scannet tekst, mainframe-rapporter, båndfiler, annoncer mv. Centraliserede lagre kan være lokale, cloud-baserede eller hybride. Det er vigtigt at huske, at dataudvinding ikke inkluderer behandling eller anden analyse, som kan finde sted senere.
Hvad kan man gøre med Data Extraction?
Overordnet set opdeles formålene med dataudvinding i 3 kategorier.
- Arkivering
Data extraction kan konvertere data fra fysiske formater: bøger, aviser, fakturaer til digitale formater, såsom databaser til opbevaring eller backup. - Ændring af dataformat
Når du vil overføre data fra din nuværende hjemmeside til en ny, der er under udvikling, kan du indsamle data fra din egen side ved at udtrække dem. - Dataanalyse
Det er almindeligt at udføre en ekstra analyse af de udtrukne data for at få indsigt i dem. Dette kan virke som dataanalyse i data mining, men husk, at dataanalyse er målet for udtrækningen, men ikke en del af den. Desuden analyseres dataene anderledes. Et eksempel: ejere af onlinebutikker udtrækker produktinformation fra e-handelswebsteder som Amazon for at overvåge konkurrenternes strategier i realtid. Ligesom data mining er data extraction en automatiseret proces, som har mange fordele. Tidligere kopierede og indsatte folk data manuelt fra et sted til et andet, hvilket tog meget tid. Data extraction fremskynder indsamlingen og forbedrer betydeligt nøjagtigheden af de udtrukne data.
Nogle eksempler på anvendelse af Data Extraction
Ligesom data mining anvendes data extraction bredt i forskellige brancher. Foruden priskontrol i e-handel kan data extraction hjælpe med egen forskning, nyhedsaggregation, marketing, i ejendom, rejser og turisme, i rådgivning, finans og meget mere.
- Leadgenerering
Virksomheder kan udtrække data fra kataloger: Yelp, Crunchbase, Yellowpages og generere leads til forretningsudvikling. Du kan se videoen nedenfor for at lære, hvordan du udtrækker data fra Yellowpages ved hjælp af . - Indholds- og nyhedsaggregation
Indholdsaggregator-websteder kan modtage regelmæssige datastrømme fra flere kilder og holde deres sider opdaterede. - Sentimentanalyse
Efter at have udtrukket anmeldelser, kommentarer og feedback fra sociale medier som Instagram og Twitter, kan specialister analysere de underliggende holdninger og få indsigt i, hvordan brandet, produktet eller et fænomen opfattes.
Trin i Data Extraction
Dataextraktion er det første trin i ETL (extract, transform, load: udvinding, transformation, indlæsning) og ELT (udvinding, indlæsning og transformation). ETL og ELT er i sig selv en del af en komplet dataintegrationsstrategi. Med andre ord kan dataudvinding være en del af deres udvinding.
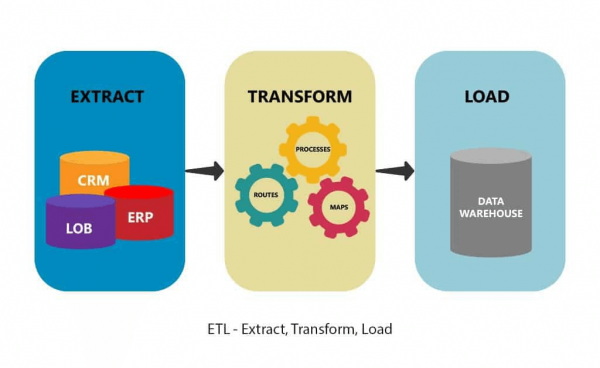
Udvinding, transformation, indlæsning
Mens data mining er processen med at hente information fra store datamængder, er dataudvinding en meget kortere og enklere proces. Den kan reduceres til tre trin:
- Vælg datakilde
Vælg kilden, som du ønsker at hente data fra, for eksempel en hjemmeside. - Dataindsamling
Send en "GET"-anmodning til websitet og analyser det modtagne HTML-dokument ved hjælp af programmeringssprog som Python, PHP, R, Ruby mv. - Dataopbevaring
Gem dataene i din lokale database eller i en cloud-lagring til fremtidig brug. Hvis du er en erfaren programmør, der ønsker at udvinde data, kan de ovennævnte trin virke enkle. Men hvis du ikke programmerer, er der en genvej - at bruge dataudvindingsværktøjer såsom . Dataudvindingsværktøjer, ligesom data mining-værktøjer, er designet til at spare kraft og gøre databehandling enkel for alle. Disse værktøjer er ikke kun omkostningseffektive, men også brugervenlige for begyndere. De gør det muligt for brugere at samle data på få minutter, gemme dem i skyen og eksportere dem i mange formater: Excel, CSV, HTML, JSON eller til databaser på hjemmesiden via API.
Ulemper ved dataudvinding
- Serverfejl
Når data udvindes i stor skala, kan webserveren på den målrettede hjemmeside blive overbelastet, hvilket kan resultere i servernedbrud. Dette vil skade ejerens interesser. - IP-banning
Når en person henter data for ofte, kan hjemmesider blokere hans IP-adresse. Ressourcen kan fuldstændigt forbyde IP-adressen eller begrænse adgangen, hvilket gør dataene ufuldstændige. For at udvinde data og undgå blokering, skal dette gøres med moderat hastighed og anvende nogle af anti-blokeringsmetoderne. - Juridiske problemer
Data extraction fra webben ligger i en grå zone, når det kommer til lovlighed. Store websteder som LinkedIn og Facebook angiver klart i deres brugsvilkår, at enhver automatisk dataudvinding er forbudt. Der har været mange retssager mellem virksomheder på grund af botaktivitet.
Nøgleforskelle mellem Data Mining og Data Extraction
- Data mining kaldes også vidensopdagelse i databaser, vidensudvinding, data/pattern analyse, information indsamling. Data extraction bruges ombytteligt med web data udvinding, web scraping, dataindsamling osv.
- Forskning i data mining er hovedsageligt baseret på strukturerede data, mens data extraction typisk henter data fra ustrukturerede eller dårligt strukturerede kilder.
- Målet med data mining er at gøre data mere nyttige til analyse. Data extraction er indsamling af data et sted, hvor de kan gemmes eller behandles.
- Analysen i data mining er baseret på matematiske metoder til at identificere mønstre eller tendenser. Data extraction er baseret på programmeringssprog eller dataudvindingsværktøjer til at navigere i kilder.
- Målet med data mining er at finde fakta, der tidligere var ukendte eller ignorante, mens data extraction håndterer eksisterende information.
- Data mining er mere komplekst og kræver større investeringer i medarbejderuddannelse. Data extraction kan være ekstremt enkelt og omkostningseffektivt ved brug af det rette værktøj.
Vi hjælper begyndere med at undgå forvirring om Data. Specielt for Habr-læsere har vi lavet en rabatkode HABR, som giver yderligere 10% rabat på den rabat, der er angivet på banneret.
Flere kurser
Anbefalede artikler
Kilde: habr.com
