

Hvordan forstår en backend-udvikler, at en SQL-forespørgsel vil fungere godt på 'prod'? I store eller hurtigt voksende virksomheder har ikke alle adgang til 'prod'. Og selv med adgang kan ikke alle forespørgsler kontrolleres uden problemer, og at oprette en kopi af databasen tager ofte timer. For at løse disse problemer har vi skabt en kunstig DBA – Joe. Han er allerede succesfuldt implementeret i flere virksomheder og hjælper ikke blot en håndfuld udviklere.
Video:
Hej alle! Jeg hedder Anatoliy Stansler. Jeg arbejder i virksomheden . Vi arbejder med at fremskynde udviklingsprocessen ved at fjerne forsinkelser forbundet med arbejdet med Postgres, for udviklere, DBAer og QA.
Vi har fantastiske kunder, og i dag vil en del af præsentationen handle om casestudier, vi har mødt i arbejdet med dem. Jeg vil fortælle, hvordan vi har hjulpet dem med at løse ret alvorlige problemer.
Når vi udfører udvikling og laver komplekse belastede migrationer, stiller vi os selv spørgsmålet: 'Vil denne migration gå igennem?'. Vi bruger review, vi trækker på viden fra mere erfarne kolleger, DBA-eksperter. Og de kan sige – ja, det vil fungere eller nej, det vil ikke fungere.
Men måske ville det være bedre, hvis vi selv kunne teste dette på fulde kopier. Og i dag vil vi netop tale om, hvilke tilgange der findes til testning, hvordan man gør det bedst muligt, og hvilke værktøjer der kan anvendes. Vi vil også diskutere fordele og ulemper ved disse tilgange, samt hvad vi kan forbedre.
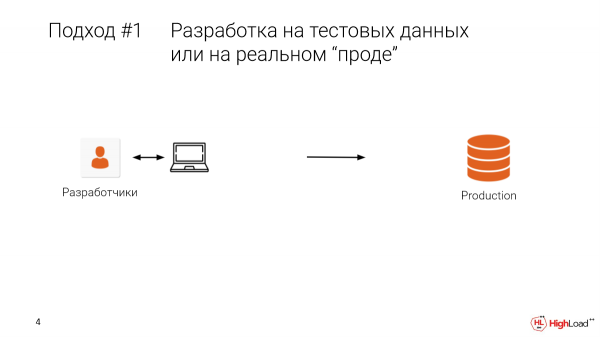
Hvem har nogensinde direkte lavet indekser eller foretaget ændringer på prod? Ret mange. Og hos hvem har det ført til datatab eller nedetid? Så kender du denne smerte. Heldigvis findes der backups.
Den første tilgang – er testning i prod. Eller når en udvikler sidder med sin lokale maskine, har testdata, og der er et begrænset udvalg. Og vi ruller det ud på prod, og vi får sådan en situation.
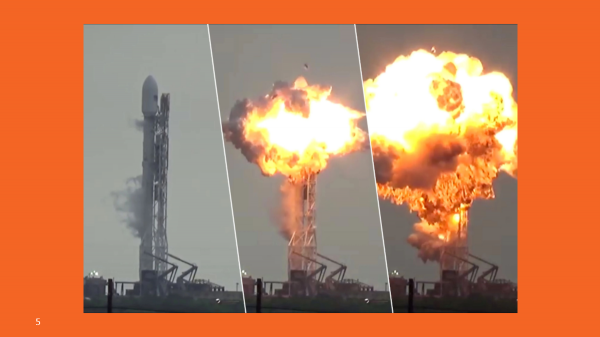
Det er smertefuldt, det er dyrt. Det er nok bedre ikke at gøre sådan.
Hvordan kan vi så gøre det bedre?
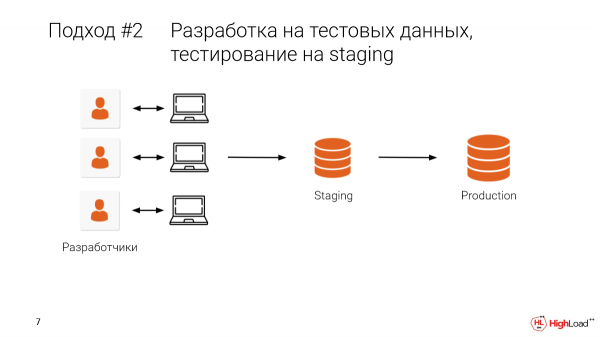
Lad os tage staging og tildele en del af prod der. Eller i bedste fald tage rigtig prod, alle data. Og efter at have udviklet lokalt, vil vi også kontrollere på staging.
Det vil gøre det muligt for os at fjerne nogen fejl, dvs. undgå at de kommer på prod.
Hvilke problemer findes der?
- Problemet er, at vi deler denne staging med kollegaer. Og det sker meget ofte, at du laver en ændring, bam – og der er ingen data, arbejdet er spildt. Stagingen var mange terabyte. Og det tager lang tid at få den op igen. Og vi beslutter at arbejde videre med det i morgen. Det er slut, vores udvikling er stoppet.
- Og selvfølgelig arbejder der mange kollegaer der, mange teams. Og det skal koordineres manuelt. Og det er ubehageligt.
Og det skal siges, at vi kun har ét forsøg, ét skud, hvis vi vil lave nogen ændringer i databasen, røre ved dataene, ændre strukturen. Og hvis noget går galt, hvis der var en fejl i migrationen, så kan vi ikke hurtigt tilbage.
Det er bedre end den tidligere tilgang, men der er stadig stor sandsynlighed for, at en eller anden fejl går videre til produktionen.
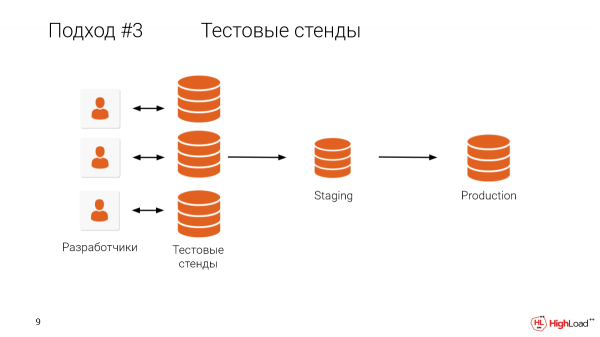
Hvad forhindrer os i at give hver udvikler en teststand, en fuld størrelse kopi? Jeg tror, det er tydeligt, hvad der forhindrer.
Hvem har en database større end en terabyte? Mere end halvdelen af salen.
Og det er klart, at det koster meget at holde maskiner til hver udvikler, når produktionsmiljøet er så stort, og det tager også tid.
Vi har kunder, der har forstået, at det er meget vigtigt at teste alle ændringer på fulde kopier, men de har en database, der er mindre end en terabyte, og ressourcer til at holde en teststand for hver udvikler finnes ikke. Derfor må de downloade dumps til deres lokale maskine og teste på den måde. Det tager en masse tid.
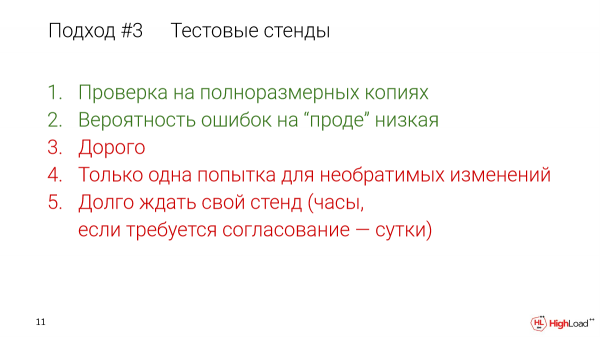
Selv hvis du gør det inden for infrastrukturen, så er det allerede rigtig godt at downloade én terabyte data på en time. Men de bruger logiske dumps, de downloader lokalt fra cloud. For dem er hastigheden omkring 200 gigabyte i timen. Og det tager også tid at gendanne fra den logiske dump, anvende indekser osv.
Men de bruger denne tilgang, fordi det gør det muligt at holde produktionen pålidelig.
Hvad kan vi gøre her? Lad os gøre det sådan, at teststandene er billige, og vi giver hver udvikler sin egen teststand.
Og det er muligt.
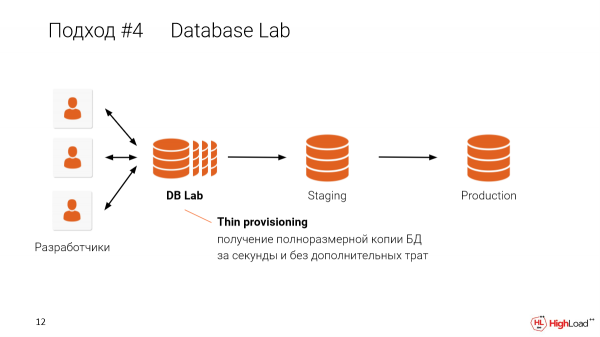
Og i denne tilgang, når vi laver tynde kloner for hver udvikler, kan vi dele dette på én maskine. For eksempel, hvis du har en fire-terabyte database og ønsker at give den til 10 udviklere, behøver du ikke at have 10 x fire-terabyte databaser. Du har kun brug for én maskine til at lave tynde isolerede kopier for hver udvikler ved hjælp af én maskine. Hvordan det fungerer, vil jeg fortælle lidt senere.
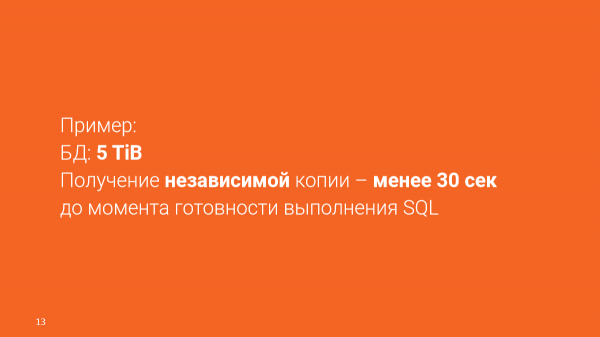
Et reelt eksempel:
DB – 4,5 terabyte.
Vi kan få uafhængige kopier på 30 sekunder.
Du behøver ikke at vente på et testmiljø og være afhængig af, hvor stort det er. Du kan få det på sekunder. Det vil være helt isolerede miljøer, men som deler data imellem sig.
Det er fantastisk. Her taler vi om magi og parallelle universer.
I vores tilfælde fungerer det med systemet OpenZFS.
OpenZFS er et copy-on-write filsystem, der fra starten understøtter snapshots og kloner. Det er pålideligt og skalerbart. Det er meget nemt at administrere. Det kan bogstaveligt talt deployes med to kommandoer.
Der er andre muligheder:
LVM,
SAN (for eksempel, Pure Storage).
Database Lab, som jeg taler om, er modulært. Det kan implementeres ved hjælp af sådanne muligheder. Men indtil videre har vi fokuseret på OpenZFS, fordi der konkret har været problemer med LVM.
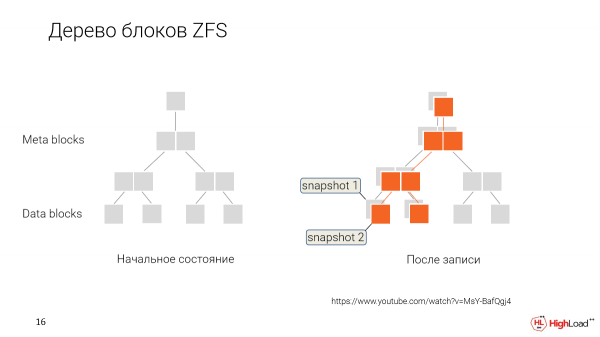
Hvordan fungerer det? I stedet for at overskrive data hver gang vi ændrer dem, gemmer vi dem, blot ved at markere, at disse nye data tilhører et nyt tidspunkt, et nyt snapshot.
Og senere, når vi ønsker at rulle tilbage, eller vi ønsker at lave en ny klon fra en ældre version, siger vi simpelthen: "Okay, giv os de data blokke, der er markeret på denne måde."
Og denne bruger vil arbejde med dette datasæt. Han vil gradvist ændre dem og lave sine snapshots.
Og vi får forgreninger. Hver udvikler vil have mulighed for at have sin egen klon, som han redigerer, mens de data, der er fælles, vil blive delt mellem alle.
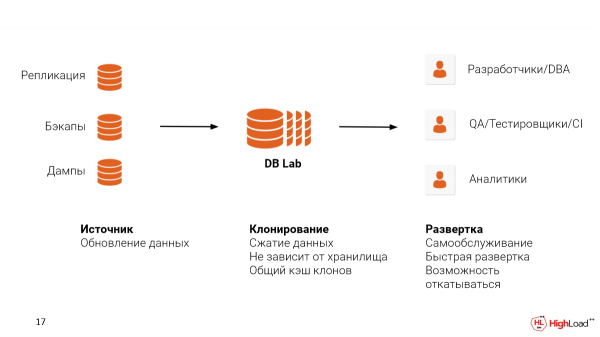
For at implementere et sådant system, skal du løse to problemer:
Det første er datakilden, hvorfra du vil hente dem. Du kan indstille replikation fra produktionen. Du kan bruge de backups, som du har konfigureret, det håber jeg. WAL-E, WAL-G eller Barman. Og selv hvis du bruger en cloud-løsning som RDS eller Cloud SQL, kan du bruge logiske dumps. Men vi anbefaler stadig at bruge backups, fordi med denne tilgang kan du også bevare den fysiske filstruktur, hvilket giver dig mulighed for at være endnu tættere på de metrikker, du ville se i produktionen, for at fange de problemer, der er.
Det andet er stedet, hvor du ønsker at hoste Database Lab. Dette kan være i skyen eller on-premise. Her er det vigtigt at nævne, at ZFS understøtter datakomprimering. Og det gør det ganske godt.
Forestil dig, at hver sådan klon, afhængigt af de operationer, vi udfører med databasen, vil have en vis dev-vækst. Denne dev vil også kræve plads. Men fordi vi har taget en database på 4,5 terabyte, komprimerer ZFS den til 3,5 terabyte. Afhængigt af indstillingerne kan dette varieres. Og vi får også plads til dev.
Sådan et system kan bruges til forskellige sager.
Det er udviklere, DBA'er til at teste forespørgsler og til optimering.
Det kan bruges i QA-testning til at kontrollere en specifik migration, før vi ruller det ud i produktionen. Og vi kan også oprette specielle miljøer til QA med rigtige data, hvor de kan teste nye funktioner. Og det vil tage sekunder i stedet for at vente timer eller måske endda dage i andre tilfælde, hvor tynde kopier ikke bruges.
Og endnu en separat sag. Hvis virksomheden ikke har et analytisk system oprettet, kan vi lave en tynd klon af produktbasen og give den til lange forespørgsler eller til specifikke indekser, der kan bruges i analysen.
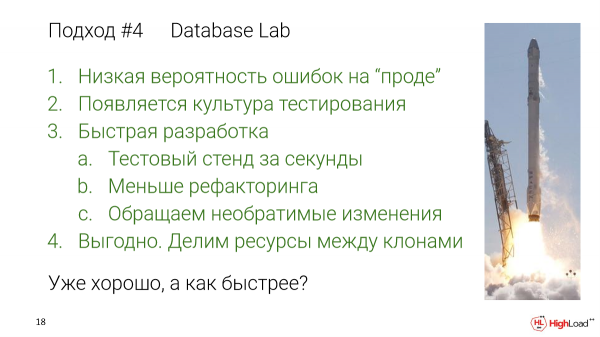
Med denne tilgang:
Der er lav sandsynlighed for fejl i produktionen, fordi vi har testet alle ændringer på fuldstørrelsesdata.
Vi får en testkultur, da man ikke længere skal vente i timevis på sin egen stand.
Og der er ingen barrierer, ingen ventetid mellem testene. Du kan virkelig gå og tjekke. Og det vil være bedre, da vi fremskynder udviklingen.
Der vil være mindre refaktorering. Færre fejl vil finde vej til produktionen. Vi vil refaktorere dem mindre senere.
Vi kan lave irreversible ændringer. Dette findes ikke i standardmetoder.
- Det er fordelagtigt, fordi vi deler ressourcerne fra testmiljøerne.
Det er allerede godt, men hvad mere kan vi accelerere?
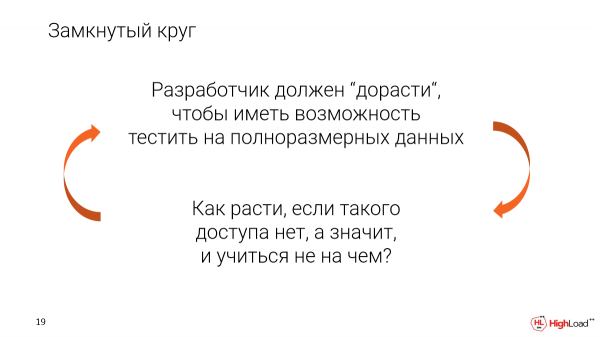
Takket være et sådant system kan vi markant sænke tærsklen for at komme ind i denne form for testning.
Der er i øjeblikket en ond cirkel, hvor udvikleren skal blive ekspert for at få adgang til virkelige, fuldskala data. De skal have tillid til akses til disse data.
Men hvordan skal man vokse, hvis der ikke er adgang? Hvad nu hvis du kun har adgang til en meget lille mængde testdata? Så vil det ikke være muligt at få reel erfaring.
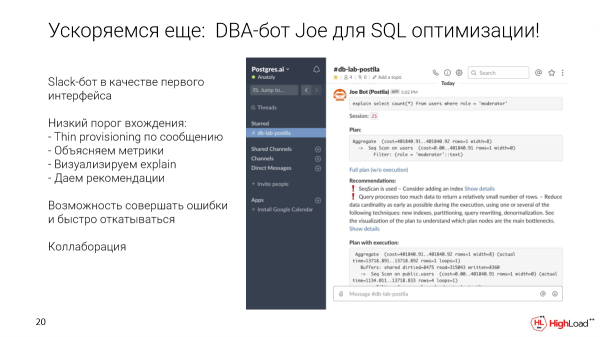
Hvordan kan vi komme ud af denne cirkel? Som et første interface, der er bekvemt for udviklere på alle niveauer, har vi valgt en Slack-bot. Men det kan være enhver anden interface.
Hvad tillader det? Du kan tage en specifik forespørgsel og sende den til et særligt kanal for databasen. Vi vil automatisk implementere en tynd klon på sekunder. Vi kører denne forespørgsel. Samler metrics og anbefalinger. Viser visualisering. Og derefter vil denne klon forblive til at optimere forespørgslen, tilføje indekser osv.
Og Slack giver os også muligheder for samarbejde fra starten. Da det blot er et kanal, kan du direkte i tråden diskutere denne forespørgsel, pinge dine kolleger og DBA’er, der er i virksomheden.
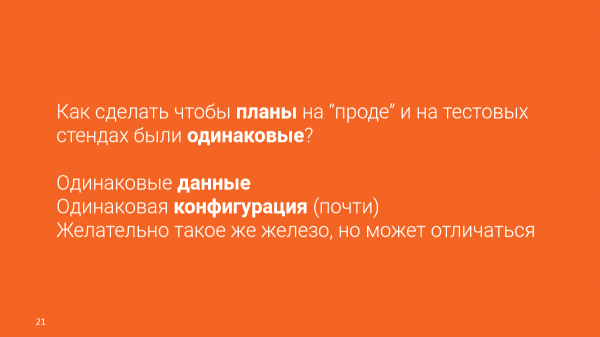
Men der er selvfølgelig også problemer. Da det er den virkelige verden, og vi bruger en server, hvor mange kloner hostes, er vi nødt til at begrænse mængden af hukommelse og processorressourcer, som klonerne har adgang til.
Men for at disse tests skal være troværdige, er vi nødt til at løse dette problem på en eller anden måde.
Det er tydeligt, at en vigtig faktor er ensartede data. Men det har vi allerede. Og vi ønsker at opnå en ensartet konfiguration. Og vi kan tilbyde en praktisk talt ensartet konfiguration.
Det ville være fantastisk at have det samme hardware som i produktionen, men det kan afvige.
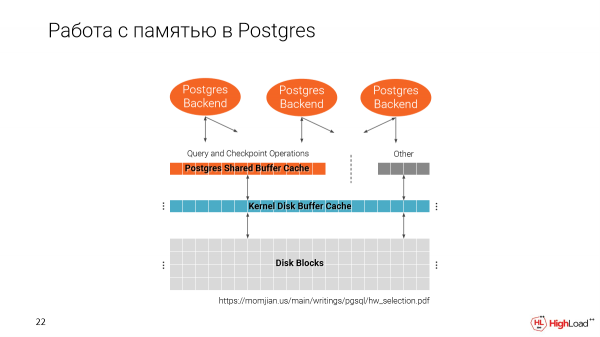
Lad os huske, hvordan Postgres arbejder med hukommelse. Vi har to caches. En fra filsystemet og en fra Selve Postgres, det vil sige Shared Buffer Cache.
Det er vigtigt at bemærke, at Shared Buffer Cache allokeres ved opstart af Postgres afhængigt af hvilken størrelse, du angiver i konfigurationen.
Og den anden cache bruger al tilgængelig plads.
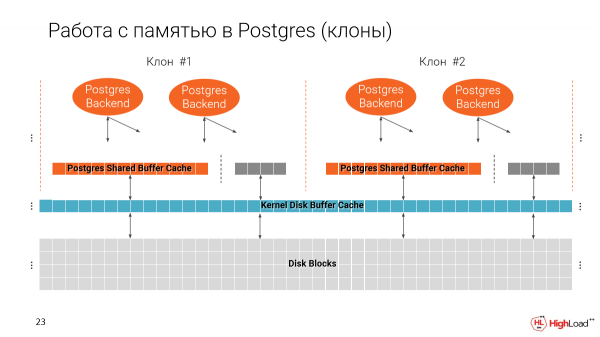
Når vi laver flere kloner på én maskine, fylder vi gradvist hukommelsen op. Rent faktisk bør Shared Buffer Cache være 25 % af den samlede mængde hukommelse, der er tilgængelig på maskinen.
Så hvis vi ikke ændrer denne parameter, kan vi kun køre 4 instanser på én maskine, dvs. kun 4 af sådanne tynde kloner. Og det er selvfølgelig dårligt, fordi vi ønsker at have mange flere.
Men på den anden side bruges Buffer Cache til at udføre forespørgsler, til indekser, dvs. planen afhænger af størrelsen på vores caches. Hvis vi bare reducerer denne parameter uden videre, kan vores planer ændre sig betydeligt.
For eksempel, hvis vi har en stor cache på prod, vil Postgres foretrække at bruge indeks. Hvis ikke, så vil det være SeqScan. Hvad ville så være meningen, hvis vores planer ikke stemte overens?
Men her når vi til den konklusion, at planen i Postgres faktisk ikke afhænger af den specifikke størrelse, der er angivet i Shared Buffer, men derimod af effective_cache_size.
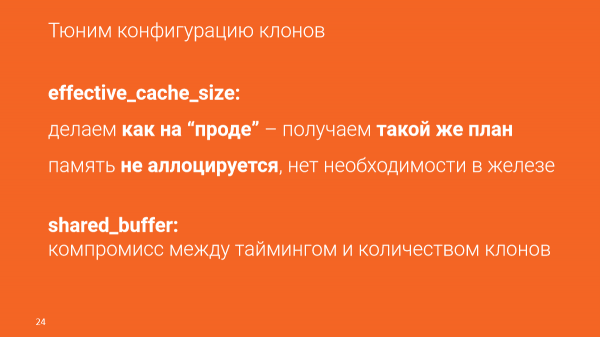
Effective_cache_size er den forventede mængde cache, som vi har til rådighed, dvs. summen af Buffer Cache og cache fra filsystemet. Dette angives i konfigurationen. Og denne hukommelse allokeres ikke.
Med denne parameter kan vi på en måde narre Postgres ved at sige, at vi faktisk har adgang til mange data, selvom vi ikke har disse data. På denne måde vil planerne være helt i overensstemmelse med produktionen.
Men det kan påvirke timingen. Vi optimerer forespørgsler efter timing, men det er vigtigt, at timingen afhænger af mange faktorer:
Den afhænger af den nuværende belastning på prod.
Den afhænger af maskinens specifikationer.
Og dette er en indirekte parameter, men vi kan faktisk optimere præcist efter mængden af data, som denne forespørgsel skal læse for at få resultatet.
Og hvis vi ønsker, at timingen skal være tæt på det, vi vil se i prod, så skal vi tage noget så lignende hardware som muligt, og måske endda mere, så alle klonerne kan passe ind. Men det er et kompromis, dvs. du får de samme planer, du vil se, hvor mange data en specifik forespørgsel læser, og du kan konkludere – denne forespørgsel er god (eller migration) eller dårlig, den skal optimeres yderligere.
Lad os se nærmere på, hvordan optimeringen foregår med Joe.
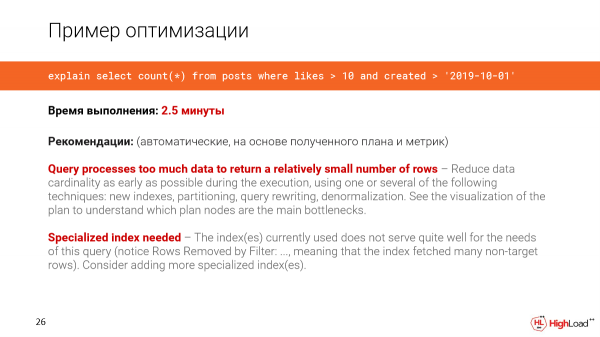
Lad os tage en forespørgsel fra et rigtigt system. I dette tilfælde er databasen 1 terabyte. Og vi ønsker at tælle antallet af friske indlæg, der har fået mere end 10 likes.
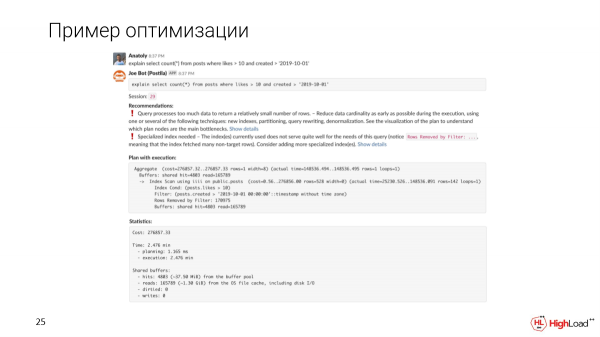
Vi skriver en besked i kanalen, og en klon er blevet startet op for os. Og vi vil se, at en sådan forespørgsel vil køre på 2,5 minutter. Det er det første, vi bemærker.
B Joe vil vise automatiske anbefalinger baseret på planen og metrics.
Vi vil se, at forespørgslen behandler for mange data for at få et relativt lille antal rækker. Og der er brug for en specialiseret indeks, da vi har bemærket, at forespørgslen har for mange filtrerede rækker.
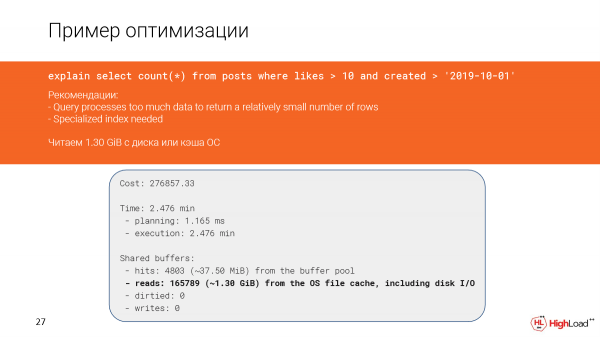
Lad os se nærmere på, hvad der skete. Faktisk ser vi, at vi har læst næsten en og en halv gigabyte data fra filcachet eller endda fra disken. Og det er ikke godt, da vi kun fik 142 rækker.
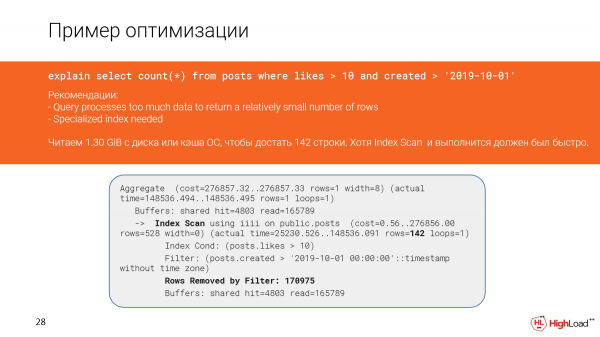
Og tilsyneladende skulle vi have haft en index scan, og det burde have kørt hurtigt, men da vi har filtreret for mange rækker (vi måtte tælle dem), så kørte forespørgslen langsomt.
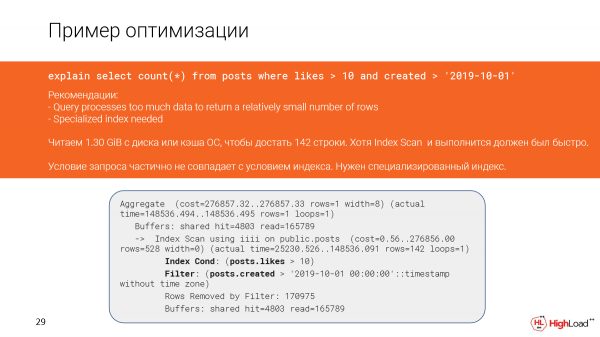
Og dette skete i planen, fordi betingelserne i forespørgslen og betingelserne i indekset delvist ikke stemmer overens.
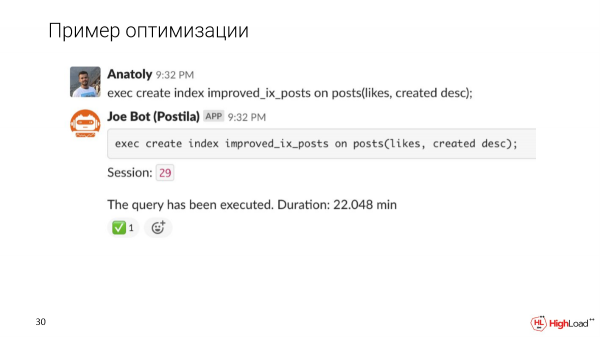
Lad os prøve at gøre indekset mere præcist og se, hvordan udførelsen af forespørgslen ændrer sig efter dette.
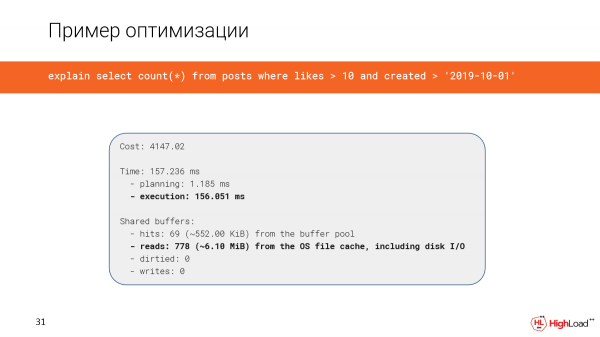
Oprettelsen af indekset tog ret lang tid, men nu kontrollerer vi forespørgslen og ser, at tiden i stedet for 2,5 minutter nu er kun 156 millisekunder, hvilket er ganske godt. Og vi læser kun 6 megabyte data.
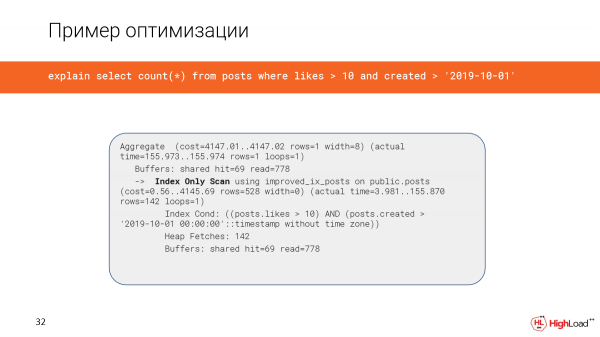
Og nu bruger vi en index only scan.
En anden vigtig ting er, at vi ønsker at præsentere planen på en mere forståelig måde. Vi har implementeret visualisering ved hjælp af Flame Graphs.
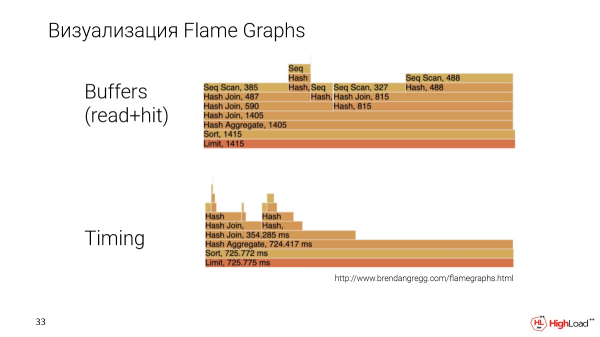
Dette er en anden forespørgsel, mere kompleks. Og vi bygger Flame Graphs baseret på to parametre: mængden af data, som en specifik node i planen læste, og timingen, dvs. node's udførelsestid.
Her kan vi sammenligne noder direkte med hinanden. Det bliver tydeligt, hvilken der optager mere eller mindre plads, hvilket ofte kan være svært at gøre med andre visualiseringsmetoder.
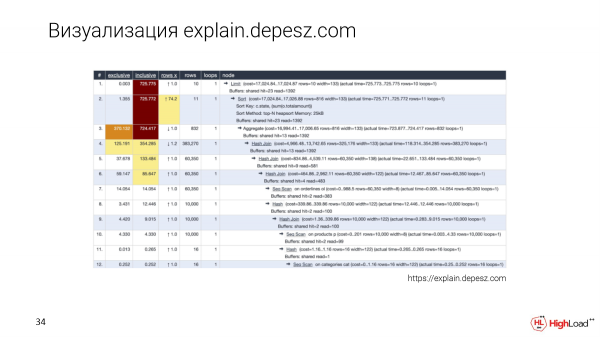
Selvfølgelig kender alle explain.depesz.com. En god funktion ved denne visualisering er, at vi gemmer den tekstuelle plan og også præsenterer nogle nøgleparametre i en tabel, så det bliver muligt at sortere.
Og udviklere, der endnu ikke har dykket ned i dette emne, bruger også explain.depesz.com, fordi det gør det lettere for dem at forstå, hvilke målinger der er vigtige, og hvilke der ikke er.
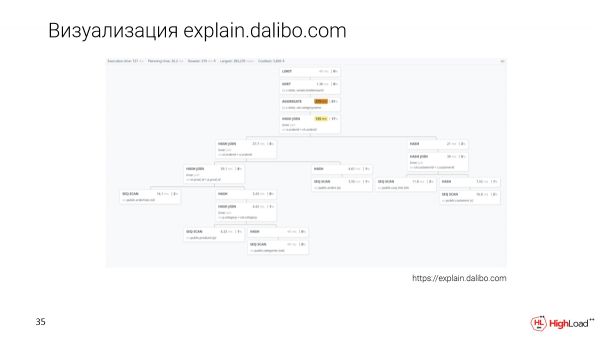
Der er en ny tilgang til visualisering – explain.dalibo.com. De laver en træstrukturvisualisering, men her er det meget svært at sammenligne noderne med hinanden. Her kan man godt forstå strukturen, selvom man, hvis der er en stor forespørgsel, skal scrolle frem og tilbage, men det er også en mulighed.
Samarbejde
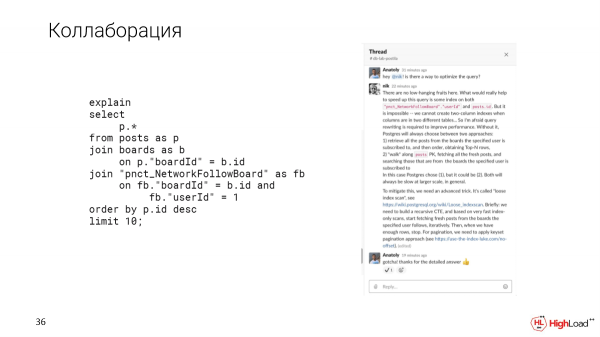
Som jeg allerede har nævnt, giver Slack os mulighed for samarbejde. For eksempel, hvis vi støder på en kompleks forespørgsel, som vi ikke ved, hvordan vi skal optimere, kan vi afklare denne sag i en tråd i Slack med vores kolleger.
Vi mener, det er vigtigt at teste på fuld størrelse data. Derfor har vi lavet værktøjet Update Database Lab, som er tilgængeligt i open source. Du kan også bruge botten Joe. Du kan tage det lige nu og implementere det hos dig selv. Alle guides er tilgængelige der.
Det er også vigtigt at bemærke, at selve løsningen ikke er noget revolutionerende, fordi der er Delphix, men det er en enterprise-løsning. Den er helt lukket, koster meget. Vi specialiserer os specifikt i Postgres. Alle vores produkter er open source. Kom og vær med!
Det var alt fra mig. Tak!
Spørgsmål
Hej! Tak for præsentationen! Meget interessant, især for mig, fordi jeg har arbejdet med en lignende opgave for noget tid siden. Derfor har jeg en række spørgsmål. Jeg håber, at jeg kan stille i det mindste nogle af dem.
Det er interessant, hvordan I beregner plads til dette miljø? Teknologien indebærer, at under visse omstændigheder kan jeres kloner vokse til maksimal størrelse. Kort sagt, hvis I har en ti terabyte database og 10 kloner, kan I nemt simulere en situation, hvor hver klon indeholder 10 unikke data. Hvordan beregner I denne plads, dvs. den forskel, I nævnte, i hvilken disse kloner vil leve?
Godt spørgsmål. Her er det vigtigt at holde øje med de specifikke kloner. Og hvis der sker en for stor ændring i en klon, så begynder den at vokse, kan vi først give brugeren en advarsel om dette, eller straks stoppe den klon, så vi undgår en fejl-situation.
Ja, jeg har et opfølgende spørgsmål. Altså hvordan sikrer I livscyklussen for disse moduler? Vi har det som et problem og en hel anden historie. Hvordan foregår det?
Hver klon har en slags ttl. I princippet har vi en fast ttl.
Hvilken, hvis jeg må spørge?
1 time, altså idle – 1 time. Hvis den ikke bruges, så sletter vi den. Men der er intet overraskende i det, da vi kan genstarte klonen på sekunder. Og hvis den er nødvendig igen, så er det bare at gøre det.
Jeg er også nysgerrig omkring valget af teknologier, fordi vi for eksempel bruger flere metoder parallelt af forskellige grunde. Hvorfor ZFS? Hvorfor brugte I ikke LVM? I nævnte, at der var problemer med LVM. Hvilke problemer var det? Efter min mening er løsningen med SAN den mest optimale, når det gælder ydeevne.
Hvad er det største problem med ZFS? At du skal køre det på én vært, altså at alle instanser vil leve inden for det samme operativsystem. I tilfælde af SAN kan du tilslutte forskellige hardwarekomponenter. Og flaskehalsen er kun de enheder, der er på SAN. Og interessen ligger netop i valget af teknologier. Hvorfor ikke LVM?
Vi kan specifikt diskutere LVM ved meetup. Om SAN – det er simpelthen dyrt. Vi kan implementere ZFS hvor som helst. Du kan implementere det på din egen maskine. Du kan bare downloade depotet og opsætte det. ZFS kan installeres stort set overalt, hvis vi taler om Linux. Det vil sige, at vi får en meget fleksibel løsning. Og selve ZFS giver meget ud af boksen. Du kan indlæse ubegrænsede data, tilslutte et stort antal diske, der er snapshots. Og som jeg allerede har sagt, er det let at administrere. Det virker meget behageligt at bruge. Det er gennemprøvet, det har eksisteret i mange år. Det har et meget stort community, der vokser. ZFS er en meget pålidelig løsning.
Nikolai Samokhvalov: Må jeg kommentere yderligere? Jeg hedder Nikolai, og jeg arbejder sammen med Anatolij. Jeg er enig i, at SAN er fantastisk. Og nogle af vores kunder har Pure Storage osv.
Anatoliy har korrekt bemærket, at vi sigter mod modulopbygning. I fremtiden kan vi realisere et enkelt interface – lav et snapshot, lav en klon, slet klonen. Det er alt sammen nemt. Og lagerrum er fantastisk, hvis det findes.
Men ZFS er tilgængeligt for alle. DelPhix har allerede nok kunder, de har 300 kunder. Af dem er 50 i Fortune 100, dvs. de sigter mod NASA osv. Det er tid til at give denne teknologi til alle. Derfor har vi open source Core. Vi har en del af interfacet, som ikke er open source. Det er en platform, vi vil vise. Men vi ønsker, at det skal være tilgængeligt for enhver. Vi vil lave en revolution, så alle testere stopper med at gætte på laptops. Vi skal kunne skrive SELECT og straks se, at det er langsomt. Det er nok at vente på, at DBA fortæller om det. Det er det, der er hovedmålet. Og jeg tror, at vi alle vil nå dertil. Og vi laver denne ting, så alle kan få den. Derfor ZFS, fordi det vil være tilgængeligt overalt. Tak til fællesskabet for at løse problemer og for den open source licens osv.
Hej! Tak for præsentationen! Jeg hedder Maxim. Vi har arbejdet med de samme problemer. Vi har løst dem internt. Hvordan deler I ressourcerne mellem disse kloner? Hver klon kan i hvert øjeblik håndtere sin egen opgave: den ene tester noget, den anden tester noget andet, en har måske bygning af indeks, mens en anden kører et tungt job. Og hvis CPU'er kan deles, hvordan deler I så IO?
Mit andet spørgsmål handler om uensartede miljøer. Antag at jeg har ZFS her, og alt er fint, men kunden har ikke ZFS i produktion, men ext4 for eksempel. Hvordan håndterer I det?
Rigtig gode spørgsmål. Jeg nævnte lidt problemet med at dele ressourcer. Løsningen er som følger. Forestil dig, at du tester på staging. Der kan også være en situation, hvor én giver en bestemt belastning, mens en anden giver en anden. Og i sidste ende ser du mærkelige målinger. Selv det kan være et problem i produktion. Når du vil kontrollere en bestemt forespørgsel og ser, at der er et problem med den – den kører langsomt – så er problemet ikke nødvendigvis forespørgslen, men at der er en parallel belastning.
Derfor er det vigtigt at fokusere på, hvilken plan vi skal følge, hvilke skridt der vil være i planen, og hvor mange data vi skal indsamle til dette. Det, at vores diske for eksempel vil være belastede af noget, påvirker specifikt timingen. Men vi kan vurdere, hvor belastet denne anmodning er, ud fra mængden af data. Det er ikke så vigtigt, at der samtidig vil være en anden udførelse.
Jeg har to spørgsmål. Det er en virkelig fed ting. Har der været tilfælde, hvor data i produktion er kritisk vigtige, for eksempel kreditkortnumre? Er der allerede noget klart eller er det en separat opgave? Og det andet spørgsmål – er der noget lignende til MySQL?
Med hensyn til data. Vi vil lave obfuskering, indtil vi gør det. Men hvis du specifikt implementerer Joe, og ikke giver udviklerne adgang, er der ingen adgang til data. Hvorfor? Fordi Joe ikke viser data. Han viser kun metrics, planer og alt det. Det blev gjort på den måde, fordi det er et af vores klients krav. De ønskede at have mulighed for at optimere, men ikke give alle adgang.
Angående MySQL. Dette system kan bruges til hvad som helst, der gemmer state på disken. Og da vi arbejder med Postgres, laver vi lige nu først og fremmest fuld automatisering for Postgres. Vi ønsker at automatisere hentningen af data fra backup. Vi konfigurerer Postgres korrekt. Vi ved, hvordan man får planerne til at matche, osv.
Men da systemet er udvideligt, vil det også kunne bruges til MySQL. Der er også sådanne eksempler. En lignende løsning findes hos Yandex, men de offentliggør den ikke noget sted. De bruger den internt i Yandex.Metrica. Og her handler det netop om MySQL. Men teknologierne er de samme, ZFS.
Tak for oplægget! Jeg har også et par spørgsmål. Du nævnte, at kloning kan bruges til analyse, for eksempel til at bygge yderligere indekser. Kan du fortælle lidt mere om, hvordan det fungerer?
Og jeg vil stille det andet spørgsmål om ensartetheden af systemerne, ensartetheden af planerne. Planen afhænger blandt andet af statistikken indsamlet af Postgres. Hvordan løser I dette problem?
Der er ingen analyse af specifikke sager, fordi vi ikke har brugt det sådan endnu, men der er en mulighed for det. Hvis vi taler om indekser, så forestil dig, at der kører en forespørgsel på en tabel med hundrede millioner poster og i en kolonne, som normalt ikke er indekseret i produktionen. Og vi ønsker at beregne nogle data. Hvis denne forespørgsel køres i produktionen, er der en risiko for, at der opstår nedetid, fordi forespørgslen vil tage et minut at udføre.
Okay, lad os lave en tynd klon, som det ikke er skræmmende at stoppe i et par minutter. Og for at gøre det mere bekvemt at beregne analysen, tilføjer vi indekser på de kolonner, hvor vi er interesseret i at få data.
Bliver indekset oprettet hver gang?
Det kan gøres sådan, at vi rører ved dataene, tager snapshots, og derefter gendanner vi fra dette snapshot og kører nye forespørgsler. Det vil sige, vi kan gøre det på en måde, så vi kan oprette nye kloner med allerede oprettede indekser.
Hvad angår spørgsmålet om statistikken, så hvis vi gendanner fra en backup, hvis vi laver replikering, så vil vores statistik være præcis den samme. Fordi vi har den fysiske datastruktur i sin helhed, så vi vil også bringe dataene som de er med alle statistiske metrikker.
Her er et andet problem. Hvis du bruger en cloud-løsning, så er der kun logiske dumps tilgængelige, fordi Google, Amazon ikke tillader at tage en fysisk kopi. Det vil være et problem her.
Tak for præsentationen. Der blev rejst to gode spørgsmål om MySQL og om ressourceopdeling. Men i essensen handler det ikke om specifikke DBMS'er, men generelt om filsystemet. Og derfor skal spørgsmålene om ressourceopdeling også løses derfra, ikke til sidst, at det er Postgres, men i filsystemet, i serveren, i instansen.
Mit spørgsmål handler om noget andet. Det er mere relateret til lagdelingen i databasen, hvor der er flere lag. For eksempel har vi indstillet opdatering af et ti terabytes billede, vi har replikation kørende. Og vi bruger specifikt denne løsning til databaser. Replikationen kører, og dataene opdateres. Her arbejder 100 medarbejdere parallelt, som konstant kører disse forskellige snapshots. Hvad skal der gøres? Hvordan kan vi undgå konflikter, hvis de kører en ting, men derefter er filsystemet blevet ændret, og disse snapshots bliver fejlbehæftede?
De vil ikke tage af sted, fordi ZFS fungerer sådan. Vi kan holde ændringerne af filsystemet adskilt i én strøm, som kommer igennem replikationen. Og holde kloner af de gamle data, som udviklerne bruger. Det fungerer for os, vi har styr på det.
Så det vil sige, at opdateringen vil ske som et ekstra lag, og alle nye snapshots vil blive baseret på dette lag, ikke?
Fra de tidligere lag, der kom fra tidligere replikationer.
De tidligere lag vil falde bort, men de vil referere til det gamle lag, og de nye billeder vil tage udgangspunkt i det seneste lag, der blev opdateret?
Generelt ja.
Så som konsekvens vil vi have mange lag. Skal de komprimeres med tiden?
Ja, det er korrekt. Der er et bestemt vindue. Vi gemmer uge-snapshots. Det afhænger af, hvilket ressourcer du har. Hvis du har kapacitet til at opbevare mange data, kan du gemme snapshots i lang tid. De sletter sig selv ikke. Der vil ikke være nogen datakorruption. Hvis snapshots er forældede, som vi ser det, det vil sige, det afhænger af politikken i firmaet, så kan vi bare slette dem og frigive plads.
Goddag, tak for præsentationen! Angående spørgsmålet fra Joe. Du sagde, at kunden ikke ønskede at give alle adgang til dataene. Strengt taget, hvis en person har resultatet af Explain Analyze, kan han se dataene.
Det er korrekt. For eksempel, kan vi skrive: "SELECT FROM WHERE email = dette“. Det vil sige, vi ser ikke selve dataene, men nogle indirekte tegn kan vi kigge på. Det skal man forstå. Men på den anden side, er alt dette synligt. Vi har logaudit, vi har kontrol fra andre kolleger, som også ser, hvad udviklerne laver. Og hvis nogen forsøger at gøre sådan, vil sikkerhedstjenesten komme til dem og arbejde på dette spørgsmål.
God dag! Tak for præsentationen! Jeg har et kort spørgsmål. Hvis Slack ikke bruges i firmaet, er der så en eller anden bindning til det nu, eller kan udviklerne opsætte instanser for at tilslutte en testapplikation til databaserne?
I øjeblikket er der kun en tilknytning til Slack, hvilket betyder, at der ikke er nogen anden messenger, men vi vil meget gerne tilføje støtte til andre messengere også. Hvad kan du gøre? Du kan opsætte DB Lab uden Joe, bruge REST API eller vores platform til at oprette kloner og tilslutte med PSQL. Men dette kan kun lade sig gøre, hvis du er villig til at give dine udviklere adgang til dataene, da der ikke vil være nogen skærm her.
Jeg har ikke brug for det lag, men har brug for den mulighed.
Så ja, det kan lade sig gøre.
Kilde: habr.com
