

I årene med at bruge Kubernetes i produktion har vi samlet mange interessante historier om, hvordan fejl i forskellige systemkomponenter førte til ubehagelige og/eller uforståelige konsekvenser, der påvirker containeres og pod'ers drift. I denne artikel har vi samlet nogle af de mest almindelige eller interessante af dem. Selv hvis du aldrig skulle være uheldig at støde på sådanne situationer, er det altid underholdende at læse om sådanne korte detektiver — især 'fra første hånd' — er det ikke?..
Historie 1. Supercronic og hængende Docker
På en af klusterne oplevede vi jævnligt en 'hævet' Docker, hvilket forstyrrede klusterets normale funktion. Samtidig så vi følgende i Docker-loggene
level=error msg="containerd: start init process" error="exit status 2: "runtime/cgo: pthread_create mislykkedes: Ingen plads tilbage på enhed
SIGABRT: abort
PC=0x7f31b811a428 m=0

goroutine 0 [idle]:

goroutine 1 [running]:
runtime.systemstack_switch() /usr/local/go/src/runtime/asm_amd64.s:252 fp=0xc420026768 sp=0xc420026760
runtime.main() /usr/local/go/src/runtime/proc.go:127 +0x6c fp=0xc4200267c0 sp=0xc420026768
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1 fp=0xc4200267c8 sp=0xc4200267c0

goroutine 17 [syscall, locked to thread]:
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1

…
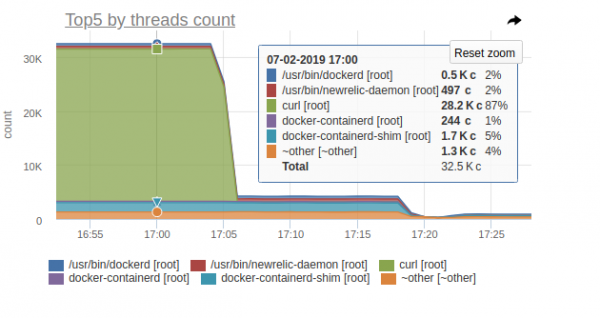
I denne fejl er vi mest interesserede i beskeden: pthread_create mislykkedes: Ingen plads tilbage på enhed. En hurtig gennemgang forklarede, at Docker ikke kunne oprette en proces, hvorfor det periodisk 'hævede'.
I overvågningen af det skete svarer følgende billede til:
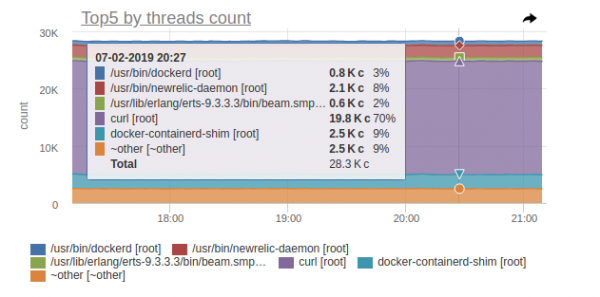
En lignende situation observeres også på andre noder:
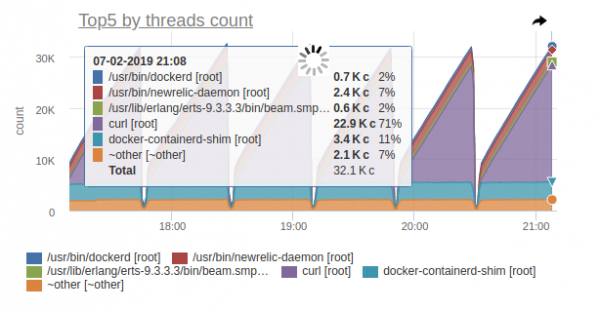
På disse samme noder ser vi:
root@kube-node-1 ~ # ps auxfww | grep curl -c
19782
root@kube-node-1 ~ # ps auxfww | grep curl | head
root     16688  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     17398  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16852  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      9473  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      4664  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     30571  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     24113  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16475  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      7176  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      1090  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
Det viste sig, at en sådan adfærd — er en følge af arbejdet i pod'en med (et værktøj på Go, som vi bruger til at køre cron-opgaver i pod'erne):
 _ docker-containerd-shim 833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 /var/run/docker/libcontainerd/833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 docker-runc
|   _ /usr/local/bin/supercronic -json /crontabs/cron
|       _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true
|       |   _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true -no-pidfile
|       _ [newrelic-daemon]
|       _ [curl]
|       _ [curl]
|       _ [curl]
…
Problemet er følgende: når opgaven køres i supercronic, kan processen, der er blevet genereret af den, ikke afsluttes korrekt, hvilket resulterer i .
Bemærk: Mere præcist bliver processerne genereret af cron-opgaverne, men supercronic er ikke et init-system og kan derfor ikke "adoptere" de processer, der genereres af dets børn. Når SIGHUP- eller SIGTERM-signalerne opstår, overføres de ikke til de genererede processer, hvilket betyder, at de underordnede processer ikke afsluttes og forbliver i zombietilstand. Du kan læse mere om dette i for eksempel .
Der er et par måder at løse problemerne på:
- Som en midlertidig workaround — øg antallet af PID’er i systemet på én gang:
/proc/sys/kernel/pid_max (since Linux 2.5.34) This file specifies the value at which PIDs wrap around (i.e., the value in this file is one greater than the maximum PID). PIDs greater than this value are not allo‐ cated; thus, the value in this file also acts as a system-wide limit on the total number of processes and threads. The default value for this file, 32768, results in the same range of PIDs as on earlier kernels - Eller kør opgaver i supercronic ikke direkte, men ved hjælp af samme , som kan afslutte processer korrekt og ikke generere zombier.
Historie 2. "Zombier" ved fjernelse af cgroup
Kubelet begyndte at bruge en stor mængde CPU:
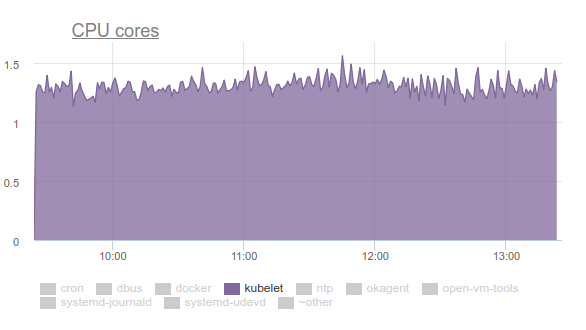
Det er ikke populært, så vi greb ind og begyndte at undersøge problemet. Undersøgelsens resultater viste følgende:
- Kubelet bruger mere end en tredjedel af processorens tid på at hente hukommelsesdata fra alle cgroup:

- I udviklerens nyhedsbrev kan man finde . Kort sagt, essensen er, at forskellige tmpfs-filer og lignende ting ikke helt fjernes fra systemet ved fjernelse af cgroup — såkaldt zombie. På et eller andet tidspunkt vil de blive fjernet fra page cache, men der er masser af hukommelse på serveren, og kernen ser ikke nogen mening i at bruge tid på at fjerne dem. Derfor fortsætter de med at samle sig. Hvorfor sker dette overhovedet? Dette er en server med cron-job, som konstant opretter nye job og dermed nye pod'er. På den måde oprettes der nye cgroup'er for containere, som snart bliver slettet.
- Hvorfor bruger cAdvisor så lang tid i kubelet? Det er let at se det ved en simpel udførelse
time cat /sys/fs/cgroup/memory/memory.stat. Hvis operationen på en sund maskine tager 0,01 sekund, tager den på den problematiske cron02 — 1,2 sekunder. Problemet er, at cAdvisor, som læser data fra sysfs meget langsomt, forsøger at tage højde for den brugte hukommelse og i zombie cgroups. - For at tvinge fjernelse af zombier forsøgte vi at rydde caches, som anbefalet i LKML:
sync; echo 3 > /proc/sys/vm/drop_caches, — men kernen viste sig at være mere kompleks, og maskinen fryser.
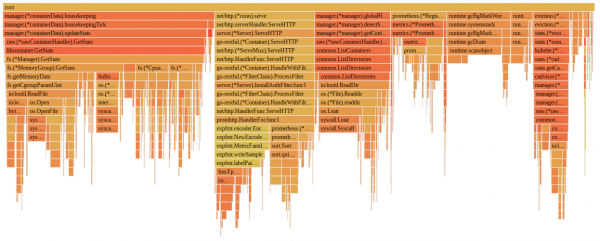
Hvad skal man så gøre? Problemet kan rettes (, og beskrivelsen findes i ) ved at opdatere Linux-kernen til version 4.16.
Historie 3. Systemd og dets mount
Igen bruger kubelet for meget ressourcer på nogle noder, men denne gang — hukommelse:
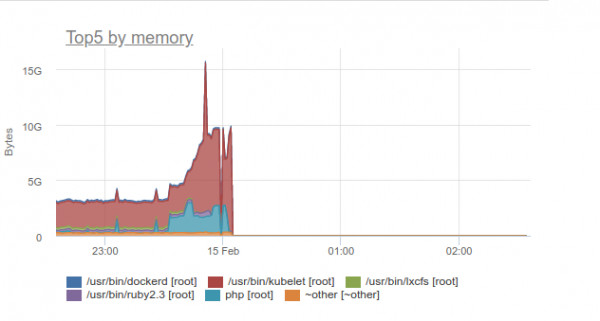
Det viste sig, at der er et problem i systemd, der bruges i Ubuntu 16.04, og det opstår ved håndtering af mounts, som oprettes for at tilslutte subPath fra ConfigMaps eller secrets. Efter pod'ens afslutning forbliver systemd-tjenesten og dens hjælpe-mount i systemet. Over tid samler de sig i stort antal. Der er endda issues om dette emne:
- ;
- .
… i sidstnævnte nævnes der en PR i systemd: (issue i systemd — ).
Problemet findes ikke i Ubuntu 18.04, men hvis du ønsker at fortsætte med at bruge Ubuntu 16.04, kan vores workaround være nyttig i denne sammenhæng.
Så vi lavede følgende DaemonSet:
---
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  labels:
    app: systemd-slices-cleaner
  name: systemd-slices-cleaner
  namespace: kube-system
spec:
  updateStrategy:
    type: RollingUpdate
  selector:
    matchLabels:
      app: systemd-slices-cleaner
  template:
    metadata:
      labels:
        app: systemd-slices-cleaner
    spec:
      containers:
      - command:
        - /usr/local/bin/supercronic
        - -json
        - /app/crontab
        Image: private-registry.org/systemd-slices-cleaner/systemd-slices-cleaner:v0.1.0
        imagePullPolicy: Always
        name: systemd-slices-cleaner
        resources: {}
        securityContext:
          privileged: true
        volumeMounts:
        - name: systemd
          mountPath: /run/systemd/private
        - name: docker
          mountPath: /run/docker.sock
        - name: systemd-etc
          mountPath: /etc/systemd
        - name: systemd-run
          mountPath: /run/systemd/system/
        - name: lsb-release
          mountPath: /etc/lsb-release-host
      imagePullSecrets:
      - name: antiopa-registry
      priorityClassName: cluster-low
      tolerations:
      - operator: Exists
      volumes:
      - name: systemd
        hostPath:
          path: /run/systemd/private
      - name: docker
        hostPath:
          path: /run/docker.sock
      - name: systemd-etc
        hostPath:
          path: /etc/systemd
      - name: systemd-run
        hostPath:
          path: /run/systemd/system/
      - name: lsb-release
        hostPath:
          path: /etc/lsb-release
… og den bruger et sådant script:
#!/bin/bash

# we will work only on xenial
hostrelease="/etc/lsb-release-host"
test -f ${hostrelease} && grep xenial ${hostrelease} > /dev/null || exit 0

# sleeping max 30 minutes to dispense load on kube-nodes
sleep $((RANDOM % 1800))

stoppedCount=0
# counting actual subpath units in systemd
countBefore=$(systemctl list-units | grep subpath | grep "run-" | wc -l)
# let's go check each unit
for unit in $(systemctl list-units | grep subpath | grep "run-" | awk '{print $1}'); do
  # finding description file for unit (to find out docker container, who born this unit)
  DropFile=$(systemctl status ${unit} | grep Drop | awk -F': ' '{print $2}')
  # reading uuid for docker container from description file
  DockerContainerId=$(cat ${DropFile}/50-Description.conf | awk '{print $5}' | cut -d/ -f6)
  # checking container status (running or not)
  checkFlag=$(docker ps | grep -c ${DockerContainerId})
  # if container not running, we will stop unit
  if [[ ${checkFlag} -eq 0 ]]; then
    echo "Stopping unit ${unit}"
    # stoping unit in action
    systemctl stop $unit
    # just counter for logs
    ((stoppedCount++))
    # logging current progress
    echo "Stopped ${stoppedCount} systemd units out of ${countBefore}"
  fi
done
… og det kører hvert 5. minut ved hjælp af den tidligere omtalte supercronic. Dens Dockerfile ser således ud:
FROM ubuntu:16.04
COPY rootfs /
WORKDIR /app
RUN apt-get update &&
    apt-get upgrade -y &&
    apt-get install -y gnupg curl apt-transport-https software-properties-common wget
RUN add-apt-repository "deb [arch=amd64] https://download.docker.com/linux/ubuntu xenial stable" &&
    curl -fsSL https://download.docker.com/linux/ubuntu/gpg | apt-key add - &&
    apt-get update &&
    apt-get install -y docker-ce=17.03.0*
RUN wget https://github.com/aptible/supercronic/releases/download/v0.1.6/supercronic-linux-amd64 -O
    /usr/local/bin/supercronic && chmod +x /usr/local/bin/supercronic
ENTRYPOINT ["/bin/bash", "-c", "/usr/local/bin/supercronic -json /app/crontab"]
Historie 4. Konkurrence ved pod planlægning
Det er blevet bemærket, at: hvis vi har en pod, der er placeret på noden, og dens billede hentes meget langsomt, så vil en anden pod, der "landet" på den samme node, simpelthen ikke begynde at hente billedet af den nye pod. I stedet venter den, indtil billedet af den forrige pod er hentet. Som et resultat af dette vil den pod, der allerede var planlagt og hvis billede kunne hentes på bare et minut, forblive i status containerCreating.
I begivenhederne vil der cirka stå følgende:
Normal Pulling 8m kubelet, ip-10-241-44-128.ap-northeast-1.compute.internal henter billede "registry.example.com/infra/openvpn/openvpn:master"Det viser sig, at et enkelt billede fra et langsomt register kan blokere implementeringen på noden.
Desværre er der ikke mange løsninger på situationen:
- Prøv at bruge dit Docker Registry direkte i klyngen eller direkte fra klyngen (for eksempel GitLab Registry, Nexus osv.);
- Brug værktøjer som .
Historie 5. Noder fryser ved manglende hukommelse
I løbet af vores brug af forskellige applikationer har vi også haft situationer, hvor en node blev helt utilgængelig: svarer ikke på SSH, alle overvågningsdemoner falder fra, og der er næsten ingen anomalier i loggene.
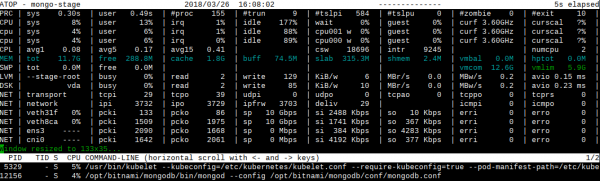
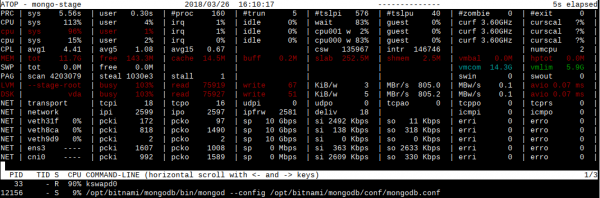
Jeg vil illustrere dette med billeder fra et eksempel med en node, der havde MongoDB kørende.
Sådan ser atop ud op til uheld:
Og sådan her — efter uheld:
Overvågningen viser også et skarpt hop, hvorefter noden bliver utilgængelig:
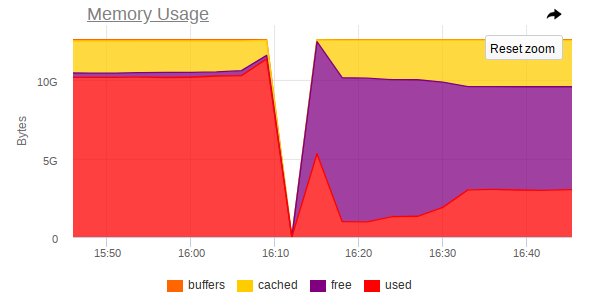
Således viser skærmbillederne, at:
- RAM på maskinen er næsten opbrugt;
- Der er et pludseligt hop i forbruget af RAM, hvorefter adgangen til hele maskinen pludselig lukkes;
- Der kommer en stor opgave til Mongo, som får DBMS-processen til at bruge mere hukommelse og aktivt læse fra disken.
Det viser sig, at hvis der i Linux ikke er nogen ledig hukommelse (memory pressure) og swap ikke er tilgængelig, så op til kan OOM killer komme til at skabe et ligevægt mellem at smide sider i page cache og skrive dem tilbage til disken. Dette håndteres af kswapd, som tappert frigiver så mange hukommelsessider som muligt til efterfølgende distribueringsformål.
Desværre, ved høj belastning på ind- / uddata sammen med lidt ledig hukommelse, bliver kswapd flaskehalsen for hele systemet, fordi det ligger til grund for alle tildelinger (page faults) af hukommelsessider i systemet. Dette kan vare meget længe, hvis processerne ikke ønsker at bruge mere hukommelse, men står på kanten af OOM-killer-afgrunden.
Et naturligt spørgsmål opstår: hvorfor kommer OOM killer så sent? I sin nuværende iteration er OOM killer ekstremt dum: den dræber kun processen, når forsøget på at tildele en hukommelsesside mislykkes, det vil sige, hvis page fault mislykkes. Dette sker ikke hurtigt, fordi kswapd tappert frigiver hukommelsessider ved at nulstille page cache (i praksis al disk I/O i systemet) tilbage til disken. Der kan læses mere detaljeret om trinene for at løse sådanne problemer i kernen. .
Denne adfærd med Linux-kernen 4.6+.
Historie 6. Pod'ene hænger i status Pending
I nogle klynger, hvor der virkelig fungerer mange pod'ene, har vi begyndt at bemærke, at størstedelen hænger meget længe i status Pending, selvom Docker-containere allerede kører på noderne, og man kan arbejde med dem manuelt.
Der er ikke noget galt med describe :
  Type    Årsag                Alder              Fra                      Besked
  ----    ------              ----               ----                      -------
  Normal  Planlagt             1m                 standard-planlægger      Tildelt sphinx-0 til ss-dev-kub07
  Normal  SuccesfuldVedhæftningVolumen  1m                 tilknytning/frakobling-controller  VedhæftVolumen.Vedhæft lykkedes for volumen "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normal  SuccesfuldMountVolumen  1m                 kubelet, ss-dev-kub07    MountVolume.SetUp lykkedes for volumen "sphinx-config"
  Normal  SuccesfuldMountVolumen  1m                 kubelet, ss-dev-kub07    MountVolume.SetUp lykkedes for volumen "default-token-fzcsf"
  Normal  SuccesfuldMountVolumen  49s (x2 over 51s)  kubelet, ss-dev-kub07    MountVolume.SetUp lykkedes for volumen "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normal  Hentet                43s                kubelet, ss-dev-kub07    Containerbillede "registry.example.com/infrastruktur/sphinx-exporter/sphinx-indexer:v1" er allerede til stede på maskinen
  Normal  Oprettet             43s                kubelet, ss-dev-kub07    Oprettet container
  Normal  Startet              43s                kubelet, ss-dev-kub07    Startet container
  Normal  Hentet                43s                kubelet, ss-dev-kub07    Containerbillede "registry.example.com/infrastruktur/sphinx/sphinx:v1" er allerede til stede på maskinen
  Normal  Oprettet             42s                kubelet, ss-dev-kub07    Oprettet container
  Normal  Startet              42s                kubelet, ss-dev-kub07    Startet container
Efter at have gravet lidt, antog vi, at kubelet simpelthen ikke har tid til at sende al information om pod'enes tilstand til API-serveren, liveness/readiness-tjek.
Og efter at have studeret hjælpen fandt vi følgende parametre:
--kube-api-qps - QPS der skal bruges ved kommunikation med Kubernetes API-server (standard 5)
--kube-api-burst - Burst der skal bruges ved kommunikation med Kubernetes API-server (standard 10)
--event-qps - Hvis > 0, begræns begivenhedsskabelser pr. sekund til denne værdi. Hvis 0, ubegrænset. (standard 5)
--event-burst - Maksimal størrelse på bursty begivenhedsoptegnelser, tillader midlertidigt begivenhedsoptegnelser at burst til dette antal, mens man stadig ikke overstiger event-qps. Bruges kun hvis --event-qps > 0 (standard 10)
--registry-qps - Hvis > 0, begræns registreringshentning QPS til denne værdi.
--registry-burst - Maksimal størrelse på bursty hentninger, tillader midlertidigt hentninger at burst til dette antal, mens man stadig ikke overstiger registry-qps. Bruges kun hvis --registry-qps > 0 (standard 10)
Som det fremgår, er standardværdierne - ret små, og i 90 % af tilfældene dækker de alle behov… Men i vores tilfælde var dette ikke tilstrækkeligt. Derfor indstillede vi følgende værdier:
--event-qps=30 --event-burst=40 --kube-api-burst=40 --kube-api-qps=30 --registry-qps=30 --registry-burst=40… og vi genstartede kubelet'ene, hvorefter vi så følgende billede på API-serverens grafikker:
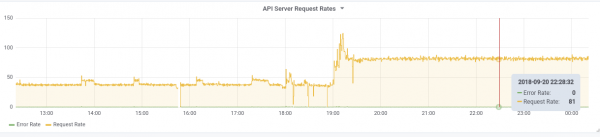
… og ja, alt begyndte at flyve!
P.S.
Jeg vil gerne udtrykke min store tak for hjælpen med at samle fejl og forberede artiklen til de mange ingeniører i vores virksomhed, især til min kollega fra vores R&D-team, Andrey Klimentyev ().
P.P.S.
Læs også på vores blog:
- «».
- Kubernetes tips & tricks:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
