

Bem. overs.: forfatterne af denne artikel er ingeniører fra et lille tjekkisk firma, pipetail. De har formået at samle en imponerende liste over [nogle gange banale, men stadig] meget relevante problemer og misforståelser i forbindelse med driften af Kubernetes-klynger.
I løbet af årene med brug af Kubernetes har vi arbejdet med et stort antal klynger (både administrerede og ikke-administrerede - på GCP, AWS og Azure). Over tid er vi begyndt at bemærke, at visse fejl konstant gentager sig. Der er dog intet skamfuldt i dette: vi har selv begået de fleste af dem!
Artiklen samler de mest almindelige fejl og omtaler, hvordan man kan rette dem.
1. Ressourcer: forespørgsler og grænser
Dette punkt fortjener bestemt den mest opmærksomme omtale og førstepladsen på listen.
CPU-forespørgsel er normalt enten slet ikke angivet eller har en meget lav værdi (for at kunne placere så mange pod'e som muligt på hver node). På den måde bliver noderne overbelastede. Under høj belastning er processorkraften på noden helt udnyttet, og den specifikke arbejdsbyrde får kun det, den "har anmodet om" ved at throttle CPU. Dette fører til øgede forsinkelse i applikationen, timeout og andre ubehagelige konsekvenser. (Læs mere om dette i en anden af vores nylige oversættelser: "" - red.)
BestEffort (yderst ikke anbefales):
resources: {}Ekstremt lav CPU-forespørgsel (yderst ikke anbefales):
   resources:
      Requests:
        cpu: "1m"
På den anden side kan en CPU-grænse føre til urimelig cykelhopping fra pod'e, selvom CPU'en på noden ikke er helt belastet. Igen kan dette føre til øgede forsinkelser. Diskussioner fortsætter omkring parameteren CPU CFS-kvota i Linux-kernen og throttling af CPU baseret på de satte grænser, samt deaktivering af CFS-kvota... Desværre kan CPU-grænser føre til flere problemer, end de kan løse. Læs mere om dette i linket nedenfor.
Overdrevent tildeling (overcommiting) af hukommelse kan føre til mere omfattende problemer. At nå CPU-grænsen medfører cykelhopping, mens at nå hukommelsesgrænsen medfører "drab" af pod'en. Har du nogensinde observeret OOMkill? Да, речь идет именно о нем.
Vil du minimere sandsynligheden for denne hændelse? Fordel ikke overdrevent store mængder hukommelse og brug Guaranteed QoS (Quality of Service) ved at sætte memory request lig med grænsen (som i eksemplet nedenfor). Læs mere om dette i (ledende ingeniør hos Zalando).
Burstable (større sandsynlighed for at få OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Hvad kan potentielt hjælpe med at konfigurere ressourcer?
Ved hjælp af metrics-server kan se den aktuelle CPU-forbrug og hukommelsesforbrug i pods (og containere inden i dem). Du bruger sandsynligvis allerede dette. Udfør blot følgende kommandoer:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Men de viser kun det aktuelle forbrug. Med dem kan man få en omtrentlig idé om størrelsesordenen, men man vil til slut have brug for historik over metricsændringer over tid (for at kunne besvare spørgsmål som: "Hvad var den maksimale CPU-belastning?", "Hvordan var belastningen i går morges?" — osv.). For dette kan man bruge Prometheus, DataDog og andre værktøjer. De henter blot metrics fra metrics-server og gemmer dem, så brugeren kan anmode om dem og lave relevante grafer.
det muligt automatisere denne proces. Den overvåger historikken for CPU- og hukommelsesforbrug og justerer nye requests og limits baseret på disse oplysninger.
Effektiv udnyttelse af databehandlingsressourcer er en udfordrende opgave. Det er som at spille tetris hele tiden. Hvis du betaler for meget for databehandlingsressourcer ved lavt gennemsnitligt forbrug (lad os sige ~10 %), anbefaler vi at se på produkter baseret på AWS Fargate eller Virtual Kubelet. De er bygget på en serverless/pay-per-usage faktureringsmodel, som i sådanne situationer kan være billigere.
2. Liveness og readiness probes
Standard liveness og readiness checks i Kubernetes er ikke aktiveret. Og nogle gange glemmer man at aktivere dem...
Men hvordan kan man ellers få tjenesten til at genstarte efter en uoprettelig fejl? Og hvordan ved lastbalancereren, at en pod er klar til at modtage trafik? Eller at den kan håndtere mere trafik?
Disse probes forveksles ofte med hinanden:
- Liveness — en "livstests"-check, der genstarter pod'en ved en fejl.
- Readiness — tjekke beredskabet, det afbryder pod'en fra Kubernetes-tjenesten ved fejlagtig tilstand (dette kan verificeres med
kubectl get endpoints) og trafikken til den modtages ikke, før en ny kontrol lykkes.
Begge disse kontroller UDFØRES HELE POD'ENS LIVSCYKLUS. Dette er meget vigtigt.
Der er en almindelig misforståelse, at readiness-tests kun udføres ved opstart, så balancereren kan finde ud af, at pod'en er klar (Klar) og kan begynde at behandle trafik. Men det er kun én anvendelse af dem.
En anden er at forstå, at trafikken til pod'en er for meget og overbelaster den (eller pod'en kører ressourcekrævende beregninger). I dette tilfælde hjælper readiness-kontrollen med at reducere belastningen på pod'en og "køle" den ned. En vellykket afslutning af readiness-testen i fremtiden gør det muligt at øge belastningen på pod'en igen. I dette tilfælde (ved fejl i readiness-testen) ville et fejltrin i liveness-testen være meget kontraproduktivt. Hvorfor genstarte en pod, der er sund og arbejder hårdt?
Derfor er i nogle tilfælde en total mangel på kontroller bedre end at have dem aktiveret med forkert konfigurerede parametre. Som tidligere nævnt, hvis liveness-testen kopierer readiness-testen, så er du i store problemer. En mulig løsning er at konfigurere , og ligge.
Begge typer kontroller bør ikke fejle ved nedbrud af fælles afhængigheder, da det ellers vil føre til en kaskade (lavine) af alle pod'ers nedbrud. Med andre ord, .
3. LoadBalancer for hver HTTP-tjeneste
Det er sandsynligt, at du har HTTP-tjenester i din klynge, som du gerne vil eksponere til omverdenen.
Hvis du åbner tjenesten som type: LoadBalancer, vil dens controller (afhængigt af udbyderen) tilbyde og forhandle en ekstern LoadBalancer (ikke nødvendigvis fungerende på L7, men snarere mere på L4), og dette kan påvirke omkostningerne (ekstern statisk IPv4-adresse, beregningskraft, timeafregning) på grund af et stort antal ressourcer, der skal oprettes.
I dette tilfælde er det langt mere logisk at bruge én ekstern belastningsbalancer og åbne tjenester som type: NodePort. Eller, endnu bedre, implementere noget som nginx-ingress-controller (eller traefik), der fungerer som den eneste NodePort en-ånd, der er forbundet med den eksterne belastningsbalancer, og vil dirigere trafikken i klyngen ved hjælp af ingress-ressourcer i Kubernetes.
Andre interne (mikro)services, der interagerer med hinanden, kan "kommunikere" ved hjælp af tjenester af typen ClusterIP og den indbyggede mekanisme til serviceopdagelse via DNS. Brug ikke deres offentlige DNS/IP, da det kan påvirke latency og føre til højere omkostninger i skyen.
4. Autoskalering af klyngen uden hensyntagen til dens særegenheder
Når der tilføjes noder til klyngen og fjernes fra den, skal man ikke stole på nogle grundlæggende metrikker som CPU-forbrug på disse noder. Planlægning af pod'en bør tage højde for mange begrænsninger, såsom pod/node-affinitet, taints og tolerations, ressourceanmodninger, QoS osv. Brug af en ekstern autoscaler, der ikke tager højde for disse nuancer, kan føre til problemer.
Forestil dig, at en pod skal planlægges, men alle tilgængelige CPU-ressourcer er allerede anmodet om/fordelt, og pod sitter fast i tilstanden Pending. Den eksterne autoscaler ser den gennemsnitlige aktuelle CPU-belastning (og ikke den anmodede) og igangsætter ikke en skalering (scale-out) — tilføjer ikke en ekstra node. Som følge heraf vil denne pod ikke blive planlagt.
Når det kommer til nedskaleringsprocessen (scale-in) — fjernelse af en node fra klyngen — er altid sværere at implementere. Forestil dig, at du har en stateful pod (med vedhæftet vedvarende lager). Persistent-volumener tilhører normalt en bestemt tilgængelighedszone og replikeres ikke på tværs af regionen. Derfor, hvis den eksterne autoscaler fjerner en node med denne pod, kan schedulereren ikke planlægge denne pod på en anden node, da det kun kan gøres i den tilgængelighedszone, hvor det vedvarende lager er placeret. Pod'en vil hænge i tilstanden Pending.
I Kubernetes-fællesskabet er der stor popularitet for . Den arbejder i klyngen, understøtter API'er fra de primære cloud-leverandører, tager alle begrænsninger i betragtning og kan skalere i de nævnte tilfælde. Den kan også udføre scale-in samtidig med at alle indstillede begrænsninger bevares, hvilket sparer penge (som ellers ville være brugt på ubenyttede ressourcer).
5. At overse IAM/RBAC-funktioner
Vær forsigtig med at bruge IAM-brugere med permanente hemmeligheder til maskiner og applikationerOrganiser midlertidig adgang ved at bruge roller og servicekonti (servicekonti).
Vi støder ofte på situationer, hvor adgangsnøgler (og hemmeligheder) er 'hardcodet' i applikationskonfigurationen, samt at der forsømmes at rotere hemmeligheder, selvom der er adgang til Cloud IAM. Brug IAM-roller og servicekonti i stedet for brugere, hvor det er relevant.
Glem kube2iam og gå direkte til IAM-roller for servicekonti (som beskrevet i Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Én annotation. Ikke så svært, vel?
Desuden skal du ikke give servicekonti og instansprofiler privilegier admin og cluster-admin, medmindre de har brug for det. Dette er lidt mere kompleks at implementere, især i RBAC K8s, men det er bestemt indsatsen værd.
6. Stol ikke på automatisk anti-affinity for pods
Forestil dig, at du har tre replikaer af en deployment på en node. Noden fejler, og sammen med den alle replikaer. Ubehagelig situation, ikke? Men hvorfor var alle replikaer på én node? Er Kubernetes ikke designet til at sikre høj tilgængelighed (HA)?!
Desværre overholder Kubernetes-scheduler ikke automatisk reglerne for adskilt eksistens (anti-affinity) for pods. De skal angives eksplicit:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Sådan er det. Nu vil pods blive planlagt på forskellige noder (denne betingelse kontrolleres kun under planlægningen, ikke under deres drift — heraf requiredDuringSchedulingIgnoredDuringExecution).
Her taler vi om podAntiAffinity på forskellige noder: topologyKey: "kubernetes.io/hostname", — og ikke om forskellige tilgængelighedszoner. For at realisere en fuldkommen HA skal vi dykke dybere ind i emnet.
7. Ignorerer PodDisruptionBudgets
Forestil dig, at du har en produktionsbelastning i et Kubernetes-kluster. Periodisk skal noderne og selve klustret opdateres (eller tages ud af drift). PodDisruptionBudget (PDB) er en slags servicegaranti mellem klusteradministratorer og brugerne.
PDB hjælper med at undgå driftsforstyrrelser i tjenester forårsaget af mangel på noder:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
I dette eksempel erklærer du som bruger af klyngen for administratorerne: „Hej, jeg har en zookeeper-tjeneste, og uanset hvad I gør, vil jeg gerne have, at mindst 2 replikaer af denne tjeneste altid er tilgængelige.“
Læs mere om dette .
8. Flere brugere eller miljøer i en fælles klynge
Kubernetes-navneområder (namespaces) giver ikke stærk isolation.
Det er en almindelig misforståelse, at hvis man ruller en ikke-prod belastning ud i et navnrum, og prod belastning i et andet, så vil de ikke påvirke hinanden… Men en vis grad af isolation kan opnås gennem ressourceanmodninger/-grænser, oprettelse af kvoter og fastsættelse af priorityClass'er. En form for „fysisk“ isolation i data plane sikres gennem affinities, tolerations, taints (eller nodeselectors), men en sådan opdeling er ret svær at implementere.
De, der har brug for at kombinere begge typer arbejdsbelastninger i en klynge, må finde sig i kompleksiteten. Hvis denne behov ikke er til stede, og det er muligt at oprette endnu en klynge (lad os sige i en offentlig sky), så er det bedre at gøre det. Dette vil give en meget højere grad af isolation.
9. externalTrafficPolicy: Cluster
Vi ser ofte, at al trafik ind i klyngen kommer gennem en service som NodePort, for hvilken politikken som standard er indstillet til externalTrafficPolicy: Cluster. Dette betyder, at NodePort åbnes på hver node i klyngen, og man kan bruge en hvilken som helst af dem til at interagere med den ønskede service (sæt af pod'er).
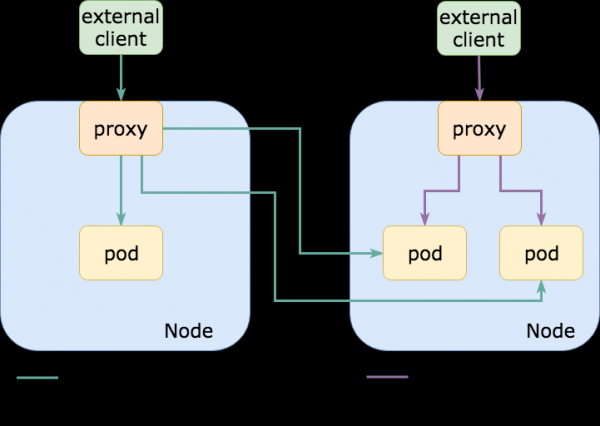
Samtidig findes de reelle pod'er, der er forbundet med ovennævnte NodePort-service, normalt kun på en bestemt delmængde af disse noder. Med andre ord, hvis jeg opretter forbindelse til en node, der ikke har den ønskede pod, vil den omdirigere trafikken til en anden node, tilføje et transitafsnit (hop) og øge forsinkelsen (hvis noderne er i forskellige tilgængelighedszoner/datacentre, kan forsinkelsen blive ret høj; desuden vil udgifterne til egress-trafik stige).
På den anden side, hvis en politik for en given Kubernetes-tjeneste er angivet som externalTrafficPolicy: Local, så åbnes NodePort kun på de noder, hvor de nødvendige pod'er faktisk kører. Ved brug af en ekstern belastningsafbalancer, der tjekker tilstande (healthchecking) af endpoints (som det gør AWS ELB), vil den kun sende trafik til de nødvendige noder, hvilket vil påvirke latensen, beregningskravene, regningerne for egress (og sund fornuft dikterer det samme).
Der er stor sandsynlighed for, at du allerede bruger noget som traefik eller nginx-ingress-controller som din endelige NodePort-endepunkt (eller LoadBalancer, der også bruger NodePort) til at rute HTTP ingress-trafik, og aktivering af denne indstilling kan betydeligt reducere latensen ved sådanne forespørgsler.
I du kan læse mere detaljeret om externalTrafficPolicy, dens fordele og ulemper.
10. Bind ikke til klynger og misbrug ikke kontrolplanet
Tidligere var det almindeligt at navngive servere med egne navne: , HAL9000 og Colossus… I dag er de blevet erstattet af tilfældigt genererede identifikatorer. Men vanen er blevet, og nu får klyngerne egne navne.
En typisk historie (baseret på virkelige hændelser): det hele begyndte som et proof of concept, så klyngen bar det stolte navn testing… Årene er gået, og den bruges stadig i produktion, og alle er bange for at røre ved den.
Der er ikke noget sjovt ved, at klynger bliver til kæledyr, så vi anbefaler at slette dem fra tid til anden, mens du øver dig i genoprettelse efter nedbrud (her vil — red. anm.)hjælpe). Desuden vil det ikke skade at tage sig af kontrolplanet (control plane). Frygten for at røre ved det er ikke et godt tegn. Etcd død? Guys, I er virkelig i problemer!
På den anden side, lad være med at overdrive manipulationerne med det. Over tid kan kontrolplanet blive langsomt.Det skyldes sandsynligvis det store antal objekter, der oprettes uden rotation (en almindelig situation ved brug af Helm med standardindstillinger, hvilket medfører, at dens tilstand ikke opdateres i configmap'er/secrets - som resultat samlet tusindvis af objekter i kontrolplanet) eller ved konstant redigering af kube-api objekter (til automatisk skalering, til CI/CD, overvågning, logfiler, kontrolsystemer osv.).
Desuden anbefaler vi at tjekke SLA/SLO-aftalerne med leverandøren af managed Kubernetes og være opmærksom på garantier. Leverandøren kan garantere tilgængeligheden af kontrolplanet (eller dets underkomponenter), men ikke p99-latensen af de forespørgsler, du sender til dem. Med andre ord kan man indføre kubectl get nodes, og svaret får du først efter 10 minutter, og det vil ikke udgøre et brud på serviceaftalens vilkår.
11. Bonus: brug af tagget latest
Og dette er klassikeren. På det seneste ser vi ikke denne teknik så ofte, da mange, der har lært af bitter erfaring, er stoppet med at bruge tagget :latest og er begyndt at fastgøre (pin) versioner. Hurra!
ECR ; vi anbefaler at sætte sig ind i denne bemærkelsesværdige funktion.
CV
Forvent ikke, at alt fungerer med et fingerknips: Kubernetes er ikke en mirakelkur. Dårlige applikationer (og måske blive endnu værre). Uforsigtighed vil føre til unødig kompleksitet, langsom og anspændt drift af kontrolplanet. Derudover risikerer du at stå uden en katastrofegenopretningsstrategi. Regn ikke med, at Kubernetes 'out of the box' vil håndtere isolering og høj tilgængelighed. Brug lidt tid på at gøre din applikation virkelig cloud native.
Du kan lære om de negative erfaringer fra forskellige teams i fra Henning Jacobs.
Hvis nogen ønsker at tilføje til listen over fejl, der er nævnt i denne artikel, kan de kontakte os på Twitter (, ).
P.S. fra oversætteren
Læs også på vores blog:
- «»;
- «»;
- «» (oversigt og video af foredraget);
- «».
Kilde: habr.com
