

God dag, venner! I dag fortsætter jeg med serien om artiklen om design af virksomhedens netværk.
I artiklen vil jeg så kort som muligt prøve at:
- beskrive den modulære tilgang til design af virksomhedens netværk
- overveje byggeformer for et af de vigtigste moduler i virksomhedens netværk — backbone-netværket (ip-campus)
- beskrive fordele og ulemper ved forskellige varianter af redundans i kritiske netværkspunkter
- på et abstrakt eksempel designe/opdatere et lille virksomhedsnetsværk
- vælge Extreme-switches til implementering af det designede netværk
- arbejde med fiber og IP-adressering
Denne artikel vil være mest interessant for netværksingeniører og netværksadministratorer i virksomheder, der lige er startet på deres rejse som "netværksfolk", snarere end for erfarne ingeniører, der har arbejdet i mange år i telekommunikationsoperatører eller i store virksomheder med geografisk distribuerede netværk.
Under alle omstændigheder opfordrer jeg dem, der er interesserede, til at læse videre.
Modulær tilgang til netværksdesign
Jeg vil begynde min artikel med den ret populære modulære tilgang til netværksdesign, som gør det muligt at samle puslespillet fra netværksstykker til et samlet billede.
Først lidt abstraktion — jeg forestiller mig ofte denne tilgang som zoom på geokorter, hvor man i første omgang ser landet, i anden omgang regionerne, i tredje omgang byerne osv.
Som et eksempel overvejer vi følgende eksempel:
- 1. zoom — hele virksomhedens netværk består af en række forskellige niveauer:
- backbone-netværk eller campus
- grænselag
- kommunikationsoperatørniveau
- fjerntliggende zoner
- 2. zoom — hvert af disse niveauer detaljers i separate moduler
- backbone-netværket eller campus består af:
- et 3- eller 2-niveau modul, der beskriver virksomhedens netværk og dens niveauer — adgang, distribution og/eller kerne
- et modul, der beskriver datacenteret — det centrale databehandlingscenter (i princippet serverdelen af infrastrukturen)
- grænselaget består igen af:
- et modul til internetforbindelse
- et WAN- og MAN-modul, som ansvarer for tilslutning af geografisk distribuerede virksomhedselementer
- et modul til oprettelse af VPN-tunneler og Remote-Access adgang
- ofte viser mange små virksomheder, at flere af disse moduler eller endda alle, bliver kombineret i ét
- udbyderlag:
- Dette niveau omfatter forbindelser til "den ydre verden" - mørke fibre (leje af fibre fra operatører), kommunikationskanaler (Ethernet, G.703 osv.), internetadgang.
- fjernt niveau:
- hovedsageligt er dette virksomhedens filialer, der er fordelt inden for byen, regionen, landet eller endda kontinentet.
- til denne zone kan også høre en backup-datacenter, der duplikerer arbejdet af det primære
- og selvfølgelig er der også de, der i stigende grad vinder popularitet - teleworkers (fjernt ansatte)
- backbone-netværket eller campus består af:
- 3. niveau - hver af modulerne opdeles i mindre moduler eller niveauer. For eksempel i campus-netværk:
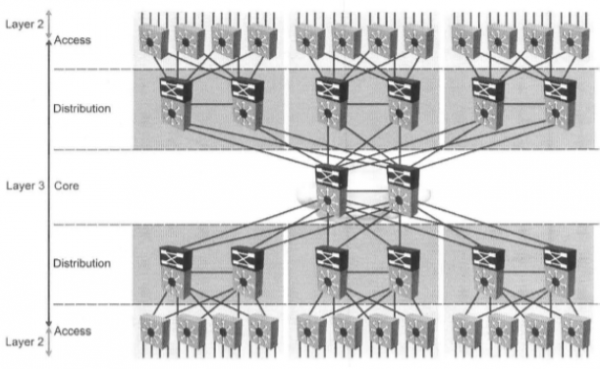
- 3-niveau netværk opdeles i:
- adgangsniveau
- distributionsniveau
- kerne niveau
- Datacenteret kan i mere komplekse tilfælde opdeles i:
- en 2- eller 3-niveau netværksdel
- serverdelen
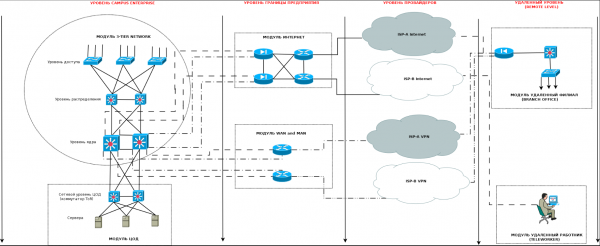
Alt det ovennævnte vil jeg forsøge at illustrere i følgende forsimplede diagram:

Som det fremgår af diagrammet ovenfor - den modulære tilgang hjælper med at detaljere og strukturere det samlede billede i bestanddele, som man senere kan arbejde med.I denne artikel vil jeg fokusere på Campus Enterprise niveauet og beskrive det i detaljer.
Typer af IP-CAMPUS-netværk
I min tid hos udbyderen og især senere - i arbejdet som integrator, har jeg stødt på forskellig "modenhed" i kundernes netværk. Jeg bruger ikke tilfældigt termen modenhed, da det ofte er tilfældet, at netværksstrukturen vokser i takt med virksomhedens vækst, og det er i princippet naturligt.
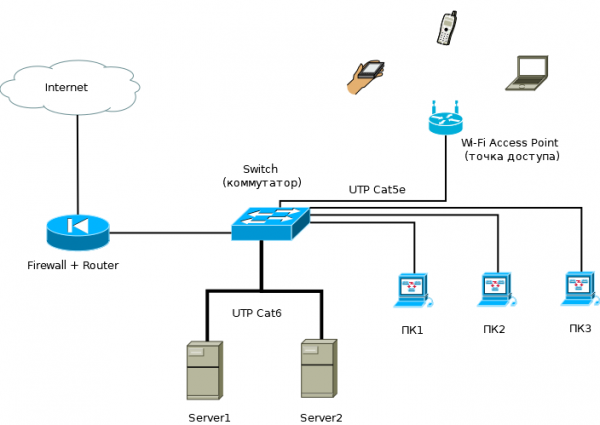
I en mindre virksomhed, der ligger inden for én bygning, kan virksomhedens netværk bestå af blot én grænseruter, der fungerer som en firewall, flere adgangs-switscher og et par-servere.
Jeg kalder et sådant netværk for en "én-niveau" netværk - der findes absolut ikke et klart kerne niveau i netværket, distributionsniveauet er flyttet til grænseruteren (med funktioner som firewall, VPN og muligvis proxy), og adgangs-switscherne betjener både medarbejdernes computere og serverne.

Ved virksomhedsvækst - stigning i antallet af medarbejdere, tjenester og servere, er det ofte nødvendigt at:- øge antallet af switche i netværket og adgangsporte
- øge serverkapaciteten
- Kæmp mod broadcast-domæner ved at implementere netværkssegmentering og routing mellem segmenterne
- Kæmp mod netværksnedbrud, som medfører driftsstop for medarbejdere, da dette medfører ekstra omkostninger for ledelsen (en medarbejder i stilstand modtager løn, men udfører ikke arbejde)
- Når man bekæmper nedbrud, bør man overveje at redundere kritiske netværkselementer — routere, switche, servere og tjenester
- Stram sikkerhedspolitikken, da der kan opstå kommercielle risici, hvilket også bidrager til en mere stabil netværksdrift
Alt dette fører til, at netværksingeniøren (administrator) før eller senere overvejer, hvordan netværket skal bygges korrekt, og begynder at anvende en to-niveau model.
Denne model skelner tydeligt mellem to niveauer — adgangsniveauet og distributionsniveauet, som også fungerer som kerne-niveauet (collapsed-core).
Det kombinerede distributions- og kerneniveau udfører følgende funktioner:
- aggregerer forbindelserne fra adgangsswitchene
- introducerer segmentrouting — brugere og enheder er så mange, at de ikke kan være i et netværk /24, og hvis de kan, så forårsager broadcast-storme konstante nedbrud (især hvis brugerne hjælper dem ved at skabe loop)
- sikrer forbindelsen mellem nærliggende segmenter af switches (via højhastighedsforbindelser)
- sikrer forbindelsen mellem brugerne, deres enheder og serverfarmene, som også på dette tidspunkt begynder at blive adskilt som et separat netværkssegment — datacenteret.
- begynder i samarbejde med adgangsswitchene, i en eller anden grad, at implementere sikkerhedspolitikker, som virksomheden begynder at få på dette tidspunkt. Virksomheden vokser, og kommercielle risici vokser også (her tænker jeg ikke kun på fortrolighedspolitikker, adgangsbegrænsninger mv., men også på elementære nedbrud i netværket og for medarbejdere).
Således vokser netværket før eller senere til en to-niveau model:

I denne model fremkommer der særlige krav til både access switches, som aggregerer links fra brugere og enheder i netværket (printere, adgangspunkter, VoIP-enheder, IP-telefoner, IP-kameraer osv.), samt til distributions- og kerne-switches.Access switches skal være mere intelligente og funktionelle for at imødekomme kravene til netværkets ydeevne, sikkerhed og fleksibilitet, og de skal:
- have forskellige typer adgangs- og trunkports — helst med mulighed for at kunne håndtere væksten i trafik og antallet af porte
- have tilstrækkelig switching-kapacitet og båndbredde
- have nødvendig sikkerhedsfunktionalitet, som opfylder de nuværende sikkerhedspolitikker (og ideelt set også kan imødekomme fremtidige krav)
- have mulighed for at forsyne svært tilgængelige netværksenheder med muligheden for fjern genstart af strømmen (PoE, PoE+)
- have mulighed for at reservelektricitet, så det kan bruges der, hvor det er nødvendigt
- have (hvis muligt) yderligere potentiale for funktionel vækst — et almindeligt eksempel er, når en access switch med tiden bliver til en distributions switch
Distribution switches har desuden også specifikke krav:
- både hvad angår trunk-nedadgående porte mod access switches og mod peer interfaces af nabo distributions switches (og senere potentielle uplink interfaces mod kernen)
- hvad angår L2 og L3 funktionalitet
- hvad angår sikkerhedsfunktionalitet
- hvad angår sikring af fejltolerance (reservedele, clustering og backup strøm)
- hvad angår sikring af fleksibilitet i trafikbalanceringen
- have (hvis muligt) yderligere potentiale for funktionel vækst (transformation af aggregation devices til kernen over tid)
- i nogle tilfælde kan det være passende at anvende PoE, PoE+ porte på distributions switches.
Fremad er der mere: hvis ledelsen vedtager en politik for aktiv vækst og udvikling af virksomheden, vil netværket fortsætte med at udvikle sig — virksomheden kan begynde at leje nabobygninger, bygge sine egne bygninger eller overtage mindre konkurrenter, hvilket dermed øger antallet af arbejdspladser for medarbejdere. Samtidig sker der også en vækst i netværket, som kræver:
- sikring af medarbejdere arbejdspladser — nye adgangsswitches med adgangsportene er nødvendige
- tilgængelighed af nye distributionsswitches til aggregering af links fra adgangsswitchene
- opbygning af nye samt modernisering af eksisterende kommunikationslinjer
Som følge heraf stiger trafikken af følgende grunde:
- på grund af det øgede antal adgangsporte og dermed brugere af netværket
- på grund af den stigende trafik fra tilstødende systemer, der vælger virksomhedens netværk som transport — telefoni, sikkerhed, ingeniørsystemer osv.
- som følge af implementeringen af yderligere tjenester — med væksten i personale opstår der nye afdelinger, der kræver bestemt software
- beregningskraften i datacentret øges for at imødekomme kravene fra infrastrukturen og applikationerne
- kravene til netværks- og informationssikkerhed stiger — den berømte CIA-triade (for sjov), men seriøst, CIA — Confidentiality, Integrity and Availability:
- i denne forbindelse opstår der yderligere krav til netværkets kritiske niveauer — distribution og datacenter — vedrørende fejltolerance og redundans
- igen stiger trafikken som følge af implementeringen af nye sikkerhedssystemer — for eksempel IDS osv.
Tid eller omgående vil væksten af trafik, tjenester og antal brugere føre til nødvendigheden af at implementere et ekstra netværksniveau — kernen, som vil udføre høje hastigheder switching/routing af pakker ved hjælp af hurtigt link.
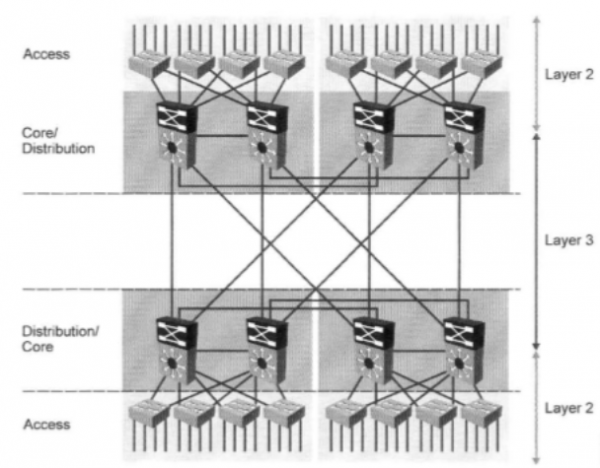
På dette tidspunkt kan virksomheden skifte til en 3-niveau netværksmodel:

Som det ses på det ovenstående billede — er der i et sådant netværk et kerneniveau, som aggregerer hurtige links fra distributionsswitchene. Således stilles der også krav til kernen switchene om:- båndbredde for grænseflader — 1GE, 2.5GE, 10GE, 40GE, 100GE
- switchens ydeevne (switching capacity og forwarding performance)
- interface-typer — 1000BASE-T, SFP, SFP+, QSFP, QSFP+
- antal og sæt af interfaces
- redundansmuligheder (stabling, clustering, redundante styringskort (aktuelt for modulære switches), strømforsyningsredundans osv.)
- funktionalitet
På dette netværksniveau er både teknisk modifikation og
- redundans af kerne-noder og links (meget, meget, meget ønskeligt)
- redundans af nodes og links i distributionslaget (afhængigt af kritikaliteten)
- redundans af links mellem access switches og distributionslaget (efter behov)
- implementering af dynamiske routingprotokoller
- trafikbalancering både i kernen og på distributions- og accessniveauer (om nødvendigt)
- implementering af ekstra services — både transport- og sikkerhedstjenester (om nødvendigt)
såvel som juridiske bestemmelser, der definerer virksomhedens netværkssikkerhedspolitik, som supplerer den overordnede sikkerhedspolitik vedrørende:
- krav til implementering og opsætning af forskellige sikkerhedsfunktioner på access- og distributionsswitches
- krav til adgang, overvågning og administration af netværksudstyr (protokoller for fjernadgang, tilladte segmenter for administration, logningsindstillinger osv.)
- krav til redundans
- krav til dannelse af et minimalt nødvendigt ZIP-sæt
I dette afsnit har jeg kort beskrevet udviklingen af netværket og virksomheden fra et par switches og flere ti medarbejdere til mange ti (eller endda hundreder) switches og flere hundrede (eller endda tusinder) af de medarbejdere, der arbejder direkte i virksomhedens netværk (og der er også produktionsafdelinger og ingeniørnetværk).
Det er klart, at en sådan "mirakuløs" og hurtig udvikling af virksomhederne ikke sker i virkeligheden.
Det tager normalt år, før en virksomhed og netværk vokser fra sit indledende niveau 1 til det 3. niveau, som jeg beskriver.Hvorfor skriver jeg alle disse indlysende sandheder? Fordi jeg gerne vil nævne et begreb som ROI — return-on-investment (afkast/tilbagebetaling af investering) og overveje den del, der direkte vedrører valget af netværksudstyr.
Når netværksingeniører og deres ledere vælger udstyr, baserer de ofte deres valg på to faktorer – den nuværende pris på udstyret og det minimale tekniske funktionalitet, der er nødvendigt på nuværende tidspunkt for at løse en konkret opgave eller opgaver (jeg vil senere tale om indkøb af udstyr til redundans).
Samtidig overvejes mulighederne for fremtidig 'vækst' af udstyret sjældent. Når situationen opstår, hvor udstyret ikke længere kan imødekomme funktionalitets- eller ydeevnekravene, købes der i stedet mere kraftfuldt og funktionelt udstyr, mens det gamle ryger på lager eller sendes rundt i netværket, efter princippet 'bare så det står' (det er øvrigt også en årsag til, at der opstår en stor zoo af udstyr og køb af mange informationssystemer, der arbejder med det).
Dermed, i stedet for at købe en del licenser til ekstra funktionalitet og ydeevne, som er betydeligt billigere end nyt, mere højtydende udstyr, må man købe nyt hardware og betale ekstra af følgende grunde:
- Netværket vokser ofte langsomt, og udvidelse af funktionaliteten eller ydeevnen af din netværks switch kan være tilstrækkeligt i lang tid.
- Det er ikke nogen hemmelighed, at udstyr fra udenlandske leverandører er bundet til udenlandsk valuta (dollar eller euro). Skal vi være ærlige - stigningen i dollar eller euro (eller den periodiske mini-devaluering af rubelen, alt efter hvordan man ser på det) fører til, at dollar for 10 år siden og dollar i dag er helt forskellige ting set fra rubelens synspunkt.
Sammenfattende vil jeg påpege, at køb af netværksudstyr med bredere funktionalitet nu kan føre til besparelser i fremtiden.
Her ser jeg udgifterne til indkøb af udstyr i konteksten af investering i mit netværk og infrastruktur.Således følger mange leverandører (ikke kun Extreme) princippet pay-as-you-grow, ved at inkludere en masse funktionalitet og muligheder for at øge ydeevnen af grænsefladerne, som senere aktiveres ved køb af separate licenser. De tilbyder også modulære switche med et bredt udvalg af interface- og processor-kort samt muligheden for gradvist at øge både deres antal og ydeevne.
Reservering af kritiske noder
I denne del af artiklen vil jeg kort beskrive de grundlæggende principper for reservasjon af sådanne vigtige netværksnoder som kerne-switcher, datacentre eller distributionssystemer. Jeg vil begynde med at se på de generelle former for reserving - stabling og clustering.
Hver af metoderne har sine fordele og ulemper, som jeg gerne vil diskutere.
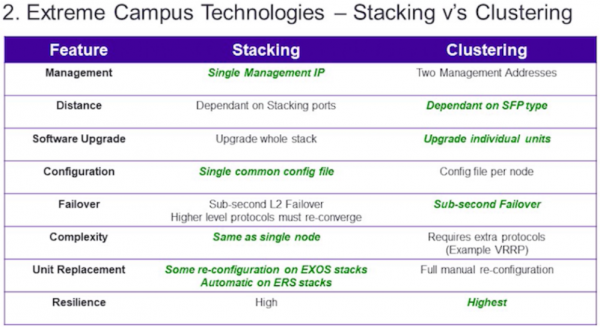
Nedenfor er en generel oversigtstabel til sammenligning af de 2 metoder:

- styring — som det fremgår af tabellen, har stablingen en fordel her, da et stak af flere switcher præsenterer sig som én switch med et stort antal porte. I stedet for at styre 8 forskellige switcher ved clustering kan du kun styre én ved stabling.
- afstand — i øjeblikket er fordelene ved clustering ikke så klare, da der er kommet stablingsteknologier gennem stabelporte eller porte med dobbelt anvendelse (f.eks. SummitStack-V fra Extreme, VSS fra Cisco osv.), som også afhænger af typerne af transceivere. Her gives fordelene til clustering på den måde, at der ved stabling findes situationer, hvor man skal bruge almindelige stabelporte, som ofte forbindes med specielle kabler af begrænset længde - 0,5, 1, 1,5, 3 eller 5 meter.
- softwareopdatering — her ser vi, at clustering har en fordel over stabling, og det handler om følgende - ved opdatering af softwareversionen på udstyret ved stabling opdaterer du softwaren på master-switchen, som derefter tager ansvaret for at uddele den nye software til standby-member switcherne i stakken. På den ene side letter dette dit arbejde, men softwareopdateringer kræver ofte en hardware-genstart, hvilket medfører, at hele stakken genstarter, og dermed fører til afbrydelser i driften og alle tilknyttede tjenester i genstartstiden. Dette er typisk meget kritisk for kerne- og datacentre. Ved clustering - har du 2 uafhængige enheder, som du kan opdatere software på sekventielt. Derved kan du undgå afbrydelser i tjenesterne.
- konfiguration af indstillinger — her er fordelene ved stabling klart synlige, da du med ledelse kun skal justere indstillinger for én enhed og dens konfigurationsfil. Ved clustering derimod vil antallet af konfigurationsfiler være lig med antallet af noder i klyngen.
- fejltolerance — her er begge teknologier omtrent lige, men der er stadig en lille fordel ved clustering. Årsagen til dette ligger i, at hvis vi ser på stakken ud fra de kørende processer og protokoller, kan vi observere følgende:
- der er en master-switch, hvor alle de vigtigste processer og protokoller kører (for eksempel protokollen for dynamisk routing — OSPF)
- der er øvrige slave-switches, hvor de vigtigste processer, der er nødvendige for at arbejde i stakken og håndtere trafikken, kører
- ved svigt af master-switch’en opdager den næste slave-switch i prioritering, at masteren er ude af drift
- den initiere sig selv som master og starter alle de processer, der kørte på masteren (inklusive den observerede protokol OSPF)
- efter noget tid til opstart af processerne (normalt ret kort), begynder selve OSPF-protokollen at fungere
- således vil OSPF ved svigt af en af noderne i clustering fungerere en smule hurtigere end ved stabling (i den tid, der kræves til opstart og initialisering af processer og protokoller på slave-switch'en i stakken). Selvom jeg skal nævne, at moderne stablingprotokoller og switches fungerer meget hurtigt, tager nedetiden i trafikken ofte mindre end et sekund under skiftet af stakken, men nominelt vinder clustering i denne henseende.
- kompleksitet — som det fremgår af tabellen, vinder stabling i komplekse situationer. Dette er en direkte konsekvens af punkterne "styring" og "konfiguration af indstillinger". En enkelt node kræver betydeligt mindre tid til indstillinger og ledelse. Desuden kræver clustering ofte konfiguration af yderligere routingprotokoller eller gateway-redundansprotokoller — VRRP, HSRP og andre.
- udskiftning af noder — her er der en klar fordel ved stacking. Meget ofte kræver det at udskifte en switch i stakken, at man foretar de nødvendige minimumsindstillinger af udstyret, for eksempel:
- opdatere softwaren på den nye switch til versionen af stakken (og dette kan gøres straks, når switchene modtages i lageret)
- indstille et par grundlæggende kommandoer til stacking (og for nogle typer switches kan dette faktisk ikke være nødvendigt)
- at fjerne den defekte switch fra stakken og tilslutte en ny
- tilslutte strømforsyningen og patchkablerne
- elasticitet — jeg anser som en af de vigtigste parametre. Generelt er elasticitet en kompleks karakteristik, der refererer til et objekts evne til at ændre sig under belastning og vende tilbage til sin oprindelige tilstand efter dens ophør. Underligt nok vil elasticiteten til clustering være højere, selv under hensyntagen til en score på 4:3 til fordel for stacking. Det hele handler om menneskelige faktorer. Ja, ja, bliv ikke overrasket — styrken i sådan parameter for stacking som centraliseret styring, konfiguration af indstillinger og lettelse af kompleksiteten afslører svagheden ved stacking, når mennesket spiller en rolle.
I mit arbejde inden for IT har jeg mange gange været ude for situationer (ja, lad os være ærlige, jeg er selv stødt på disse problemer, især i starten), hvor en ingeniør ved konfiguration af stakken gjorde fejl i indtastningen af bestemte kommandoer eller ved at tænde/slukke for skelrende funktioner på udstyret, hvilket førte til, at hele stakken nedbrød og måtte genstartes manuelt. Det er værd at nævne dem, der elsker Putty-applikationen til Windows (åh, det med at kopiere med højre museknap).
Faktisk er begge teknologier temmelig gode (især sammenlignet med fraværet af redundans), og hver har sine styrker og svagheder, men til kernens niveau og til højt belastede datacentre ville jeg stadig foretrække at bruge clustering.
Selvom det kun er min mening. Mange professionelle ingeniører, der har arbejdet med netværksunderstøttelse på et professionelt niveau i mange år, kan lige så godt anvende begge teknologier — her afhænger alt af erfaring og kvalifikation.
Udover teknologier til stacking og redundans af netværksnoder findes der også generelle principper for redundans af dele af selve netværksnoden og forbindelser mellem noderne:
Med redundans inden for netværksnoden forstår jeg:
- redundans af strømforsyninger — installation af 2 strømforsyninger, der duplikerer hinanden (ideelt set tilsluttet til en primær strømforsyningskategori) kan betydeligt lette dit liv.
- redundans af kontrolkort — dette gælder i høj grad for modulære switches, som har mulighed for tilslutning af flere duplikerende kontrolkort.
- redundans af interfacekort — dette gælder ligeledes for modulære switches.
Med redundans af forbindelser/link forstås hovedsageligt tilstedeværelsen af duplikerende kabelruter (eller radiolinks i åbne rum) med:
- fordeling over forskellige kabelskakter og kanaler inden i bygningen
- geografisk fordeling over området på niveauet af 2 eller flere bygninger, byer, regioner eller lande (de såkaldte volumetriske ringe)
Når der bygges redundante forbindelser, er det nødvendigt at følge nogle retningslinjer for udstyret:
- i tilfælde af duplisering af interfacekort i den modulære switch, eller ved tilstedeværelse af stacking, skal forbindelserne fordeles mellem enhederne — interfacekort i tilfælde af modulære switches og switches i tilfælde af stacking.
- det er ønskeligt at bruge protokoller til linkaggregering (LACP, MLT, PAgP osv.) til at samle links i grupper og fordele belastningen mellem dem.
- bruge routere, der understøtter ECMP-protokoller (Equal-Cost-Multi-Path) — når flere pakker leveres via en rute, og disse pakker ikke går gennem én bedste rute (og interface), men fordeles over flere bedste ruter (og flere interfaces), som bestemmes ud fra lighed i routingprotokollets metrikker, som igen er ansvarlig for at udfylde den endelige routingtabel.
Og nu, som lovet, vil jeg beskrive en reel sag fra min praksis og princippet om besparelse ved redundans af kritiske noder, som skete for et par år siden:
- i et firma, lad os kalde det X, var der en standard 3-lags netværksmodel:
- med flere kerner
- flere dusin aggregationer
- med et par tusinde adgangsunioner
- med titusindvis af brugere
- netværket var ret komplekst opbygget:
- med en masse dynamiske routingprotokoller og protokoller — OSPF, MP-BGP, MPLS, PIM, IGMP, IPv6 osv.
- med en række tjenester — internetadgang, L2 og L3 VPN, VoIP, IPTV, dedikerede linjer osv.
- men der var ét flaskehals i netværket — grænserouteren, som kombinerede funktioner som BGP-border og terminerede nogle brugerrettede tjenester
- ja, den kostede som en vinge på et fly (flere millioner rubler)
- ja, på det tidspunkt var den en af de bedste enheder fra den mest anerkendte netværksleverandør
- ja, den skulle være meget pålidelig — med fremragende MTBF
- ja, den havde 4 strømkilder, der var samlet i en 2x2-konfiguration og tilsluttet via forskellige UPS og indgange.
Men alt dette ændrede ikke det faktum, at den var et enkelt fejlpunk i netværket.
Og en dag, der bestemt ikke var god for mig og mine kolleger, stoppede denne router med at fungere (senere fandt vi ud af, at der var sket en eller anden fejl i strømforsyningen via UPS, hvilket førte til, at 2 strømkilder gik ned samtidigt, og samtidig brændte en af strømkilderne routerens RP-modul og interfacekortet, som var tilsluttet den fælles databus i enheden).
Vi havde ikke reservedelene — RP og interfacekortet, men vi havde en kontrakt på udskiftning af udstyr eller dets komponenter med en af vores partnere efter NBD-ordningen.
Desværre havde partnerne kun interfacekortet på lager på det tidspunkt, men RP-kortet kom først efter et par dage (efter 3 dage).
Som et resultat førte tilstedeværelsen af et enkelt fejlpunk i netværket (selv med en support- og udskiftningskontrakt) til følgende finansielle omkostninger:
- andelen af virksomhedens tjenester, der var relateret til denne border, udgjorde cirka 60-70%
- som senere blev beregnet havde den daglige profit været omkring 900.000 rubler (cirka) på det tidspunkt
- således gik der teoretisk mistet profit på mellem 1.620.000 rubler og 1.890.000 rubler i løbet af 3 dages nedetid
Selvfølgelig var de rene tab mindre, da kompensationen til hovedparten af brugerne ikke blev udbetalt i penge, men i form af tjenester, men de var stadig til stede:
- en del kompensation til corporatebrugerne
- forøgede udgifter til virksomhedens medarbejdere, der har arbejdet i fuldt antal i alle disse 3-4 dage – overarbejde, nattevagter, øget skift osv.
- reputationsmæssige tab, hvilket heller ikke er uvigtigt
- og det vigtigste – nerverne, både for ledelsen og medarbejderne, såvel som for kunderne
Som et resultat blev virksomhedens politik revideret:
- man opgav udskiftningskontrakten ifølge betingelse NBD
- man beholdt den almindelige servicekontrakt
- man købte en duplikerende router til en pris på ca. 1 – 1,3 millioner rubler for at sikre 90% funktionalitet af den primære
Fremadrettet gjorde indkøbet af yderligere udstyr og reservedele til hovedudstyret det muligt at balancere belastningen mellem dem i forhold til eksterne links, trafik og brugere, og sikrede en buffer for virksomheden i tilfælde af fremtidige nødsituationer.
Eksempel på design af Enterprise-netværk
I denne del af artiklen vil jeg forsøge at beskrive de vigtigste punkter i beregningen af virksomhedens backbone-netværk. Jeg vil ikke overbelaste dig med hele metoden PPDIOO (Prepare-Planning-Design-Implement-Operate-Optimize), men vil kun fremhæve dens vigtigste punkter:
- Prepare/Forberedelse – det er nødvendigt at afklare med din ledelse, hvilke mål for modernisering af netværket du ønsker at opnå – øge driftsstabiliteten, implementere nye services eller teknologier. Jeg vil springe over fastsættelsen af begrænsninger – tekniske og organisatoriske, da jeg antager, at du er ansat i organisationen og har en god margin i tid til at overvinde dem. Jeg vil vende tilbage til budgetspørgsmålet senere.
- Planning/Planlægning – her skal du lave en komplet beskrivelse af dit nuværende netværk (hvis du ikke allerede kender det), dvs. beskrive netværket, som det er nu:
- antal og typen af udstyr
- antal og typer af porte
- eksisterende kabelruter og skemaer for switching inde i bygninger og mellem dem
- strømforsyningsskemaer
- L2 og L3 adressering
- bygge Wi-Fi netværkskort med angivelse af adgangspunkter og controllere
- beskrive din serverfarm
- det anbefales at beskrive alle dine services og forbindelser mellem dem
- hvis du allerede har implementeret en eller anden form for netværkssikkerhedspolitik og netværksadgangsinddeling, så husk at tage hensyn til det i designet
- Jeg vil straks bemærke, at det andet trin i bund og grund repræsenterer en fuldstændig inventarisering af netværket, fra kabelinfrastrukturen og strømforsyningsskemaerne til tjenesterne (applikationerne og deres porte). Dette trin er meget, meget arbejdskrævende og kan til tider være kedeligt. Hvis du eller din forgænger ikke har ført dokumentation eller endda et elementært overvågningssystem, så er det på høje tid at overveje det. Netværket har en tendens til at ændre sig over tid i forskellig hastighed, og kun ved at føre ajourført dokumentation eller et overvågningssystem kan du holde styr på dets tilstand og lette administrationen. Men det hører allerede til trin 'operate'.
- Design — bevæbnet med den fulde viden om dit netværk, opnået i det forrige trin, sætter du dig endelig ned og overvejer, hvordan du vil opgradere dit netværk. Nedenfor vil jeg forsøge at vise et lille eksempel på netværksberegningen.
Jeg har lavet en lille liste med de grundlæggende data, som jeg vil følge, når jeg beregner og designer det centrale netværk.
Lad os forestille os trin 'Prepare' som en liste over, hvad vi har til rådighed, og hvad der er planlagt at blive gjort:
- der er et ret stort firma med cirka 700-800 arbejdspladser (her mener jeg de ansatte, der har brug for adgang til virksomhedens netværk)
- der er flere selvstændige bygninger inden for virksomhedens område:
- Hovedbygninger:
- antal bygninger — 2 stk
- antal etager i bygningen — 7 stk
- antal telekommunikationsskabe pr. etage i én bygning — 3 (i alt 21) stk
- antal medarbejdere i bygningen =~ 250 personer
- Yderligere bygninger:
- antal bygninger — 10 stk
- antal etager i bygningen/fabrikken — 2 stk
- antal telekommunikationsskabe i bygningen — 3 stk
- antal medarbejdere i bygningen =~ 20 personer
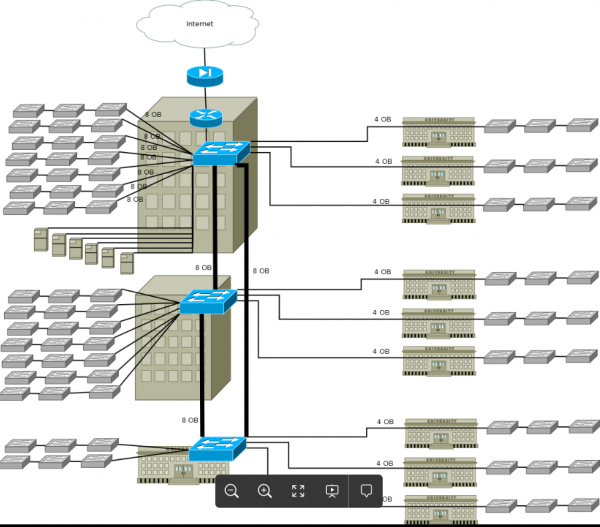
- Den nuværende niveau af netværkskernen (forresten en meget udbredt skema, som jeg har set flere gange i forskellig form og med forskellige porte) er præsenteret:
- med 2 L2 switches:
- 1Gb porte af typen RJ-45 — 24 stk
- 1Gb SFP porte — 4 stk
- med 1 L2 switch:
- 1Gb SFP porte — 24 stk
- topologien af kernen — ring
- peer-to-peer links mellem switches er aktiveret ved hjælp af optiske fibre
- switches er placeret i små serverrum med skabe
- med 2 L2 switches:
- Den nuværende niveau af distribution:
- sammensat med netværkskernel niveauet i forbindelse med aggregating links fra adgangsswitches
- L3 adressering flyttes til grænserouter og/eller firewall
- Nuværende adgangsniveau:
- L2-switches med 16 x 100 Mb RJ-45 adgangsport og 2 gigabit combo uplink RJ-45/SFP porte
- switchene er placeret i skabe på etagerne
- topologi for adgangsswitcher:
- stjerne (hub-and-spoke — hub og eger) med kerne-/distributionswitch i midten
- stråle/spoke repræsenterer en sektion af switches på etagerne — 3 stykker i kæden
- der er ikke-styrbare adgangsswitches
- switchene i 9 ekstra bygninger er tilsluttet via mediekonvertere (optisk til elektrisk signalomformere)
- Nuværende kabelinfrastruktur:
- Kabelsystem mellem bygninger:
- der er et optisk kabel mellem de 2 hovedbygninger med kapacitet på 8 fibre
- der er 1 optisk kabel mellem en af de ekstra bygninger (hvor kerne-switch er installeret) og hver af de primære bygninger med kapacitet på 8 fibre hver
- der er 1 optisk kabel mellem de ekstra bygninger og de bygninger med installerede kerne-switches med kapacitet på 4 fibre (deres distribution er vist på billedet nedenfor)
- fiber type i alle kabler — SMF
- der anvendes 2-fiber SMF SFP transceivere
- nogle kabler termineres på optiske cross-connects (ODF) i separate rum (cross rooms/server rooms), mens nogle kabler er i etage-skabe
- Kabelsystem inden for bygninger:
- der er en blandet kabelstruktur mellem serverrum og de første skabe på etagerne:
- kobberkabler Cat5e — 10 stk (eller 100 par kabler)
- multimode/MF fiber kabel på 4 eller 8 fibre — 1 stk
- multimode/MF fiber kabel på 4 fibre mellem etageskabe
- kobberkabler Cat5e mellem etageskabe og adgangsstik
- nuværende datacenter:
- der er flere servere, for eksempel 6 stykker
- tilsluttet med 1 Gb porte til kerne-switch i 1. hovedbygning
- alle virksomhedens applikationer er placeret på servere
- L2, L3 adressering og routing:
- der er flere VLANs i netværket — 2,3 stykker pr. bygning
- servere er tildelt til et separat /24 netværk
- til interne behov anvendes grå klasse B netværk, der falder inden for rækkevidden — 172.16.0.0/16
- L3 adresser terminates på grænserouteren og/eller firewall.
- Der anvendes statisk routing.
- Yderligere information:
- Telefoni:
- Traditionel telefoni med digitale PBX'er af gammel type (ikke IP-PBX) er blevet implementeret i bygninger og enkelte bygninger.
- Det er nødvendigt at telefoniere nye bygninger uden udgifter til dyre kobberkabler af bestemt kapacitet og opbygning af en redundant struktur for telefoni indeni bygninger.
- Der planlægges gradvist at implementere IP-telefoni på hele virksomhedens område, integrere det med CRM-systemer og overføre alle medarbejdere til det.
- Portkapacitet:
- Det skal analyseres, hvad den nuværende kapacitet af transmissionsporte og adgangsportene er, og der skal reserveres minimum 25-30% til fremtidige behov.
- Analysere tilstrækkeligheden af den nuværende båndbredde af adgangsportene og transmissionslinjerne.
- Forese portene PoE/PoE+ for enheder fra tilstødende systemer - videoovervågning og telefoni.
- Videoovervågning:
- Der planlægges at bruge virksomhedens netværk som transport for videoovervågningsnetværket.
- Det er nødvendigt at forudse tilstedeværelsen af PoE-porte for overvågningskameraer.
- Trådløse systemer:
- Det planlægges i fremtiden at implementere en trådløs infrastruktur for medarbejdernes mobilitet.
- Det er nødvendigt at forudse tilstedeværelsen af PoE-porte for adgangspunkter.
- Budget, tidslinjer og udstyrskrav:
- Udnyt det eksisterende udstyr maksimalt.
- Ved netværksdesign skal der tages højde for muligheden for at udvide netværkets kapacitet i N år frem.
- Ved netværksdesign skal alle sikkerhedsfunktioner understøttes - herunder en liste over funktionalitet fra port-sikkerhed til autentificering og autorisation af brugere via 802.1x.
- Så vidt muligt skal kritiske noder i netværket af højeste vigtighed reserveres - kernen og datacentret, og der skal overvejes mulighed for at reservens sekundære vigtighedsnoder - distributionsnoder.
- Projektbudgettet skal forudse trinvis finansiering i flere faser.
- Budgetbeløbet - her bestemmer hver virksomhed selv baseret på sine økonomiske indikatorer.
- Tidsrammer - i det mest ideelle tilfælde vil der ikke være nogen åbenlyse tidsrammer her, da det er et internt projekt for virksomheden, der gennemføres af egne medarbejdere, eller de vil være relativt komfortable - for eksempel 1 år (eller mere). I det værste tilfælde kan det være alt fra 3 måneder til et halvt år.
- løse nuværende problemer i netværket:
- pakketab
- problemer med DHCP på mere eller mindre intelligente adgangsswitche, relateret til brugen af STP-protokolfamilien for at bekæmpe løkker på adgangsporte.
- fjerne DHCP-serverens tilstedeværelse i hver VLAN for medarbejdere
- opståen af switching-løkker relateret til uautoriseret tilslutning af administrerede/ikke-administrerede switche i kontorerne og tilslutning af forskellige enheder til dem
- listen kan fortsætte og fortsætte…
Planlægnings trin - karakteriseringen af tilstanden i dit nuværende netværk, som jeg allerede har nævnt, afhænger af tilstedeværelsen af et kvalitetsmonitoreringssystem og graden af dets dokumentation. På dette trin skal du:
- mindst skitsere det eksisterende netværk til yderligere analyse
- indsamle data fra udstyret:
- trafik på backbone-porte
- fejl på portene
- CPU-belastning og hukommelsesforbrug på switche og routere
- skrive L2-L3 diagrammer for VLAN'er og IP adresser
- oprette diagrammer for kabelruter:
- fiberdiagrammer og diagrammer for patching af optiske kryds
- diagrammer for kobberkabeldistribution mellem serverrum og etager
- diagrammer for kobberkabeldistribution mellem etager og kontorer
- tjekke for tilstedeværelsen af optiske kryds og patchpaneler i serverrum og skabe
- tjekke strømforsyningsdiagrammer i serverrum og etage skabe
- tjekke for tilstedeværelsen af UPS og batterier på kritiske punkter
- analysere alle data
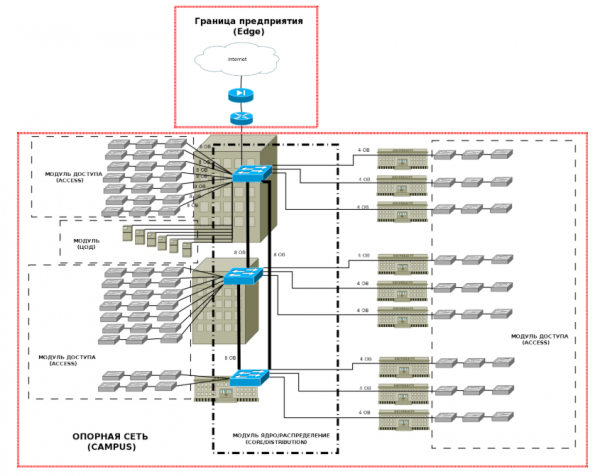
Med udgangspunkt i dataene fra forberedelsesfasen, har jeg lavet et omtrentlig logisk diagram:

Dernæst, ved at følge den modulære tilgang, skal niveauer og moduler i virksomheden skelnes:
Grænser (Edge) vil jeg ikke berøre i denne artikel, men jeg vil kort minde om de grundlæggende pointer for hvert af Campus-modulerne:- Adgang - på dette niveau skal det sikre:
- det nødvendige antal porte til brugernes adgang til netværket
- implementering af sikkerhedspolitikker - filtrering af trafik og protokoller
- komprimering af broadcast-domæner og segmentering af netværket ved hjælp af VLAN
- implementering af separate VLAN til tale trafik
- support for QoS
- support for PoE adgangsportene
- support for IP multicast
- fejltolerance for opadgående forbindelser i samarbejde med distributionsniveauet (helst)
- Distribution – på dette niveau skal der sikres:
- det nødvendige antal porte til tilslutning af adgangsswitcher
- aggregering og reserving af adgangsswitcher forbindelser
- IP-routing
- pakke filtrering
- support for QoS
- fejltolerance på niveauet af links, udstyr og strømforsyning (meget ønskeligt)
- Kernen – skal sikre:
- høj pakke-switching og routing hastighed
- det nødvendige antal porte til tilslutning af distributionsswitcher
- support for IP-routing og dynamiske routingprotokoller med hurtig netværkskonvergens
- support for QoS
- sikkerhedsfunktionalitet til beskyttelse af adgang til udstyr og kontrolplanen
- fejltolerance på niveauet af udstyr og strømforsyning (obligatorisk)
- Datacenter – netværksniveauet i denne modul skal sikre:
- højhastigheds forbindelser
- det nødvendige antal porte til tilslutning af servere
- reservering af forbindelser både mellem servere og datacenter switcher samt mellem datacenter switcher og kernen i netværket (obligatorisk)
- reservering af udstyr og strømforsyning (obligatorisk)
- support for QoS
Dernæst skal vi tælle vores porte og forbindelser og bestemme kravene.
Så vi har fået data til fordeling af adgangsporte i bygningerne. Nu er det nødvendigt at analysere kravene til adgangsniveauet og bemærkningerne og skitsere mulige løsninger.
Dernæst vil vi tælle porte og forbindelser for følgende niveauer:
Ved beregningen fik vi følgende:
- adgangsniveau – 24- og 48-port adgangsswitcher er nødvendige, gerne med 1Gb adgangsport og optiske uplink porte SFP med support for PoE og bred funktionalitet:
- i alt vil de give 504 adgangsporte, hvilket i princippet dækker kravene til spare porte, hvis der træffes beslutning om at bruge 2 porte pr. arbejdsplads – IP-telefon og dataport.
- det kan være brug af en 48-port PoE-switch på hver etage, der leverer adgangsporte til kravene:
- reserve — omkring 102 spare porte (22%) på hovedbygningerne. For yderligere bygninger er det lidt mere — 25%.
- videoovervågning
- trådløst netværk
- distributionsniveau — der er behov for switche med et sæt SFP-porte fra 12 til 48 porte med minimum 2 SFP+ porte, muligheden for stabling og avanceret funktionalitet, samt redundante strømadaptere.
- kerne niveau — der kræves højhastigheds switche fra 12 til 24 SFP/SFP+ porte med understøttelse af både stabling og clustering med MC-LAG. Det skal bemærkes, at routingmidler kan anvendes til trafikbalancering. De seneste generationer af L3 switche og routere understøtter ECMP med trafikbalancering over 4 eller flere ruter med samme metrik.
- niveauet af datacenter — der er behov for switche fra 8 til 24 SFP/SFP+ porte med understøttelse af både stabling og clustering med MC-LAG.
Den målrettede netværksdiagram er endelig blevet
Valg af Extreme-switche til gennemførelse af projektet
Så er vi kommet til hovedpunktet — valget af switche til gennemførelse af vores projekt. Til det opnåede målrettede diagram vil følgende Extreme-switche være passende:
Niveau
Model
Ports
Descriptioner baseret på Linux-kerneversion 4.19, som kører i Windows ved hjælp af en virtuel maskine, der allerede er anvendt i Azure. De specifikke patches til WSL2-kernen inkluderer optimeringer til at reducere opstartstiden for kernen, mindske hukommelsesforbruget, frigive hukommelse, der er optaget af Linux-processer, samt at holde et minimalt nødvendigt sæt drivere og subsystemer i kernen.
x620-16x-Base *x670-G2-48x-4q-Base*
16 x 10GE SFP+
48x10GE SFP+ og 4×40 GE QSFP+
Til de primære behov i kernen:- højhastighedsforbindelser
- avanceret routing- og sikkerhedsfunktionalitet
- redundant strømforsyning med ekstra strømblokke
- understøttelse af stabling og clustering
Med minimale krav er switchen fra serien x620 tilstrækkelig.
Hvis der er udvidede krav til antallet af porte og bredere funktionalitet, bør switche fra serien x670-G2 overvejes.Datacenter
x620-16x-Base*
x590-24x-1q-2c*
x670-G2-48x-4q-Base*
16 x 10GE SFP+
24x10GE SFP, 1xQSFP+, 2xQSFP28
48x10GE SFP+ og 4×40 GE QSFP+Til de primære behov i datacenteret:
- højhastighedsforbindelser
- redundant strømforsyning med ekstra strømblokke
- understøttelse af stabling og clustering
Med minimale krav er switchen fra serien x620 tilstrækkelig.
Hvis der er udvidede krav til antallet af porte og bredere funktionalitet, bør switche fra serien x670-G2 og x590-24x-1q-2c overvejes.distribuering
X460-G2-24x-10GE4-Base*
X460-G2-48x-10GE4-Base*
24x1GE SFP, 8×1000 RJ-45, 4x10GE SFP+
48x1GE SFP, 4x10GE SFP+Til de primære behov i distribueringen:
- nødvendigt antal optiske porte
- redundant strømforsyning med ekstra strømblokke
- understøttelse af stabling og clustering
- nødvendig L3 funktionalitet
De er ideelle for X460-G2-serien. Tilgængeligheden af redundant strømforsyning med mulighed for at udvide og tilføje 10G-porte, CX (til stacking) og QSFP+ gør dem til de perfekte switche til distributionsniveauet med porte op til 1 Gb.
adgang
X440-G2-24p-10GE4*
X440-G2-24t-10GE4*
X440-G2-48t-10GE4*
X440-G2-48p-10GE4*
24x1000BASE-T(4 x SFP combo), 4x10GE SFP+ (PoE budget 380 W)
24x1000BASE-T(4 x SFP combo), 4x10GE SFP+
24x1000BASE-T(4 x SFP combo), 4x10GE SFP+ kombinationsporte
48x1000BASE-T(4 x SFP combo), 4x10GE SFP+ kombinationsporte (PoE budget 740 W)Til adgangsbehov:
- det nødvendige antal adgangsporte
- understøttelse af PoE/PoE+
- funktionalitet og mulighed for udvidelse af porte
- en ekstra bonus i form af understøttelse af stacking med 10Gb porte 'out of the box'
Jeg anbefaler at lade sig imponere af denne række for dens fleksibilitet med hensyn til porte, ydeevne og funktionalitet.
*specifikationen for de valgte switche kan ses i den første artikel i rækken —
På dette punkt kunne jeg afslutte artiklen, men jeg vil gerne belyse yderligere 2 aspekter, som enhver ingeniør vil støde på ved udvikling eller opgradering af sit netværk:
- arbejde med kabelbaner — fiber og kobberlinjer
- IP-adressering
Arbejdet med fiber
Ovenfor har jeg præsenteret det ønskede diagram, som vi skal nå. For at realisere det kræves følgende antal forbindelser til udstyret:
Som det fremgår af tabellen, er det mindste antal fiber, der kræves for at sikre redundant drift af netværksniveauerne (kerne, datacenter og distribution i 2 bygninger) — 10 enheder.
I netværkets karakteriseringsfase fandt vi ud af, at der kun er 8 fibre i kabel mellem bygningerne. Hvad skal vi gøre i en sådan situation?
Jeg vil præsentere nogle løsninger:
- det første åbenlyse skridt — at bruge de frie fibre i kablet mellem bygning 1 — bygning 1 og bygning 1 — bygning 2 (som det fremgår af tabellen — bruges kun 2 ud af 8 fibre i hvert kabel). For dette er det tilstrækkeligt at installere optiske krydsninger mellem krydsene i bygning 1 og om nødvendigt bruge SFP-moduler med en margin på det optiske budget.
- Det andet skridt er muligvis brugen af CWDM-teknologi – komprimering af bærerbølgelængder inden for en enkelt fiber. Denne teknologi er meget billigere end DWMD og ret nem at implementere. De vigtigste krav er rettet mod kvaliteten af de optiske fibre og SFP/SFP+ transceivere af en bestemt længde og budget. Som jeg nævnte i den tidligere artikel – muligheden for, at switche genkender transceivere fra tredjepart, kan være en stor lettelse for os og reducere kapitalomkostningerne ved at opføre yderligere optiske kabler.
- I det tredje skridt bør man overveje muligheden for at øge antallet af fibre ved at lægge ekstra optiske kabler.
Derefter ser vi på antallet af fibre mellem bygningerne med installerede fordelingsswitche og ekstra kabinetter 2-10. Her er der heller ikke noget entydigt:
- For det første er der ikke tilstrækkeligt med fibre til at realisere vores målskema – to fibre pr. switch (som vi husker, har vi kabler med 4 FO pr. kabinet).
- For det andet, selv med tilstrækkeligt antal fibre mellem bygningerne, bruges der MMF-fibre inde i kabinetterne, som ikke gør det muligt for os bare at koble SMF og MMF-fibre sammen (jeg taler om afstande mellem bygninger over 300-400 meter).
I sådanne tilfælde kan vi overveje følgende optioner:
- Forsyning af hver switch med SMF-fibre:
- Hvis afstandene tillader det, kan der trækkes ekstra lange patchkabler mellem switche. Tidligere brugte vi patchkabler på 30-50 m i længden.
- Lægge et relativt billigt optisk SMF-kabel med lav kapacitet mellem skabene.
- Som en sidste mulighed kan man bruge forskellige SMF-MMF konvertere.
- For at minimere de anvendte fibre mellem bygningerne kan man:
- Brug funktionen til stakning af access switches x440-G2 – ved dette bruge 1 SMF-fiber til hver switch på etage, hvilket muliggør anvendelsen af 3 fibre og porte på hver side i stedet for 6 fibre og porte.
- Brug 2 fibre til at forbinde den første switch i kæden og den sidste. Aggregere linker på grænse-switchen og bruge STP-protokoller i den resulterende ring.
IP-adressering
Her vil jeg give et eksempel på adressering til vores skema.
I øjeblikket har vi flere klasse B-netværk — 172.16.0.0/16. Når jeg beregner IP-adresseområdet, vil jeg følge disse hensyn:
- 4 bit af det andet oktet vil repræsentere bygninger — 172.16.0.0/12.
- 3. oktet vil angive etage nummeret i bygningen.
- 3. oktet = 255 vil blive tildelt til point-to-point linjer af udstyr og styringsnetværk.
- én management VLAN pr. etage til styring af switches.
- én bruger VLAN pr. switch (gennemsnitligt 24 porte).
- én Voice VLAN pr. switch (gennemsnitligt 24 porte).
- én VLAN til videosystemet pr. etage.
- én VLAN til Wi-Fi-enheder pr. etage.
Jeg endte med cirka sådanne tabeller:
I tabellen ovenfor har jeg præsenteret et omtrentligt opdelingsmønster af netværk mellem bygninger og etager på den ene side og netværk (bruger, administration og service) på den anden side.
Faktisk er valget af det grå netværk 172.16.0.0/12 ikke det mest optimale, da det begrænser os på antallet af netværk (fra 16 til 31) for bygninger, og der er også fjerntliggende kontorer, som også skal have tildelt netværksblokke. En mulig mere optimal løsning kunne være brugen af 10.0.0.0/8 netværk, eller en kombination af 172.16.0.0/12 netværk (for eksempel til servicebehov og servere) og 10.0.0.0/8 (til bruger-netværk).
Generelt er fremgangsmåden for tildeling af IP-netværk også modulær, og det er ønskeligt at følge reglerne for sammenlægning af subnetværk til et summary-netværk på distributionsniveauer samt på grænseroutere i fjerntliggende filialer. Dette gøres af flere grunde:
- for at minimere routingtabellerne på routerne
- for at minimere kontroltrafik af routingprotokoller (forskellige update-beskeder, ved utilgængelighed af indlejrede subnetter)
- for at forenkle administrationen og forbedre læsbarheden af L3-netværk
Selvom det skal nævnes, at moderne routeres kapacitet er langt højere end dem, der var for 15-20 år siden, og de kan opbevare større routingtabeller i deres RAM, og forholdet mellem pris og båndbredde for kommunikationskanaler er faldet sammenlignet med priserne i tiden med udbredt brug af E1/T1-strømme (G.703).
Konklusion
Venner, i denne artikel har jeg forsøgt at kortlægge de grundlæggende principper for design af campusnetværk så kort som muligt. Ja, der blev en del materiale, og det var uden at berøre emner som:
- organisationen af virksomhedens grænse (og det er en separat historie med sine egne switches, grænse-routers, firewalls, IPS/IDS systemer, DMZ, VPN og andre ting)
- organisationen af Wi-Fi netværk
- organisationen af VoIP netværk
- organisationen af datacentre
- sikkerhed (og det er også en helt egen verden, som ikke kun er omfattende, men også har krav, der kan overstige dem for design af ren netværksinfrastruktur)
- energi
- listen kan fortsætte og fortsætte
Faktisk er design og opbygning af virksomhedens netværk en ret krævende opgave, der kræver meget tid og ressourcer.
Men jeg håber, at min artikel vil hjælpe dig med at evaluere og få en grundlæggende forståelse af, hvordan du kan tackle denne opgave.
Dette er langt fra den sidste artikel om , så hold øje med opdateringer (, , , )!
- Telefoni:
- Kabelsystem mellem bygninger:
- 3-niveau netværk opdeles i:
Kilde: habr.com
