

I anledning af starten på kurset har forberedt en oversættelse af endnu et nyttigt materiale til dig.
Huffman-kodning er en datakomprimeringsalgoritme, der formulerer hovedideen om filkomprimering. I denne artikel vil vi tale om faste og variable længder, unikt dekodérbare koder, præfiksregler og opbygning af Huffman-træet.
Vi ved, at hvert tegn gemmes som en sekvens af 0 og 1 og optager 8 bit. Dette kaldes faste længder, da hvert tegn bruger et ensartet, fast antal bit til at gemme.
Antag, at der er en tekst. Hvordan kan vi reducere den plads, der kræves for at gemme ét tegn?
Hovedideen er at anvende variable længder. Vi kan udnytte det faktum, at nogle tegn i teksten optræder hyppigere end andre (), for at udvikle en algoritme, der vil repræsentere den samme sekvens af tegn med færre bit. Ved kodning af variable længder tildeler vi tegnene et varierende antal bit, afhængigt af hvor ofte de optræder i den givne tekst. I sidste ende kan nogle tegn blot optage 1 bit, mens andre optager 2, 3 eller flere. Problemet med kodning af variable længder ligger kun i den efterfølgende dekodering af sekvensen.
Hvordan kan vi, ved at kende sekvensen af bits, dekode den entydigt?
Lad os se på strengen »aabacdab«. Den har 8 tegn, og ved kodning af faste længder kræves der 64 bit til at gemme den. Vi bemærker, at hyppigheden af tegnene »a«, »b«, »c« og »d« er henholdsvis 4, 2, 1, 1. Lad os prøve at repræsentere den »aabacdab« med færre bit ved at bruge det faktum, at »a« optræder oftere end »b«., og »b«. optræder oftere end ‘c’ og »d«Vi starter med at kode »a« ved hjælp af én bit, lig med 0, »b«. tildele vi den to-bits kode 11, og med tre bits 100 og 011 koder vi ‘c’ og »d«.
I sidste ende får vi:
en
0
b
11
c
100
d
011
Dermed vil vi kode strengen »aabacdab« som 00110100011011 (0|0|11|0|100|011|0|11), ved at bruge de koder, der er præsenteret ovenfor. Men det primære problem vil være i dekoderingen. Når vi prøver at dekode strengen 00110100011011, får vi et tvetydigt resultat, da den kan repræsenteres som:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
osv.
For at undgå denne tvetydighed skal vi sikre, at vores kodning opfylder et begreb som præfikregel, hvilket i sin tur indebærer, at koderne kun kan dekodes på én unik måde. Præfikreglen sikrer, at ingen kode er et præfiks for en anden. Med 'kode' forstås de bits, der anvendes til at repræsentere et bestemt symbol. I det ovenstående eksempel 0 – er et præfiks 011, hvilket overtræder præfikreglen. Så hvis vores koder opfylder præfikreglen, kan dekodningen foretages entydigt (og omvendt).
Lad os tage et kig på det ovenstående eksempel igen. Denne gang tildeler vi symbolerne »a«, »b«, »c« og »d« koder, der opfylder præfikreglen.
en
0
b
10
c
110
d
111
Ved brug af sådan kodning vil strengen »aabacdab« blive kodet som 00100100011010 (0|0|10|0|100|011|0|10)Men en 00100100011010 og vi vil allerede kunne dekode entydigt og komme tilbage til vores oprindelige streng »aabacdab«.
Huffman-kodning
Nu, når vi har forstået kodning med variabel længde og præfikreglen, lad os tale om Huffman-kodning.
Metoden er baseret på opbygningen af binære træer. I den kan en node være enten en blad- eller en intern node. Oprindeligt anses alle noder for at være blade (endelige), som repræsenterer selve symbolet og dets vægt (dvs. frekvensen af forekomsten). Interne noder indeholder vægten af symbolet og henviser til to nederlagsnoder. Efter almindelig praksis repræsenterer bit "0" at følge den venstre gren, og "1" – den højre. I et fuldt træ N er der blade og N-1 interne noder. Det anbefales at kassere ubrugte symboler, når Huffman-træet bygges for at opnå koder af optimal længde.
Vi vil bruge en prioritetskø til at opbygge Huffman-træet, hvor noden med den laveste frekvens får højeste prioritet. Nedenfor beskrives trinnene i opbygningen:
- Opret en bladnode for hvert symbol, og tilføj dem til prioritetskøen.
- Så længe der er mere end én blad i køen, gør følgende:
- Fjern de to noder med højeste prioritet (den laveste frekvens) fra køen;
- Opret en ny intern node, hvor disse to noder vil være efterkommere, og forekomstfrekvensen vil være lig med summen af frekvenserne for disse to noder.
- Tilføj den nye node til prioritetskøen.
- Den eneste tilbageværende node vil være roden, hvormed opbygningen af træet afsluttes.
Lad os antage, at vi har en tekst, der kun består af tegn «a», «b», «c», «d» og ‘e’, og hyppigheden af deres forekomst er henholdsvis 15, 7, 6, 6 og 5. Nedenfor er illustrationer, der viser trinene i algoritmen.
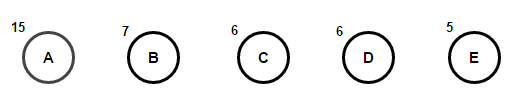
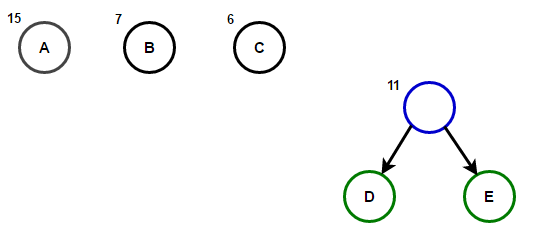
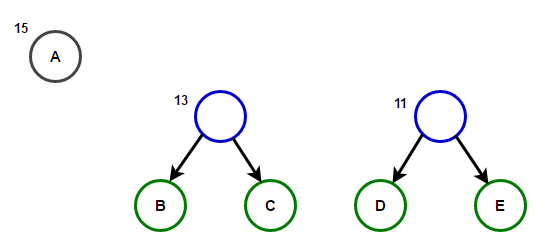
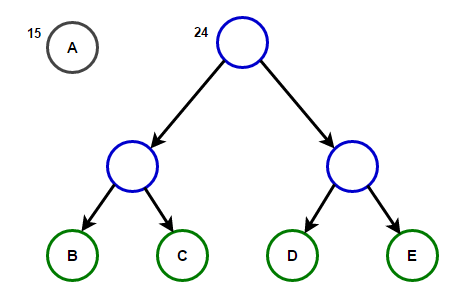
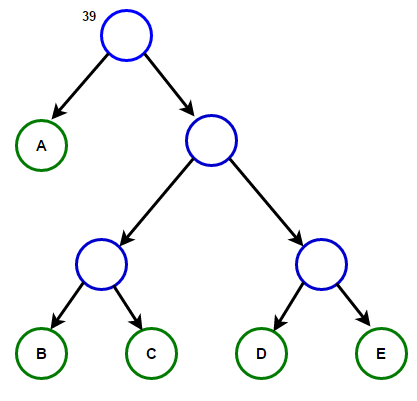
Stien fra roden til enhver terminalnode vil gemme den optimale præfiks kode (også kendt som Huffman-koden), der svarer til det tegn, der er knyttet til denne terminalnode.
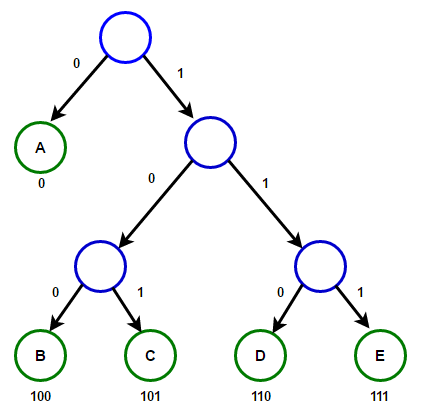
Huffman-træ
Nedenfor finder du implementeringen af Huffman-komprimeringsalgoritmen i C++ og Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// En trænode
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Gennemgå Huffman-træet og gem Huffman-koder
// i et kort.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// fundet et bladnode
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Gennemgå Huffman-træet og afkode den kodede streng
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// fundet et bladnode
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Bygger Huffman-træet og huffmanCode og afkoder givet inputtekst
public static void buildHuffmanTree(String text)
{
// tælle frekvens af forekomst af hvert tegn
// og gemme det i et kort
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Oprette en prioritetskø for at gemme levende noder i Huffman-træet
// Bemærk at det højeste prioriterede element har laveste frekvens
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Oprette en bladnode for hvert tegn og tilføje det
// til prioritetskøen.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// Gør indtil der er mere end en node i køen
while (pq.size() != 1)
{
// Fjern de to noder med højeste prioritet
// (laveste frekvens) fra køen
Node left = pq.poll();
Node right = pq.poll();
// Opret en ny intern node med disse to noder som børn
// og med frekvens lig med summen af de to noders
// frekvenser. Tilføj den nye node til prioritetskøen.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// roden gemmer pointeren til roden af Huffman-træet
Node root = pq.peek();
// Gennemgå Huffman-træet og gemme Huffman-koderne i et kort
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// print Huffman-koderne
System.out.println("Huffman Codes are :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nOriginal string was :\n" + text);
// print kodet streng
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nEncoded string is :\n" + sb);
// Gennemgå Huffman-træet igen, og denne gang
// afkode den kodede streng
int index = -1;
System.out.println("\nDecoded string is: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffman coding is a data compression algorithm.";
buildHuffmanTree(text);
}
}Bemærk: Den hukommelse, som den indgående streng bruger, udgør 47 * 8 = 376 bit, mens den kodede streng kun optager 194 bit, dvs. data komprimeres med ca. 48%. I C++-programmet ovenfor bruger vi klassen string til at gemme den kodede streng for at gøre programmet læsbart.
Da effektive datastrukturer til prioritetskøer kræver O(log(N)) tid til indsættelse, og i et komplet binært træ med blade er der N 2N-1 noder, og Huffman-træet er et komplet binært træ, så algoritmen arbejder på O(Nlog(N)) tid, hvor – antallet af symboler. N en.wikipedia.org/wiki/Huffman_coding
Kilder:
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish