

Hvis du administrerer en virtuel infrastruktur baseret på VMware vSphere (eller en hvilken som helst anden teknologistak), hører du sikkert ofte klager fra brugerne: "Den virtuelle maskine kører langsomt!" I denne artikelcyklus vil jeg gennemgå præstationsmetrikker og forklare, hvad der "bremser" og hvordan man får det til at køre mere glat.
Jeg vil overveje følgende aspekter af præstationen for virtuelle maskiner:
- CPU,
- RAM,
- DISK,
- Netværk.
Lad mig starte med CPU.
For at analysere præstationen har vi brug for:
- vCenter Performance Counters – præstationsmålere, hvis grafikker kan ses gennem vSphere Client. Informationen fra disse målere er tilgængelig i enhver version af klienten ("tyk" klient i C#, web-klient i Flex og web-klient i HTML5). I disse artikler vil vi bruge skærmbilleder fra C#-klienten, simpelthen fordi de ser bedre ud i miniature:)
- ESXTOP – et værktøj, der startes fra kommandolinjen på ESXi. Med dette værktøj kan man få værdierne for præstationsmålere i realtid eller eksportere disse værdier over en bestemt periode til en .csv-fil for videre analyse. Jeg vil senere fortælle mere om dette værktøj og give nogle nyttige links til dokumentation og artikler om emnet.
Lidt teori
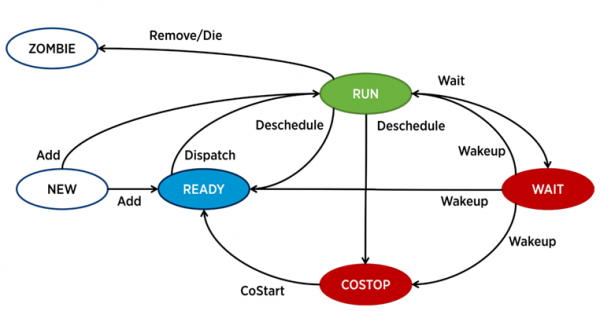
I ESXi er det en separat proces - world i VMware's terminologi - der er ansvarlig for arbejdet af hver vCPU (kerne i den virtuelle maskine). Der findes også serviceprocesser, men de er mindre interessante set ud fra et præstationsanalyseperspektiv.
En proces i ESXi kan befinde sig i en af fire tilstande:
- Kør – processen udfører noget nyttigt arbejde.
- Vent – processen udfører ikke noget arbejde (idle) eller venter på input/output.
- Costop – en tilstand, der opstår i multikernede virtuelle maskiner. Den opstår, når hypervisorens CPU-planlægger (ESXi CPU Scheduler) ikke kan planlægge samtidig udførelse på serverens fysiske kerner for alle aktive kerner i den virtuelle maskine. I den fysiske verden arbejder alle processorkerner parallelt, den gæst OS inden i VM'en forventer en lignende adfærd, så hypervisoren bliver nødt til at bremse VM'ens kerner, som har mulighed for at afslutte takten hurtigere. I moderne versioner af ESXi bruger CPU-planlæggeren en mekanisme, der kaldes relaxed co-scheduling: hypervisoren vurderer forskellen mellem den
- Klar – processen går ind i denne tilstand, når hypervisoren ikke har mulighed for at allokere ressourcer til dens udførelse. Høje værdier for ready kan forårsage ydeevneproblemer for VM'en.
Nøglemålinger for CPU-ydeevne for den virtuelle maskine
CPU-brug, %. Viser procentdelen af CPU-brug i en given periode.
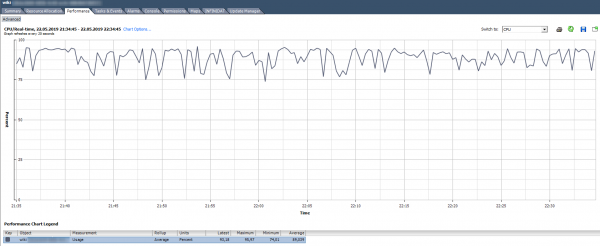
Hvordan analyserer man? Hvis VM'en stabilt bruger CPU på 90% eller har spidser op til 100%, så har vi problemer. Problemerne kan ikke kun udtrykkes i "langsom" performance af applikationen inden i VM'en, men også i utilgængeligheden af VM'en over netværket. Hvis overvågningssystemet viser, at VM'en periodisk falder ud, så vær opmærksom på spidserne i grafen for CPU-brug.
Der er en standard Alarm, der viser CPU-belastningen for den virtuelle maskine:
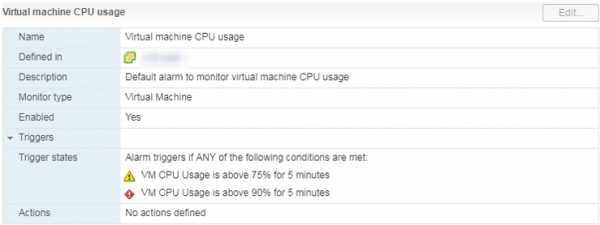
Hvad skal man gøre? Hvis VM'ens CPU-brug konstant overstiger grænserne, så kan man overveje at øge antallet af vCPU'er (desværre hjælper dette ikke altid) eller flytte VM'en til en server med mere potente processorer.
CPU-brug i MHz
I grafikkerne på vCenter kan man kun se brugen i % for den samlede virtuelle maskine; der er ingen grafer for individuelle kerner (i Esxtop er der % værdier for kerner). For hver kerne kan man se brugen i MHz.
Hvordan analyserer man? Det kan ske, at applikationen ikke er optimeret til en multi-core arkitektur: den bruger 100% af kun én kerne, mens de andre forbliver inaktive. For eksempel, med standardindstillingerne for MS SQL-backup, kører processen kun på én kerne. Resultatet er, at backupprocessen hæmmes ikke på grund af langsom diskhastighed (det var det, som brugeren oprindeligt klagede over), men fordi processoren ikke kan klare belastningen. Problemet blev løst ved at ændre indstillingerne: backupen begyndte at køre parallelt i flere filer (dermed i flere processer).
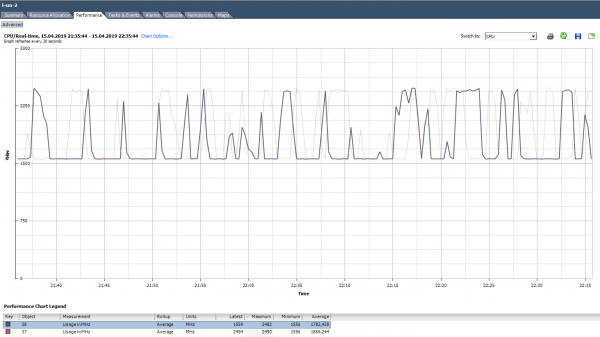
Eksempel på ujævn belastning af kerner.
Der kan også opstå situationer (som i grafen ovenfor), hvor kernerne er ujævnt belastet og nogle af dem har spidser på 100%. Som ved belastning af kun én kerne, vil alarmen for CPU-brug ikke gå i gang (den gælder for hele VM'en), men der vil være problemer med ydeevnen.
Hvad skal man gøre? Hvis softwaren i den virtuelle maskine belaster kernerne ujævnt (kun bruger én kerne eller en del af kernerne), er der ingen mening med at øge antallet af dem. I sådanne tilfælde er det bedre at flytte VM'en til en server med mere kraftfulde processorer.
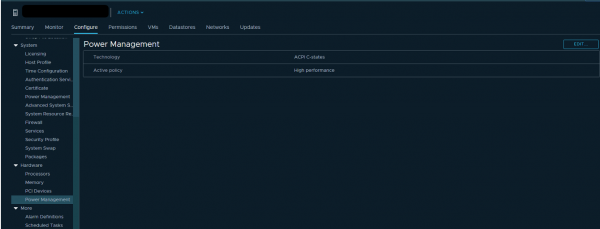
Du kan også prøve at tjekke indstillingerne for energiforbrug i serverens BIOS. Mange administratorer aktiverer High Performance-tilstand i BIOS og deaktiverer dermed energispareteknologierne C-states og P-states. Moderne Intel-processorer bruger Turbo Boost-teknologi, der øger frekvensen for individuelle kerner på bekostning af andre kerner. Men dette fungerer kun, når energispareteknologierne er tændt. Hvis vi deaktiverer dem, kan processoren ikke reducere energiforbruget for de kerner, der ikke er belastet.
VMware anbefaler ikke at deaktivere energispareteknologier på serverne, men at vælge tilstande, der maksimalt giver hypervisoren kontrol over energiforbruget. I indstillingerne for energiforbrug i hypervisoren skal der vælges High Performance.
Hvis du i din infrastruktur har separate VM'er (eller kerner af VM'er), der kræver en højere CPU-frekvens, kan korrekt indstilling af energiforbruget betydeligt forbedre deres ydeevne.
CPU Ready (Readiness)
Hvis værtsmaskinens kerne (vCPU) er i tilstanden Ready, udfører den ikke noget nyttigt arbejde. Denne tilstand opstår, når hypervisoren ikke kan finde en ledig fysisk kerne, som den kan tildele vCPU-processen fra den virtuelle maskine.
Hvordan analyserer man? Generelt, hvis kernerne af den virtuelle maskine er i tilstanden Ready i mere end 10 % af tiden, vil du bemærke problemer med ydeevnen. Simple sagt, bruger VM'en mere end 10 % af tiden på at vente på tilgængeligheden af fysiske ressourcer.
I vCenter kan du se 2 målere relateret til CPU Ready:
- Readiness,
- Ready.
Værdierne for begge målere kan ses både for hele VM'en og for de enkelte kerner.
Readiness viser værdien direkte i procent, men kun i Real-time (data fra den sidste time, måleinterval på 20 sekunder). Denne måler bør kun bruges til at finde problemer 'on-the-fly'.
Værdierne for Ready-måleren kan også ses i historisk perspektiv. Dette er nyttigt til at identificere mønstre og til dybere analyse af problemer. For eksempel, hvis den virtuelle maskine begynder at have ydeevneproblemer på et bestemt tidspunkt, kan man sammenligne intervallerne med forhøjede CPU Ready-værdier med den samlede belastning på serveren, hvor denne VM kører, og tage skridt til at reducere belastningen (hvis DRS ikke har kunne klare det).
Ready, i modsætning til Readiness, vises ikke i procent, men i millisekunder. Dette er en summationsmåler, hvilket betyder, at den viser, hvor meget tid den virtuelle maskines kerne har været i tilstanden Ready i måleperioden. Dette kan konverteres til procent med en simpel formel:
(CPU ready summation value / (chart default update interval in seconds * 1000)) * 100 = CPU ready %
For eksempel, for VM'en på grafikken nedenfor, vil den maksimale Ready-værdi for hele den virtuelle maskine se således ud:

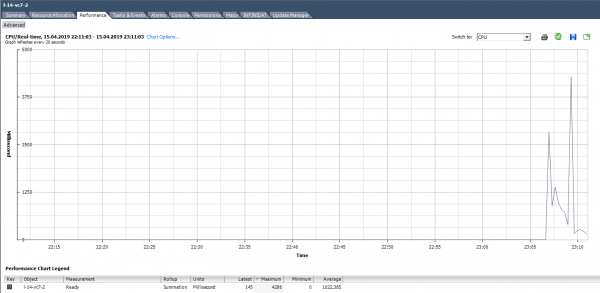
Når du beregner værdien for Ready i procent, er der to punkter, man skal være opmærksom på:
- Værdien for Ready for hele VM'en er summen af Ready for kernerne.
- Måleinterval. For Real-time er det 20 sekunder, mens det for dagsgrafikker f.eks. er 300 sekunder.
Ved aktiv fejlsøgning kan disse simple punkter nemt blive overset, hvilket kan føre til spild af værdifuld tid på at løse ikke-eksisterende problemer.
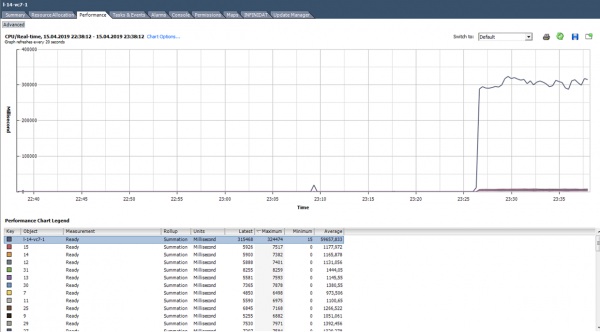
Vi beregner Ready baseret på dataene fra grafen nedenfor. (324474/(20*1000))*100 = 1622% for hele VM'en. Hvis vi ser på kernerne, virker det ikke så skræmmende: 1622/64 = 25% per kerne. I dette tilfælde er det ret nemt at opdage en falde: værdien af Ready er urealistisk. Men hvis vi taler om 10-20% for hele VM'en med flere kerner, kan værdien per kerne være inden for det normale område.
Hvad skal man gøre? En høj Ready-værdi indikerer, at serveren mangler processorressourcer til at fungere korrekt for de virtuelle maskiner. I denne situation er der ikke andet at gøre end at reducere overforbruget af CPU (vCPU:pCPU). Det er åbenlyst, at dette kan opnås ved at reducere parametrene for de eksisterende VM'er eller ved at migrere nogle VM'er til andre servere.
Co-stop
Hvordan analyserer man? Denne tæller har også typen Summation og oversættes til procent på samme måde som Ready:
(CPU co-stop summation value / (chart default update interval in seconds * 1000)) * 100 = CPU co-stop %
Her skal der også tages hensyn til antallet af kerner i VM'en og det måleinterval.
I co-stop-tilstand udfører kernen ikke nyttigt arbejde. Ved korrekt dimensionering af VM'en og normal belastning af serveren bør co-stop tælleren være tæt på nul.
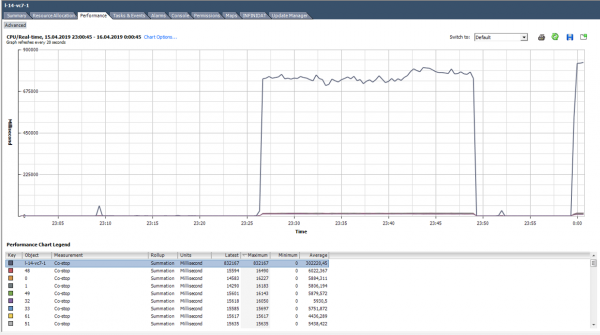
I dette tilfælde er belastningen tydeligvis unormalt :)
Hvad skal man gøre? Hvis der kører flere VM'er med mange kerner på en hypervisor og der er overforbrug af CPU, kan co-stop tælleren stige, hvilket vil føre til præstationsproblemer for disse VM'er.
Co-stop vil også stige, hvis der for aktive kerner i én VM bruges tråde på et enkelt fysisk kerne i serveren med aktiveret hyper-threading. Denne situation kan opstå, hvis VM'en har flere kerner, end der fysisk findes på serveren, hvor den kører, eller hvis VM'en har indstillingen 'preferHT' aktiveret. Man kan læse om denne indstilling .
For at undgå præstationsproblemer for VM'er på grund af høj co-stop, bør du vælge størrelsen på VM'en i overensstemmelse med anbefalingerne fra softwareleverandøren, der kører på denne VM, og i forhold til de fysiske servermuligheder, hvor VM'en kører.
Tilføj ikke kerner for sikkerheds skyld, da det kan forårsage præstationsproblemer ikke kun for VM'en selv, men også for dens naboer på serveren.
Andre nyttige CPU-metre
Kør – hvor lang tid (ms) vCPU'en var i RUN-tilstand i måleperioden, dvs. faktisk udførte nyttigt arbejde.
Idle – hvor lang tid (ms) i measurementsperioden vCPU var i inaktiv tilstand. Høje værdier af Idle er ikke et problem, det betyder bare, at vCPU'en ikke havde 'noget at lave'.
Vent – hvor lang tid (ms) i measurementsperioden vCPU var i Wait-tilstand. Da IDLE inkluderes i denne tæller, indikerer høje Wait-værdier heller ikke nødvendigvis et problem. Men hvis IDLE er lav, når Wait er høj, så har VM'en ventet på, at I/O-operationer skulle fuldføres, og det kan betyde, at der er problemer med diskens ydeevne eller nogle af VM'ens virtuelle enheder.
Max begrænset – hvor lang tid (ms) i measurementsperioden vCPU var i Ready-tilstand på grund af de anvendte ressourcegrænser. Hvis ydelsen er uforklarligt lav, kan det være nyttigt at kontrollere værdien af denne tæller og CPU-grænsen i VM'ens indstillinger. VM'en kan være underlagt grænser, som du ikke er klar over. For eksempel kan det ske, når VM'en er klonet fra en skabelon, hvor en CPU-grænse var indstillet.
Swap ventetid – hvor lang tid vCPU har ventet på operationer med VMkernel Swap i measurementsperioden. Hvis værdien af denne tæller er over nul, er der bestemt ydeevneproblemer med VM'en. Vi vil diskutere SWAP mere detaljeret i artiklen om hukommelsestællere.
ESXTOP
Hvis ydeevnetællerne i vCenter er gode til at analysere historiske data, er det bedre at analysere problemer i realtid i ESXTOP. Her præsenteres alle værdierne i et færdigt format (du skal ikke oversætte noget), og den minimale measurementperiode er 2 sekunder.
ESXTOP-skærmen for CPU åbnes med tasten 'c' og ser sådan ud:

For nemheds skyld kan man kun lade virtuelle maskiners processer være synlige ved at trykke på Shift-V.
For at se metrikkerne for de enkelte kerner i VM'en, tryk 'e' og indtast GID for den pågældende VM (30919 på skærmbilledet nedenfor):
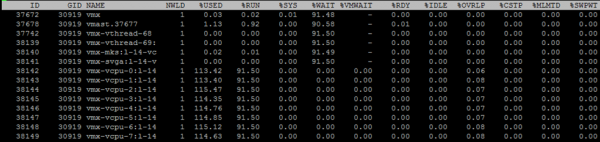
Jeg vil kort gennemgå de standardkolonner, der vises. Yderligere kolonner kan tilføjes ved at trykke 'f'.
NWLD (Number of Worlds) – antallet af processer i gruppen. For at udvide gruppen og se metrikkerne for hver proces (f.eks. for hver kerne i en multikern VM), tryk 'e'. Hvis der er mere end én proces i gruppen, er metrikværdierne for gruppen summen af metrikværdierne for de enkelte processer.
%USED – hvor mange CPU-cyklusser serveren bruger til en proces eller gruppe af processer.
%RUN – hvor lang tid processen i måleperioden har været i RUN-tilstand, dvs. udførte nyttigt arbejde. Forskellen fra %USED er, at det ikke tager højde for hyper-threading, frekvensjustering og den tid, der er brugt på systemopgaver (%SYS).
%SYS – tiden brugt på systemopgaver, for eksempel: behandling af afbrydelser, input/output, netværksarbejde osv. Værdien kan være høj, hvis der er meget input/output på VM.
%OVRLP – hvor længe den fysiske kerne, som processen på VM kører på, har brugt tid på andre processers opgaver.
Disse metrikker relaterer til hinanden som følger:
%USED = %RUN + %SYS — %OVRLP.
Normalt er metrikken %USED mere informativ.
%WAIT – hvor lang tid processen i måleperioden har været i Wait-tilstand. Inkluderer IDLE.
%IDLE – hvor lang tid processen i måleperioden har været i IDLE-tilstand.
%SWPWT – hvor lang tid vCPU har ventet på VMkernel Swap-operationer i måleperioden.
%VMWAIT – hvor lang tid vCPU har været i ventetilstand (normalt input/output) i måleperioden. Der findes ikke en tilsvarende tæller i vCenter. Høje værdier indikerer problemer med input/output på VM.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Hvis VM ikke bruger VMkernel Swap, er det fornuftigt at se på %VMWAIT ved analyse af ydeevneproblemer, da denne metrik ikke tager højde for tiden, hvor VM ikke gjorde noget (%IDLE).
%RDY – hvor lang tid processen i måleperioden har været i Ready-tilstand.
%CSTP – hvor lang tid processen i måleperioden har været i costop-tilstand.
%MLMTD – hvor lang tid vCPU har været i Ready-tilstand på grund af en indstillet ressourcegrænse i måleperioden.
%WAIT + %RDY + %CSTP + %RUN = 100% – kernen på VM er hele tiden i en af disse fire tilstande.
CPU på hypervisoren
I vCenter er der også CPU-ydeevnen tællere for hypervisoren, men de er ikke interessante – det er blot summen af tællerne for alle VM'er på serveren.
Det er nemmest at se CPU-tilstanden på serveren under fanen Oversigt:
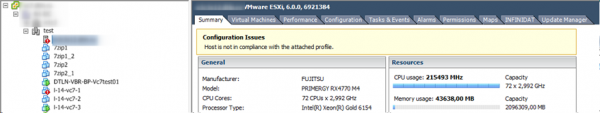
For en server, ligesom for en virtuel maskine, er der en standard Alarm:
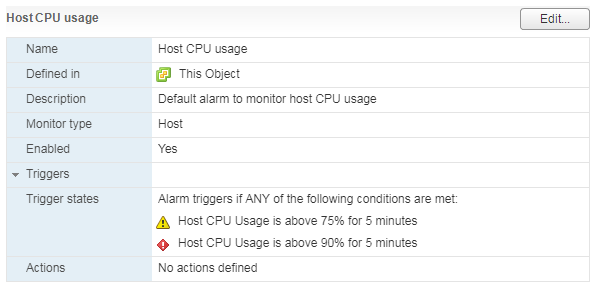
Ved høj CPU-belastning på serveren begynder VM'er, der kører på den, at få ydeevneproblemer.
I ESXTOP vises CPU-belastningen på serveren øverst på skærmen. Udover den standard CPU-belastning, som er lidt informativ for hypervisorer, er der tre andre målepunkter:
CORE UTIL(%) – belastningen på kernen af den fysiske server. Denne tæller viser, hvor meget tid kernen har udført arbejde i måleperioden.
PCPU UTIL(%) – hvis hyper-threading er aktiveret, er der to strømmme (PCPU) pr. fysisk kerne. Dette målepunkt viser, hvor meget tid hver strøm har udført arbejde.
PCPU USED(%) – svarer til PCPU UTIL(%), men tager højde for frekvensjustering (enten nedsættelse af kernenes frekvens for energibesparelser eller forøgelse af kernenes frekvens gennem Turbo Boost-teknologi) og hyper-threading.
PCPU_USED% = PCPU_UTIL% * effektiv kernefrekvens / nominelle kernefrekvens.
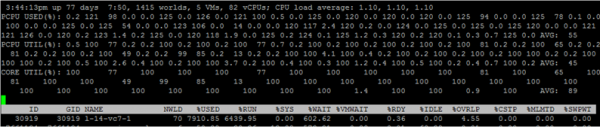
I dette skud er værdien FORBRUGT over 100% for nogle kerner på grund af Turbo Boost, da kernen kører hurtigere end den nominelle frekvens.
Som en bemærkning om, hvordan hyper-threading tages i betragtning. Hvis processer udføres 100% af tiden på begge strømmme af den fysiske kerne på serveren, og kernen kører ved nominelle frekvenser, så:
- CORE UTIL for kernen vil være 100%,
- PCPU UTIL for begge strømmme vil være 100%,
- PCPU USED for begge strømmme vil være 50%.
Hvis begge strømmme ikke arbejdede 100% af tiden i måleperioden, så deles PCPU USED for kernerne halvvejs i de perioder, hvor strømmene arbejdede parallelt.
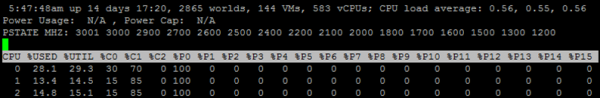
I ESXTOP er der også en skærm med CPU-serverens energiforbrugsparametre. Her kan man se, om serveren bruger energibesparende teknologier: C-states og P-states. Kaldes med tasten «p»:
Standard CPU-ydeevneproblemer
Til slut vil jeg kort gennemgå typiske årsager til CPU-ydeevneproblemer for VM og give nogle hurtige råd til løsning:
Manglende kernefrekvens. Hvis det ikke er muligt at flytte VM til mere effektive kerner, kan man forsøge at ændre energiforbrugsindstillingerne, så Turbo Boost fungerer mere effektivt.
Forkert sizing af VM (for mange/få kerner). Hvis der er for få kerner, vil VM's CPU-belastning være høj. Hvis der er for mange, vil der være høj co-stop.
Høj CPU-overtegnelse på serveren. Hvis der er høj Ready på VM, så sænk CPU-overtegnelsen.
Forkert NUMA-topologi på store VM. NUMA-topologi, som VM (vNUMA) ser, skal svare til NUMA-topologien for serveren (pNUMA). Om diagnosticering og mulige løsninger på dette problem er der skrevet, for eksempel i bogen . Hvis du ikke ønsker at dykke dybt ned, og du ikke har licensbegrænsninger for OS, der er installeret på VM'en, så lav mange virtuelle sockets med et enkelt kerne. Du vil ikke tabe meget 🙂
Det var alt om CPU for nu. Stil spørgsmål. I den næste del vil jeg fortælle om RAM.
Nyttige links
Kilde: habr.com
