

Tidspunktsdatabase (TSDB, time series database) i Prometheus 2 er et fremragende eksempel på en ingeniørløsning, der tilbyder betydelige forbedringer sammenlignet med lageret v2 i Prometheus 1, hvad angår dataindsamlingshastighed og forespørgselsydelse samt ressourceeffektivitet. Vi implementerede Prometheus 2 i Percona Monitoring and Management (PMM), og jeg fik mulighed for at undersøge ydeevnen af Prometheus 2 TSDB. I denne artikel vil jeg dele resultaterne af disse observationer.
Gennemsnitlig arbejdsbyrde i Prometheus
For dem, der er vant til at arbejde med databasesystemer af primær betydning, er den typiske arbejdsbyrde i Prometheus ganske interessant. Dataindsamlingshastigheden stræber mod en stabil værdi: normalt sender de tjenester, du overvåger, cirka det samme antal målinger, og infrastrukturen ændrer sig relativt langsomt.
Informationsforespørgsler kan komme fra forskellige kilder. Nogle af dem, såsom alarmer, stræber også mod en stabil og forudsigelig værdi. Andre, såsom brugerforespørgsler, kan forårsage spidser, selvom dette ikke er typisk for størstedelen af belastningen.
Belastningstest
Under testen fokuserede jeg på evnen til at indsamle data. Jeg satte Prometheus 2.3.2 op, kompilering med Go 1.10.1 (som en del af PMM 1.14) på en service fra Linode, ved hjælp af dette script: . For at generere den mest realistiske belastning, ved hjælp af denne startede jeg flere MySQL-noder med en autentisk belastning (Sysbench TPC-C Test), hver af dem emulerede 10 Linux/MySQL-noder.
Alle nedenstående tests blev udført på en Linode-server med otte virtuelle kerner og 32 GB hukommelse, hvor 20 belastningssimulationer kørte for at overvåge to hundrede MySQL-instanser. Eller, i Prometheus-termer, 800 targets, 440 scrapes per sekund, 380 tusinde samples per sekund og 1,7 millioner aktive tidsserier.
Design
Den almindelige tilgang for traditionelle databaser, herunder den, som Prometheus 1.x brugte, er . Hvis den ikke er tilstrækkelig til at håndtere belastningen, vil du opleve store forsinkelser, og visse forespørgsler vil ikke blive udført. Hukommelsesbrugen i Prometheus 2 konfigureres via nøglen storage.tsdb.min-block-duration, som bestemmer, hvor længe optegnelser vil blive gemt i hukommelsen, før de skrives til disk (som standard 2 timer). Den nødvendige mængde hukommelse afhænger af antallet af tidsserier, labels og intensiteten af dataindsamling i summen med den rene indkommende strøm. I forhold til diskplads stræber Prometheus efter at bruge 3 bytes per optegnelse (sample). På den anden side er hukommelseskravene betydeligt højere.
Selvom der er mulighed for at konfigurere blokstørrelsen, anbefales det ikke at justere den manuelt, så du står over for nødvendigheden af at give Prometheus så meget hukommelse, som den beder om til din arbejdsbyrde.
Hvis der ikke er tilstrækkelig hukommelse til at understøtte den indkommende strøm af metrikker, vil Prometheus fejle med out of memory eller blive ramt af OOM killer.
At tilføje swap for at forsinke tidspunktet for nedbruddet, når Prometheus løber tør for hukommelse, hjælper ikke meget, fordi brugen af denne funktion medfører eksplosiv hukommelsesforbrug. Jeg tror, det har at gøre med Go, dens garbage collector og hvordan den fungerer med swap.
En anden interessant tilgang er at indstille tidspunkter for hovedblokskrift til disk i en bestemt tid, i stedet for at tælle fra tidspunktet for processtart.
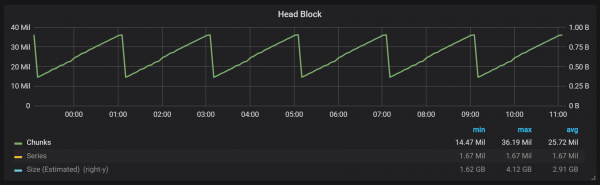
Som du kan se fra grafen, sker skrivninger til disk hver anden time. Hvis du ændrer indstillingen for min-block-duration til en time, vil disse skrivninger finde sted hver time, startende efter en halv time.
Hvis du vil bruge denne og andre grafer i din Prometheus-installation, kan du bruge dette . Det blev udviklet til PMM, men med små ændringer passer det til enhver Prometheus-installation.
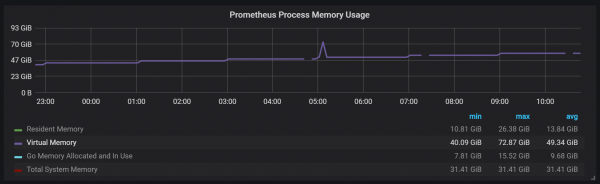
Vi har en aktiv blok kaldet head block, som opbevares i hukommelsen; blokke med ældre data er tilgængelige via mmap(). Dette fjerner behovet for at konfigurere cachen separat, men betyder også, at du skal efterlade tilstrækkelig plads til systemcache, hvis du vil foretage forespørgsler på data, der er ældre end dem, som head block kan indeholde.
Og det betyder også, at Prometheus' virtuelle hukommelsesanvendelse vil se ret høj ud, hvilket ikke er noget at bekymre sig om.
Endnu et interessant designelement er brugen af WAL (write ahead log). Som det fremgår af dokumentationen for lagringen, anvender Prometheus WAL for at undgå datatab ved nedbrud. Desværre er de specifikke mekanismer til at sikre datalivdygtighed utilstrækkeligt dokumenterede. Prometheus version 2.3.2 gemmer WAL til disk hver 10. sekund, og denne indstilling kan ikke konfigureres af brugeren.
Kompakteringer (Compactions)
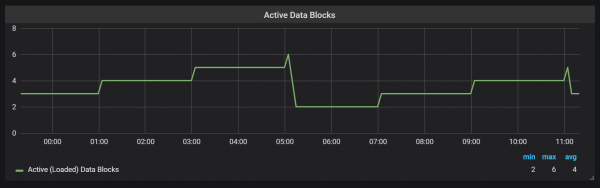
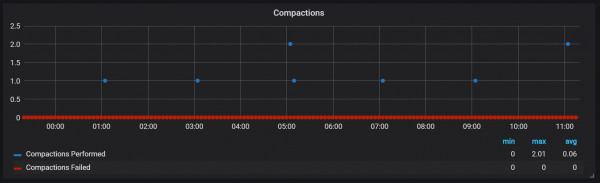
Prometheus TSDB er designet efter modellen for LSM-lagrede databaser (Log Structured Merge — logisk struktureret sammenflydning): head-blokken gemmes periodisk på disk, mens kompakteringsmekanismen samler flere blokke for at undgå scanning af for mange blokke under forespørgsler. Her kan du se antallet af blokke, som jeg har observeret på testsystemet efter en dags belastning.
Hvis du vil vide mere om lagringen, kan du undersøge filen meta.json, som indeholder oplysninger om de eksisterende blokke og hvordan de blev til.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Kompakteringer i Prometheus er knyttet til tidspunktet for at gemme head-blokken på disk. På dette tidspunkt kan flere sådanne operationer finde sted.
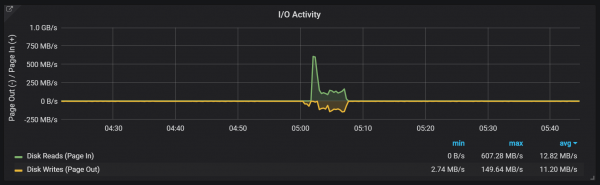
Det ser ud til, at komprimeringen ikke er begrænset på nogen måde og kan forårsage store udsving i disk I/O under udførelsen.
Udsving i CPU-belastning
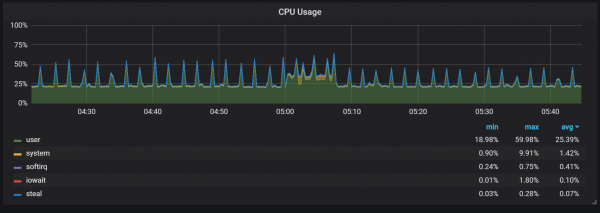
Det påvirker selvfølgelig systemets hastighed negativt og udgør en seriøs udfordring for LSM-lagre: hvordan kan man komprimere for at opretholde høj forespørgsels hastighed uden at forårsage for meget overhead?
Brugen af hukommelse under komprimering ser også temmelig interessant ud.
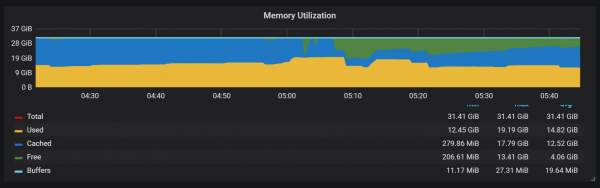
Vi kan se, hvordan størstedelen af hukommelsen efter komprimeringen ændrer tilstand fra Cached til Free: det betyder, at potentielt værdifuld information er blevet fjernet derfra. Det er nysgerrigt, om der bruges fadvice() eller en anden teknik til minimering, eller om det skyldes, at cache er blevet ryddet for blokke, der blev ødelagt under komprimeringen?
Gendannelse efter nedbrud
Gendannelse efter nedbrud tager tid, og det er berettiget. For en indstrømning på en million poster pr. sekund måtte jeg vente omkring 25 minutter, mens gendannelsen fandt sted med en SSD-disk.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Starter Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Begynder at lytte efter forbindelser" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Starter TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="fundet sund blok" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="router præfiks" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="fundet sund blok" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="fundet sund blok" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="fundet sund blok" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="fundet sund blok" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="WAL-korruption registreret; afkorter" err="uventet CRC32 checksum d0465484, ønsker 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB startet"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Indlæser konfigurationsfil" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Afsluttet indlæsning af konfigurationsfil" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Serveren er klar til at modtage webanmodninger."
Hovedproblemet med genoprettelsesprocessen er det høje hukommelsesforbrug. I normale situationer kan serveren stabilt køre med samme mængde hukommelse, men ved et nedbrud kan den muligvis ikke starte op igen på grund af OOM. Den eneste løsning, jeg har fundet, er at deaktivere datainnsamling, starte serveren, lade den genoprette sig, og derefter genstarte med datainnsamlingen aktiveret.
Opvarmning
En anden adfærd, der skal huskes under opvarmning, er forholdet mellem lav ydeevne og højt ressourceforbrug umiddelbart efter opstart. Ved nogle, men ikke alle opstartsforløb, har jeg observeret alvorlig belastning af CPU og hukommelse.
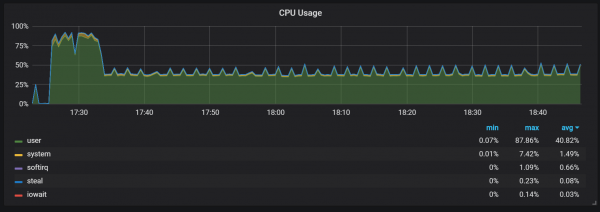
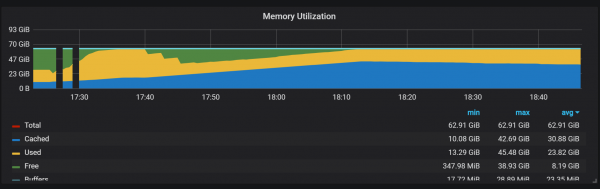
Problemer med hukommelsesforbruget indikerer, at Prometheus ikke kan konfigurere alle indsamlinger fra starten, og nogle oplysninger går tabt.
Jeg har ikke fundet de præcise årsager til den høje belastning på CPU og hukommelse. Jeg formoder, at det hænger sammen med oprettelsen af nye tidsserier i head block med høj frekvens.
Belastningsspidser på CPU
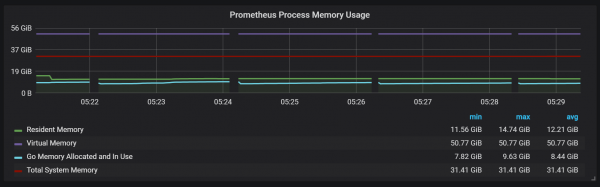
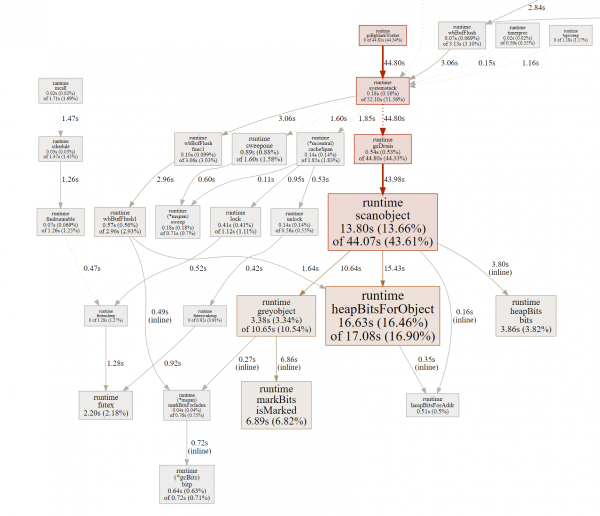
Udover tætningsmidler, der skaber en ganske høj I/O-belastning, har jeg bemærket alvorlige spidser i CPU-belastningen hvert andet minut. Spidserne varer længere ved høj indstrømning, og det ser ud til, at de er forårsaget af Go's garbage collector, da nogle kerner er fuldt belastede.
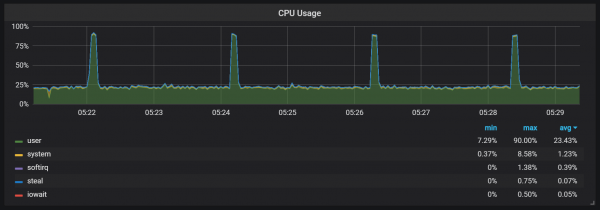
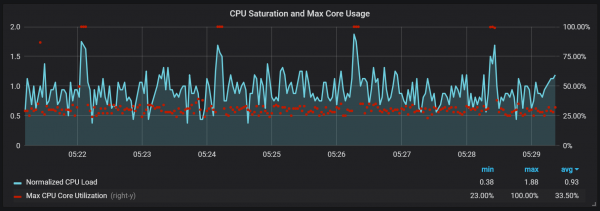
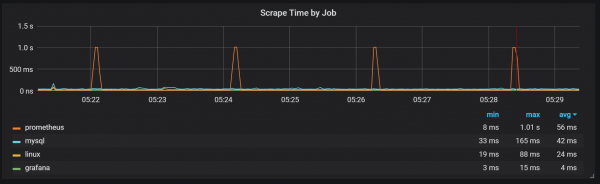
Disse spidser er ikke uden betydning. Det lader til, at når de opstår, bliver den interne indgang og Prometheus-metrikker utilgængelige, hvilket forårsager datatab i disse tidsintervaller.
Det kan også bemærkes, at Prometheus-exportøren stopper i et sekund.
Vi kan se korrelationer med garbage collection (GC).
Konklusion
TSDB i Prometheus 2 fungerer hurtigt, kan håndtere millioner af tidsserier og samtidig tusindvis af indlæsninger pr. sekund ved hjælp af ganske beskeden hardware. CPU-udnyttelse og disk-I/O er også imponerende. Mit eksempel viste op til 200.000 målinger pr. sekund på hver brugt kerne.
Ved planlægning af skalering skal man huske på tilstrækkelige hukommelsesvolumener, og det skal være reel hukommelse. Den mængde hukommelse, jeg observerede, var omkring 5 GB ved 100.000 indlæsninger pr. sekund, hvilket tilsammen med operativsystemets cache gav omkring 8 GB optaget hukommelse.
Selvfølgelig er der stadig meget arbejde tilbage for at tame spidserne i CPU og disk-I/O, og det er ikke overraskende, givet hvor ung TSDB Prometheus 2 stadig er i forhold til InnoDB, TokuDB, RocksDB, WiredTiger, men de havde alle lignende problemer i begyndelsen af deres livscyklus.
Kilde: habr.com
