

Hej, jeg er Dmitrij Logvinenko — Data Engineer i analyseafdelingen hos selskabet «Vezët».
Jeg vil fortælle dig om et fantastisk værktøj til udvikling af ETL-processer — Apache Airflow. Men Airflow er så alsidigt og multifacetteret, at du bør overveje det, selvom du ikke arbejder med data streams, men har behov for at køre visse processer af og til og overvåge deres udførelse.
Og ja, jeg vil ikke kun fortælle, men også vise: programmet indeholder meget kode, skærmbilleder og anbefalinger.
Hvad ser man normalt, når man googler ordet Airflow / Wikimedia Commons
Indholdsfortegnelse
Introduktion
Apache Airflow — den er ligesom Django:
- skrevet i Python,
- har en fremragende admin-interface,
- kan udvides ubegribeligt,
— kun bedre, og virkelig lavet til helt andre formål, nemlig (som skrevet før kataklysmen):
- at starte og overvåge opgaver på et ubegribelig antal maskiner (hvor meget dit Celery/Kubernetes og din samvittighed tillader),
- med dynamisk generering af workflows fra meget letlæselig og forståelig Python-kode
- og muligheden for at forbinde alle databaser og API'er med hinanden ved hjælp af både færdige komponenter og hjemmelavede plugins (som er ekstremt enkle at lave).
Vi bruger Apache Airflow på følgende måde:
- samler data fra forskellige kilder (mange instanser af SQL Server og PostgreSQL, forskellige API'er med applikationsmetrikker, selv 1C) i DWH og ODS (for os er det Vertica og Clickhouse).
- som en avanceret
cron, der starter konsolideringsprocesser på ODS, samt overvåger deres vedligeholdelse.
Indtil for nylig dækkede vores behov en lille server med 32 kerner og 50 GB RAM. I Airflow fungerer:
- mere end 200 DAGs (faktisk workflows, hvor vi har fyldt opgaver),
- i hver i gennemsnit 70 opgaver,
- startes det gode (også i gennemsnit) en gang i timen.
Og om hvordan vi udvidede, vil jeg skrive nedenfor, men lad os nu definere den über-opgave, som vi skal løse:
Der er tre SQL Servere, hver med 50 databaser – instanser af det samme projekt, så strukturen er stort set den samme (næsten overalt, muha-ha-ha), og derfor har hver en tabel kaldet Orders (heldigvis kan en tabel med det navn presses ind i enhver virksomhed). Vi henter data ved at tilføje systemfelter (kilde-server, kilde-database, identifikator for ETL-opgaven) og naivt kaster dem ind i, lad os sige, Vertica.
Lad os komme i gang!
Hoveddelen, den praktiske (og lidt teoretiske)
Hvorfor det er relevant for os (og jer)
Da træerne var store, og jeg var simpelthen SQL-ensætter i en russisk detailhandel, kørte vi ETL-processer aka datastreams ved hjælp af de to værktøjer, vi havde til rådighed:
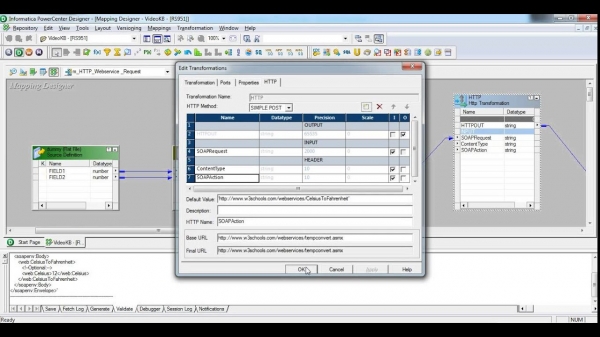
- Informatica Power Center — et ekstremt komplekst system, meget effektivt, med eget hardware og versionskontrol. Jeg brugte gudhjælpemig 1% af dets muligheder. Hvorfor? For det første, den grænseflade stammede fra nullerne og pressede psykisk på os. For det andet, dette værktøj er skabt til ekstremt komplicerede processer, intensiv genbrug af komponenter og andre meget-vigtige-virksomhedstricks. At den koster som en vinge til Airbus A380/år, lad os tie stille om.
Pas på, screenshot kan gøre folk under 30 en smule ondt

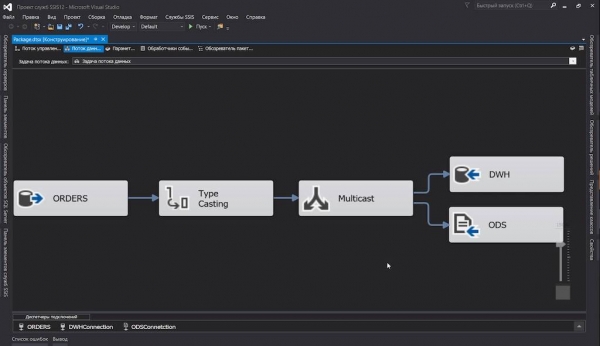
- SQL Server Integration Server — denne fyr brugte vi i vores interne projekter. Nå, virkeligheden er: SQL Server bruger vi allerede, og det ville være underligt ikke at bruge dets ETL-værktøjer. Det hele er godt: både grænsefladen er smuk, og rapporterne er fantastisk… Men det er ikke for det, vi elsker softwareprodukter, åh ikke for det. Vi kan versionere det
dtsx(som er en XML med sammenblandede noder ved gemning), men hvad hjælper det? Og at lave et sæt opgaver, der kan flytte hundredvis af tabeller fra én server til en anden? Ja, hvad med hundredvis, med tyve stykker vil din pegefinger falde af, når du klikker på musen. Men det ser bestemt mere stilfuldt ud:
Vi ledte selvfølgelig efter løsninger. Det blev endda næsten til en hjemmelavet SSIS-pakkegenerator…
… og så fandt jeg et nyt job. Og dér ramte Apache Airflow mig.
Da jeg fandt ud af, at beskrivelserne af ETL-processer er simpel Python-kode, var jeg lige ved at danse af glæde. Sådan blev datastreams versioneret og diff'et, og at smide tabeller med ensartet struktur fra hundrede databaser ind i én destination blev til Python-kode på halvanden-til-to 13” skærme.
Bygger et cluster
Lad os undgå at gøre det til en børnehave og ikke tale om de åbenlyse ting som installation af Airflow, den valgte database, Celery og andre emner, der er beskrevet i dokumentationen.
For at vi hurtigst muligt kan komme i gang med eksperimenterne, har jeg skitseret docker-compose.yml hvor:
- Lad os starte med Airflow: Scheduler, Webserver. Der vil også køre Flower til overvågning af Celery-opgaver (for det er allerede blevet skubbet ind i
apache/airflow:1.10.10-python3.7, og det har vi ikke noget imod); - PostgreSQL, hvor Airflow vil skrive sine logfiler (planlægger data, udførelsesstatistik og så videre), mens Celery vil registrere afsluttede opgaver;
- Redis, som vil fungere som opgavebroker for Celery;
- Celery worker, som vil udføre opgaverne direkte.
- I mappen
./dagsvil vi gemme vores filer med beskrivelser af dags. De vil blive hentet on-the-fly, så der er ikke behov for at genstarte hele stakken efter hver lille ændring.
Nogle steder er koden i eksemplerne ikke fuldstændig (for ikke at overbelaste teksten), og andre steder modificeres den undervejs. Fuldstændige fungerende kodeeksempler kan ses i repositoryet. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis as a Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB for the Airflow metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Main container with Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, will be scaled using `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Bemærkninger:
- Jeg har i høj grad baseret kompositionsbygningen på det velkendte billede – sørg for at tage et kig. Måske har du ikke brug for mere i dit liv.
- Alle Airflow-indstillinger er tilgængelige ikke kun gennem
airflow.cfg, men også gennem miljøvariabler (tak til udviklerne), hvilket jeg udnyttede flittigt. - Naturligvis er det ikke produktion-klar: jeg har bevidst ikke indstillet heartbeats på containerne og har ikke bekymret mig om sikkerheden. Men jeg har lavet et minimum, der er passende til vores eksperimenter.
- Bemærk, at:
- Mappen med DAGs skal være tilgængelig for både planlæggeren og arbejderne.
- Det samme gælder for alle tredjepartsbiblioteker — de skal alle være installeret på maskinerne med planlæggeren og arbejderne.
Nu er det enkelt:
$ docker-compose up --scale worker=3Når alt er oppe, kan du se på webgr interfaces:
- Airflow:
- Flower:
Grundlæggende begreber
Hvis du ikke forstod noget af disse "dags", så her er et kort ordforråd:
- Scheduler — den vigtigste fyr i Airflow, som sørger for, at robotter arbejder i stedet for mennesker: han holder øje med tidsplanen, opdaterer dags, og starter opgaver.
Generelt havde han i gamle versioner problemer med hukommelsen (nej, ikke amnesi, men lækager), og i konfigurationerne fandtes der endda et legacy-parameter
run_duration— intervallet for hans genstart. Men nu er alt godt. - DAG (også kaldet "dag") — "rettet acyklisk graf", men sådan en definition siger ikke meget, i bund og grund er det et container for opgaver, der interagerer med hinanden (se nedenfor), eller en analog til Package i SSIS og Workflow i Informatica.
Udover dags kan der også være subdags, men vi kommer sandsynligvis ikke til dem.
- DAG Run — en initieret dag, der har fået sin egen
execution_date. Dagruns for en dag kan godt køre parallelt (hvis du selvfølgelig har gjort dine opgaver idempotente). - Operator — det er stykker af kode, der er ansvarlige for at udføre en specifik handling. Der er tre typer operatører:
- action, som for eksempel vores yndlings
PythonOperator, der kan udføre enhver (gyldig) Python-kode; - overførsel, der flytter data fra sted til sted, lad os sige,
MsSqlToHiveTransfer; - sensor kan reagere eller forsinke yderligere udførelse af dags indtil en begivenhed indtræffer.
HttpSensorkan kalde den angivne endpoint, og når den får det ønskede svar, starte overførslenGoogleCloudStorageToS3Operator. Et nysgerrigt sind vil spørge: "hvorfor? For man kan jo gøre gentagelser direkte i operatøren!" Og derefter, for at undgå at belaste task-poolen med hængende operatører. Sensoren starter, tjekker og dør indtil næste forsøg.
- action, som for eksempel vores yndlings
- Task — deklarerede operatører uanset type, der er knyttet til dags, hæves til rang af opgave.
- Task instance — når generalplanlæggeren beslutter, at det er tid til at sende opgaver i kamp til udførelses-arbejdere (med det samme, hvis vi bruger
LocalExecutoreller på en fjernnode i tilfælde afCeleryExecutor) tildeler han dem en kontekst (dvs. et sæt variabler — udførelsesparametre), udfolder skabeloner for kommandoer eller forespørgsler og placerer dem i puljen.
Genererer opgaver
Lad os først angive den generelle struktur af vores dag, og så vil vi gradvist dykke dybere ned i detaljerne, fordi vi anvender nogle utraditionelle løsninger.
Så i sin enkleste form vil sådan en dag se således ud:
fra datetime import timedelta, datetime

fra airflow import DAG
fra airflow.operators.python_operator import PythonOperator

fra commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Lad os finde ud af det:
- Først importerer vi de nødvendige biblioteker og noget andet;
sql_server_ds— det erListe[namedtuple[str, str]]med forbindelsesnavne fra Airflow Connections og databaserne, hvorfra vi vil hente vores tabel;dag— deklarationen af vores DAG, som bestemt skal ligge iglobals(), ellers finder Airflow den ikke. DAG'en skal også informeres om:- hvad den hedder
orders— dette navn vil senere blive vist i webgrænsefladen, - at den vil begynde at køre fra midnat den 8. juli,
- og at den skal køres cirka hver 6. time (for de cool typer er det tilladt at bruge
timedelta()-strengen,cronfor de mindre cool — et udtryk som0 0 0/6 ? * * *workflow()@daily);
- hvad den hedder
vil udføre det primære arbejde, men ikke lige nu. Lige nu vil vi blot udskrive vores kontekst til loggen.Og nu, den enkle magi ved at oprette opgaver:- vi går igennem vores kilder;
- initialiserer
- , som vil udføre vores tomme funktion
PythonOperator. Husk at angive et unikt (i forhold til DAG'en) opgavenavn og tilknytte selve DAG'en. Flagetvil udføre det primære arbejde, men ikke lige nu. Lige nu vil vi blot udskrive vores kontekst til loggen.provide_contextvil så give funktionen ekstra argumenter, som vi omhyggeligt vil samle ved hjælp af**contextDet er alt for nu. Hvad har vi fået:.
en ny DAG i webgrænsefladen,
- en og en halv hundrede opgaver, der vil blive udført parallelt (hvis Airflow, Celery og servernes kapacitet tillader det).
- Nå, næsten fået det.
Hvem vil sætte afhængighederne?
For at forenkle det hele, har jeg lagt det i
behandlingen, docker-compose.yml på alle noder. requirements.txt Nu går det løs:
De grå firkanter er task instances, behandlet af scheduler'en.
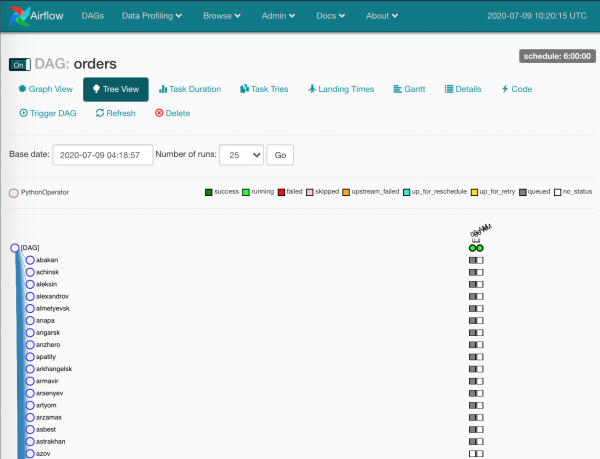
Vi venter lidt, opgaverne gribes af arbejderne:
De grønne, forståeligt nok, er dem, der er gennemført med succes. De røde — ikke så meget.
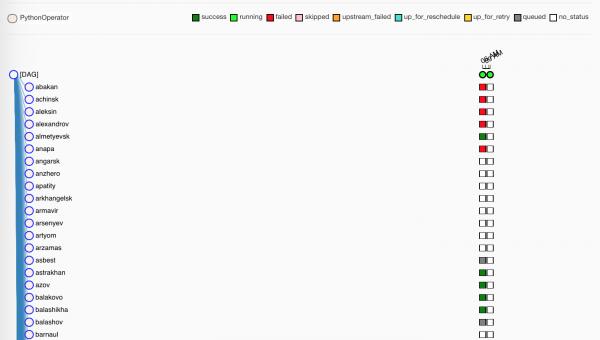
Forresten, på vores produktion er der ingen mappe,
der synkroniseres mellem maskinerne — alle DAG'er ligger i
./dagsvores Gitlab, og Gitlab CI slynger opdateringer ud til maskinerne ved merge igitMens arbejderne kører vores tomme opgaver, lad os huske på et andet værktøj, der kan vise os noget — Flower.master.
Lidt om Flower
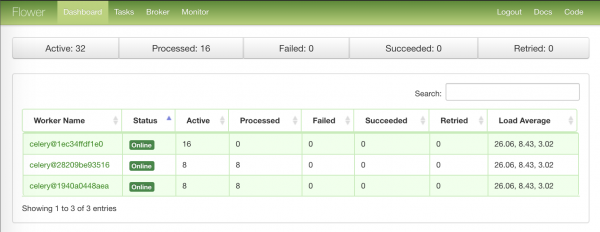
Den allerførste side med samlet information om noderne-arbejdere:
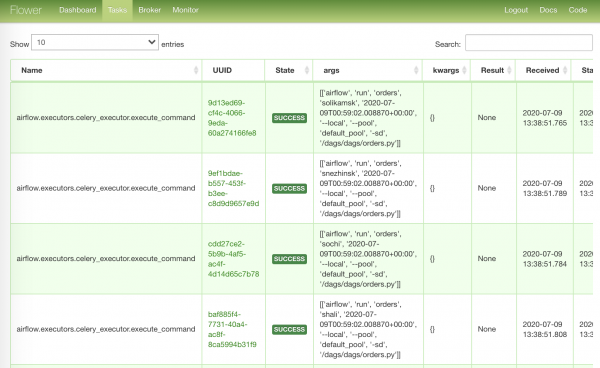
Den mest informative side med opgaver, der er sendt til behandling:
Den mest detaljefyldte side med de opgaver, der er sendt på arbejde:
Den mest kedelige side med status for vores broker:
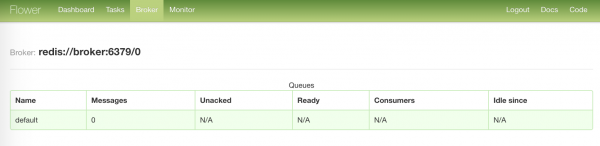
Den mest farverige side — med grafer over opgavernes status og deres udførelsestid:
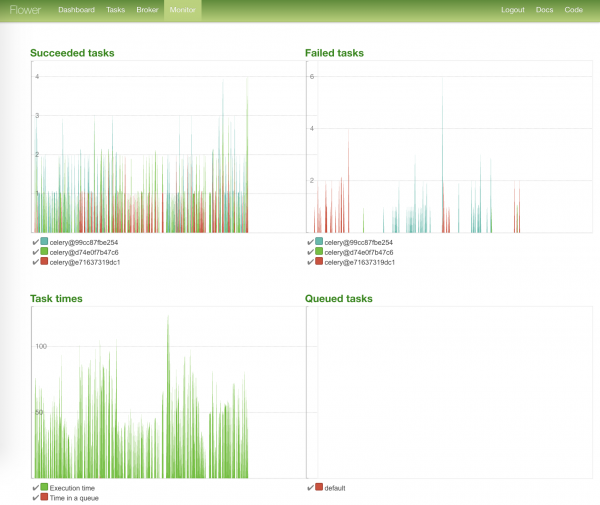
Loader det, der ikke blev loaded
Så, alle opgaver er blevet behandlet, vi kan bære de sårede væk.
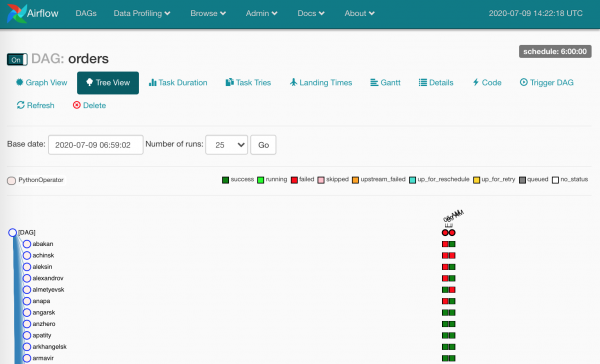
Og der var en del sårede — af forskellige årsager. Ved korrekt anvendelse af Airflow siger disse kvadrater, at dataene bestemt ikke nåede frem.
Vi skal se loggen og genstarte de fejlede opgaveinstanser.
Når vi klikker på et hvilket som helst kvadrat, ser vi de tilgængelige handlinger for os:
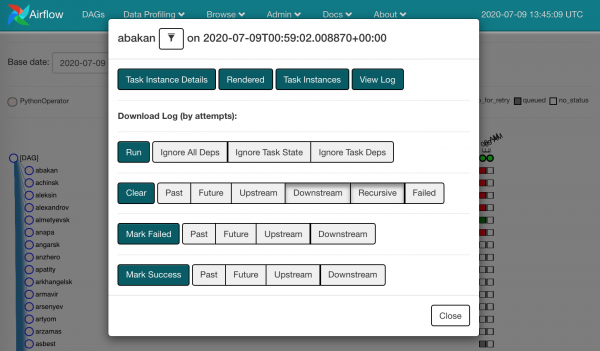
Vi kan tage og rense den, der er fejlet. Det vil sige, at vi glemmer, at der var noget, der gik galt, og den samme opgaveinstans tager tilbage til planlæggeren.
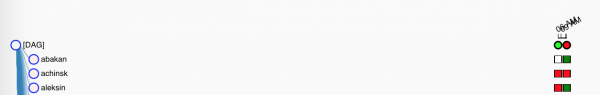
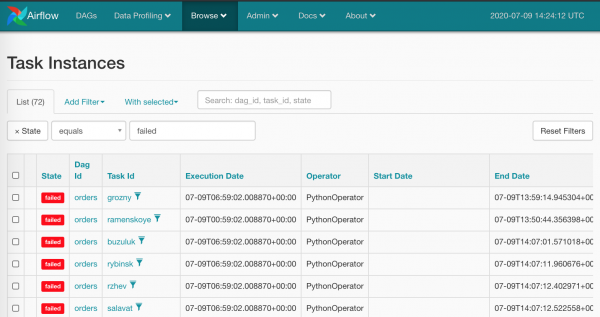
Det er klart, at gøre dette med musen for alle de røde kvadrater ikke er særligt humanitært — det er ikke dette, vi forventer fra Airflow. Selvfølgelig har vi et masseødelæggelsesvåben: Browse/Task Instances
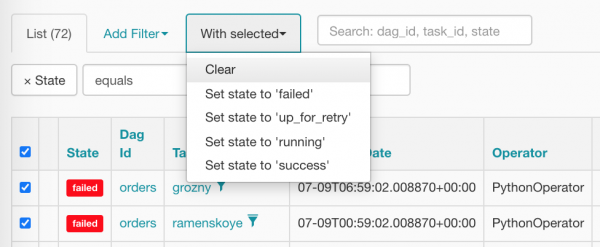
Vi vælger alt på én gang og nulstiller ved at klikke på den rigtige mulighed:
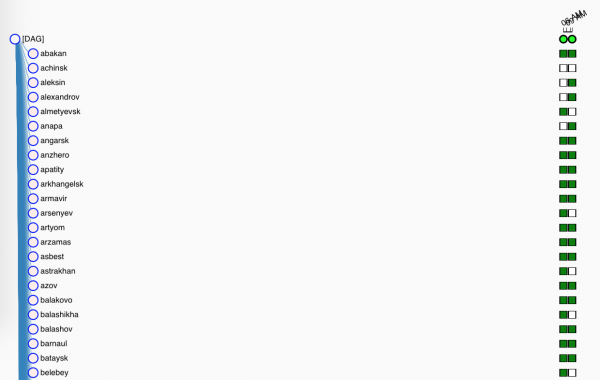
Efter rensningen ser vores taxaer sådan her ud (de kan næsten ikke vente på, at planlæggeren vil planlægge dem):
Forbindelser, hooks og andre variable
Det er tid til at se på den næste DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Kære alle, rapporterne er opdateret"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, vågn op, vi har brækket {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Har alle ikke lavet en opdatering af rapporter engang? Her er den igen: der er en liste over kilder til data; der er en liste over, hvor de skal placeres; glem ikke at signalere, når alt er sket eller gået i stykker (nå, det er ikke om os, nej).
Lad os tage fat i filen igen og se på de nye uforståelige ting:
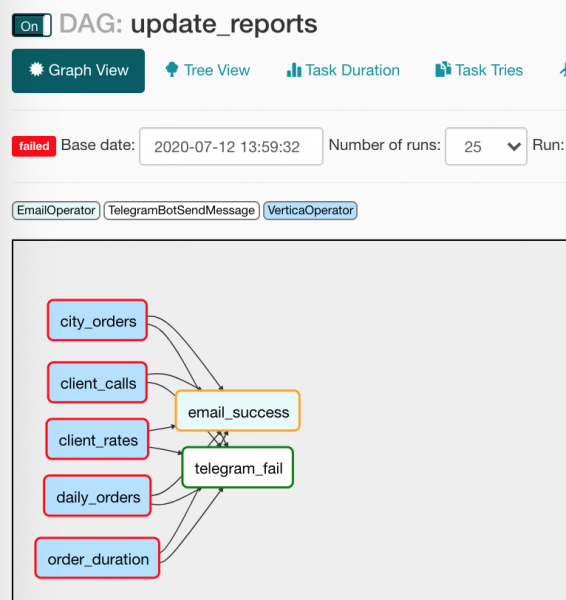
from commons.operators import TelegramBotSendMessage— der er intet, der hindrer os i at lave vores egne operatorer, hvilket vi har udnyttet ved at lave et lille wrapper til at sende beskeder i Det Udlåste. (Vi vil tale mere om denne operator nedenfor);default_args={}— dags kan give de samme argumenter til alle sine operatorer;to='{{ var.value.all_the_kings_men }}'— felttilvil ikke være hardkodet, men dynamisk dannet ved hjælp af Jinja og en variabel med en liste over email-adresser, som jeg forsigtigt har lagt iAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— betingelsen for at starte operatoren. I vores tilfælde sendes brevet kun til ledere, hvis alle afhængigheder har kørt succesfuldt;tg_bot_conn_id='tg_main'— argumenterconn_idmodtager forbindelses-id'er, som vi opretter iAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— beskeder i Telegram vil kun blive sendt, hvis der er nogle fejlede opgaver;task_concurrency=1— vi forhindrer samtidig kørsel af flere task instances af én opgave. Ellers vil vi fåVerticaOperator(som ser på én tabel);report_update >> [email, tg]— alleVerticaOperatorvil samle sig om at sende brevene og beskederne, sådan her:

Men da notifikationsoperatorerne har forskellige betingelser for start, vil kun én køre. I Tree View ser det lidt mindre overskueligt ud:

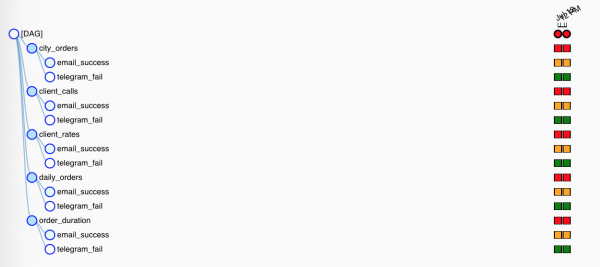
Jeg vil sige et par ord om makroer og deres venner — af variabler.
Makroer er Jinja-plakater, der kan indsætte forskellige nyttige oplysninger i operatorernes argumenter. For eksempel sådan her:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
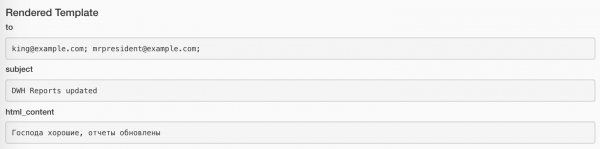
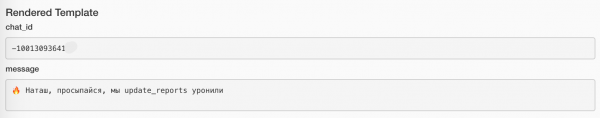
{{ ds }} vil blive udvidet til indholdet af kontektsvariablen execution_date i formatet YYYY-MM-DD: 2020-07-14. Det mest behagelige er, at kontekstvariablerne er fastgjort til en bestemt task-instance (den firkant i Tree View), og ved genstart vil plakaterne afsløres med de samme værdier.
De tildelte værdier kan ses med knappen Rendered på hver task-instance. Sådan er det for opgaven med at sende brevet:
Og sådan er det for opgaven med at sende beskeden:
Den fulde liste over indbyggede makroer for den seneste tilgængelige version findes her:
Desuden kan vi med hjælp fra plugins erklære vores egne makroer, men det er en helt anden historie.
Udover de foruddefinerede ting kan vi indsætte værdier for vores variabler (jeg har allerede brugt dette ovenfor i koden). Lad os oprette i Admin/Variables et par ting:
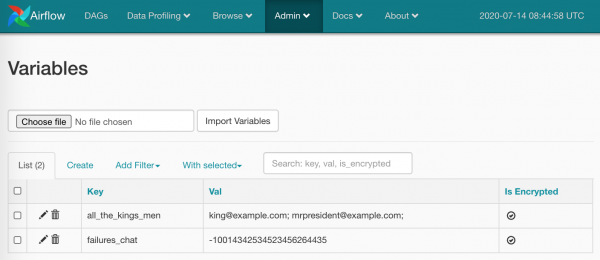
Det er det, nu kan vi bruge det:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Værdien kan være skalar, eller den kan være JSON. I tilfælde af JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
bruger vi ganske enkelt stien til den ønskede nøgle: {{ var.json.bot_config.bot.token }}.
Jeg vil sige et ord og vise et screenshot om forbindelser. Her er det hele enkelt: på siden Admin/Connections opretter vi forbindelsen, hvor vi lægger vores login/oplysninger og mere specifikke parametre. Sådan her:
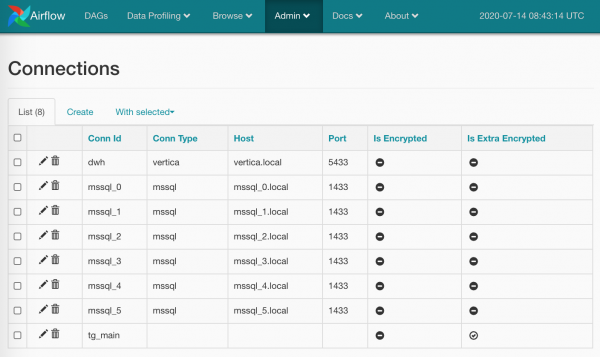
Adgangskoder kan krypteres (mere grundigt, end i standardvarianten), eller man kan undlade at angive forbindelsetypen (som jeg gjorde for tg_main) — det er sådan, at listen over typer er indbygget i Airflow-modellerne, og udvidelsen kan ikke ændres uden at ændre kildekoden (hvis jeg nu skulle have glemt noget — ret mig endelig), men at få credentials blot ved navn vil ikke være noget problem.
Og man kan også oprette flere forbindelser med samme navn: i så fald vil metoden BaseHook.get_connection(), der henter forbindelser ved navn, returnere en tilfældig af flere med samme navn (det ville have været mere logisk at bruge Round Robin, men lad os overlade det til udviklerne af Airflow).
Variables og Connections er uden tvivl fremragende værktøjer, men det er vigtigt ikke at miste balancen: hvilke dele af dine workflows opbevarer du egentlig i koden, og hvilke - overlader du til Airflow. På den ene side kan det være praktisk hurtigt at ændre værdien, for eksempel e-mailen til nyhedsbreve, gennem UI. På den anden side er det trods alt en tilbagevenden til musen, som vi (jeg) ønskede at slippe for.
Arbejdet med forbindelser er en af opgaverne hooks. Generelt er Airflow-hooks tilslutningspunkter til eksterne tjenester og biblioteker. For eksempel kan JiraHook åbne en klient for interaktion med Jira (man kan flytte opgaver frem og tilbage), og ved hjælp af SambaHook kan man uploade en lokal fil til smb-punkt.
Gennemgår en brugerdefineret operator
Og vi er nu tæt på at se, hvordan TelegramBotSendMessage
Kode commons/operators.py med selve operatoren er lavet:
fra typing import Union

fra airflow.operators import BaseOperator

fra commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Send meddelelse til chat_id ved hjælp af TelegramBotHook

    Eksempel:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} mislykkedes :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Send "{self.message}" til chatten {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Her, ligesom alt andet i Airflow, er alt meget simpelt:
- Vi arver fra
BaseOperator, som implementerer en del Airflow-specifikke ting (tag et kig på det, når du har tid) - Vi har defineret felterne
template_fields, hvor Jinja vil lede efter makroer til behandling. - Vi har organiseret de rette argumenter til
__init__(), og sat standarder, hvor det er nødvendigt. - Vi glemte heller ikke at initialisere forælderen.
- Vi åbnede den relevante hook
TelegramBotHook, og fik fat i klientobjektet fra den. - Vi har overskrevet (overridden) metoden
BaseOperator.execute(), som Airflow vil kalde, når det er tid til at køre operatoren - i den implementerer vi hovedhandlingen, uden at glemme at logge. (Vi logger os faktisk direkte ind istdoutogstderr— Airflow vil gribe det, pænt indpakke det, og placere det, hvor det skal hen.)
Lad os tage et kig på, hvad vi har i commons/hooks.py. Den første del af filen, med selve hooken:
fra typing import Union

fra airflow.hooks.base_hook import BaseHook
fra requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API hook

    Bemærk: tilføj en forbindelse med tom Conn Type og glem ikke
    at udfylde Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Jeg ved ikke engang, hvad jeg kan forklare her, jeg vil blot bemærke vigtige punkter:
- Vi arver, overvejer argumenterne - i de fleste tilfælde vil det være ét:
conn_id; - Vi overskriver standardmetoderne: jeg begrænsede mig til
get_conn(), hvor jeg henter forbindelsesparametrene efter navn og bare henter sektionenextra(dette felt er til JSON), hvor jeg (i henhold til min egen instruktion!) har indsat Telegram-bot tokenet:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Jeg opretter en instans af vores
TelegramBot, og giver den et specifikt token.
Og det er det. Du kan hente klienten fra hooken ved hjælp af TelegramBotHook().client eller TelegramBotHook().get_conn().
Og den anden del af filen, hvor jeg laver en mikroindpakning for Telegram REST API, så jeg ikke skal trække den samme for blot én metode sendMessage.
class TelegramBot:
    """Telegram Bot API indpakning

    Eksempler:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Hej, skat')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Hej, skat', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Den rigtige vej er at samle alt dette:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— i et plugin, uploade det til et offentligt repository, og give det til Open Source.
Mens vi har studeret alt dette, har vores rapportopdateringer formået at mislykkes og sende mig en fejlmeddelelse i kanalen. Jeg skal tjekke, hvad der er galt igen...
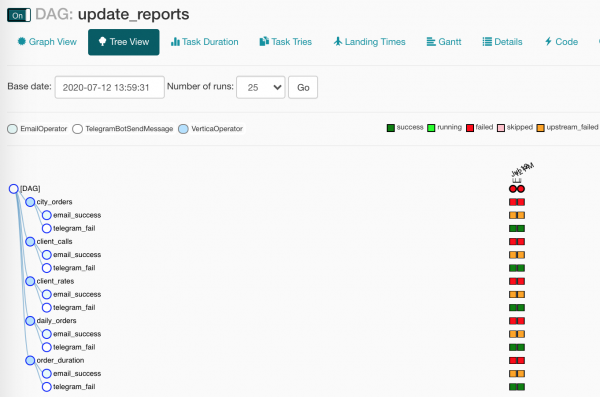
Der er noget, der er gået galt i vores DAG! Og var det ikke præcis det, vi ventede på? Ja, det var!
Skal du hælde i?
Føler du, at jeg har overset noget? Jeg lovede jo at overføre data fra SQL Server til Vertica, og her er jeg så væk fra emnet, skandaløst!
Det var en overlagt handling, jeg var simpelthen nødt til at afkode lidt af terminologien for dig. Nu kan vi komme videre.
Vores plan var sådan her:
- Oprette en DAG
- Generere opgaver
- Se hvordan alt ser godt ud
- Tildel session numre til uploads
- Hente data fra SQL Server
- Placer data i Vertica
- Indsamle statistik
For at kunne starte det hele, har jeg lavet en lille tilføjelse til vores docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Her opstarter vi:
- Vertica som vært
dwhmed de mest standardindstillinger, - tre forekomster af SQL Server,
- fylder databaserne med nogle data (kig absolut ikke i
mssql_init.py!)
Vi starter det hele med en lidt mere kompleks kommando end sidste gang:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Hvad vores mirakelforrandring genererede, kan man se ved at bruge punktet Data Profiling/Ad Hoc Query:
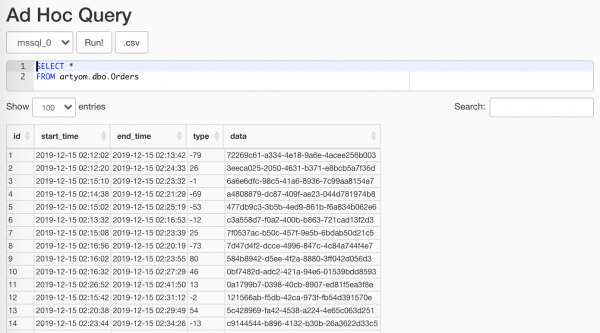
Det vigtigste er ikke at vise dette til analytikerne
Jeg vil ikke gå i detaljer om ETL-sessionerne, det er alt trivielt: vi opretter databasen, laver en tabel, pakker det hele ind i en kontekstmanager, og nu gør vi sådan her:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Load workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
fra sys import stderr

klasse Session:
    """ETL arbejdsflow session

    Eksempel:
        med Session(task_name) som session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Godt klaret'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() som cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            Opret TABEL hvis ikke eksisterer sessions (
                id          SERIAL       IKKE NULL PRIMARY KEY,
                task_name   VARCHAR(200) IKKE NULL,

                started     TIMESTAMPTZ  IKKE NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'åbnet')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Session er ikke åben')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'lukket',
              ', succesfuld: ', self.successful,
              ', Læsset: ', self.loaded_rows,
              ', kommentar:', self.comment)

klasse SessionError(Exception):
    pass

klasse SessionClosedError(SessionError):
    pass
Det er tid til at hente vores data fra vores halvanden hundrede tabeller. Det vil vi gøre med meget enkle linjer:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    VÆLG
        id, start_time, end_time, type, data
    FRA dbo.Orders
    HVOR
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Med hjælp fra hooken henter vi fra Airflow
pymssql-forbindelse - I forespørgslen vil vi sætte en begrænsning i form af datoen — funktionen vil blive givet af skabelonmotoren.
- Vi sender vores forespørgsel
pandas, som vil hente for osDataFrame— det bliver nyttigt senere.
Jeg bruger substitutionen
{dt}i stedet for anmodningsparameteren%sikke fordi jeg er en ond Pinocchio, men fordipandaskan ikke klare detpymssqlog giver det sidsteparams: Liste, selvom det meget gerne viljeg kan bruge tupler:.
Bemærk også, at udviklerenpymssqlhar besluttet ikke at understøtte det længere, og det er på tide at flytte over tilpyodbc.
Lad os se, hvad Airflow har stoppet ind i argumenterne for vores funktioner:
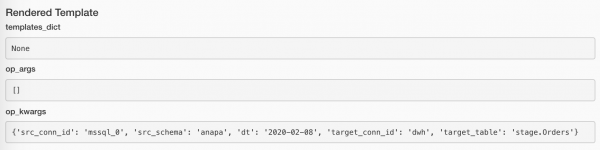
Hvis der ikke er nogen data, giver det ikke mening at fortsætte. Men det er også underligt at betragte indlæsningen som vellykket. Men det er ikke en fejl. Åh, hvad skal man gøre?! Sådan her:
if df.empty:
    raise AirflowSkipException('Ingen rækker at indlæse')
AirflowSkipException vil sige, at der reelt ikke er nogen fejl, og at vi springer opgaven over. I grænsefladen vil der ikke være en grøn eller rød firkant, men en pink.
Lad os tilsætte nogle kolonner:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Nemlig:
- DB'en, hvorfra vi hentede ordrene,
- Identifikatoren for vores indlæsningssession (den vil være forskellig for hver opgave),
- Hash fra kilden og ordrenummeret – så vi i den endelige database (hvor alt bliver samlet i en tabel) har en unik identifikator for ordren.
Der er kun et før- sidste skridt tilbage: at indlæse alt i Vertica. Og, som det ikke må undre, er en af de mest effektive måder at gøre det på – via CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Vi laver en specialmodtager
StringIO. pandasvil venligt lægge voresDataFramei form afCSV-linjer.- Lad os åbne en forbindelse til vores elskede Vertica ved hjælp af en hook.
- Og nu med
copy()sender vi vores data direkte til Vertica!
Fra driveren henter vi, hvor mange linjer der blev indlæst, og fortæller sessionslederen, at alt er OK:
session.loaded_rows = cursor.rowcount
session.successful = True
Det er alt.
I produktion opretter vi måltabellen manuelt. Her har jeg givet mig selv lidt automatisering:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Jeg bruger
VerticaOperator()til at oprette databasen og tabellen (hvis de ikke allerede findes, selvfølgelig). Det vigtigste er at sætte afhængighederne korrekt:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Sammenfatning
— Jamen, sagde musen, — er det ikke sandt, nu
Har du været sikker på, at jeg er den mest frygtelige bestie i skoven?
Julia Donaldson, «Gruffalo»
Jeg mener, hvis jeg og mine kolleger deltager i en konkurrence: hvem der hurtigst kan opbygge og lancere en ETL-proces fra bunden: de med deres SSIS og mus, og jeg med Airflow... Og så sammenligner vi brugsvenligheden... Åh, jeg tror, du vil være enig i, at jeg slår dem på alle fronter!
Hvis man ser lidt mere seriøst på det, så har Apache Airflow — ved at beskrive processerne i form af programkode — gjort mit arbejde meget mere bekvemt og behageligt.
Dens ubegribelige udvidelsesmuligheder: både hvad angår plugins og tilbøjelighed til skalering — giver dig mulighed for at anvende Airflow i næsten enhver kontekst: uanset om det er i den fulde cyklus af indsamling, forberedelse og behandling af data, eller i opsendelsen af raketter (til Mars, selvfølgelig).
Afsluttende del, informations- og vejledningsdel
Problemer, som vi har samlet for dig
start_date. Ja, det er allerede en lokal meme. Gennem hovedargumentet for DAG'enstart_dategår alle. Kort sagt, hvis man angiver istart_dateden nuværende dato, og ischedule_interval— en dag, så vil DAG'en ikke starte før i morgen.start_date = datetime(2020, 7, 7, 0, 1, 2)Og ikke flere problemer.
Der er også en anden fejl ved udførelsen forbundet med den:
Task is missing the start_date parameter, som oftest indikerer, at du har glemt at knytte det til operatoren af DAG'en.- Alt på én maskine. Ja, og databaserne (både Airflow selv og vores frontend), webserveren, planlæggeren og arbejderne. Og det fungerede endda. Men over tid voksede antallet af opgaver for tjenesterne, og da PostgreSQL begyndte at returnere svar fra indekset på 20 ms i stedet for 5 ms, tog vi det og flyttede det.
- LocalExecutor. Ja, vi kører stadig på det, og vi er nu kommet til afgrundens kant. LocalExecutor'en har stadig været tilstrækkelig for os, men nu er tiden kommet til at udvide med mindst én arbejder, og vi må virkelig tage os sammen for at flytte til CeleryExecutor. Og eftersom det kan bruges selv på en enkelt maskine, så er der intet, der stopper os fra at bruge Celery, selv ikke på en server, der "naturligvis aldrig vil gå i produktion, jeg sværger!"
- Mangel på indbyggede værktøjer:
- Connections til opbevaring af servicelegitimationsoplysninger,
- SLA-misser til reaktion på opgaver, der ikke er blevet udført til tiden,
- XCom til udveksling af metadata (jeg sagde metadata!) mellem opgaverne i dag.data!) mellem opgaverne af dag.
- Misbrug af e-mail. Hvad skal man sige? Der blev opsat underretninger for alle gentagelser af fejlede opgaver. Nu har jeg over 90.000 e-mails fra Airflow i min arbejds Gmail, og webgrænsefladen nægter at hente og slette mere end 100 ad gangen.
Flere faldgruber:
Værktøjer til endnu mere automatisering
For at vi kan arbejde endnu mere med hovedet og ikke med hænderne, har Airflow forberedt følgende til os:
- — det har stadig status som eksperimentelt, hvilket ikke forhindrer det i at fungere. Med det kan man ikke kun få information om DAG'er og opgaver, men også stoppe/starten en DAG, oprette en DAG-kørsel eller et pulje.
- — mange værktøjer er tilgængelige via kommandolinjen, som ikke blot er besværlige at bruge gennem WebUI, men som overhovedet ikke eksisterer. For eksempel:
backfillserien til at genstarte instanser af opgaver.
For eksempel, analytikere kommer og siger: "Åh, Der er noget galt med dataene fra 1. til 13. januar! Fix det, fix det, fix det!" Og du er sådan, bingo:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Databasevedligeholdelse:
initdb,resetdb,upgradedb,checkdb. run, som gør det muligt at køre én instans af en opgave, og være ligeglad med alle afhængigheder. Desuden kan man starte det gennemLocalExecutor, selvom du har et Celery-kluster.- Det gør næsten det samme som
test, bare at det ikke skriver noget til databasen. connectionsgiver mulighed for massivt at oprette forbindelser fra shell'en.
- — en ret hardcore måde at interagere på, som er beregnet til plugins og ikke til at pille omkring med det manuelt. Men hvem sætter os i vejen for at gå ind i
/home/airflow/dags, starteipythonog begynde at eksperimentere? For eksempel kan man eksportere alle forbindelser med følgende kode:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Forbindelse til Airflows metadata-database. Jeg anbefaler ikke at skrive i den, men det er meget hurtigere og lettere at hente status for opgaver til forskellige specifikke metrikker end gennem nogen af API'erne.
Lad os sige, ikke alle vores opgaver er idempotente, og de kan nogle gange fejle, og det er normalt. Men flere sammenbrud — det er allerede mistænkeligt, og det vil være klogt at tjekke.
Pas på, SQL!
MED sidste_udførsler SOM (
VÆLG
    opgave_id,
    dag_id,
    udførelses_dato,
    tilstand,
        række_nummer()
        OVER (
            PARTITION BY opgave_id, dag_id
            ORDER BY udførelses_dato DESC) SOM rn
FRA offentlig.opgave_instance
HVOR
    udførelses_dato > nu() - INTERVAL '2' DAG
),
fejlet SOM (
    VÆLG
        opgave_id,
        dag_id,
        udførelses_dato,
        tilstand,
        CASE NÅR rn = række_nummer() OVER (
            PARTITION BY opgave_id, dag_id
            ORDER BY udførelses_dato DESC)
                 SÅ SAND END SOM sidste_fejl_seq
    FRA sidste_udførsler
    HVOR
        tilstand IN ('fejlet', 'oppe_til_genoverførsel')
)
VÆLG
    opgave_id,
    dag_id,
    tæll(last_fejl_seq)                       SOM mislykkedes,
    tæll(CASE NÅR sidste_fejl_seq
        OG tilstand = 'fejlet' SÅ 1 END)       SOM fejlet,
    tæll(CASE NÅR sidste_fejl_seq
        OG tilstand = 'oppe_til_genoverførsel' SÅ 1 END) SOM oppe_til_genoverførsel
FRA fejlet
GRUPPER EFTER
    opgave_id,
    dag_id
HAVING
    tæll(last_fejl_seq) > 0
Links
Og selvfølgelig skal de første ti links fra Google-resultaterne indeholde indholdet fra mappen Airflow fra mine bogmærker.
- — selvfølgelig, man skal starte med den officielle dokumentation, men hvem læser instruktioner?
- — men læs i det mindste anbefalingerne fra skaberne.
- — starten: brugergrænsefladen i billeder
- — godt beskrevne grundlæggende begreber, hvis (pludselig!) du ikke forstod noget hos mig.
- — en kort guide til opsætning af en Airflow-klynge.
- — en næsten lige så interessant artikel, måske med mere formalitet men færre eksempler.
- — om arbejde i kombination med Celery.
- — om idempotens af opgaver, indlæsning efter ID i stedet for dato, transformationer, filstruktur og andre interessante ting.
- — afhængigheder af opgaver og Trigger Rule, som jeg kun nævnte ganske kort.
- — hvordan man overvinder nogle "det fungerer som forventet" fra planlæggeren, indlæser tabte data og prioriterer opgaver.
- — nyttige SQL-forespørgsler til Airflow-metadata.
- — der er en nyttig sektion om at oprette en custom sensor.
- — en interessant kort bemærkning om opbygning af infrastruktur på AWS til Data Science.
- — almindelige fejl (når nogle alligevel ikke læser instruktionerne).
- — smil, mens folk kæmper med opbevaring af adgangskoder, selvom man bare kan bruge forbindelser.
- — implicit DAG passing, context passing in functions, again about dependencies, and also about skipping task runs.
- — om brugen af
standardargumenterogparamsi skabeloner samt om Variables og Connections. - — en fortælling om, hvordan schedulerne forberedes til Airflow 2.0.
- — en lidt forældet artikel om at deployere vores klynge i
docker-compose. - — dynamiske opgaver ved hjælp af skabeloner og kontekstoverførsel.
- — standard og tilpassede notifikationer via e-mail og Slack.
- — Branching af opgaver, makroer og XCom.
Og links, der er nævnt i artiklen:
- — tilgængelige til brug i skabelonpladsholdere.
- — Almindelige fejl ved oprettelse af DAG'er.
- —
docker-composetil eksperimenter, fejlfinding og mere. - — Python-wrapper til Telegram REST API.
Kilde: habr.com
