

Det er sandsynligvis ingen hemmelighed for nogen, at det for Apache Hadoop har været et år med store forandringer. Sidste år blev Cloudera og Hortonworks fusioneret (praktisk talt en overtagelse af det sidstnævnte), og Mapr blev solgt til Hewlett Packard på grund af alvorlige økonomiske problemer. Hvis man for nogle år siden i tilfælde af on-premises installationer skulle vælge mellem Cloudera og Hortonworks, har vi desværre ikke dette valg længere i dag. En overraskelse var også det faktum, at Cloudera siden februar i år har annonceret at stoppe med at udgive binære builds af deres distribution i det offentlige repository, og nu er de kun tilgængelige via betalt abonnement. Selvfølgelig er det stadig muligt at downloade de seneste versioner af CDH og HDP, der blev udgivet inden udgangen af 2019, og support for disse forventes at fortsætte i et til to år. Men hvad skal vi så gøre videre? For dem, der tidligere har betalt for et abonnement, er der ikke sket ændringer. Og for dem, der ikke ønsker at skifte til den betalte version af distributionen, men som stadig ønsker at have adgang til de nyeste versioner af klusterkomponenterne samt patches og andre opdateringer, har vi forberedt denne artikel. Her vil vi se på mulige løsninger på den aktuelle situation.
Artiklen er mere en oversigt. Der vil ikke være nogen sammenligning af distributioner eller en detaljeret gennemgang af dem, og der vil heller ikke være nogen opskrifter på installation og konfiguration. Hvad vil der så være? Vi vil kort fortælle om en distribution som Arenadata Hadoop, som med rette har fortjent vores opmærksomhed takket være sin tilgængelighed, hvilket i dag er en sjældenhed. Og derefter vil vi tale om Vanilla Hadoop, primært om, hvordan man "tilbereder" det ved hjælp af Apache Bigtop. Er I klar? Så velkommen til.
Arenadata Hadoop
Det er en helt ny og, indtil videre, en lidt ukendt distribution af indenlandsk udvikling. Desværre er der på nuværende tidspunkt kun .
Flere oplysninger kan findes på den officielle projekt. De seneste versioner af distributionen er baseret på Hadoop 3.1.2 for version 3 og 2.8.5 for version 2.
Information om roadmappet kan findes .
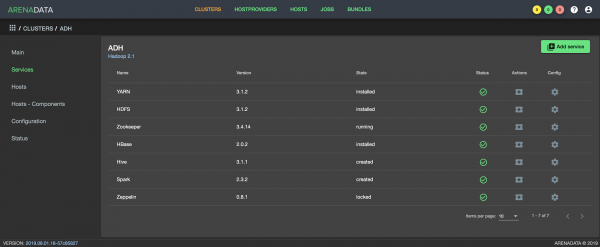
Arenadata Cluster Manager Interface
Hovedproduktet fra Arenadata er , som bruges til installation, konfiguration og overvågning af forskellige softwareløsninger fra virksomheden. ADCM distribueres gratis, og dets funktionalitet kan udvides ved at tilføje bundles, som er sæt af ansible-playbooks. Bundles deles op i to typer: enterprise og community. Sidstnævnte er tilgængelige for gratis download fra Arenadata's hjemmeside. Der er også mulighed for at udvikle sit eget bundle og tilknytte det til ADCM.
Til deployment og administration af Hadoop 3 tilbydes en community-version af bundlet i sammenhæng med ADCM, mens der kun er som et alternativ til Hadoop 2. Hvad angår repositories med pakker, er de åbne for offentlig adgang, og de kan downloades og installeres som sædvanligt for alle komponenter i klyngen. Generelt set ser distributionen meget interessant ud. Jeg er sikker på, at der vil være dem, der er vant til løsninger som Cloudera Manager og Ambari, og som vil finde ADCM tiltalende. For nogle vil det også være et stort plus, at distributionen til importafløsning.
Hvis vi taler om ulemperne, vil de være de samme som for alle andre Hadoop-distributioner. Nemlig:
- Den såkaldte 'vendor lock-in'. På eksemplet med Cloudera og Hortonworks har vi allerede forstået, at der altid er risiko for ændringer i virksomhedens politik.
- Betydeligt efterslæb i forhold til Apache upstream.
Vanilla Hadoop
Som I ved, er Hadoop ikke et monolitisk produkt, men i bund og grund en hel række tjenester omkring dets distribuerede filsystem HDFS. Næsten ingen vil være tilfredse med blot en filkluster. Nogle har brug for Hive, andre Presto, og så er der HBase og Phoenix, og stadig oftere anvendes Spark. Til orkestrering og indlæsning af data ses der nogle gange Oozie, Sqoop og Flume. Og hvis spørgsmålet om sikkerhed opstår, tænkes straks på Kerberos i forbindelse med Ranger.
De binære versioner af Hadoop-komponenter er tilgængelige på hjemmesiden for hvert af projekterne i økosystemet som tarballs. Du kan downloade dem og begynde installationen, men med én forudsætning: udover at du sandsynligvis vil ønske at bygge pakker fra "rå" binære filer, vil du ikke have nogen sikkerhed for, at de downloadede versioner af komponenterne er kompatible med hinanden. En mere foretrukken mulighed er opbygning ved hjælp af Apache Bigtop. Bigtop giver mulighed for at bygge fra Apache's maven-repositories, køre tests og samle pakker. Men hvad der er meget vigtigt for os er, at Bigtop vil samle de versioner af komponenterne, der vil være kompatible med hinanden. Det vil vi fortælle mere detaljeret om senere.
Apache Bigtop
Apache Bigtop er et værktøj til opbygning, pakke, og testen af en række
open source projekter såsom Hadoop og Greenplum. Bigtop har mange
udgivelser. På tidspunktet for denne artikel var den seneste stabile udgivelse version 1.4,
mens 1.5 var i master. I forskellige versioner af udgivelserne anvendes forskellige versioner
af komponenterne. For eksempel har core-komponenterne Hadoop i version 1.4 version 2.8.5, mens der i master
er 2.10.0. Sammensætningen af de understøttede komponenter ændrer sig også. Nogle forældede og
ikke-opdaterede komponenter fjernes, mens noget nyt og mere efterspurgt kommer til, og
det er ikke nødvendigvis noget fra Apache-familien.
Derudover har Bigtop mange .
Da vi begyndte at lære Bigtop at kende, blev vi først og fremmest overrasket over dets beskedne, i sammenligning med andre Apache-projekter, udbredelse og kendthed samt det ret lille community. Dette betyder, at der er minimal information om produktet, og at søgning efter løsninger på opståede problemer gennem fora og mailinglister ofte ikke giver noget. I starten viste det sig at være en udfordrende opgave for os at udføre en fuld opbygning af distributionen på grund af værktøjets specifikationer, men det vil vi fortælle lidt senere om.
Som en teaser - dem, der i sin tid kunne lide sådanne projekter i Linux-universet som Gentoo og LFS, vil måske finde det nostalgisk behageligt at arbejde med denne ting og mindes de "forgangne" tider, hvor vi selv søgte (og måske endda skrev) ebuilds og regelmæssigt genopbyggede med nye patches til Mozilla.
En stor fordel ved Bigtop er åbenheden og alsidigheden af de værktøjer, det er baseret på. I bunden ligger Gradle og Apache Maven. Gradle er ret kendt som det værktøj, Google bruger til at samle Android. Det er fleksibelt og, som man siger, "testet i kamp". Maven er det officielle værktøj til at samle projekter i Apache, og eftersom de fleste af deres produkter udsendes gennem Maven, er det ikke til at komme udenom. Det er værd at bemærke POM (project object model) – en "fundamental" xml-fil, der beskriver alt, hvad der er nødvendigt for, at Maven kan arbejde med dit projekt, omkring hvilken hele arbejdet er bygget op. Netop i
delen af Maven opstår nogle forhindringer, som folk ofte støder på, når de for første gang arbejder med Bigtop.
Praktik
Så hvad skal man starte med? Gå til download-siden og hent den seneste stabile version som et arkiv. Der kan man også finde de binære artefakter, som Bigtop har samlet. Forresten understøttes de almindeligt anvendte pakkemanagere YUM og APT.
Alternativt kan man hente den seneste stabile udgave direkte fra
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitKloning til "bigtop"...
remote: enumererer objekter: 46, færdig.
remote: tæller objekter: 100% (46/46), færdig.
remote: komprimering af objekter: 100% (41/41), færdig.
remote: I alt 40217 (delta 14), genbrugt 10 (delta 1), pakke-genbrugt 40171
Får objekter: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, klar.
Bestemmer ændringer: 100% (20503/20503), klar.
Opdaterer filer: 100% (1998/1998), klar.
Den resulterende mappe ./bigtop ser cirka sådan ud:
./bigtop-bigpetstore — demonstrative applikationer, syntetiske eksempler
./bigtop-ci — CI-værktøjer, jenkins
./bigtop-data-generators — data-generering, syntetisk, til smoke-tests osv.
./bigtop-deploy — værktøjer til deployment
./bigtop-packages — configs, scripts, patches til bygning, hoveddelen af værktøjet
./bigtop-test-framework — test-framework
./bigtop-tests — selve testene, belastnings- og smoke-tests
./bigtop_toolchain — miljø til bygning, forberedelse af miljøet til værktøjets arbejde
./build — arbejdsmappe til bygning
./dl — mappe til downloadede kilder
./docker — bygning i docker-billeder, testning
./gradle — gradle-config
./output – mappe, hvor bygningens artefakter havner
./provisioner — provisioning
Det mest interessante på dette stadie for os er hovedkonfigurationen ./bigtop/bigtop.bom, hvor vi kan se alle understøttede komponenter med versioner. Her kan vi angive en anden version af produktet (hvis vi ønsker at prøve at bygge det) eller en version af bygningen (hvis vi f.eks. har tilføjet en betydelig patch).
Der er også stor interesse for undermappen .\/bigtop\/bigtop-packages, som har direkte relation til processen med at bygge komponenter og pakker med dem.
Så vi har downloadet arkivet, udpakket det eller lavet et klon fra github, kan vi begynde at bygge?
Nej, først skal vi forberede miljøet.
Forberedelse af miljøet
Og her vil der være behov for en lille afstikker. For at bygge næsten ethvert mere eller mindre komplekst produkt er der brug for et bestemt miljø — i vores tilfælde er det JDK, de samme delte biblioteker, headerfiler osv., værktøjer som ant, ivy2 og mange andre. En mulighed for at få det nødvendige Bigtop-miljø er at installere de nødvendige komponenter på byggehosten. Jeg kan tage fejl i kronologien, men det ser ud til, at der fra version 1.0 også er blevet introduceret en mulighed for at bygge i forudkonfigurerede og tilgængelige docker-images, som kan ses her.
Hvad angår forberedelse af miljøet, så har vi en hjælp — Puppet.
Man kan bruge følgende kommandoer, der køres fra rodmappen
af værktøjet, .\/bigtop:
.\/gradlew toolchain\n.\/gradlew toolchain-devtools\n.\/gradlew toolchain-puppetmodules
Eller direkte gennem puppet:
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::installer"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::deployment-tools"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::development-tools"Desværre kan der allerede opstå problemer på dette trin. Generelt råd her er – at bruge en understøttet distribution, der er opdateret på byggehosten, eller forsøge at anvende docker-path.
Kompilering
Hvad kan vi så prøve at bygge? Svaret på dette spørgsmål vil blive givet af output fra kommandoen
.\/gradlew tasks I sektionen Package tasks er der en række produkter, der er slutartefakter for Bigtop.
De kan identificeres ved suffikset -rpm eller -pkg-ind (i tilfælde af bygning
i docker). I vores tilfælde er det mest interessante Hadoop.
Lad os prøve at udføre bygningen i miljøet på vores build-server:
.\/gradlew hadoop-rpmBigtop downloader selv de nødvendige kilder, der er nødvendige for den specifikke komponent, og starter bygningen. Dermed er værktøjets funktion knyttet til Maven-repositorier og andre kilder, hvilket betyder, at det har brug for adgang til internettet.
I arbejdets forløb dannes der en standardoutput. Nogle gange kan man ud fra denne og fejlmeddelelserne forstå, hvad der er gået galt. Og nogle gange er det nødvendigt at få yderligere information. I dette tilfælde bør du tilføje argumenter --info eller --debug, og det kan også være nyttigt –stacktrace. Der er en praktisk måde at danne et datasæt til efterfølgende henvisning i mailinglister, nøgle --scan.
Dette vil få bigtop til at samle al information og lægge det i gradle, hvorefter det vil give et link,
ved at følge hvilket, en kompetent person vil kunne forstå, hvorfor opbygningen mislykkedes.
Det er vigtigt at huske, at denne mulighed kan gøre uønsket information offentlig for dig, såsom brugernavne, noder, miljøvariabler osv., så vær forsigtig.
Ofte er fejl et resultat af, at det ikke er muligt at få nogle nødvendige komponenter til opbygningen. Som regel kan problemet rettes ved at lave et patch for at rette noget i kilden, f.eks. adressen i pom.xml i rodmappen af kildekoden. Dette gøres ved at oprette og placere det i den relevante mappe ./bigtop/bigtop-packages/src/common/oozie/ patch, for eksempel i form af patch2-fix.diff.
--- a/pom.xml
+++ b/pom.xml
@@ -136,7 +136,7 @@


central
- http://repo1.maven.org/maven2
+ https://repo1.maven.org/maven2

false
Sandsynligvis, på tidspunktet for læsningen af denne artikel, vil du ikke selv skulle lave den nævnte rettelse.
Ved implementering af nogen patches og ændringer i opbygningsmekanismen kan det være nødvendigt at "nullstille" opbygningen ved hjælp af en rensekommando:
./gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
Denne operation vil rulle alle ændringer i opbygningen af denne komponent tilbage, hvorefter opbygningen udføres igen. Denne gang vil vi forsøge at samle projektet i en docker-billede:
.\/gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Opgave :hadoop-pkg-ind
Bygger 1.2.1 hadoop-pkg på centos-7 i Docker...
+++ dirname .\/bigtop-ci\/build.sh
++ cd .\/bigtop-ci\/..
++ pwd
+ BIGTOP_HOME=\/tmp\/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop\/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop\/slaves:1.2.1-centos-7 \/sbin\/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
meget output
....
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-secondarynamenode-2.8.5-
1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-journalnode-2.8.5-
1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-resourcemanager-2.8.5-
1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-nodemanager-2.8.5-
1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-proxyserver-2.8.5-
1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-timelineserver-2.8.5-
1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-historyserver-2.8.5-
1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-client-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Skrevet: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ cd hadoop-2.8.5-src
+ \/usr\/bin\/rm -rf \/bigtop\/build\/hadoop\/rpm\/BUILDROOT\/hadoop-2.8.5-1.el7.x86_64
Udfører(%clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Udfører(--clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.CwDb22
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Oprettet \/bigtop\/build\/hadoop\/.rpm
:hadoop-rpm (Tråd[Opgavearbejder for ':',5,main]) færdig. Tog 38 mins 1.151 secs.
:hadoop-pkg (Tråd[Opgavearbejder for ':',5,main]) startede.
> Opgave :hadoop-pkg
Opgave ':hadoop-pkg' er ikke opdateret fordi:
Opgave har ikke erklæret nogen output på trods af at den udfører handlinger.
:hadoop-pkg (Tråd[Opgavearbejder for ':',5,main]) færdig. Tog 0.0 secs.
BUILD SUCCESSFUL på 40m 37s
6 handlingable opgaver: 6 udført
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Fejl: Ingen sådan container:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BUILD SUCCESSFUL på 41m 24s
1 handlingsbar opgave: 1 udført
Bygningen blev udført på CentOS, men den kan også udføres på Ubuntu:
.\/gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indUdover at bygge pakker til forskellige Linux-distributioner, kan værktøjet også oprette et repository med de byggede pakker, for eksempel:
.\/gradlew yumMan kan også huske på smoke-tests og implementering i docker.
Opret et cluster med tre noder:
.\/gradlew -Pnum_instances=3 docker-provisionerKør smoke-tests i et cluster med tre noder:
.\/gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerSlet clusteret:
.\/gradlew docker-provisioner-destroyFå kommandoer til at forbinde til docker-containere:
.\/gradlew docker-provisioner-sshVis status:
.\/gradlew docker-provisioner-statusDu kan læse mere om Deployment tasks i dokumentationen.
Når det kommer til tests, er der et betydeligt antal, primært smoke og integrations. Deres analyse ligger uden for rammerne af denne artikel. Jeg vil blot sige, at opbygningen af distributionen ikke er så kompleks, som det kan se ud ved første øjekast. Alle komponenter, som vi bruger i produktionen, er lykkedes at samle og gennemgå tests på, og vi har ikke haft problemer med deres implementering og udførelse af grundlæggende operationer i testmiljøet.
Udover de eksisterende komponenter i Bigtop er der mulighed for at tilføje noget andet, endda egen softwareudvikling. Alt dette kan automatiseres fremragende og passer ind i CI/CD-konceptet.
Konklusion
Det er tydeligt, at en distribution bygget på denne måde ikke straks skal sendes til produktion. Man skal forstå, at hvis der er et reelt behov for at bygge og vedligeholde sin egen distribution, så skal der investeres tid og penge i det.
Ikke desto mindre kan man med den rette tilgang og et professionelt team godt klare sig uden kommercielle løsninger.
Det er vigtigt at bemærke, at selve Bigtop-projektet har brug for udvikling, og det ser ud til, at der i øjeblikket ikke er aktiv udvikling i det. Perspektiverne for introduktionen af Hadoop 3 i det er også uklare. For øvrigt, hvis du har et reelt behov for at bygge Hadoop 3, kan du se på fra Arenadata, som udover de standard
komponenter også har en række yderligere (Ranger, Knox, NiFi).
Hvad angår Rostelecom, så er Bigtop en af de overvejede muligheder for os i dag. Om vi vælger det eller ej, vil tiden vise.
Bilag
For at inkludere en ny komponent i samlingen, skal du tilføje dens beskrivelse i bigtop.bom og ./bigtop-packages. Du kan prøve at gøre dette ved at følge de eksisterende komponenter som eksempler. Prøv at finde ud af det. Det er ikke så svært, som det ser ud ved første øjekast.
Hvad tænker du? Vi ser frem til at høre din mening i kommentarerne, og tak for din opmærksomhed!
Artiklen er forberedt af datahåndteringsholdet hos «Ростелеком»
Kilde: habr.com
