

I 2017 vandt vi konkurrencen om udviklingen af det transaktionelle kerne-system for investeringsforretningen i Alfa-Bank og begyndte arbejdet (præsenteret på HighLoad++ 2018 med et foredrag om kernen i investeringsforretningen Vladimir Drynkin, leder af retningen for det transaktionelle kerne-system i Alfa-Banks investeringsforretning). Dette system skulle aggregerer data om transaktioner fra forskellige kilder i forskellige formater, standardisere dataene, gemme dem og give adgang til dem.
I udviklingsprocessen har systemet udviklet sig og fået flere funktioner, og på et tidspunkt indså vi, at vi skabte noget meget større end blot applikationssoftware designet til at løse en bestemt vifte af opgaver: vi har skabt et system til opbygning af distribuerede applikationer med vedvarende lager. Den erfaring, vi har opnået, danner grundlaget for et nyt produkt — (TDG).
Jeg vil fortælle om arkitekturen af TDG og de løsninger, vi kom frem til under udviklingen, introducere dig for de vigtigste funktioner og vise, hvordan vores produkt kan blive grundlaget for at skabe komplette løsninger.
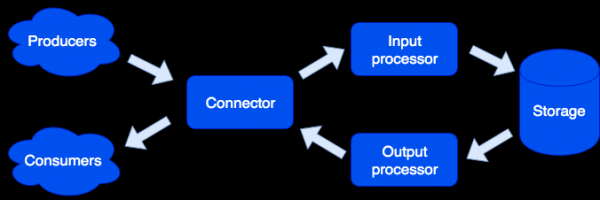
Arkitektonisk har vi opdelt systemet i separate roller, hvor hver enkelt er ansvarlig for at løse en bestemt opgave. En kørende instans af applikationen implementerer en eller flere typer roller. Der kan være flere roller af samme type i klyngen:
Connector
Connectoren er ansvarlig for at opretholde forbindelsen til omverdenen; dets opgave er at modtage anmodninger, parse dem, og hvis det lykkes, sende dataene til behandling i input processor. Vi understøtter formater som HTTP, SOAP, Kafka, FIX. Architekturen muliggør nemt at tilføje støtte til nye formater; snart vil der også være støtte til IBM MQ. Hvis parsen af anmodningen fejler, vil connectoren returnere en fejl; ellers vil den svare, at anmodningen er blevet behandlet med succes, selvom der opstod en fejl under den efterfølgende behandling. Dette er gjort med vilje for at arbejde med systemer, der ikke kan gentage anmodninger — eller omvendt, gør det for insisterende. For at undgå tab af data anvendes en reparationskø: objektet går først ind i den, og efter succesfuld behandling bliver det fjernet derfra. En administrator kan modtage notifikationer om objekter, der er blevet i reparationskøen, og efter at have løst softwarefejlen eller hardwarefejlen kan forsøge behandlingen igen.
Input processor
Input processor klassificerer de modtagne data efter deres karakteristika og kalder de passende handlere. Handlere er kode skrevet i Lua, som kører i en sandkasse, og de kan derfor ikke påvirke systemets funktion. På dette stadium kan dataene bringes i det krævede format, og om nødvendigt kan et vilkårligt antal opgaver startes, som kan udføre nødvendig logik. For eksempel i MDM (Master Data Management) produktet, der er bygget på Tarantool Data Grid, når vi tilføjer en ny bruger, starter vi oprettelsen af den gyldne post som en separat opgave for ikke at forsinke behandlingen af anmodningen. Sandkassen understøtter anmodninger til læsning, ændring og tilføjelse af data og tillader udførelse af en funktion på alle roller af typen storage og aggregering af resultatet (map/reduce).
Handlere kan beskrives i filer:
sum.lua

local x, y = unpack(...)
return x + y
Og derefter deklareres i konfigurationen:
functions:
  sum: { __file: sum.lua }
Hvorfor Lua? Lua er et meget simpelt sprog. Baseret på vores erfaring begynder folk at skrive kode, der løser deres opgave efter et par timer med at lære det. Og det gælder ikke kun professionelle udviklere, men også for eksempel analytikere. Derudover, takket være JIT-kompilatoren, fungerer Lua meget hurtigt.
Storage
Lagring gemmer persistente data. Før gemmingen valideres dataene mod dataskemaet. Til at beskrive skemaet bruger vi et udvidet format . Eksempel:
{
    "name": "Bruger",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "fornavn", "type": "string"},
        {"name": "efternavn", "type": "string"}
    ],
    "indexes": ["id"]
}
Ud fra denne beskrivelse genereres der automatisk DDL (Data Definition Language) til databasesystemet Tarantool og skemaet til dataadgang.
Asynkron datareplication understøttes (med planer om at tilføje synkronisering).
Output processor
Nogle gange er det nødvendigt at informere eksterne forbrugere om ankomsten af nye data; til dette formål findes rollen Output processor. Efter gemmingen kan dataene sendes til deres tilsvarende behandler (for eksempel for at bringe dem i den form, som forbrugeren kræver) — og derefter sendes til connectoren for udsendelse. Her anvendes også en reparation kø: hvis objektet ikke blev accepteret af nogen, kan administratoren prøve igen senere.
Skalering
Rollerne connector, input processor og output processor har ingen tilstand, hvilket giver os mulighed for at skalere systemet horisontalt ved simpelt at tilføje nye instanser af applikationen med den ønskede rolle aktiveret. For at opnå horisontal skalerbarhed i lagringen anvendes til klusterorganisation ved hjælp af virtuelle buckets. Efter tilføjelsen af en ny server flyttes nogle buckets fra de gamle servere i baggrunden til den nye server; dette sker transparant for brugerne og påvirker ikke hele systemets funktion.
Datakvaliteter
Objekter kan være meget store og indeholde andre objekter. Vi sikrer atomaritet ved tilføjelse og opdatering af data, hvilket gør det muligt at gemme objektet med alle afhængigheder i en enkelt virtuel bucket. Dette eliminerer "udstrækning" af objektet over flere fysiske servere.
Versions understøttes: hver opdatering af et objekt skaber en ny version, og vi kan altid tage et tidsmæssigt snapshot og se, hvordan verden så ud dengang. For data, der ikke kræver en lang historie, kan vi begrænse antallet af versioner eller endda kun opbevare én — den seneste, hvilket effektivt deaktiverer versionering for en bestemt type. Vi kan også begrænse historikken tidsmæssigt: for eksempel ved at slette alle objekter af en bestemt type, der er ældre end 1 år. Arkivering understøttes også: vi kan eksportere objekter ældre end den angivne tid for at frigøre plads i klyngen.
Opgaver
Af interessante funktioner skal nævnes muligheden for at planlægge opgaver, anmode brugeren eller programmere dem fra sandkassen:
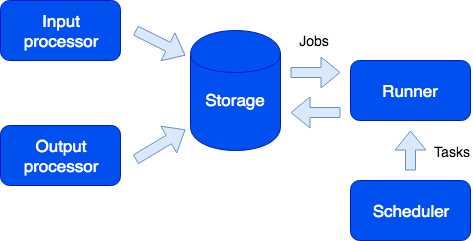
Her ser vi endnu en rolle — runner. Denne rolle har ikke nogen tilstand, og hvis nødvendigt, kan der tilføjes ekstra instanser af applikationen med denne rolle til klyngen. Runnerens ansvar er at udføre opgaver. Som nævnt kan der fra sandkassen oprettes nye opgaver; de gemmes i en kø på storage og udføres derefter på runneren. Denne type opgave kaldes Job. Vi har også en type opgave, der kaldes Task — disse er opgaver, som brugeren definerer og som kan køres efter en tidsplan (bruger cron-syntaks) eller på forespørgsel. For at starte og overvåge sådanne opgaver har vi en brugervenlig opgavestyrer. For at denne funktionalitet kan være tilgængelig, skal rollen scheduler aktiveres; denne rolle har en tilstand og skaleres ikke, hvilket dog ikke er nødvendigt; den kan dog, ligesom alle andre roller, have en replika, der begynder at arbejde, hvis master pludselig fejler.
Logger
En anden rolle kaldes logger. Den indsamler logs fra alle medlemmer af klyngen og giver et interface til eksport og visning gennem webinterfacet.
Tjenester
Det skal nævnes, at systemet gør det nemt at oprette services. I konfigurationsfilen kan man angive, hvilke forespørgsler der skal sendes til den brugerdefinerede handler, som køres i sandkassen. I denne handler kan man for eksempel udføre en analytisk forespørgsel og returnere resultatet.
En service beskrives i konfigurationsfilen:
services:
   sum:
      doc: "adderer to tal"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API genereres automatisk, og tjenesten bliver tilgængelig til kald:
query {
   sum(x: 1, y: 2)
}
Dette vil føre til kaldet af handleren sum, som vil returnere resultatet:
3
Profilering af forespørgsler og metrikker
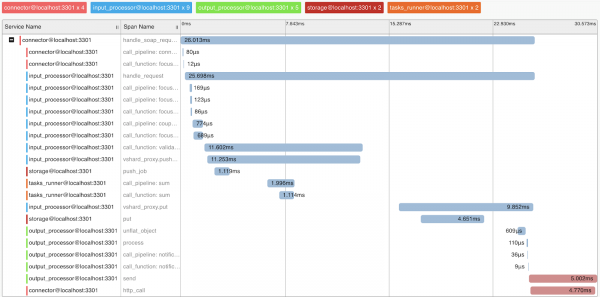
For at forstå systemets funktion og profilering af forespørgsler har vi implementeret støtte til OpenTracing-protokollen. Systemet kan efter anmodning sende information til værktøjer, der understøtter denne protokol, såsom Zipkin, hvilket gør det muligt at forstå, hvordan forespørgslen blev udført:
Naturligvis leverer systemet interne metrikker, som kan indsamles ved hjælp af Prometheus og visualiseres med Grafana.
Deploy
Tarantool Data Grid kan implementeres fra RPM-pakker eller arkiver, ved hjælp af værktøjet fra leverancen eller Ansible, og der er også støtte til Kubernetes ().
Applikationen, der implementerer forretningslogik (konfiguration, håndterere), indlæses i den implementerede Tarantool Data Grid-klynge som et arkiv via UI eller ved hjælp af et script, gennem det API, vi har givet.
Eksempler på applikationer
Hvilke applikationer kan oprettes med Tarantool Data Grid? Faktisk er de fleste forretningsopgaver på en eller anden måde relateret til behandling af dataflow, opbevaring og adgang til dataene. Så hvis du har store datastrømme, der skal opbevares pålideligt og være tilgængelige, kan vores produkt spare dig for meget udviklingstid, så du kan fokusere på din forretningslogik.
For eksempel ønsker vi at indsamle information om ejendomsmarkedet for senere at have information om de mest attraktive tilbud. I dette tilfælde vil vi fremhæve følgende opgaver:
- Roboter, der indsamler information fra åbne kilder - dette vil være vores datakilder. Du kan løse denne opgave ved at bruge færdige løsninger eller ved at skrive kode i ethvert sprog.
- Derefter vil Tarantool Data Grid modtage og gemme dataene. Hvis dataformatet fra forskellige kilder adskiller sig, kan du skrive kode i Lua, der vil konvertere til et ensartet format. På forhåndsbehandlingsniveauet kan du også for eksempel filtrere gentagne tilbud eller opdatere oplysninger i databasen om agenter, der arbejder på markedet.
- Nu har du allerede en skalerbar løsning i et cluster, som kan fyldes med data og foretages datatræk. Derfra kan du implementere nye funktioner, såsom at skrive en service, der anmoder om data og giver det mest fordelagtige tilbud inden for 24 timer — dette kræver et par linjer i konfigurationsfilen og lidt kode i Lua.
Hvad nu?
Vi prioriterer at forbedre udviklingsvenligheden med . For eksempel er dette en IDE med støtte til profilering og fejlfinding af håndterere, der kører i en sandkasse.
Vi lægger også stor vægt på sikkerhedsspørgsmål. Lige nu gennemgår vi certificering af FSTEC i Rusland for at bekræfte det høje sikkerhedsniveau og overholde de krav, der stilles til certificering af softwareprodukter brugt i informationssystemer for personlige data og statslige informationssystemer.
Kilde: habr.com
