

ved St-Petersburg
Hej alle sammen! Jeg er Mons Anderson, platformarkitekt , og jeg vil fortælle, hvordan vi byggede vores S3-lager, hvordan det fungerer, hvilke løsninger der var vellykkede, og hvilke vi ville ændre, hvis vi skulle starte et sådant projekt fra bunden nu.
Artiklen er baseret på et foredrag ved af Mail.ru Cloud Solutions & Tarantool. I artiklen vil vi tale om:
- hvordan Mail.ru-lageret var opbygget, som vi byggede vores S3-lager oven på;
- hvad vi tilføjede for at skabe Mail.ru Cloud Storage;
- hvordan objektlagermodellen fungerer, og hvilke skridt der er taget for at komme i produktion;
- om forbedringer af det aktive system: failover og skalering;
- hvordan vi implementerede sharding og re-sharding;
- samt om arbejdet med SSL-certifikater.
Hvis du ikke ønsker at læse, kan du .
Hvordan Mail.ru-lageret var opbygget, som vi byggede vores S3-lager oven på
Udviklingen af vores S3 begyndte oven på Mail.ru Cloud-lageret, så det er vigtigt først at fortælle, hvordan det er opbygget, og hvad det kan.
Mail.ru Cloud-lageret består af servere med diske. I gennemsnit er en moderne storage-server 36 diske á 12–14 terabyte. Tidligere var diskene mindre, men over de sidste tre år er diskstørrelserne vokset, og i dag er det næsten en halv petabyte rå data.
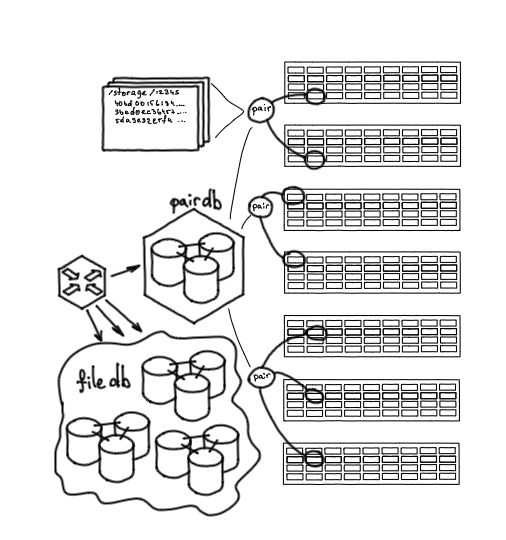
Diskene fra forskellige lager-servere samles i såkaldte ‘par’. Et par er en enkelt enhed til opbevaring af filer. Det er i bund og grund en disk, der er monteret i et bestemt partition på en bestemt sti, hvor filer, der er identifikation via hashes, kan opbevares.
Par er et historisk navn, som er bevaret til i dag, selvom der i et par ikke nødvendigvis kun skal være to diske. Der kan være tre diske, og der kan også være forskellige hybridlagringsformer, eksempelvis 3/2.
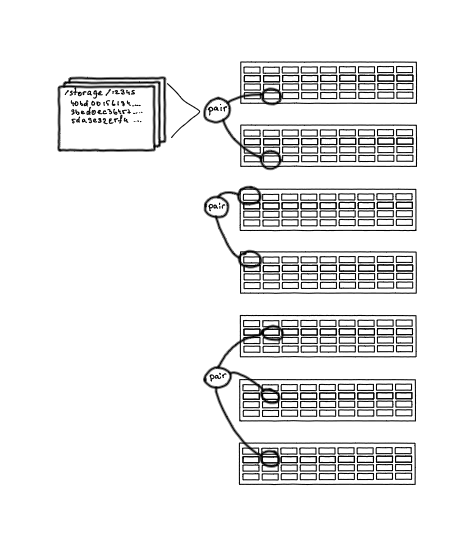
Par (pair) — enheder til opbevaring af objekter
Alle par gemmes i PairDB — en applikation baseret på Tarantool. Alle databaser i vores lager, fra de allerførste, er Tarantool, vi bruger ikke andre databaser.
PairDB gemmer alle par, deres tilstande, ledig plads, fejlmuligheder, seneste fejl. Den kan også selv tilgå parene, opdatere deres tilstand, kontrollere, om de fungerer eller ej. Så PairDB er et samlet øjebliksbillede af tilstanden for alle diske i vores system.
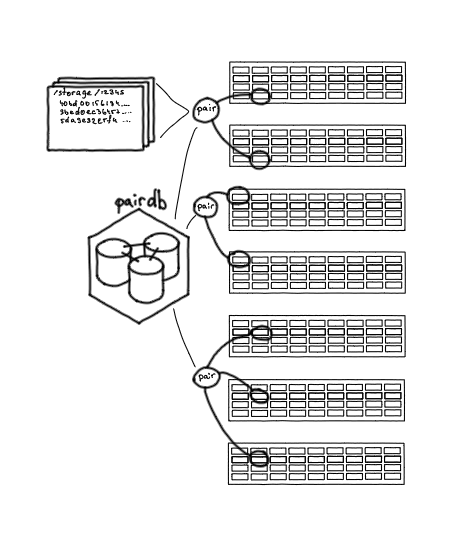
Pair DB: en database med tilstanden for par
Parterne gemmer filer, og for at vide, hvilke filer der er på hvilken par, er der brug for endnu en database - FileDB. Den gemmer mapping, hvilket definerer forholdet: filen sådan og sådan opbevares på par sådan og sådan, samt et lille antal nødvendige attributter.
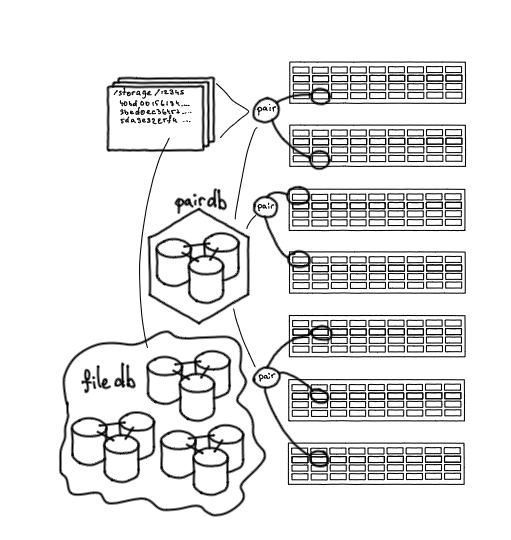 File DB: stedet, hvor filen opbevares
Et andet vigtigt element er service Nylon, en router til arbejde med databaser. Den fungerer som et enkelt punkt for adgang og tillader brug af et enhedligt interface til både PairDB og FileDB. Det er en stateless-service, den foretager belastningsbalancering af forespørgsler, forstår hvilken shard FileDB der skal tilgås, og ved, hvilke par der er aktive, og hvilke der ikke er.
Nylon: router til arbejde med databaser
Det er også nødvendigt at placere indhold i lageret. For dette formål findes der en service - Streamer. Den tilbyder to HTTP-metoder: PUT-metoden til at uploade indhold til lageret og GET-metoden til at hente det derfra. HTTP er et ret populært og bekvemt protokol til dataoverførsel.
Når vi henvender os til Streamer, kontakter den PairDB gennem Nylon, finder ud af, hvilken par filen kan uploades til, hvorefter den sender dataene via WebDAV til den pågældende par.
I bund og grund er enhver storage-server nginx plus diske, som er monteret på de angivne stier. Vi kan fra Streamer uploade en fil til lageret, slette den, omdøbe den eller kontrollere dens integritet. Det er med andre ord et praktisk interface til lavtliggende interaktion med lageret.
Streamer: indgangspunkt til lageret
Hvad vi har tilføjet for at skabe S3-lageret
Så vi har set på den grundlæggende opbygning af lageret på det tidspunkt, vi planlagde at lancere S3-lageret. Ved hjælp af PUT-metoden kunne vi placere vilkårligt indhold dér og modtage en hash som identifikator for disse data. Med denne identifikator kunne man senere komme og hente den originale fil. Men det er ikke tilstrækkeligt til at implementere S3. I S3-protokollen, ud over selve opbevaringen af objekter, er der:
- opbevaring af metadata - yderligere egenskaber for objekterne;
- organisering af adgang til objekterne via HTTP;
- gruppering af objekterne i samlinger - buckets;
- HTTP-S3 Endpoint. S3 organiserer data i bestemte strukturer - buckets, som hver især giver et indgangspunkt for opbevaring af filer.
For this logic to be implemented, a separate service was required. We also wanted to plan the architecture for the future growth of the service with linear scalability.
The first components
The daemon implementing the S3 API. This is the standard Amazon S3 API, which supports XML operations for metadata and allows direct content transfer. We didn't have to invent anything; everything is described and documented.
We also placed Nginx in front of the service. We used it for SSL termination, load balancing, and some logic in Lua (metrics, logging, and tracing).
For storing S3 metadata, we chose Tarantool. In the first version, the S3 daemon accessed this database for metadata, while the content was stored in a large storage through Streamer.
Nginx + S3 API + metadata
Object storage model
Let’s see how S3 works. A user can create a bucket — a collection of objects. A bucket is addressed by a hostname and is a subdomain of the service. Within a bucket, a user can create objects. The object identifier will be a URL. The content of the object is a blob, an array of binary data that we will store in the storage. The object also has attributes: the name — which is that URL, ACL (access control list), and other additional or custom attributes — all this is stored in metadata.
The normalized schema of this data might look like this: there are projects that own buckets, which own objects, and objects can be composite. Since one way to upload an object is by parts, there are two auxiliary tables for uploads and chunks. Projects also have credentials for access and billing.
Data schema
Since we were creating a B2B service with paid access, billing was necessary in this schema.
We also implemented the billing service on Tarantool.
Improvements to the S3 storage: steps to production
We have already created a working model that can be used: objects and metadata were stored, but a few aspects were missing for going into production.
For det første er der systemet med rate-limits. Hvis man kører tjenesten uden det, kan vi uforudsigeligt overbelaste et hvilket som helst område af systemet under peakbelastning. Rate-limit bør fungere sådan, at enhver S3-forespørgsel kommer til en specifik vært, hvor denne vært er en identifikator for bucketten, og bucketten tilhører en bestemt kunde. Vi skal definere en funktion for bucketten, der gør det muligt at beregne rate-limit.
Desuden skal systemet med rate-limits være tilstrækkeligt effektivt til at håndtere den belastning, der kommer til S3.
Her har vi igen brugt Tarantool. Rate-limits er et cluster bestående af 21 instanser, instanserne er opdelt i grupper, distribueret over tre fysiske noder og samlet i et stort topologisk cluster. Konfigurationsændringer spredes automatisk: rate-limits, standarder og konfiguration fastsættes. Hver bucket serviceres strengt af én instans. Når en specifik bucket modtager en forespørgsel, beregnes den instans, der er ansvarlig for denne bucket. Inden for denne node tælles den aktuelle forespørgselsrate med en algoritme, der ligner Token Bucket. Derefter fortæller rate-limit-systemet, baseret på de aktuelle belastningsdata og egenskaberne, der er indstillet for den specifikke bucket, om forespørgslen kan udføres eller ej. Grænsen kontrolleres på det tidligste stadie af udførelsen af S3-forespørgslen for at beskytte de øvrige systemelementer mod overbelastning.
Derudover er det ret svært at klare sig uden cache under belastning. I S3 forudsættes det gentagne anmodninger til de samme objekter, hvilket betyder, at det er et varmt lager. Normalt behandles anmodningen til en enkelt fil gennem hele kæden: Streamer, FileDB, PairDB, Storage. Men ved gentagne anmodninger til en fil optimerer vi adgangen til dette indhold ved hjælp af lokal cache.
Cachen er lagdelt og implementeret ved hjælp af nginx, lokale, SSD- og RAM-diske. Her har vi ikke brugt Tarantool, fordi det er lettere at levere objekter fra filsystemet, hvilket giver os mulighed for at lave caching tiering. Derudover har vi store objekter med en maksimal størrelse på 32 gigabyte, og i Tarantool kan man kun cache små objekter.
Dette var det første system, vi lancerede, og det havde en beregnet kapacitet, som var tilstrækkelig til at udforske og forstå produktet og sikre, at det ville fungere.
Forbedringer af kampsystemet: failover og skalering
Systemet var allerede i drift, men ved starten havde vi overset nogle ting — vi skulle have tilføjet failover og skalering.
Vores S3-demon hentede metadata via Tarantool-protokollen. Vi satte Tarantool som proxy-router for forespørgsler efter metadata på stedet for den originale database. Set fra applikationens side, der implementerede API'en, ændrede intet sig — den fortsatte med at tilgå databasen via Tarantool-protokollen, men routeren kunne sikre aktiv failover. Det vil sige, vi kunne kontrollere tilgængeligheden af noderne, tage pauser ved skift og fejl, og så videre. Applikationen blev dog ikke ændret.
Lær mere om, hvordan vi implementerede sharding
Det næste spørgsmål, som vi måtte tage os af — var sharding. Systemet voksede, antallet af objekter voksede, og vi måtte sikre muligheder for yderligere vækst.
Lad os vende tilbage til dataskemaet: der er projekter, buckets, credentials og billing. Dette er objekter, der højst sandsynligt ikke vil vokse ud over én instans hverken i volumen eller forespørgsler inden for den nærmeste fremtid. Så der er ikke nogen grund til at sharde dem, og vi har flyttet dem til en separat instans, som forbliver usharded. Dette gør det muligt at administrere projekter og buckets mere konsekvent, da der er et enkelt usharded punkt.
Der er også objekter i skemaet, som vokser lineært — i starten var der hundrede tusinde, og nu måles deres antal i milliarder. Sådanne objekter og deres dele skulle flyttes til en sharded cluster.
Vi delte skemaet op, men objekterne skal arbejde med buckets: et objekt tilhører altid en specifik bucket, plus der anvendes ACL på bucketen. Derfor holder vi en skyggekopia af hver bucket for hver shard med objekter. Derudover, under modifikation af objekter og udførelse af forespørgsler, skal vi tælle volumen for billing, så hver shard har tællere til billing.
Vi har også tilføjet et par ekstra tabeller og komponenter:
- en papirkurv til at slette gamle projekter, der bliver slettet eller fryset;
- en kø for baggrundsopgaver, hvilket betyder, at det primære lager kan udføre de nødvendige baggrundsopgaver på klyngen;
- livscyklusstøtte — en mekanisme, der tillader arbejde med objekter og styring af deres livscyklus.
Da vi har flyttet nogle data til shards, havde vi brug for en shardering-proxy. Vi kunne have genbrugt routeren til denne rolle, men en separat shardering-proxy, der kun beskæftiger sig med shardering af data, gør, at routeren kan hente data i sin helhed uden at tænke på shardering.
Jeg vil specifikt fortælle, hvorfor vi ikke tog en færdig løsning, men ønskede at lave en tilpasset shardering-funktion.
Lad os se, hvordan det er opbygget. Vi har 256 tilgængelige shards. For hver bucket tildeler vi et interval ved hjælp af en konsistent funktion. Det er enkelt — ligesom når du ved hjælp af en konsistent funktion bestemmer tilhørsforhold til en shard, bestemmer du den startende shard og tildeler et interval:
f(bucket, shards) = subset
Det vil sige, at hvis vi tager en bucket, kan vi sige, at den og dens data altid vil være placeret i et specifikt underudvalg af alle shards. Dette reducerer indflydelsen fra én bucket på en anden og forenkler arbejdet med map-reduce forespørgsler, når det for eksempel skal laves en liste over objekter i en bucket. For dette skal vi forespørge alle shards, hvor disse objekter er gemt. Hvis objekterne lå på alle shards, ville enhver listeoperation påvirke hele systemet, men her påvirker det kun et specifikt underudvalg.
Dernæst — hvert objekt tilhører en specifik bucket, så når vi anmoder om et objekt, anmoder vi om objektet med navn i den specifikke bucket. Det vil sige, at vi kan definere en funktion for objektet ikke fra hele det tilgængelige interval af shards, men kun fra underudvalget af dets bucket:
f(object, subset) = shard
Vi tager et specifikt objekt, og som argumenter for funktionen sender vi ikke alle shards, men et underudvalg af dets bucket — og får en specifik shard.
Så, shardingen er implementeret, der er en shardering-proxy. Det, der er tilbage, er at hente fra routeren og database med metadata ind i shardering-proxien. For eksempel til oprettelse af objekter til skyggekopier — når vi opretter en bucket, skal det primære lager oprette en repræsentant for denne bucket på alle shards, hvor den skal være til stede.
Hvordan vi implementerede resharing
Den største udfordring ved sharding er resharding. Det var vigtigt for os at gøre det uden nedetid, da systemet allerede var i produktion. Jeg vil vise, hvordan vi løste problemet ved hjælp af et tilsvarende eksempel med live migration af data fra et projekt til et andet.
Nedenfor er diagrammet over vores klynge, som det så ud efter implementeringen af sharding. Vi har nginx, S3 API, en router, en primær database med projekter, en sharding-proxy og selve shards.
Tidligere overså jeg det punkt, at der på et bestemt tidspunkt i projektet var en produktopgave: „At lancere endnu en opbevaring, Icebox, som Hotbox, men kun til kolde data“. I bund og grund en lignende opbevaring, men med andre URL'er og uden caches.
Icebox blev brugt mindre end Hotbox, derfor fungerede det forholdsvis længe uden nogen form for sharding. I sidste ende besluttede vi at opgive det og kombinere Hotbox og Icebox til en enkelt service ved blot at dele lagringsklasserne.
Buckets i opbevaringerne overlapper ikke, de kunne let smeltes sammen og flyttes, men kunderne brugte både det ene og det andet opbevaringssystem, så vi var nødt til at løse problemet med fraværet af nedetid. Man kunne ikke bare slukke og kopiere. Vi udførte migration i flere trin.
I første omgang synkroniserede vi de primære opbevaringer. Vi havde Tarantool, og vi kunne ved oprettelse af et objekt gøre det sådan:
- en anmodning om oprettelse af en bucket kommer til databasen, f.eks. i Hotbox;
- Tarantool kontrollerer i en anden database (i dette tilfælde – i Icebox), at der ikke er nogen sådan bucket;
- hvis bucket findes, meddeler databasen, at den ikke kan oprettes, og den synkroniseres som eksisterende.

Synkronisering af buckets
I den opbevaring, der skulle modtage alle data, indførte vi for projekter og buckets et flag, der angav, hvor dette objekt opbevares. Det kunne være lokalt i Hotbox, i Icebox – så vil der ikke være nogen data i den nye opbevaring, eller det kunne være i en migrationsstatus.
Hvis et projekt eller en bucket havde flaget Migrating, blev anmodningen under migrationen først udført i den nye opbevaring, hvor dataene burde være, og hvis de ikke var der, blev anmodningerne sendt til den alternative opbevaring.
Derefter skiftede vi trafikken. Da API'et kunne betjene anmodninger fra både Icebox og Hotbox, kunne vi uden nedetid skifte trafikken ved blot at flytte værter og tilføje de relevante poster i Nginx.
Når trafikken var omdirigeret, kunne Nginx og API fra Icebox fjernes.
Derefter fjernede vi Icebox nginx og S3 API - og alt virkede:
Derefter startede vi en baggrundsproces for migration, som kører inde i databasen - det gennemgår element for element alle projekter og deres buckets, sætter dem i status Migrating, overfører dataene, og efter overførslen sætter det status til Local.
Efter dataoverførslen har vi ikke længere brug for det gamle lagersystem, og vi fjerner de resterende dele af det gamle system samt fjerner understøttelsen af migreringsstatus fra koden.
Den samme tilgang blev anvendt til resharding fra det gamle lager til det sharded:
- Vi markerede alle buckets som
Non-sharded. Alle forespørgsler til dem gik til det originale, ikke-shardede lager. - Nye buckets blev straks oprettet med status
Sharded. - Vi tog én bucket ad gangen, satte status til
Migratingog overførte dataene.
Forespørgsler blev behandlet med følgende princip:
- Læs først fra det nye, derefter fra det gamle.
- Opret kun i det nye.
- Opdater i to faser: hvis det nye ikke har det, overfør fra det gamle til det nye, og derefter opdater.
Arbejdet med SSL-certifikater
På frontend anvender vi Nginx. I vores tilfælde er det ikke en almindelig Nginx, men OpenResty, Nginx med understøttelse af LuaJIT.
Et andet stykke af systemet - arbejdet med SSL-certifikater. I S3-lageret kan du tilføje et eget domæne til adgang til en specifik bucket, blot ved hjælp af CNAME. Men uden HTTPS kan man ikke i dag: et eget domæne forudsætter et eget SSL-certifikat.
Som jeg allerede har sagt, er det Nginx, der står for belastningsbalancering og SSL-terminering. I vores tilfælde er det ikke en almindelig Nginx, men OpenResty, Nginx med understøttelse af LuaJIT.
Dette gjorde det muligt for os at lære vores Nginx at afgive vilkårlige certifikater ret nemt. Desuden var det nødvendigt at afgive certifikater dynamisk (uden at skulle angive dem i konfigurationsfilen). Vi brugte udvidelsen ssl_certificate_by_lua, som gør det muligt at læse certifikatet fra en vilkårlig kilde under TLS-handshake. Til certifikatlagring anvendte vi også Tarantool: dette gør det muligt at administrere certifikater udefra og sikrer ekstremt hurtig levering.
Der blev også implementeret en separat daemon, hvis opgave er regelmæssigt at opdatere certifikater, der blev udstedt ved hjælp af Let’s Encrypt.
Hvad ville jeg have gemt, og hvad ville jeg have gjort anderledes, hvis jeg skulle udvikle lageret fra bunden
Hvad skulle have været brugt fra starten
Sharding med det samme. Der har været en del problemer med resharding. Det er let at gøre, men hvis man starter projekter, der skal skaleres, er det bedre at tage en sharded klynge fra starten, selv på et minimum af noder. Implementeringen af sharding fra starten er næsten gratis sammenlignet med at indføre sharding i et driftsystem.
At arbejde med Tarantool gennem load balancers. Nu kobler vi alle nye databaser til arbejdet gennem load balancers. Det giver mulighed for at udvide funktionaliteten og opnå højere fejlresistens.
Auto-failover. Jeg ville have installeret alle de værktøjer, der kræves til auto-failover, da de første fejlslag efter lanceringen var relateret til dets fravær. Efter erfaringen med S3 blev alle efterfølgende produkter lanceret med dette i tankerne.
S3-funktionen "Versioning". Først syntes det ikke at være en særlig efterspurgt funktionalitet. At integrere denne mulighed i arkitekturen af et fungerende system er ekstremt vanskeligt.
Separat billing. Den måde, vi integrerede billing i vores system, fungerede godt i starten, men senere blev det problematisk; det ville have været bedre at have det som en helt separat service.
Hvad der var en vellykket løsning
Datamodel. Historien har vist, at vi i takt med udviklingen af tjenesten ret præcist passer til datamodellen fra Amazon, så vi kan implementere de funktioner, der findes der.
Shardingskema. Jeg ville have støttet den samme sortering af sharding efter buckets, da det gør det muligt at fordele forespørgsler fra forskellige buckets over en stor klynge.
Brug af Tarantool. Tarantool har været en stor hjælp i udviklingen af tjenesten og dens modifikation; vi arbejdede nemt med dataene, transformerede og sharded lageret uden at skulle opbygge et lag i applikationen.
Denne præsentation blev første gang præsenteret ved by Mail.ru Cloud Solutions&Tarantool. Se andre præsentationer og tilmeld dig nyhedsbreve om arrangementer på Telegram .
Du kan også se mit gamle foredrag om S3 eller læse min kollegas artikel om bloklagring.
- .
- .
Kilde: habr.com
