

Hej, jeg er Sergey Ylantsev, jeg udvikler i Yandex.Cloud. Tidligere ledede jeg udviklingen af L7-belasteren til Yandex' portal - mine kolleger spøger med, at uanset hvad jeg laver, så ender det som en belaster. Jeg vil fortælle læserne på Habr, hvordan man skal håndtere belastningen i cloudplatformen, hvordan vi ser det ideelle værktøj til at nå dette mål, og hvordan vi bevæger os hen imod konstruktionen af dette værktøj.
For at begynde, lad os introducere nogle termer:
- VIP (Virtual IP) - IP-adressen for belasteren
- Server, backend, instans - en virtuel maskine med en kørende applikation
- RIP (Real IP) - IP-adressen for serveren
- Healthcheck - serverens klarheds kontrol
- Tilgængelighedszone, Availability Zone, AZ - isoleret infrastruktur i datacenteret
- Region - en sammenslutning af forskellige AZ
Belastere løser tre hovedopgaver: de udfører selve belastningen, forbedrer servicepålidelighed og forenkler dens skalering. Pålidelighed sikres gennem automatisk trafikstyring: belasteren overvåger applikationens tilstand og udelukker instanser, der ikke har bestået livstest. Skalering sikres gennem jævn fordeling af belastningen på instanserne samt ved at opdatere listen over instanser i realtid. Hvis belastningen ikke er jævnt fordelt, så vil nogle af instanserne få en belastning, der overskrider deres arbejdskapacitet, og servicen vil blive mindre pålidelig.
Belastere klassificeres ofte efter protokolniveauet fra OSI-modellen, som de arbejder på. Cloud-belasteren arbejder på TCP-niveau, hvilket svarer til det fjerde niveau, L4.
Lad os gå videre til en oversigt over arkitekturen for Cloud-belasteren. Vi vil gradvist øge detaljeniveauet. Vi opdeler komponenterne af belasteren i tre klasser. Config plane-klassen er ansvarlig for interaktionen med brugeren og gemmer systemets måltilstand. Control plane gemmer systemets aktuelle tilstand og styrer systemerne fra data plane-klassen, som er ansvarlig for at levere trafik fra kunderne til dine instanser.
Data plane
Traffic travels to expensive devices called border routers. To enhance fault tolerance, multiple such devices operate simultaneously in a single data center. Next, the traffic goes to load balancers, which announce an anycast IP address to all AZs using BGP.
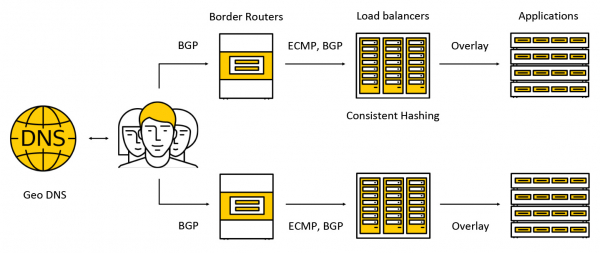
Traffic is transmitted using ECMP — a routing strategy whereby multiple equally good routes to a destination (in our case, the destination IP address) can exist, allowing packets to be sent via any of them. We also support operation across multiple availability zones in the following scheme: we announce the address in each zone, and the traffic reaches the nearest and does not go beyond it. Later in the post, we will take a closer look at what happens with the traffic.
Config plane
The key component of the config plane is the API through which the main operations with load balancers are performed: creating, deleting, changing the composition of instances, obtaining health check results, etc. On one hand, this is a REST API, and on the other hand, we in the Cloud frequently use the gRPC framework, hence we "translate" REST into gRPC and further use only gRPC. Each request leads to the creation of a series of asynchronous idempotent tasks that are executed on a common pool of workers in Yandex.Cloud. The tasks are written in such a way that they can be paused at any time and then restarted. This ensures scalability, repeatability, and logability of operations.
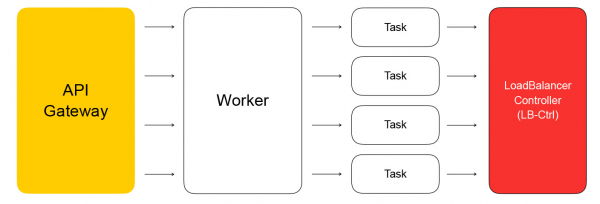
As a result, a task from the API will make a request to the service controller of load balancers, which is written in Go. It can add and remove load balancers, change the composition of backends and settings.
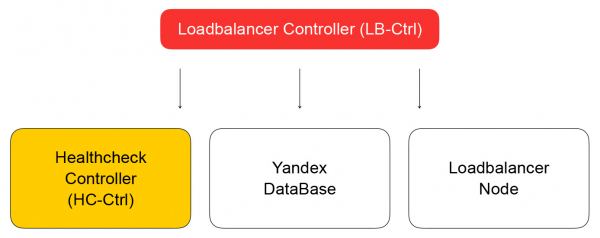
The service stores its state in Yandex Database — a distributed managed DB that you will soon be able to use as well. In Yandex.Cloud, as we have already mentioned, , there is the concept of dog food: if we use our services ourselves, our clients will also be happy to use them. Yandex Database is an example of such a concept in action. We store all our data in YDB, so we do not have to think about maintaining and scaling the database: those problems are solved for us, and we use the database as a service.
Lad os vende tilbage til balanceringscontrolleren. Dens opgave er at gemme information om balanceringssystemet og sende en opgave til at kontrollere, om den virtuelle maskine er klar, til healthcheck controlleren.
Healthcheck controller
Den modtager forespørgsler om ændring af kontrolreglerne, gemmer dem i YDB, distribuerer opgaverne til healthcheck-noderne og aggregerer resultaterne, som derefter gemmes i databasen og sendes til loadbalancer controlleren. Dette sender igen en forespørgsel om at ændre sammensætningen af klyngen til data plane på loadbalancer-node, som jeg vil fortælle mere om senere.
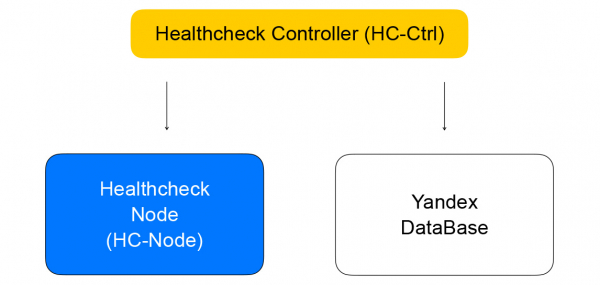
Lad os tale mere om healthchecks. De kan opdeles i flere klasser. Kontrollerne har forskellige succescriteria. TCP-kontroller skal klart etablere en forbindelse inden for en bestemt tid. HTTP-kontroller kræver både en vellykket forbindelse og et svar med statuskode 200.
Desuden varierer kontrollerne efter handlingsklasse — de kan være aktive eller passive. Passive kontroller holder blot øje med, hvad der sker med trafikken, uden at iværksætte nogen særlige handlinger. Dette fungerer ikke så godt på L4, da det afhænger af logikken fra højere niveau protokoller: På L4 er der ingen information om, hvor lang tid operationen tog, og om afslutningen af forbindelsen var god eller dårligt. Aktive kontroller kræver, at balanceringssystemet sender forespørgsler til hver serverinstans.
Størstedelen af balanceringssystemerne udfører 'livstjek' automatisk. I vores Cloud har vi besluttet at opdele disse dele af systemet for at øge skalerbarheden. Denne tilgang vil gøre os i stand til at øge antallet af balanceringssystemer, mens vi opretholder antallet af healthcheck-forespørgsler til tjenesten. Kontrollerne udføres af separate healthcheck-noder, som er sharderede og replikerede mål for kontrollerne. Det er ikke muligt at udføre kontroller fra én vært, da denne kan fejle. Så vil vi ikke få status på de kontrollerede instanser. Vi udfører kontroller på enhver instans fra mindst tre healthcheck-noder. Målene for kontrollerne sharder vi mellem noderne ved hjælp af algoritmer til konsistent hashing.
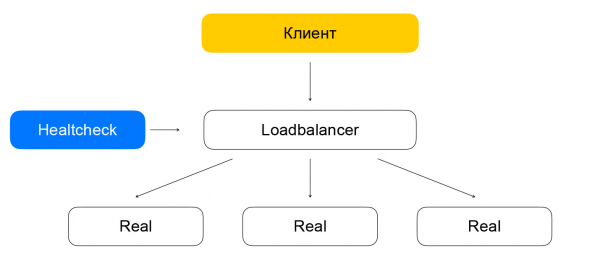
Adskillelsen mellem balancering og healthcheck kan medføre problemer. Hvis healthcheck-noden foretager anmodninger til instansen udenom balanceringssystemet (som i øjeblikket ikke håndterer trafik), opstår der en besynderlig situation: ressourcen ser ud til at være aktiv, men trafikken når ikke frem til den. Vi løser dette problem ved garanteret at sende healthcheck-trafik gennem balanceringssystemerne. Med andre ord adskiller skemaet for pakkeoverførsel af trafik fra kunder og healthchecks sig minimalt: i begge tilfælde når pakkerne frem til balanceringssystemerne, som leverer dem til de ønskede ressourcer.
Forskellen er, at kunderne sender anmodninger til VIP, mens healthchecks henvender sig til hver enkelt RIP. Her opstår et interessant problem: vi giver vores brugere mulighed for at oprette ressourcer i grå IP-netværk. Forestil dig, at der er to forskellige ejere af skyder, som har skjult deres tjenester bag balanceringssystemer. Hver af dem har ressourcer i subnettet 10.0.0.1/24, og de har de samme adresser. Det er nødvendigt at kunne skelne dem på en eller anden måde, og her skal vi dykke ned i strukturen af det virtuelle netværk i Yandex. Cloud. Detaljer kan du bedre finde ud af i , det er nu vigtigt for os at forstå, at netværket er lagdelt og indeholder tunneler, som kan skelnes efter subnet-ID.
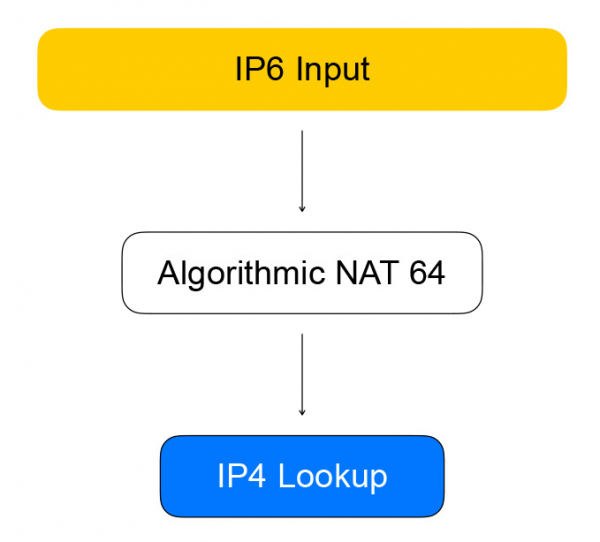
Healthcheck-noder henvender sig til balanceringssystemerne ved hjælp af såkaldte quasi-IPv6-adresser. En quasi-adresse er en IPv6-adresse, hvor IPv4-adressen og brugerens subnet-ID er indlejret. Trafikken når frem til balanceringssystemet, som udpakkes IPv4-adressen fra ressourcen, erstatter IPv6 med IPv4 og sender pakken videre i brugerens netværk.
Den omvendte trafik går på samme måde: balanceringssystemet ser, at destinationen er et gråt netværk fra healthcheckere, og omdanner IPv4 til IPv6.
VPP - hjertet af data plane
Balanceringssystemet er implementeret på teknologien Vector Packet Processing (VPP) - et framework fra Cisco til pakke behandling af netværkstrafik. I vores tilfælde fungerer frameworket oven på user-space-biblioteket til styring af netværksenheder - Data Plane Development Kit (DPDK). Dette sikrer høj ydeevne ved behandling af pakker: i kernen er der betydeligt færre afbrydelser, og der er ingen kontekstskift mellem kernel space og user space.
VPP går et skridt videre og udnytter systemets ydeevne endnu mere ved at samle pakker i batches. Ydeevnen forbedres takket være aggressiv brug af moderne processorers caches. Der bruges både datacacher (pakkerne behandles "i vektorer", hvor data ligger tæt på hinanden) og instruktionscacher: i VPP følger behandlingen af pakker en graf, hvor noderne indeholder funktioner, der udfører én opgave.
For eksempel behandles IP-pakker i VPP i følgende rækkefølge: først sker parseringen af pakkehovederne i noden, og derefter sendes de til en node, der videresender pakkerne i henhold til routingtabellerne.
Lidt hardcore. Forfatterne af VPP går ikke på kompromis i brugen af processorens caches, så typisk kode til behandling af vektorpakker indeholder manuel vektorisering: der er en behandlingsløkke, hvor scenariet "vi har fire pakker i kø" behandles, derefter det samme for to, og derefter for én. Der bruges ofte prefetch-instruktioner til at indlæse data i caches for at fremskynde adgangen til dem i de næste iterationer.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame(vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // behandling af flere pakker ad gangen
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Prefetch næste iteration. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer(vm, from[2]);
            p3 = vlib_get_buffer(vm, from[3]);

            vlib_prefetch_buffer_header(p2, LOAD);
            vlib_prefetch_buffer_header(p3, LOAD);

            CLIB_PREFETCH(p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH(p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // faktisk behandling af data
        /* bekræft spekulative enqueue, måske skift nuværende næste frame */
        vlib_validate_buffer_enqueue_x2(vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // behandling af pakker én ad gangen
    }

    // behandlet batch
    vlib_put_next_frame(vm, node, next_index, n_left_to_next);
}
Så Healthchecks henvender sig til VPP via IPv6, som omdanner dem til IPv4. Dette håndteres af grafens node, som vi kalder algoritmisk NAT. For den omvendte trafik (og omdannelsen fra IPv6 til IPv4) er der den samme node for algoritmisk NAT.
Direkte trafik fra klienter til loadbalancer går gennem grafens noder, der udfører selve belastningsbalanceringen.
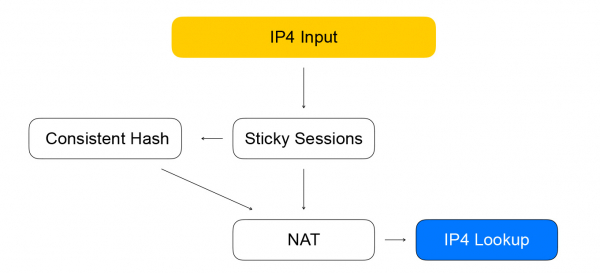
Den første node — sticky sessions. Her opbevares en hash af for established sessions. The 5-tuple includes the address and port of the client sending the information, the address and port of the resources available for receiving traffic, as well as the network protocol.
The hash from the 5-tuple helps us perform fewer computations in the subsequent node of consistent hashing and better handle changes to the list of resources behind the load balancer. When a packet arrives at the load balancer with no session, it is sent to the consistent hashing node. Here, balancing occurs using consistent hashing: we select a resource from the list of available 'live' resources. Then packets are sent to the NAT node, which performs the actual destination address replacement and recalculates checksums. As you can see, we follow VPP rules—similar to similar, grouping similar computations to increase CPU cache efficiency.
Consistent hashing
Why did we choose it and what is it anyway? To begin, let's look at the previous task—selecting a resource from the list.
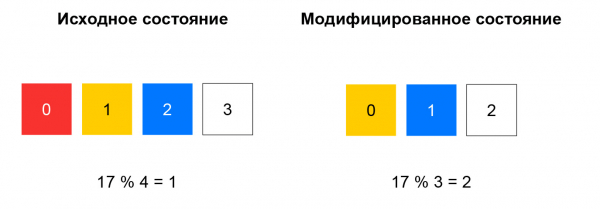
With inconsistent hashing, the hash of the incoming packet is calculated, and the resource is selected from the list based on the remainder of the division of this hash by the number of resources. As long as the list remains unchanged, this scheme works well: we always send packets with the same 5-tuple to the same instance. However, if, for instance, a resource stops responding to health checks, then a significant portion of the hashes will change. The client's TCP connections will break: a packet that previously went to instance A may start going to instance B, which is not familiar with the session for this packet.
Consistent hashing solves the described problem. The simplest way to explain this concept is to imagine that you have a ring on which you distribute resources by hash (for example, by IP:port). Choosing a resource is like turning a wheel at an angle determined by the hash of the packet.
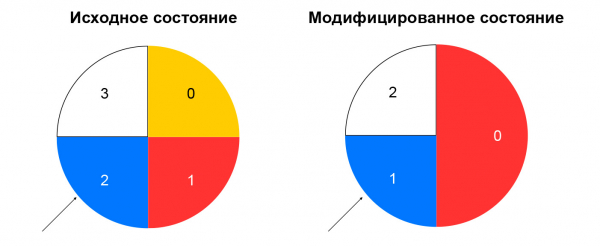
This minimizes traffic redistribution when the list of resources changes. Removing a resource will only affect that part of the consistent hashing ring where the resource was located. Adding a resource also changes the distribution, but we have a sticky sessions node that allows already established sessions not to switch to new resources.
Vi har set på, hvad der sker med den direkte trafik mellem belastningsbalanceren og ressourcerne. Lad os nu se på den omvendte trafik. Den følger samme mønster som kontroltrafikken — gennem algoritmisk NAT, det vil sige gennem omvendt NAT 44 for klienttrafik og gennem NAT 46 for healthcheck-trafik. Vi holder os til vores eget skema: vi standardiserer healthcheck-trafikken og den faktiske trafik fra brugerne.
Loadbalancer-node og komponenter i samlet form
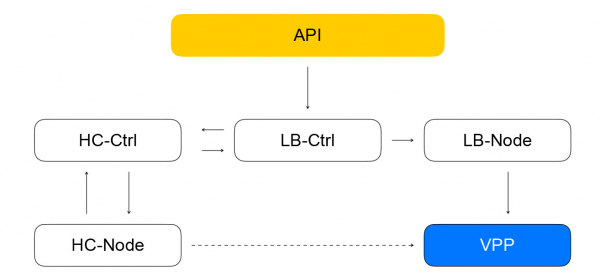
Loadbalancer-node informer om sammensætningen af belastningsbalancere og ressourcer i VPP. Den abonnerer på en strøm af hændelser fra loadbalancer-controlleren, er i stand til at opbygge forskellen mellem den aktuelle tilstand af VPP og den måltilstand, der er modtaget fra controlleren. Vi får et lukket system: hændelser fra API'en kommer til belastningsbalancerens controller, som sætter healthcheck-controlleren opgaver til at kontrollere "livligheden" af ressourcerne. Denne, igen, sætter opgaver i healthcheck-node og aggregerer resultaterne, som derefter gives tilbage til belastningsbalancerens controller. Loadbalancer-node abonnerer på hændelser fra controlleren og ændrer staten af VPP. I et sådant system kender hver tjeneste kun det nødvendige om nabo-tjenesterne. Antallet af forbindelser er begrænset, og vi har mulighed for at udnytte og skalere forskellige segmenter uafhængigt.
Hvilke spørgsmål vi undgik
Alle vores tjenester i kontrolplanet er skrevet i Go og har gode egenskaber hvad angår skalering og pålidelighed. Der er mange open source-biblioteker i Go til opbygning af distribuerede systemer. Vi bruger aktivt GRPC, alle komponenter indeholder en open source-implementering af service discovery — vores tjenester holder øje med hinandens tilstand, kan ændre deres sammensætning dynamisk, og vi har forbundet dette med GRPC-belastningsbalancering. Til målinger bruger vi også en open source-løsning. I dataplanen har vi opnået anstændig ydeevne og en stor ressourcekapacitet: det viste sig, at det var meget udfordrende at samle en stand, hvor man kunne ramme ydeevnen af VPP og ikke den fysiske netværkskort.
Problemer og løsninger
Hvad gik ikke så godt? I Go er hukommelsesstyring automatisk, men der kan stadig være hukommelseslækager. Den nemmeste måde at håndtere dem på er at køre goroutines og huske at afslutte dem. Konklusion: Hold øje med hukommelseskonsumtionen af Go-programmer. Antallet af goroutines er ofte en god indikator. Der er en fordel i denne historie: Det er nemt at få runtime-data i Go — om hukommelsesforbrug, antallet af kørende goroutines og mange andre parametre.
Desuden er Go muligvis ikke det bedste valg til funktionelle tests. De er ret omstændelige, og den standard tilgang med 'at køre alt i CI i grupper' passer ikke så godt til dem. Problemet er, at funktionelle tests er mere ressourcekrævende, og de kan opleve rigtige timeouts. Dette kan føre til, at tests mislykkes, da CPU'en er optaget af enhedstest. Konklusion: Udfør 'tunge' tests separat fra enhedstest, hvis det er muligt.
Mikrotjenestearkitektur er mere kompleks end en monolit: At gennemgå logs på mange forskellige maskiner er ikke særligt praktisk. Konklusion: Hvis du laver mikrotjenester, så tænk straks på tracing.
Vores planer
Vi vil lancere en intern balancerer, en IPv6-balancerer, tilføje support til Kubernetes-scripts, fortsætte med at shard vores tjenester (i øjeblikket er kun healthcheck-node og healthcheck-ctrl sharded), tilføje nye healthchecks og implementere smart aggregation af checks. Vi overvejer at gøre vores tjenester endnu mere uafhængige — så de kommunikerer ikke direkte med hinanden, men via en meddelelseskø. Der er for nylig blevet lanceret en SQS-kompatibel tjeneste i skyen. .
Der har for nylig været en offentlig udgivelse af Yandex Load Balancer. Udforsk tjenesten, administrer balancerne på en måde, der passer dig, og øg fejltolerance i dine projekter!
Kilde: habr.com
