

I de første to artikler har jeg rejst spørgsmålet om automatisering og skitseret dens ramme, i den anden gjorde jeg et sidespring til netværksvirtualisering som den første tilgang til automatisering af servicekonfiguration.
Og nu er det tid til at tegne diagrammet for det fysiske netværk.
Hvis du ikke har meget kendskab til datacenterets netværksudstyr, anbefaler jeg kraftigt at starte med .
Alle udgivelser:
De praktikker, der beskrives i denne serie, skal kunne anvendes på netværk af enhver type, enhver skala og med enhver variation af leverandører (ikke). Dog kan man ikke beskrive et universelt eksempel på anvendelse af disse tilgange. Derfor vil jeg fokusere på den moderne arkitektur af datacenteret: .
DCI vil blive lavet på MPLS L3VPN.
Over det fysiske netværk fungerer et Overlay-netværk fra hosten (det kan være VXLAN fra OpenStack eller Tungsten Fabric eller hvad som helst andet, der kun kræver grundlæggende IP-konnektivitet fra netværket).
I dette tilfælde vil der være et relativt enkelt scenarie for automatisering, fordi vi har meget udstyr, der konfigureres ensartet.
Vi vælger en sfærisk datacenter i et vakuum:
- En version af designet overalt.
- To leverandører danner to planer af netværket.
- Et datacenter ligner et andet som to dråber vand.
Indhold
- Fysisk topologi
- Routing
- IP-plan
- Lab
- Konklusion
- Nyttige links
Lad vores serviceudbyder LAN_DC f.eks. hoste undervisningsvideoer om at overleve indespærret i elevatorer.
I storbyer er dette ekstremt populært, så der skal mange fysiske maskiner til.
Først vil jeg beskrive netværket som det kunne se ud i vores ønsker. Derefter vil jeg forenkle det til lab.
Fysisk topologi
Lokationer
LAN_DC vil have 6 datacentre:
- Rusland (RU):
- Moskva (msk)
- Kazan (kzn)
- Spanien (SP):
- Barcelona (bcn)
- Malaga (mlg)
- Kina (CN):
- Shanghai (sha)
- Xi'an (sia)

Inden for datacentret (Intra-DC)
I alle datacentre er der identiske interne netværk baseret på Clos-topologien.
Hvad er Clos-netværkene, og hvorfor netop dem — i et separat .
I hvert datacenter er der 10 reoler med maskiner, de vil blive nummereret som A, B, C Og så videre.
I hver reol er der 30 maskiner. De vil ikke interessere os.
Derudover er der i hver reol en switch, som alle maskinerne er tilsluttet — det er Top of the Rack switch — ToR eller på anden måde, i termerne fra Clos-fabrikken, vil vi kalde det Leaf.

Den overordnede skitse af fabrikken.
Vi vil kalde dem XXX-leafY, hvor XXX — en tre-bogstav forkortelse for DC, og Y — rækkenummer. For eksempel, kzn-leaf11.
I artiklerne tillader jeg mig at bruge termerne Leaf og ToR ret frit som synonymer. Men det er vigtigt at huske, at det ikke er korrekt.
ToR er en switch, der er installeret i et rack, til hvilken maskiner tilsluttes.
Leaf er en enheds rolle i det fysiske netværk eller en førstegenerations switch i Clos-topologi.
Det vil sige, Leaf != ToR.
Så en Leaf kan være en EndofRaw-switch, for eksempel.
Men i denne artikel vil vi alligevel bruge dem som synonymer.
Hver ToR-switch er igen forbundet til fire overordnede aggregerende switcher — Spine. Der er afsat én rack til Spine i DC. Vi navngiver dem tilsvarende: XXX-spineY.
I det samme rack vil der stå netværksudstyr til forbindelse mellem datacentre — 2 routere med MPLS om bord. Men i det store hele er det de samme ToR'er. Det vil sige, at fra Spine-switchers synspunkt er det ligegyldigt om det er en almindelig ToR med tilsluttede maskiner eller en router til DCI — det er ligegyldigt at forwarde.
Disse specialiserede ToR'er kaldes Edge-leaf. Vi vil kalde dem XXX-edgeY.
Det vil se sådan ud.
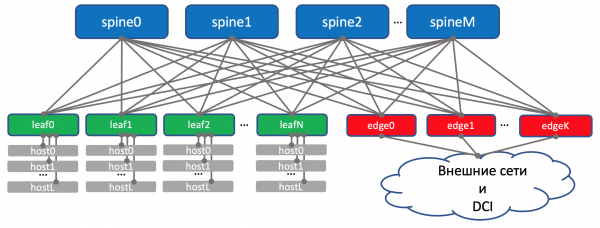
I skemaet ovenfor har jeg faktisk placeret edge og leaf på samme niveau. har vænnet os til at betragte uplink (heraf termen) som forbindelser opad. Men her viser det sig, at ‘uplink’ DCI går tilbage nedad, hvilket lidt bryder den vante logik. I tilfælde af store netværk, hvor datacentrene deles i endnu mindre enheder — POD‘er (Point Of Delivery), tildeles separate Edge-POD‘er til DCI og forbindelse til eksterne netværk.
For at forenkle forståelsen vil jeg alligevel tegne Edge over Spine, mens vi holder i mente, at der ikke er nogen intelligens på Spine og ingen forskelle i arbejdet med almindelige Leaf og Edge-leaf (selvom der kan være nuancer, men generelt er det sådan).
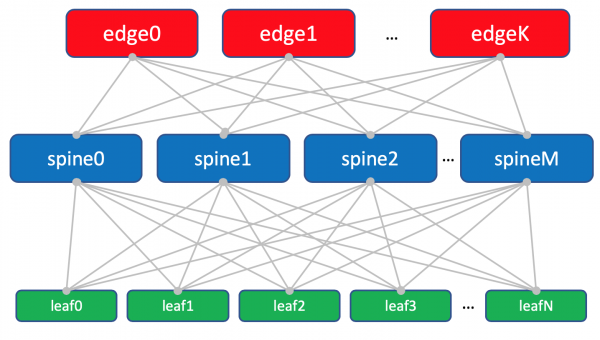
Skemaet for fabrikken med Edge-leaf'er.
Trekløveret Leaf, Spine og Edge danner undersystemnetværket eller fabrikken.
Opgaven for netværksfabrikken (læs Underlay), som vi allerede har fastslået i , er meget, meget simpel — at sikre IP-forbindelse mellem maskiner både inden for et DC og mellem.
Derfor kaldes netværket en fabrik, ligesom fabrikken til switching inde i modulære netværksbokse, som man kan læse mere om i .
Generelt kaldes en sådan topologi en fabrik, fordi fabric på dansk betyder stof. Og det er svært at være uenig:
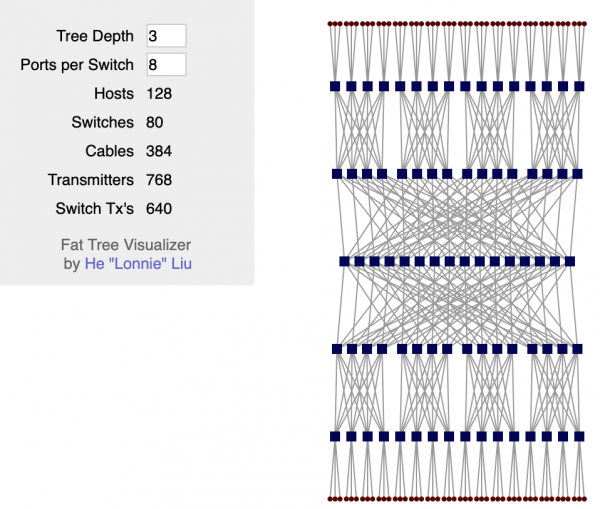
Fabrikken er helt L3. Ingen VLAN, ingen Broadcast — sådan er vores fantastiske programmører i LAN_DC, de kan skrive applikationer, der lever i L3-paradigmet, og virtuelle maskiner kræver ikke Live Migration med bevarelses af IP-adressen.
Og endnu en gang: svaret på spørgsmålet om, hvorfor en fabrik og hvorfor L3, findes i en separat .
DCI — Data Center Interconnect (Inter-DC)
DCI vil blive organiseret ved hjælp af Edge-Leaf, så de er vores udgangspunkt til hovedledningen.
For enkelhedens skyld lad os antage, at DC'erne er forbundet med direkte links.
Lad os udelukke ekstern tilslutning fra vores overvejelser.
Jeg er klar over, at hver gang jeg fjerner en komponent, forenkler jeg netværket betydeligt. Og ved automatisering af vores abstrakte netværk vil alt gå godt, mens der i det virkelige vil opstå udfordringer.
Det er rigtigt. Og alligevel er formålet med denne serie at tænke over og arbejde med tilgange, ikke at løse opfundne problemer heroisk.
På Edge-Leaf'erne placeres underlaget i VPN og overføres via MPLS-hovedledningen (den direkte forbindelse).
Her er den overordnede skitse.

Routing
Til ruting inden for DC'en vil vi bruge BGP.
På MPLS-hovedledningen OSPF+LDP.
Til DCI, det vil sige til organisering af forbindelsen i underlaget — BGP L3VPN over MPLS.
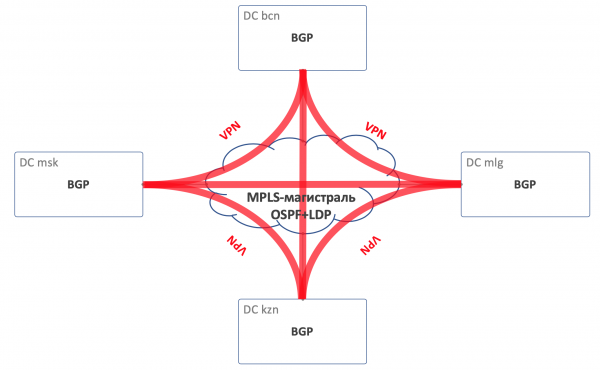
Den overordnede rutineskema
I fabrikken er der ingen OSPF og ISIS (som er et forbudt rutingsprotokol i Den Russiske Føderation).
Og det betyder, at der ikke vil være Auto-discovery eller beregning af de korteste stier — kun manuel (faktisk automatisk — vi handler om automatisering her) konfiguration af protokoller, naboer og politikker.
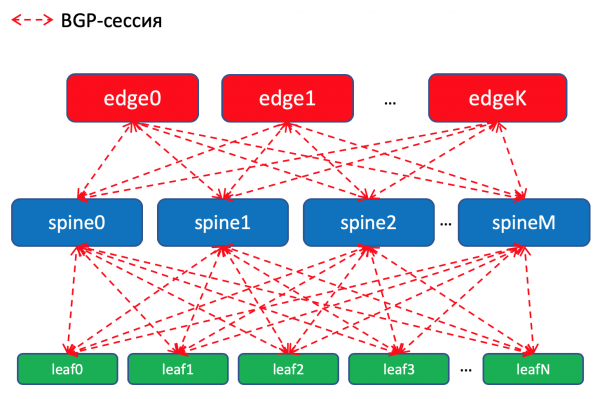
Skema for BGP-routing inden for DC'en
Hvorfor BGP?
Der er meget at sige om dette emne, med Facebook og Arista, som beskriver, hvordan man bygger meget store datacenter-netværk ved hjælp af BGP. Det læses nærmest som skønlitteratur, meget anbefalet til en stille aften.
Der er også et helt afsnit i min artikel om dette. Hvor jeg også .
Men hvis vi skal opsummere kort, så er ingen IGP'er passende til netværk med store datacentre, hvor udstyret tælles i tusinder.
Desuden vil brugen af BGP overalt gøre det muligt ikke at sprede sig over at støtte flere forskellige protokoller og synkronisering mellem dem.
Hånd på hjertet, på vores fabrik, som sandsynligvis ikke vil vokse hurtigt, ville OSPF være tilstrækkeligt. Det er faktisk problemer for megaskaler og cloud-titaner. Men lad os fantasere lidt i nogle udgaver om, at vi har brug for det, og vi vil bruge BGP, som Peter Lapukhov har foreskrevet.
Routingpolitikker
På Leaf-switchene importerer vi BGP-præfikser fra underlag-interfacet med netværk.
Vi vil have en BGP-session mellem hvert par Leaf-Spine, hvor disse underlag-præfikser vil blive annonceret rundt i netværket.
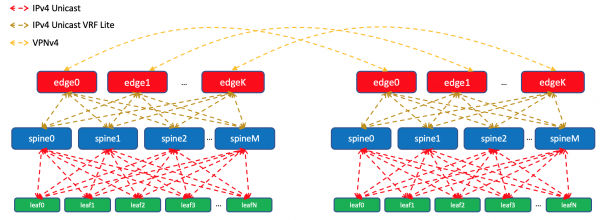
Inden for et datacenter vil vi distribuere specifikationerne, som vi har importeret til ToR. På Edge-Leafs vil vi aggregere dem og annoncere dem til fjerne datacentre og ned i ToR’ene. Det vil sige, at hver ToR præcist vil vide, hvordan man når den anden ToR i dette datacenter og hvor indgangen er for at nå ToR i et andet datacenter.
I DCI vil ruter blive overført som VPNv4. Til dette vil Edge-Leaf interfacet mod fabrikken blive placeret i en VRF, som vi kalder UNDERLAY, og naboskabet med Spine på Edge-Leaf vil blive oprettet inden for VRF'en, mens der mellem Edge-Leafs i VPNv4-familien.
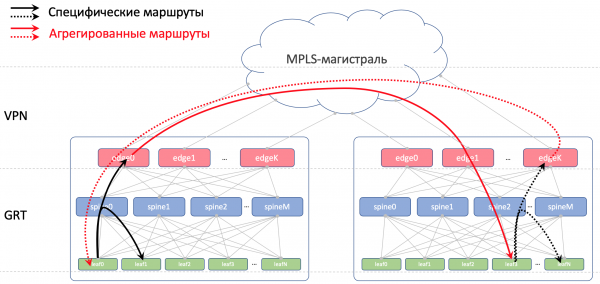
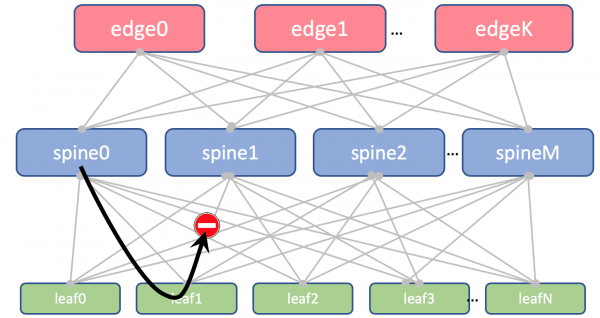
Og vi vil også forbyde at reannonce ruter, der er modtaget fra spine, tilbage til dem.
På Leaf og Spine vil vi ikke importere Loopback. De vil kun være nødvendige for at bestemme Router ID.
Men på Edge-Leafs importerer vi det til Global BGP. Mellem Loopback-adresser vil Edge-Leafs oprette en BGP-session i IPv4 VPN-family med hinanden.
Mellem EDGE-enhederne vil vi have en strakt backbone på OSPF+LDP. Alt i én zone. En meget simpel konfiguration.
Sådan ser billedet ud med routing.
BGP ASN
Edge-Leaf ASN
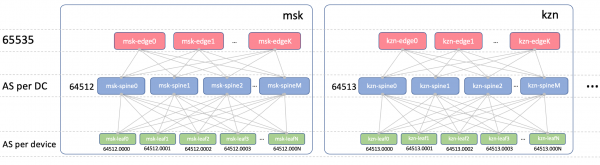
På Edge-Leafs vil der være én ASN i alle datacentre. Det er vigtigt for at have iBGP mellem Edge-Leafs, så vi ikke løber ind i nuancerne i eBGP. Lad os sige, at det bliver 65535. I virkeligheden kunne det have været nummeret på et offentligt AS.
Spine ASN
På Spine vil vi have én ASN pr. datacenter. Lad os starte her med det første nummer fra området af private AS — 64512, 64513 osv.
Hvorfor ASN i datacenteret?
Lad os nedbryde dette spørgsmål i to:
- Hvorfor ens ASN på alle spine i ét datacenter?
- Hvorfor forskellige i forskellige datacentre?
Hvorfor ens ASN på alle spine i ét datacenter
Sådan vil AS-Path for underlag-ruten på Edge-Leaf se ud:
[leafX_ASN, spine_ASN, edge_ASN]
Når man forsøger at annoncere det tilbage på Spine, vil den afvise det, fordi dens AS (Spine_AS) allerede er på listen.
Men vi er helt tilfredse med, at Underlay-ruterne, der er steget til Edge, ikke kan gå ned igen inden for datacenteret. Al kommunikation mellem værter inden for datacenteret skal foregå på spines-niveau.
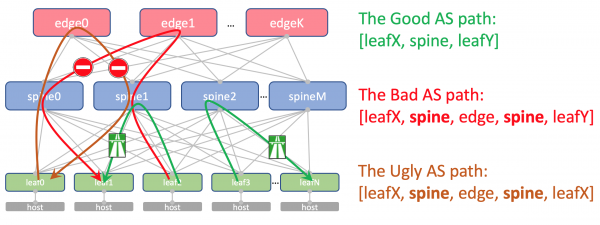
De aggregerede ruter fra andre datacentre vil dog uden problemer nå frem til ToR'erne — deres AS-Path vil kun indeholde ASN 65535 — nummeret for Edge-Leaf'ene, da de netop blev oprettet på dem.
Hvorfor forskellige i forskellige datacentre
Teoretisk set kan vi have brug for at forbinde Loopback'ene fra nogle service-VM'er mellem datacentre.
For eksempel vil vi køre en Route Reflector på værten eller (Virtual Network Gateway), som via BGP vil forbinde sig med ToR'en og annoncere sin loopback, som skal være tilgængelig fra alle datacentre.
Sådan vil dens AS-Path se ud:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Og her må der ikke være nogen gentagne ASN.
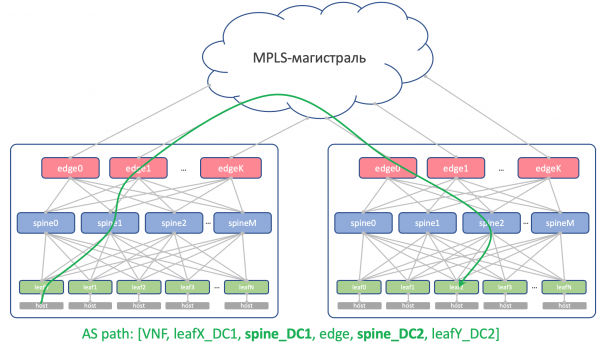
Det vil sige, Spine_DC1 og Spine_DC2 skal være forskellige, ligesom leafX_DC1 og leafY_DC2, hvilket vi netop er ved at tilpasse.
Som du måske ved, findes der hacks, der gør det muligt at modtage ruter med gentagne ASN på trods af mekanismen til at forhindre loops (allowas-in på Cisco). Dette har endda legitime anvendelser. Men det udgør et potentielt hul i netværkets stabilitet. Og jeg har personligt været ude for det et par gange.
Og hvis vi har muligheden for ikke at bruge farlige løsninger, vil vi gøre det.
Leaf ASN
Vi vil have en individuel ASN for hver Leaf-switch i hele netværket.
Vi gør dette af de grunde, der er nævnt ovenfor: AS-Path uden loops, BGP-konfiguration uden sårbarheder.
For at ruterne mellem Leaf'ene kan passere uhindret, skal AS-Path se sådan ud:
[leafX_ASN, spine_ASN, leafY_ASN]
hvor det ville være godt, hvis leafX_ASN og leafY_ASN adskilte sig.
Dette er også nødvendigt i situationen med annoncering af VNF loopback mellem datacentre:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Vi vil bruge 4-bytes ASN og generere det baseret på Spine's ASN og Leaf-switch nummeret, nemlig sådan her: Spine_ASN.0000X.
Sådan ser billedet ud med ASN.
IP-plan
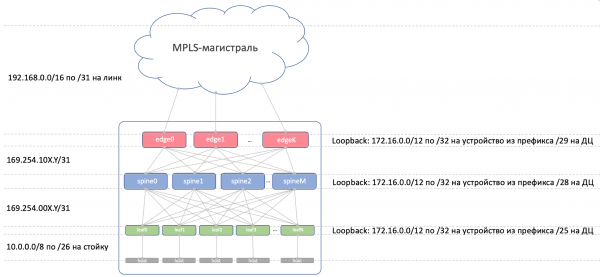
Principielt set skal vi tildele adresser til følgende forbindelser:
- Underlay-netværksadresserne mellem ToR og maskinen. De skal være unikke i hele netværket, så enhver maskine kan kontakte enhver anden. En perfekt løsning er 10/8. En /26 til hver reol med overskud. Vi vil tildele /19 til datacenteret og /17 til regionen.
- Link-adresserne mellem Leaf/Tor og Spine.
De involverede enheder skal tildeles algoritmisk, dvs. beregnes ud fra navne på de enheder, der skal tilsluttes.
Lad det være... 169.254.0.0/16.
Specifikt 169.254.00X.Y/31, hvor X — nummer på Spine, Y — P2P-netværk /31.
Dette vil muliggøre opstart af op til 128 racks og op til 10 Spine i datacenteret. Linkadresser kan (og vil) blive gentaget fra datacenter til datacenter. - Vi organiserer forbindelsen mellem Spine - Edge-Leaf på subnettene 169.254.10X.Y/31, hvor det vil være det samme X — nummer på Spine, Y — P2P-netværk /31.
- Linkadresser fra Edge-Leaf til MPLS-hovedlinjen. Her er situationen lidt anderledes — det er stedet, hvor alle dele samles i én enhed, så det er ikke muligt at genbruge de samme adresser — vi skal vælge det næste ledige subnet. Derfor vil vi tage udgangspunkt i 192.168.0.0/16 og trække de ledige fra.
- Loopback-adresser. Vi vil give dem hele området 172.16.0.0/12.
- Leaf — /25 pr. datacenter — de samme 128 racks. Vi tildeler /23 til regionen.
- Spine — /28 pr. datacenter — op til 16 Spine. Vi tildeler /26 til regionen.
- Edge-Leaf — /29 pr. datacenter — op til 8 enheder. Vi tildeler /27 til regionen.
Hvis vi i datacenteret ikke har nok tildelte intervaller (og vi vil ikke have det — vi sigter mod hyperskalering), tildeler vi blot det næste blok.
Sådan ser IP-adresseringen ud.
Loopback’e:
Præfiks
Enhedens rolle
Region
Datacenter
172.16.0.0/23
edge
172.16.0.0/27
dk
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
dk
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
dk
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay:
Præfiks
Region
Datacenter
10.0.0.0/17
dk
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Lab
To leverandører. Ét netværk. ADSM.
Juniper + Arista. Ubuntu. Den gode gamle Eva.
Antallet af ressourcer på vores virtuelle maskine i Miran er trods alt begrænset, så til praksis vil vi bruge et så forsimpleret netværk som muligt.
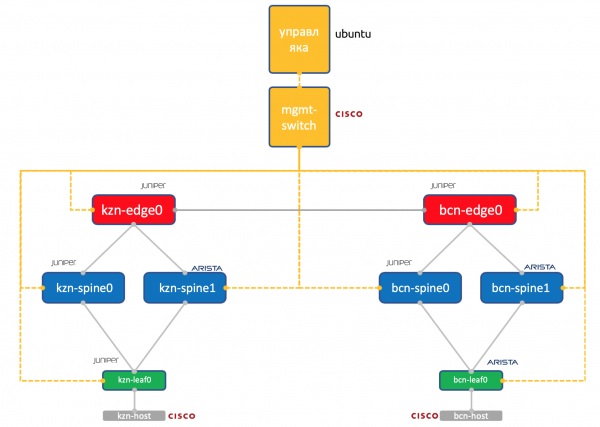
To datacentre: Kazan og Barcelona.
- To spines i hver: Juniper og Arista.
- Én tor (Leaf) i hver — Juniper og Arista, med én tilsluttet vært (vi tager en letvægtig Cisco IOL til dette).
- Én Edge-Leaf node (kun Juniper indtil videre).
- En Cisco switch til at herske over dem alle.
- Udover netværksbokse er der startet en virtuel styringsmaskine. Under Ubuntu.
Den har adgang til alle enheder; der vil køre IPAM/DCIM-systemer, et udvalg af Python-scripts, Ansible og alt muligt andet, vi måtte få brug for.
af alle netværksenheder, som vi vil forsøge at reproducere med automation.
Konklusion
Er det også almindelig praksis? At lave en kort afslutning under hver artikel?
Så vi har valgt Clos-netværk inde i datacenteret, fordi vi forventer meget East-West trafik og ønsker ECMP.
Vi har delt netværket op i fysisk (underlay) og virtuel (overlay). Overlay begynder med værten — dermed har vi forenklet kravene til underlay.
Vi valgte BGP som protokol til routing af underlægningsnetværk på grund af dens skalerbarhed og fleksibilitet i politikerne.
Vi vil have separate noder til at organisere DCI - Edge-leaf.
På backbone vil der være OSPF+LDP.
DCI vil blive implementeret på basis af MPLS L3VPN.
For P2P-links IP-adresser vil vi beregne algorithmisk baseret på enhedernes navne.
Loopbacks vil blive tildelt i henhold til enhedernes roller og deres placering sekventielt.
Underlægningspræfikser - kun på Leaf-switchere sekventielt baseret på deres placering.
Lad os antage, at vi lige nu ikke har installeret udstyret.
Derfor vil vores næste skridt være at registrere dem i systemerne (IPAM, inventar), organisere adgang, generere konfigurationen og implementere den.
I den næste artikel vil vi undersøge Netbox - et system til inventarisering og styring af IP-området i datacenteret.
Tak
- Andrei Glazkov aka @glazgoo for korrektur og rettelser
- Alexander Klimenko aka @v00lk for korrektur og rettelser
- Artyom Chernobay for KDPV
Kilde: habr.com
