

Hej alle. Jeg arbejder som senior systemadministrator hos OK og har ansvaret for portalen's stabilitet. Jeg vil gerne fortælle om, hvordan vi har opbygget en proces for automatisk skiftnings af harddiske, og hvordan vi derefter udelukkede administratoren fra denne proces og erstattede ham med en bot.
Denne artikel er en form for transliterering til HighLoad+ 2018
Opbygning af processen for skift af harddiske
Først nogle tal
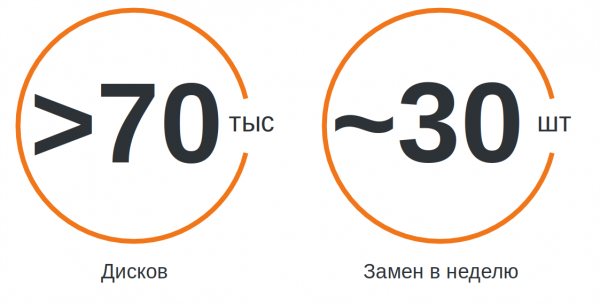
OK er en gigantisk tjeneste, der bruges af millioner af mennesker. Den drives af cirka 7.000 servere, der er placeret i 4 forskellige datacentre. Serverne har over 70.000 harddiske. Hvis man lægger dem oven på hinanden, får man et tårn, der er over 1 km højt.
Harddiske er den komponent i servere, der oftest svigter. Med sådanne mængder skal vi skifte omkring 30 diske om ugen, og denne procedure er blevet en mindre behagelig rutine.
Hændelser
I vores virksomhed er der indført fuld hændelseshåndtering. Hver hændelse registreres i Jira, hvorefter vi løser og gennemgår den. Hvis hændelsen havde en effekt for brugerne, samles vi og overvejer, hvordan vi hurtigt kan reagere i sådanne tilfælde, hvordan vi kan reducere effekten, og selvfølgelig hvordan vi kan forhindre gentagelser.
Lagringsenheder er ingen undtagelse. Deres tilstand overvåges af Zabbix. Vi monitorerer beskeder i Syslog for fejl ved skrivning/læsning, analyserer tilstanden af HW/SW-RAID, overvåger SMART, og for SSD'er beregner vi slid.
Hvordan diskene blev skiftet tidligere
Når der i Zabbix tændes for en alarm, oprettes der en hændelse i Jira, som automatisk tildeles de relevante ingeniører i datacentrene. Vi gør dette for alle HW-hændelser, det vil sige sådanne, der kræver fysisk arbejde med udstyr i datacentret.
Datacenter-ingeniøren er den person, der håndterer spørgsmål relateret til hardware, står for installation, vedligeholdelse, og afmontering af servere. Når han modtager en ticket, går ingeniøren i gang. I diskkabinet skifter han selv diske. Men hvis han ikke har adgang til den nødvendige enhed, henvender ingeniøren sig til de vagthavende systemadministratorer for hjælp. Først skal disken tages ud af rotation. For dette skal de nødvendige ændringer foretages på serveren, applikationerne stoppes, og disken afmonteres.
Den vagthavende systemadministrator er ansvarlig for portalens drift i løbet af arbejdsdagen. Han undersøger hændelser, udfører reparationer og hjælper udviklerne med mindre opgaver. Han beskæftiger sig dog ikke med harddiske.
Tidligere kommunikerede datacenter-ingeniører med systemadministratorer i chatten. Ingeniørerne sendte links til Jira-billetter, og administratoren fulgte dem, førte en log over arbejdet i en eller anden notesbog. Men for sådanne opgaver er chatten upraktisk: informationen er ikke struktureret og går hurtigt tabt. Desuden kunne administratoren blot være væk fra computeren og ikke svare på anmodninger i et stykke tid, mens ingeniøren stod ved serveren med en bunke diske og ventede.
Det værste var dog, at administratorerne ikke kunne se det store billede: hvilke diskproblemer der eksisterede, og hvor potentielle problemer kunne opstå. Dette skyldes, at vi overdrager alle HW-hændelser til ingeniørerne. Ja, man kunne vise alle hændelser på administratorens dashboard. Men der er så mange, og administratoren blev kun involveret i nogle af dem.
Derudover kunne ingeniøren ikke korrekt prioritere, fordi han ikke vidste noget om formålet med de specifikke servere, eller hvordan informationen var fordelt på lagermedierne.
Ny udskiftningsprocedure
Det første, vi gjorde, var at opdele alle diskproblemer i en særskilt type "HW-disk" og tilføje felterne "navn på blokenhed", "størrelse" og "disktype", så denne information blev gemt i billetten, og vi ikke konstant skulle udveksle den i chatten.
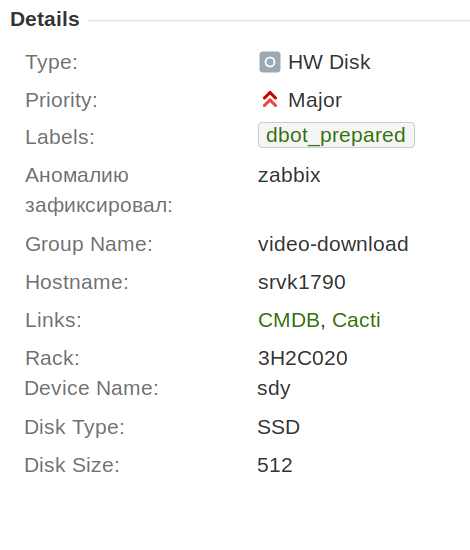
Vi blev også enige om, at vi kun ville udskifte én disk inden for én hændelse. Dette har væsentligt forenklet den efterfølgende automatiseringsproces, indsamlingen af statistik og arbejdet.
Derudover tilføjede vi feltet "ansvarlig administrator". Der indsættes automatisk den vagthavende sysadmin. Det er meget praktisk, fordi ingeniøren altid kan se, hvem der er ansvarlig. Man behøver ikke at gå ind i kalenderen og lede. Netop dette felt gjorde det muligt at vise billetter på administratorens dashboard, hvor hans hjælp måske vil være nødvendig.
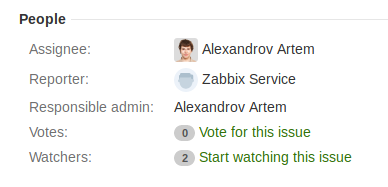
For all participants to gain the maximum benefit from the innovations, we created filters and dashboards, and informed the team about them. When people understand the changes, they do not distance themselves from them as something unnecessary. It is important for the engineer to know the rack number where the server is located, the size and type of the disk. The administrator needs, first and foremost, to understand what group of servers this is and what effect there may be from replacing the disk.
Having fields and their display is convenient, but it has not relieved us from the need to use chats. For this, we had to change the workflow.
It used to be like this:
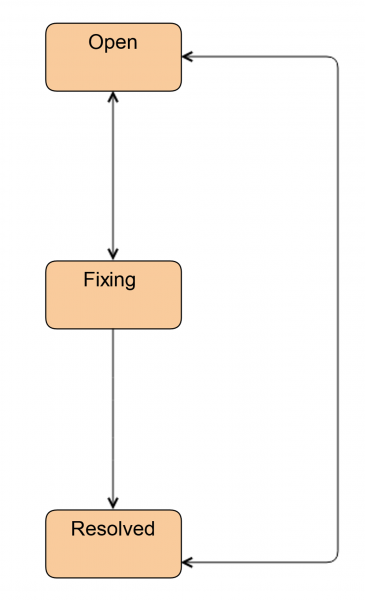
Today, this is how engineers continue to work when they do not require the administrator's assistance.
The first thing we did was introduce a new status Investigate. In this status, the ticket is located when the engineer still hasn't decided whether they will need the administrator or not. Through this status, the engineer can pass the ticket to the administrator. Additionally, we use this status to mark tickets when a disk replacement is required, but the disk itself is not on site. This can happen in the case of CDN and remote sites.
We also added a status Klar. Tickets are transferred to this status after the disk replacement. This means everything is already done, but the HW/SW RAID is synchronizing on the server. This can take quite a long time.
If the administrator is involved in the work, the scheme becomes a bit more complicated.
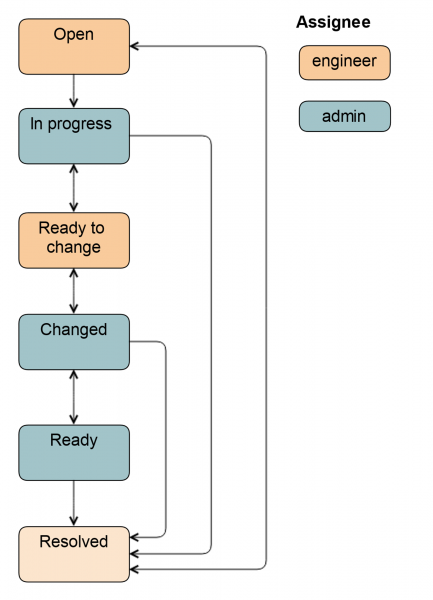
From the status Åben , the ticket can be transferred by both the system administrator and the engineer. In the status In progress , the administrator removes the disk from rotation so that the engineer can simply pull it out: they turn on the light, unmount the disk, stop applications, depending on the specific group of servers.
Then the ticket is transferred to Ready to change: this is a signal to the engineer that the disk can be pulled out. All fields in Jira are already filled in, and the engineer knows the type and size of the disk. This information is filled in either automatically in the previous status or by the administrator.
After the disk replacement, the ticket is transferred to the status Changed. It is checked that the correct disk was inserted, marking is done, the application is started, and some data recovery tasks are executed. Additionally, the ticket can be transferred to the status Klar, in which case the administrator will remain responsible, because they registered the disk in rotation. The complete scheme looks like this.
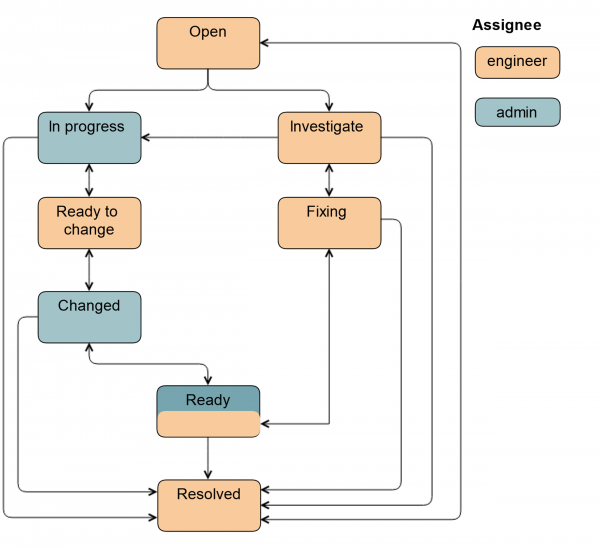
Tilføjelsen af nye felter har betydeligt lettet vores arbejde. Folkene arbejder nu med struktureret information, og det er blevet klart, hvad og hvornår der skal gøres noget. Prioriteterne er blevet langt mere relevante, da de nu fastsættes af administratoren.
Behovet for chats er forsvundet. Selvfølgelig kan administratoren skrive til ingeniøren "her skal der skiftes hurtigere", eller "det er allerede aften, når kan du skifte?". Men vi kommunikerer ikke længere dagligt i chats om disse emner.
Diske skiftes nu i større mængder. Hvis administratoren kommer lidt tidligere på arbejde, har han lidt tid og der er ikke opstået noget endnu, kan han forberede en række servere til udskiftning: angive felter, fjerne diske fra rotation og overdrage opgaven til ingeniøren. Ingeniøren kommer lidt senere til datacenteret, ser opgaven, henter de nødvendige lagringsenheder fra lageret og skifter dem med det samme. Resultatet er, at udskiftningshastigheden er steget.
Erfaringer fra opbygningen af Workflow
- Når man opbygger proceduren, skal man indsamle information fra forskellige kilder.
Nogle af vores administratorer vidste ikke, at ingeniøren selv skifter diske. Nogle troede, at ingeniørerne holdt øje med synkroniseringen af MD RAID, selvom nogle af dem ikke engang havde adgang til det. Nogle af de førende ingeniører gjorde det, men ikke altid, fordi processen ikke var dokumenteret nogen steder. - Proceduren skal være simpel og forståelig.
Det er svært for et menneske at holde styr på mange trin. De vigtigste sammenhængende statuser i Jira skal vises på hovedskærmen. Man kan omdøbe dem, for eksempel kalder vi "In progress" for "Ready to change". De øvrige statuser kan skjules i en dropdown-menu, så de ikke forstyrrer. Men det er bedst ikke at begrænse folk, men give dem mulighed for at lave overgange.
Forklar værdien af ændringerne. Når folk forstår, tager de bedre imod den nye procedure. For os var det meget vigtigt, at folk ikke bare klikkede sig igennem hele processen, men fulgte den. Senere opbyggede vi automatisering baseret på dette. - Vent, analyser, forstå.
Vi brugte cirka en måned på at opbygge proceduren, den tekniske implementering, møder og diskussioner. Og det tog mere end tre måneder at gennemføre. Jeg har set, hvordan folk langsomt begynder at bruge nyheden. I de tidlige faser var der meget negativitet. Men det var slet ikke afhængigt af selve proceduren eller dens tekniske implementering. For eksempel brugte en administrator ikke Jira, men et Jira-plugin i Confluence, og nogle ting var utilgængelige for ham. Da vi viste ham Jira, steg hans produktivitet både på generelle opgaver og ved diskudskiftninger.
Automatisering af diskudskiftninger
Vi har forsøgt at automatisere diskudskiftninger flere gange. Vi havde allerede nogle forberedelser, scripts, men de fungerede enten interaktivt eller manuelt og krævede en opstart. Og først efter implementeringen af den nye procedure indså vi, at det netop var den, vi havde manglet.
Da vi nu har opdelt udskiftningsprocessen i faser, hvor hver fase har en bestemt ansvarlig og en liste over handlinger, kan vi implementere automatiseringen trin for trin i stedet for at gøre det hele på én gang. For eksempel kan den enkleste fase - Ready (kontrol af RAID/data synkronisering) - nemt delegeres til en bot. Når botten har lært sig lidt, kan vi give den en mere ansvarlig opgave - at indføre disken i rotation mm.
Zoologisk have af opsætninger
Før vi fortæller om botten, lad os lave en lille ekskurs til vores zoologiske have af installationer. For det første skyldes det den enorme størrelse af vores infrastruktur. For det andet prøver vi at finde den optimale hardwarekonfiguration til hver service. Vi har omkring 20 modeller af hardware RAID, primært LSI og Adaptec, men der findes også HP og DELL i forskellige versioner. Hver RAID-controller har sit eget administrationsværktøj. Sættet af kommandoer og output kan variere fra version til version for hver RAID-controller. Hvor hardware-RAID ikke anvendes, kan mdraid være til stede.
Næsten alle nye installationer laver vi uden diskreservéringer. Vi forsøger at undgå at bruge hardware- og software RAID, da vi reservér vores systemer på datacenter-niveau og ikke server-niveau. Men selvfølgelig er der mange legacy-servere, som vi skal vedligeholde.
Nogle steder anvendes diske i RAID-controllere som rå enheder, mens andre steder bruger JBOD. Der findes konfigurationer med én systemdisk i serveren, og hvis den skal udskiftes, skal serveren geninstalleres med operativsystemet og applikationerne, herunder de samme versioner, hvorefter konfigurationsfilerne tilføjes, og applikationerne startes. Der er også mange grupper af servere, hvor redundans ikke administreres på niveauet for det diskbaserede system, men direkte i selve applikationerne.
I alt har vi mere end 400 unikke grupper af servere, der kører omkring 100 forskellige applikationer. For at dække et så stort antal varianter havde vi brug for et multifunktionelt automatiseringsværktøj. Gerne med et simpelt DSL, så det kunne vedligeholdes ikke kun af den, der skrev det.
Vi valgte Ansible, fordi det er agentløst: der var ikke behov for at forberede infrastrukturen, og det kan komme i gang hurtigt. Desuden er det skrevet i Python, som er accepteret som standard i teamet.
Generelt skema
Lad os se på det overordnede automatiseringsskema med eksemplet på en hændelse. Zabbix opdager, at disken sdb er defekt, en trigger aktiveres, og der oprettes en ticket i Jira. Administratoren har kigget på den, forstået, at det ikke er en duplikat eller en falsk positiv, hvilket betyder, at disken skal udskiftes, og han flytter ticketen til 'In progress'.
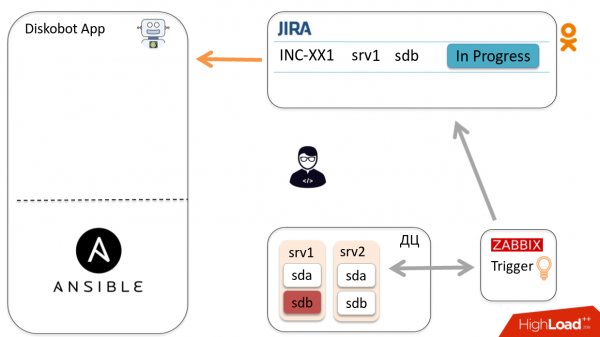
Applikationen DiskoBot, skrevet i Python, forespørger periodisk Jira om nye billetter. Den bemærker, at der er oprettet en ny ticket 'In progress', den relevante tråd aktiveres, som starter playbook'en i Ansible (det gøres for hver status i Jira). I dette tilfælde aktiveres Prepare2change.
Ansible sendes til værten, tager disken ud af rotation og rapporterer status til applikationen via Callbacks.
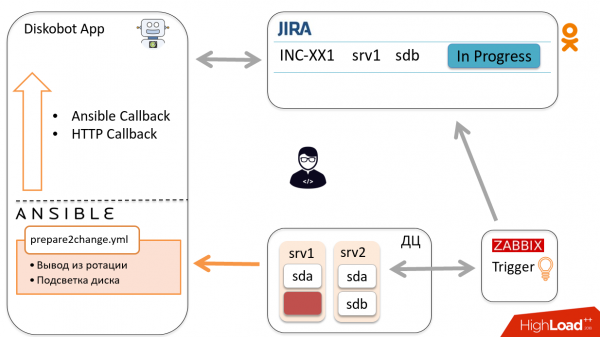
Baseret på resultatet oversætter botten automatisk ticketen til 'Ready to change'. Ingeniøren modtager en meddelelse og går for at udskifte disken, hvorefter han ændrer ticketens status til 'Changed'.
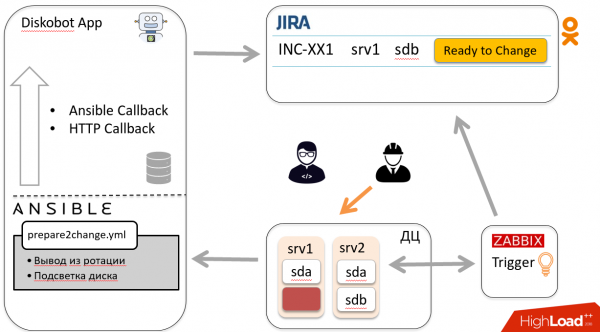
Ifølge den beskrevne proces kommer ticketen tilbage til botten, som starter en anden playbook, går til værten og tager disken tilbage i rotation. Botten lukker ticketen. Hurra!
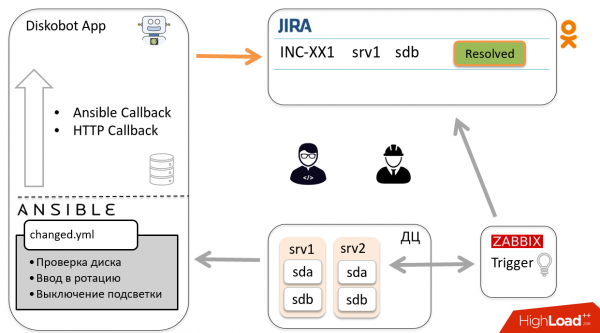
Lad os nu tale om nogle komponenter i systemet.
Diskobot
Denne applikation er skrevet i Python. Den vælger billetter fra Jira i henhold til JQL. Afhængigt af statusen for ticketen sendes den til den relevante behandler, som derefter starter det relevante Ansible playbook i forhold til status.
JQL og spørgselsintervaller er defineret i applikationskonfigurationsfilen.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
For eksempel, blandt billetter i status In progress vælges kun dem, hvor felterne Disk size og Device name er udfyldt. Device name er navnet på blokkeringsenheden, nødvendig for at udføre playbook’en. Disk size er nødvendig, så ingeniøren ved, hvilken størrelse disk der er nødvendig.
Blandt billetter i status Ready filtreres der billetter med etiketten dbot_ignore. For øvrigt bruger vi Jira-etiketter både til denne filterering og til at markere duplikater af billetter samt til at indsamle statistik.
I tilfælde af en fejl i playbook’en tildeler Jira etiketten dbot_failed, så det senere kan blive undersøgt.
Interaktion med Ansible
Applikationen interagerer med Ansible gennem . I playbook_executor sender vi filnavnet og sættet af variable. Dette gør det muligt at holde Ansible-projektet i form af almindelige yml-filer i stedet for at beskrive det i Python-kode.
Desuden sendes navnene på blokkeringsenheder, status på billetten og callback_url via *extra_vars*, hvor issue key er indkapslet — det bruges til callback i HTTP.
For hver kørsel genereres en midlertidig inventory, bestående af en vært og en gruppe, som denne vært tilhører, så group_vars anvendes.
Her er et eksempel på en opgave, hvor HTTP callback er implementeret.
Resultatet af playbooks’ udførelse opnår vi gennem callback(-ene). De er af to typer:
- , det giver data om resultaterne af playbook’ens udførelse. Her beskrives de opgaver, der er blevet kørt, enten med succes eller uden succes. Denne callback kaldes ved afslutningen af afspilningen af playbook’en.
- HTTP callback for at modtage information under afspilningen af playbook’en. I Ansible-opgaven udfører vi en POST/GET anmodning til vores applikation.
Gennem HTTP callback(-e) sendes de variable, der blev defineret under udførelsen af playbook’en og som vi ønsker at gemme og bruge i fremtidige kørsel. Disse data skriver vi i sqlite.
Gennem HTTP callback lader vi også kommentarer og ændrer status på billetten.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Som mange lignende opgaver har vi flyttet den til en separat common fil og inkluderer den efter behov for ikke konstant at gentage den i playbooks. Her optræder callback_url, der indeholder issue key og host name. Når Ansible udfører denne POST-forespørgsel, forstår botten, at den er kommet inden for en bestemt hændelse.
Her er et eksempel fra playbooken, hvor vi fjernede en disk fra et MD-udstyr:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Denne opgave flytter Jira-ticketen til status "Ready to change" og tilføjer en kommentar. Desuden gemmes listen over md-udstyr, hvorfra disken er blevet fjernet, i variablen mdam_data, mens parted_info indeholder et dump af partitionen fra parted.
Når ingeniøren indsætter en ny disk, kan vi bruge disse variabler til at genoprette dumpet af partitionerne samt registrere disken i de md-udstyr, hvorfra den blev fjernet.
Ansible check mode
Det var skræmmende at aktivere automatiseringen. Derfor besluttede vi at køre alle playbooks i tilstanden
, hvor Ansible ikke udfører nogen handlinger på serverne, men kun efterligner dem.
Denne opstart køres gennem et separat callback-modul, og resultatet af playbookens udførelse gemmes i Jira som en kommentar.
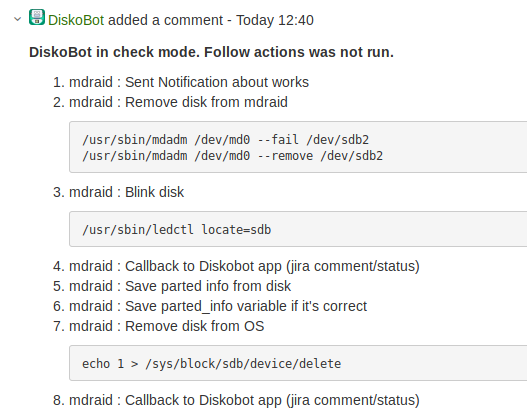
For det første gjorde det det muligt at validere botens og playbookernes funktion. For det andet øgede det administratorernes tillid til botten.
Da vi havde gennemgået validationen og indset, at vi kunne køre Ansible ikke kun i dry run-tilstand, lavede vi en knap i Jira med teksten Run Diskobot for at køre den samme playbook med de samme variabler på den samme host, men i normal tilstand.
Desuden bruges knappen til at genstarte playbooken i tilfælde af fejl.
Struktur af Playbooks
Jeg har allerede nævnt, at botten kører forskellige playbooks afhængigt af status for Jira-ticketen.
For det første gør det det meget lettere at organisere indgangen.
For det andet er det i nogle tilfælde ganske nødvendigt.
For eksempel, når man skifter systemdisken, skal man først gå ind i distributionssystemet, oprette en opgave, og efter korrekt distribution bliver serveren tilgængelig via ssh, hvorefter applikationen kan installeres. Hvis vi havde gjort alt dette i én playbook, kunne Ansible ikke have udført den på grund af utilgængeligheden af værten.
Vi bruger Ansible-roller for hver gruppe af servere. Her kan man se, hvordan playbook(-e) er organiseret i én af dem.
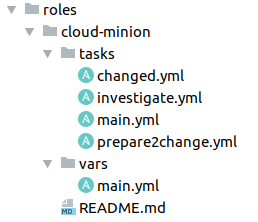
Det er praktisk, fordi man med det samme kan se, hvor forskellige opgaver er placeret. I main.yml, som er indgangen til Ansible-rollen, kan vi blot have en include baseret på ticketstatus eller generelle opgaver, der er nødvendige for alle, for eksempel at gennemgå identifikation eller få en token.
Investigation.yml
Kører for billetter med status Investigation og Open. Det vigtigste for denne playbook er navnet på den blokkerede enhed. Denne information er ikke altid tilgængelig.
For at få adgang til denne information analyserer vi Jira-sammenfatningen, den seneste værdi fra Zabbix-triggeren. Der kan være navnet på den blokkerede enhed — heldigt. Eller det kan indeholde mount point, — i så fald skal vi gå til serveren, parse og beregne den nødvendige disk. Triggeren kan også overføre SCSI-adressen eller anden information. Men nogle gange er der slet ingen spor, og vi må analysere.
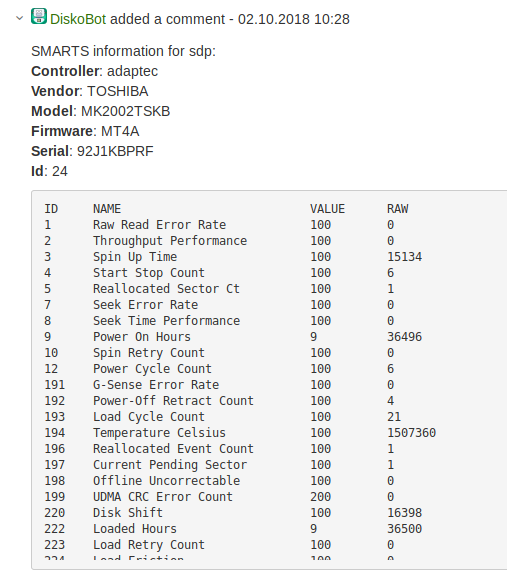
Når vi har fundet navnet på den blokkerede enhed, indsamler vi information om typen og størrelsen på disken for at udfylde felterne i Jira. Vi indsamler også information om producenten, modellen, firmwaren, ID, SMART, og alt dette indsætter vi i kommentaren i Jira-billetten. Administrator og ingeniør behøver ikke længere at lede efter disse data. 🙂
prepare2change.yml
Fjernelse af disken fra rotation, forberedelse til udskiftning. Den mest komplekse og ansvarlige fase. Her kan man stoppe applikationen, når den ikke kan stoppes. Eller trække disken, der manglede replikater, og dermed påvirke brugerne, miste nogle data. Her har vi flest tjek og notifikationer i chatten.
I det enkleste tilfælde handler det om at fjerne disken fra HW/MD RAID.
I mere komplekse situationer (i vores lagersystemer), når redundans udføres på applikationsniveau, skal vi gå ind i applikationen via API, informere om, at disken fjernes, deaktivere den og starte genoprettelsen.
Vi migrerer nu massivt til , og hvis serveren er cloud-baseret, så kontakter Diskobot cloud API, fortæller, at den skal arbejde med denne minion — serveren, hvor containerne kører — og beder "migrer alle containere fra denne minion". Og tænder samtidig diskens belysning, så ingeniøren straks kan se, hvilken der skal trækkes ud.
changed.yml
Efter udskiftning af disken kontrollerer vi først og fremmest dens tilgængelighed.
Ingeniører installerer ikke altid nye diske, så vi har tilføjet en kontrol af de SMART-værdier, der opfylder vores krav.
Hvilke attributter vi ser påReallocated Sectors Count (5) < 100
Current Pending Sector Count (107) == 0
Hvis disken ikke klarer testen, bliver ingeniøren informeret om at erstatte den. Hvis alt er i orden, slukkes belysningen, der påføres markering, og disken tages i rotation.
ready.yml
Den enkleste case: kontrol af synkronisering mellem HW/SW raid eller afslutning af datasykronisering i applikationen.
Applikations-API'er
Jeg har nævnt flere gange, at botten ofte tilgår applikations-API'er. Selvfølgelig havde ikke alle applikationer de nødvendige metoder, så vi måtte udvikle dem. Her er de vigtigste metoder, som vi bruger:
- Status. Status for klyngen eller disken for at forstå, om den kan anvendes;
- Start/stop. Aktivere/deaktivere disken;
- Migrate/restore. Migrering og gendannelse af data under og efter udskiftning.
Erfaring produceret i Ansible
Jeg elsker Ansible. Men ofte, når jeg ser på forskellige open source-projekter og ser, hvordan folk skriver playbooks, bliver jeg lidt skræmt. Komplekse logiske sammenfletninger af when/loop, mangel på fleksibilitet og idempotens på grund af hyppigt brug af shell/command.
Vi besluttede at forenkle det hele ved at udnytte Ansible's styrker — modulært design. På det højeste niveau findes playbooks, som enhver administrator eller ekstern udvikler, der har lidt kendskab til Ansible, kan skrive.
- name: Blink disk
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Hvis en logik er svær at implementere i playbooks, flytter vi den til et Ansible-modul eller filter. Scripts kan skrives i både Python og ethvert andet sprog.
De er nemme og hurtige at skrive. For eksempel består modulet til belysning af disken, hvis eksempel er givet ovenfor, af 265 linjer.
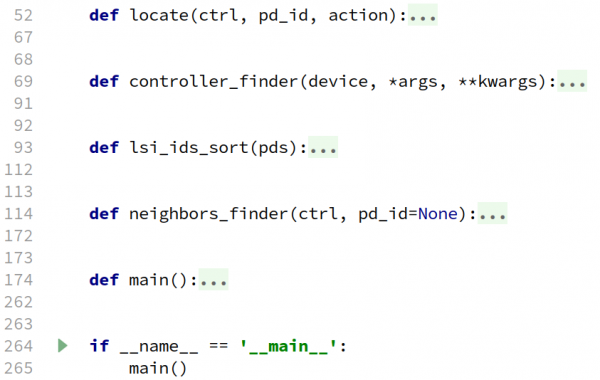
I bunden findes biblioteket. Til dette projekt skrev vi en separat applikation, en slags abstraktion over hardware og software RAID, der udfører de relevante forespørgsler.
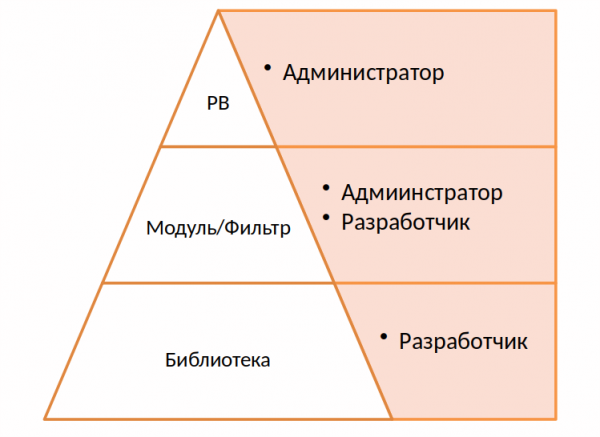
Ansible's stærkeste sider er enkelhed og forståelige playbooks. Jeg mener, at man bør bruge dem og ikke generere skræmmende yaml-filer og et stort antal betingelser, shell-kode og loops.
Hvis du ønsker at gentage vores erfaring med Ansible API, skal du have to ting i mente:
- Playbook_executor kan slet ikke overføre en timeout til playbook'en. Der er en timeout for ssh-sessioner, men der er ingen timeout for playbook. Hvis vi forsøger at afmontere en disk, der ikke længere findes i systemet, vil playbook'en køre uendeligt, så vi måtte indkapsle kørsel i en separat wrapper og dræbe den efter timeout.
- Ansible arbejder på basis af fork-processer, så dets API er ikke trådsikkert. Vi kører alle vores playbooks i en enkelt tråd.
Som resultat lykkedes det os at automatisere udskiftningen af omkring 80 % af diskene. Generelt er hastigheden for udskiftning steget med det dobbelte. I dag ser administratoren blot på hændelsen og beslutter, om disken skal skiftes eller ej, og derefter foretager han blot ét klik.
Men nu begynder vi at støde på et andet problem: nogle nye administratorer ved ikke, hvordan man skifter diske. 🙂
Kilde: habr.com
