

Skalérbarhed er et nøglekrav for cloud-applikationer. Med Kubernetes er det lige så nemt at skalere applikationen som at øge antallet af replikaer til den relevante deployment eller ReplicaSet — men det er en manuel proces.
Kubernetes gør det muligt at skalere applikationer automatisk (dvs. Pods i deployment eller ReplicaSet) på deklarativ måde ved hjælp af specifikationen for Horizontal Pod Autoscaler. Som standard er kriteriet for automatisk skalering ressourceforbrugsmetrikkerne, men man kan integrere brugerdefinerede metrikker og metrikker, der leveres udefra.
Kommandoen oversatte artiklen om, hvordan man bruger eksterne metrikker til automatisk skalering af Kubernetes-applikationer. For at vise, hvordan det hele fungerer, bruger forfatteren metrikker for HTTP-anmodninger, som indsamles med Prometheus.
I stedet for horisontal autoskalering af pods anvendes Kubernetes Event Driven Autoscaling (KEDA) — en open source Kubernetes-operator. Den integreres oprindeligt med Horizontal Pod Autoscaler for at sikre glat autoskalering (inklusive op/ned til nul) for begivenhedsstyrede arbejdsbelastninger. Koden er tilgængelig på .
En kort oversigt over systemets funktion
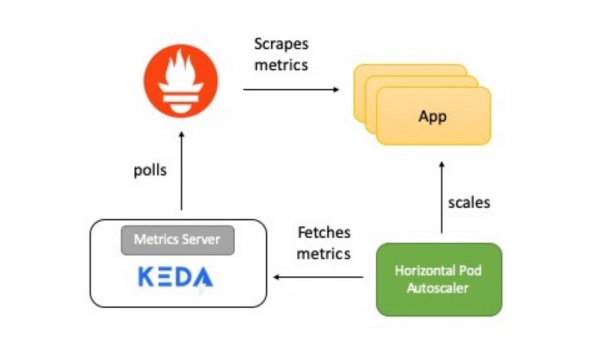
Diagrammet viser en kort beskrivelse af, hvordan det hele fungerer:
- Applikationen leverer metrikker for antallet af HTTP-anmodninger i Prometheus-format.
- Prometheus er konfigureret til at indsamle disse målinger.
- Prometheus-skaleren i KEDA er konfigureret til at autoskalere applikationen baseret på antallet af HTTP-anmodninger.
Nu vil jeg fortælle om hver enkelt komponent.
KEDA og Prometheus
Prometheus er et open source sæt af værktøjer til overvågning og alarmering af systemer, en del af . Den indsamler metrikker fra forskellige kilder og gemmer dem som tidsseriedata. Til visualisering af data kan man bruge eller andre visualiseringsværktøjer, der arbejder med Kubernetes API.
KEDA understøtter konceptet med en skalerer — den fungerer som en bro mellem KEDA og et eksternt system. Implementeringen af skalerespecifikationen er forskellig for hver målsystem og udtrækker data fra den. Derefter bruger KEDA dem til at styre automatisk skalering.
Skalere understøtter flere datakilder, såsom Kafka, Redis, Prometheus. Det betyder, at KEDA kan anvendes til automatisk skalering af Kubernetes-implementeringer ved at bruge Prometheus-metrics som kriterier.
Testapplikation
Test Golang-applikationen giver adgang via HTTP og udfører to vigtige funktioner:
- Den bruger Prometheus Go-klientbiblioteket til at instrumentere applikationen og levere metric http_requests, der indeholder en tæller for anmodninger. Endepunktet, hvor Prometheus-metrics er tilgængelige, findes på URI
/metrics.var httpRequestsCounter = promauto.NewCounter(prometheus.CounterOpts{ Name: "http_requests", Help: "antal http-anmodninger", }) - Som svar på anmodningen
GETøger applikationen værdien af nøglen (access_count) i Redis. Dette er en simpel måde at udføre arbejdet som en del af HTTP-handleren og samtidig kontrollere Prometheus-metrics. Værdien af metrikken skal være den samme som værdienaccess_counti Redis.func main() { http.Handle("/metrics", promhttp.Handler()) http.HandleFunc("/test", func(w http.ResponseWriter, r *http.Request) { defer httpRequestsCounter.Inc() count, err := client.Incr(redisCounterName).Result() if err != nil { fmt.Println("Kan ikke inkrementere redis-tælleren", err) os.Exit(1) } resp := "Adgang på " + time.Now().String() + "nAdgangstælling " + strconv.Itoa(int(count)) w.Write([]byte(resp)) }) http.ListenAndServe(":8080", nil) }
Applikationen implementeres i Kubernetes via Deployment. En tjeneste oprettes også, ClusterIPden gør det muligt for Prometheus-serveren at modtage applikationens metrics.
Her er .
Prometheus-serveren
Manifestet for implementering af Prometheus består af:
ConfigMap— til viderebefordring af Prometheus-konfigurationen;Deployment— til implementering af Prometheus i Kubernetes-klyngen;ClusterIP— en tjeneste til adgang til Prometheus UI;ClusterRole,ClusterRoleBindingogServiceAccount— til at understøtte autoopdagelse af tjenester i Kubernetes (Auto-discovery).
Her er .
KEDA Prometheus ScaledObject
Skalereren fungerer som en bro mellem KEDA og det eksterne system, hvor metrics skal hentes fra. ScaledObject — en konfigurerbar ressource, der skal implementeres for at synkronisere implementeringen med begivenhedskilden, i dette tilfælde Prometheus.
ScaledObject indeholder information om skaleringen af implementeringen, metadata om begivenhedskilden (f.eks. hemmeligheder til forbindelse, køens navn), forespørgselsinterval, gendannelsesperiode og andre data. Den fører til den relevante autoskalering ressource (HPA-definition) for at skalere implementeringen.
Når objektet ScaledObject fjernes, den tilsvarende HPA-definitionen renses.
Her er definitionen ScaledObject for vores eksempel, hvor en scaler bruges Prometheus:
apiVersion: keda.k8s.io/v1alpha1
kind: ScaledObject
metadata:
 name: prometheus-scaledobject
 namespace: default
 labels:
   deploymentName: go-prom-app
spec:
 scaleTargetRef:
   deploymentName: go-prom-app
 pollingInterval: 15
 cooldownPeriod:  30
 minReplicaCount: 1
 maxReplicaCount: 10
 triggers:
 - type: prometheus
   metadata:
     serverAddress:
http://prometheus-service.default.svc.cluster.local:9090
     metricName: access_frequency
     threshold: '3'
     query: sum(rate(http_requests[2m]))
Tag venligst følgende punkter i betragtning:
- Det henviser til
Deploymentmed navnetgo-prom-app. - Trigger type —
Prometheus. Prometheus-serverens adresse nævnes sammen med metriknavnet, tærskelværdien og , som vil blive brugt. PromQL-forespørgslen ersum(rate(http_requests[2m])). - Ifølge
pollingInterval, KEDA spørger målet hos Prometheus hver femten sekunder. Minimum én pod understøttes (minReplicaCount), mens det maksimale antal pods ikke overstigermaxReplicaCount(i dette eksempel — ti).
Det kan sættes minReplicaCount til nul. I dette tilfælde aktiverer KEDA deploymentet fra nul til én, og derefter giver HPA til videre automatisk skalering. Den omvendte rækkefølge er også mulig, altså skalering fra én til nul. I eksemplet har vi ikke valgt nul, da dette er en HTTP-tjeneste, ikke en forespørgsel-system.
Magien bag autoskalering
Tærskelværdien bruges som en trigger til at skalere deploymentet. I vores eksempel returnerer PromQL-forespørgslen sum(rate(http_requests[2m])) en aggregeret værdi af hastigheden for HTTP-anmodninger (antal anmodninger per sekund), målt over de seneste to minutter.
Da tærskelværdien er tre, vil der være én pod, sålænge værdien sum(rate(http_requests[2m])) er mindre end tre. Hvis værdien stiger, tilføjes en ekstra pod hver gang sum(rate(http_requests[2m])) den stiger med tre. For eksempel, hvis værdien går fra 12 til 14, så er antallet af pods fire.
Lad os nu prøve at konfigurere!
Forudkonfiguration
Alt, hvad du behøver, er et Kubernetes-klynge og et konfigureret værktøj kubectl. I dette eksempel bruges en klynge minikube, men du kan tage en hvilken som helst anden. For at installere klyngen er der .
Installer den nyeste version på Mac:
curl -Lo minikube
https://storage.googleapis.com/minikube/releases/latest/minikube-linux-amd64
&& chmod +x minikube
sudo mkdir -p /usr/local/bin/
sudo install minikube /usr/local/bin/
Installer , for at få adgang til Kubernetes-klyngen.
Installer den nyeste version på Mac:
curl -LO
"https://storage.googleapis.com/kubernetes-release/release/$(curl -s
https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/darwin/amd64/kubectl"
chmod +x ./kubectl
sudo mv ./kubectl /usr/local/bin/kubectl
kubectl version
Installation af KEDA
Du kan implementere KEDA på flere måder, de er angivet i . Jeg bruger en monolitisk YAML:
kubectl apply -f
https://raw.githubusercontent.com/kedacore/keda/master/deploy/KedaScaleController.yaml
KEDA og dens komponenter installeres i navnerummet keda. Kommandoen til at kontrollere:
kubectl get pods -n keda
Vent på, at KEDA Operator-poden starter — går ind i Running State. Og fortsæt derefter.
Installation af Redis ved hjælp af Helm
Hvis du ikke har installeret Helm, kan du bruge denne . Kommandoen til installation på Mac:
brew install kubernetes-helm
helm init --history-max 200
helm init initialiserer det lokale kommandolinjeinterface og installerer også Tiller i Kubernetes-klusteret.
kubectl get pods -n kube-system | grep tiller
Vent på, at Tiller-poden går ind i tilstanden Running.
Oversætterens note: Forfatteren bruger Helm@2, som kræver installation af serverkomponenten Tiller. Helm@3 er nu aktuel, hvor serverkomponenten ikke er nødvendig.
Efter installationen af Helm kræves kun én kommando for at køre Redis:
helm install --name redis-server --set cluster.enabled=false --set
usePassword=false stable/redis
Sørg for, at Redis er startet korrekt:
kubectl get pods/redis-server-master-0
Vent på, at Redis-poden går ind i tilstanden Kørende.
Implementering af applikationen
Kommandoen til implementering:
kubectl apply -f go-app.yaml

//output
deployment.apps/go-prom-app created
service/go-prom-app-service created
Kontroller, at alt er startet:
kubectl get pods -l=app=go-prom-app
Vent på, at Redis går ind i tilstanden Kørende.
Implementering af Prometheus-serveren
Manifestet for Prometheus bruger . Det gør det muligt dynamisk at opdage applikationspoder baseret på tjenestemærket.
kubernetes_sd_configs:
   - role: service
   relabel_configs:
   - source_labels: [__meta_kubernetes_service_label_run]
     regex: go-prom-app-service
     action: keep
Til implementering:
kubectl apply -f prometheus.yaml

//output
clusterrole.rbac.authorization.k8s.io/prometheus created
serviceaccount/default configured
clusterrolebinding.rbac.authorization.k8s.io/prometheus created
configmap/prom-conf created
deployment.extensions/prometheus-deployment created
service/prometheus-service created
Kontroller, at alt er startet:
kubectl get pods -l=app=prometheus-server
Vent på, at Prometheus-poden går ind i tilstanden Kørende.
Brug kubectl port-forward for at få adgang til brugergrænsefladen for Prometheus (eller API-serveren) på adressen .
kubectl port-forward service/prometheus-service 9090
Implementering af autoskalering konfiguration for KEDA
Kommandoen til at oprette ScaledObject:
kubectl apply -f keda-prometheus-scaledobject.yaml
Tjek KEDA-operatorens logs:
KEDA_POD_NAME=$(kubectl get pods -n keda
-o=jsonpath='{.items[0].metadata.name}')
kubectl logs $KEDA_POD_NAME -n keda
Resultatet ser omtrent slik ut:
time="2019-10-15T09:38:28Z" level=info msg="Watching ScaledObject:
default/prometheus-scaledobject"
time="2019-10-15T09:38:28Z" level=info msg="Created HPA with
namespace default and name keda-hpa-go-prom-app"
Kontroller podene for applikasjonen. Det skal være en instans kjørende, siden minReplicaCount er lik 1:
kubectl get pods -l=app=go-prom-app
Kontroller at HPA-ressursen er opprettet:
kubectl get hpa
Du bør se noe slik:
NAME                   REFERENCE                TARGETS     MINPODS   MAXPODS   REPLICAS   AGE
keda-hpa-go-prom-app   Deployment/go-prom-app   0/3 (gj.snitt)   1         10        1          45s
Helsekontroll: tilgang til applikasjonen
For å få tilgang til REST-endepunktet til applikasjonen vår, kjør:
kubectl port-forward service/go-prom-app-service 8080
Nå kan du få tilgang til Go-applikasjonen ved å bruke adressen . For å gjøre dette, kjør kommandoen:
curl http://localhost:8080/test
Resultatet ser omtrent slik ut:
Tilgang registrert 2019-10-21 11:29:10.560385986 +0000 UTC
m=+406004.817901246
Tilgangsantall 1
På dette stadiet bør du også sjekke Redis. Du vil se at nøkkelen access_count økes til 1:
kubectl exec -it redis-server-master-0 -- redis-cli get access_count
//output
"1"
Sørg for at metrikken http_requests er den samme:
curl http://localhost:8080/metrics | grep http_requests
//output
# HELP http_requests antall http forespørsel
# TYPE http_requests counter
http_requests 1
Generere belastning
Vi vil bruke — verktøyet for å generere belastning:
curl -o hey https://storage.googleapis.com/hey-release/hey_darwin_amd64
&& chmod a+x hey
Du kan også laste ned verktøyet for eller .
Kjør det:
./hey http://localhost:8080/test
Som standard sender verktøyet 200 forespørsel. Du kan bekrefte dette ved å bruke Prometheus-metrikker og Redis.
curl http://localhost:8080/metrics | grep http_requests
//output
# HELP http_requests antall http forespørsel
# TYPE http_requests counter
http_requests 201
kubectl exec -it redis-server-master-0 -- redis-cli get access_count
//output
201
Bekreft verdien av den faktiske metrikken (tilbakeført ved PromQL-spørring):
curl -g
'http://localhost:9090/api/v1/query?query=sum(rate(http_requests[2m]))'
//output
{"status":"success","data":{"resultType":"vector","result":[{"metric":{},"value":[1571734214.228,"1.686057971014493"]}]}}
I dette tilfellet er det faktiske resultatet lik 1,686057971014493 og vises i feltet value. Dette er ikke tilstrekkelig for skalering, siden terskelen vi har satt er 3.
Mer belastning!
I et nytt terminalvindu, følg med på antallet applikasjonspods:
kubectl get pods -l=app=go-prom-app -w
La oss øke belastningen med kommandoen:
./hey -n 2000 http://localhost:8080/test
Etter en stund vil du se at HPA skalerer distribusjonen og starter nye pods. Sjekk HPA for å bekrefte dette:
kubectl get hpa
NAVN                   REFERENCER                MÅL         MINPODS   MAXPODS   REPLIKER   ALDER
keda-hpa-go-prom-app   Deployment/go-prom-app   1830m/3 (gennemsnit)   1         10        6          4m22s
Hvis belastningen er uregelmæssig, vil deploymentet falde til det punkt, hvor kun én pod kører. Hvis du vil tjekke den faktiske metrisk (returneret af PromQL-forespørgslen), skal du bruge kommandoen:
curl -g
'http://localhost:9090/api/v1/query?query=sum(rate(http_requests[2m]))'
Rydning
//Delete KEDA
kubectl delete namespace keda
//Delete the app, Prometheus server and KEDA scaled object
kubectl delete -f .
//Delete Redis
helm del --purge redis-server
Konklusion
KEDA gør det muligt automatisk at skalere dine Kubernetes-deploymenter (op/ned fra nul) baseret på data fra eksterne metrikker. For eksempel baseret på Prometheus-metrik, kølængde i Redis, eller forbrugers ventetid i Kafka-emnet.
KEDA udfører integration med en ekstern kilde og leverer også dens metrikker via Metrics Server til Horizontal Pod Autoscaler.
Held og lykke!
Yderligere læsning:
- .
- .
- .
Kilde: habr.com
