

I store med store cloud-systemer er spørgsmålet om automatisk belastningsbalancering eller udjævning af belastningen på beregningsressourcer særligt presserende. Dette spørgsmål er også blevet taget op af Tionix (udvikler og operatør af cloud-tjenester, der er en del af Rostelekom-gruppen).
Og da vores primære udviklingsplatform er OpenStack, og vi, ligesom alle mennesker, er dovne, blev det besluttet at finde en eller anden færdig modul, som allerede findes i platformen. Vores valg faldt på Watcher, som vi besluttede at bruge til vores behov.
Lad os først tage fat på termer og definitioner.
Termer og definitioner
Formålet — er et menneskeligt læsbart, observerbart og målbart slutresultat, der skal opnås. Der er en eller flere strategier for at nå hver mål. En strategi er implementeringen af et algoritme, der kan finde en løsning til det pågældende mål.
Handling (Action) — er en elementær opgave, der ændrer den nuværende tilstand af den målrettede styrrede ressource i OpenStack-klyngen, såsom: migrering af en virtuel maskine (migration), ændring af strømstatus for en node (change_node_power_state), ændring af status for nova-tjenesten (change_nova_service_state), ændring af flaven (resize), registrering af en NOP-meddelelse (nop), ingen handlinger i en bestemt tidsperiode — pause (sleep), flytning af disk (volume_migrate).
Handlingsplan (Action Plan) — er en specifik sekvens af handlinger, der udføres i en bestemt rækkefølge for at opnå et konkret mål. Handlingsplanen indeholder også den vurderede globale effektivitet med et sæt præstationsindikatorer. Handlingsplanen genereres af Watcher efter en vellykket audit, hvor den anvendte strategi finder en løsning for at nå målet. Handlingsplanen består af en liste over sekventielle handlinger.
Audit (Audit) — er en anmodning om optimering af klyngen. Optimeringen udføres for at nå et mål i denne klynge. For hver vellykket audit genererer Watcher en handlingsplan.
Auditområde (Audit Scope) — et sæt af ressourcer, inden for hvilket audit udføres (zone(r) for tilgængelighed, nodeaggregatorer, individuelle computerknudepunkter eller lagringsknudepunkter osv.). Auditområdet er defineret i hver skabelon. Hvis auditområdet ikke er angivet, udføres auditet for hele klustret.
Audit Skabelon (Audit Template) — et gemt sæt af indstillinger til at køre auditer. Skabeloner er nødvendige for at køre auditer flere gange med de samme indstillinger. Skabelonen skal indeholde formålet med auditet; hvis strategier ikke angives, vælges de mest passende fra de eksisterende strategier.
Klynge (Cluster) — et sæt af fysiske maskiner, der leverer compute-ressourcer, lagerressourcer og netværksressourcer og styres af den samme OpenStack-kontrolknude.
Cluster Data Model (Cluster Data Model, CDM) — en logisk repræsentation af den nuværende tilstand og topologi af de ressourcer, der styres af klyngen.
Effektivitetsindikator (Efficacy Indicator) — en indikator, der angiver, hvordan løsningen, der er skabt med denne strategi, præsterer. Effektivitetsindikatorer er specifikke for det enkelte mål og bruges normalt til at beregne den samlede effektivitet af den endelige handlingsplan.
Effektivitets-specifikation (Efficacy Specification) — et sæt af specifikke egenskaber knyttet til hvert mål, som definerer forskellige effektivitetsindikatorer, som strategien, der skal sikre opnåelse af det relevante mål, skal opfylde i sin løsning. Faktisk vil hver løsning, der foreslås af strategien, blive testet for at sikre, at den overholder specifikationen, før dens samlede effektivitet beregnes.
“Vurderings” motor (Scoring Engine) — en eksekverbar fil, der har klart definerede input, klart definerede output og udfører en ren matematisk opgave. Derved afhænger beregningen ikke af det miljø, hvori den udføres — den vil give det samme resultat alle steder.
Watcher planlægger (Watcher Planner) — en del af beslutningsmekanismen Watcher. Denne modul modtager et sæt handlinger genereret af strategien og skaber en arbejdsplan, der definerer, hvordan man tidsplanlægger disse forskellige handlinger og for hver handling, hvad betingelserne er.
Mål og strategier for Watcher
Formålet
Strategier
Dummy mål
Dummy strategi
Dummy strategi ved hjælp af prøve Scoring Engines
Dummy strategi med resize
Energibesparelse
Strategi for energibesparelse
Serverkonsolidering
Grundlæggende offline serverkonsolidering
VM arbejdsbyrde konsolideringsstrategi
Arbejdsbyrdebalancering
Migreringsstrategi for arbejdsbyrdebalance
Strategi for lagringskapacitetsbalance
Stabilisering af arbejdsbyrde
Nostyret nabo
Nostyret nabo
Termisk optimering
Strategi baseret på udløbstemperatur
Luftstrømsoptimering
Strategi for ensartet luftstrømmigering
Hardwarevedligeholdelse
Zonemigrering
Ukategoriseret
Aktuator
Dummy mål — en reserveret mål, der bruges til testformål (reserved goal that is used for testing purposes).
Relaterede strategier: Dummy strategi, Dummy strategi ved hjælp af prøve Scoring Engines og Dummy strategi med resize. Dummy strategi — en dummy-strategi, der bruges til integrationstest gennem Tempest. Denne strategi giver ikke nogen nyttig optimering, dens eneste formål er at bruge Tempest-tests.
Dummy strategi ved hjælp af prøve Scoring Engines — strategien er lig den forrige, adskilt kun ved brugen af en 'scoring engine'-prøve, der tæller med maskinlæringsmetoder.
Dummy strategi med resize — strategien er lig den forrige, adskilt kun ved brugen af ændring af flavor (migration og resize).
Ikke brugt i produktion.
Energibesparelse — minimere energiforbruget. Strategien for dette mål, Saving Energy Strategy, sammen med strategien VM Workload Consolidation Strategy (Server Consolidation) er i stand til at udføre dynamisk strømstyring (DPM), som sparer elektricitet ved at konsolidere arbejdsbyrder dynamisk, selv i perioder med lav ressourcebelastning: virtuelle maskiner flyttes til færre noder, og unødvendige noder slukkes. Efter konsolidering foreslår strategien en løsning om at tænde/slukke noder i henhold til de angivne parametre: “min_free_hosts_num” — antal ledige, tændte noder, der venter på belastning, og “free_used_percent” — procentandelen af ledige, tændte noder i forhold til det antal noder, der er optaget af maskiner. For at strategien skal fungere, skal Ironic være aktiveret og konfigureret til at arbejde med tænding/slukning af strøm til noder.
Strategiparametre
parameter
type
som standard
beskrivelse
free_used_percent
Nummer
10.0
forholdet mellem antallet af ledige beregningsnoder og antallet af beregningsnoder med virtuelle maskiner
min_free_hosts_num
Int
1
minimum antal ledige beregningsnoder
Der skal være mindst to noder i skyen. Den anvendte metode er ændring af strømtilstand for noden (change_node_power_state). Strategien kræver ikke indsamling af metrikker.
Server Consolidation - minimere antallet af beregningsnoder (konsolidering). Den har to strategier: Basic Offline Server Consolidation og VM Workload Consolidation Strategy.
Strategien Basic Offline Server Consolidation minimerer det samlede antal anvendte servere samt minimerer antallet af migrationer.
Den grundlæggende strategi kræver følgende metrikker:
metrik
service
plugins
kommentar
compute.node.cpu.percent
ingen
cpu_util
ingen
Strategi parametre: migration_attempts - antal af kombinationer til at finde potentielle kandidater til nedlukning (standard, 0, ingen begrænsninger), period - tidsinterval i sekunder for at indsamle statisk aggregation fra metrikdata kilden (standard, 700).
Anvendte metoder: migration, ændring af nova service tilstand (change_nova_service_state).
Strategien VM Workload Consolidation Strategy er baseret på en heuristisk metode med første passende (first-fit), som fokuserer på den målte CPU-belastning og forsøger at minimere noder, der har alt for høj eller for lav belastning i forhold til kapacitetsbegrænsningerne. Denne strategi tilbyder en løsning, der fører til mere effektiv udnyttelse af klusterressourcerne, ved hjælp af følgende fire trin:
- Aflastningsfase - behandling af overstegne ressourcer;
- Konsolideringsfase - behandling af utilstrækkeligt anvendte ressourcer;
- Optimering af løsningen - reduktion af antallet af migrationer;
- Afbrydelse af ubrugte beregningsnoder.
Strategien kræver følgende metrikker:
metrik
service
plugins
kommentar
memory
ingen
disk.root.size
ingen
Følgende metrikker er ikke obligatoriske, men øger nøjagtigheden af strategien, hvis de er tilgængelige:
metrik
service
plugins
kommentar
memory.resident
ingen
cpu_util
ingen
Strategi parametre: period - tidsinterval i sekunder for at indsamle statisk aggregation fra metrikdata kilden (standard, 3600).
Bruger de samme metoder som den foregående strategi. Mere information .
Arbejdsbyrdebalancering — balancere arbejdsbelastningen mellem beregningsnoder. Målet har tre strategier: Workload Balance Migration Strategy, Workload stabilization, Storage Capacity Balance Strategy.
Workload Balance Migration Strategy starter migreringer af virtuelle maskiner baseret på arbejdsbelastningen af nodens virtuelle maskiner. Beslutningen om at flytte træffes, når procentdelen af brugen af CPU eller RAM på noden overskrider den angivne tærskel. Den flyttede virtuelle maskine skal bringe noden tættere på den gennemsnitlige arbejdsbelastning blandt alle noder.
Krav
- Brug af fysiske processorer;
- Minimum to fysiske beregningsnoder;
- Installeret og konfigureret komponent Ceilometer — ceilometer-agent-compute, der kører på hver beregningsnode, og Ceilometer API, samt indsamling af følgende målinger:
metrik
service
plugins
kommentar
cpu_util
ingen
memory.resident
ingen
Strategi parameter:
parameter
type
som standard
beskrivelse
metrics
Streng
'cpu_util'
Målingerne, der ligger til grund for: 'cpu_util', 'memory.resident'.
grænseværdi
Nummer
25.0
Tærskel for arbejdsbelastning til migration.
periode
Nummer
300
Samlet periode for Ceilometer.
Brugte metode — migration.
Workload stabilisering — en strategi med fokus på at stabilisere arbejdsbelastningen ved hjælp af live migration. Strategien er baseret på en standardafvigelsesalgoritme og bestemmer, om der er overbelastning i klyngen, og reagerer på det ved at starte migrationen af maskiner for at stabilisere klyngen.
Krav
- Brug af fysiske processorer;
- Minimum to fysiske beregningsnoder;
- Installeret og konfigureret komponent Ceilometer — ceilometer-agent-compute, der kører på hver beregningsnode, og Ceilometer API, samt indsamling af følgende målinger:
metrik
service
plugins
kommentar
cpu_util
ingen
memory.resident
ingen
Storage Capacity Balance Strategy (strategien implementeret fra Queens) — strategien flytter diske baseret på belastningen af Cinder-pulje. Beslutningen om at flytte træffes, når udnyttelsesgraden af puljen overstiger den angivne tærskel. Den flyttede disk skal bringe puljen tættere på den gennemsnitlige belastning blandt alle Cinder-puljer.
Krav og begrænsninger
- Minimum to Cinder-puljer;
- Mulighed for at migrere diske.
- Klyngens datamodel — Cinder cluster data model collector.
Strategi parameter:
parameter
type
som standard
beskrivelse
volume_threshold
Nummer
80.0
Tærskelværdien for diske til balancing af volumener.
Brugd metode — disk-migration (volume_migrate).
Noisy Neighbor — identificere og flytte "støjende nabo" — en virtuel maskine med lav prioritet, der negativt påvirker præstationen af en virtuel maskine med høj prioritet med hensyn til IPC, ved overdreven brug af Last Level Cache. Egen strategi: Noisy Neighbor (brugt parameter for strategien — cache_threshold (standardværdi — 35), når præstationen falder til den angivne værdi, udløses migration. For at strategien fungerer, kræves aktiverede LLC (Last Level Cache) målinger, den seneste Intel-server med support til CMT, samt indsamling af følgende målinger:
metrik
service
plugins
kommentar
cpu_l3_cache
ingen
Nødvendig Intel .
Cluster datamodel (standard): Nova cluster data model collector. The applied method is migration.
Working towards this goal through the Dashboard is not fully implemented in Queens.
Termisk optimering — optimize the temperature regime. The outlet temperature (exhaust air) is one of the important thermal telemetry systems for measuring the thermal/working load status of the server. There is one strategy for this purpose — Outlet temperature based strategy, which makes decisions to offload workloads to nodes with favorable temperature conditions (the lowest outlet temperature), when the outlet temperature of the source hosts reaches a configurable threshold.
To operate the strategy, a server with Intel Power Node Manager installed and configured is required. , samt indsamling af følgende målinger:
metrik
service
plugins
kommentar
hardware.ipmi.node.outlet_temperature
IPMI
Strategi parameter:
parameter
type
som standard
beskrivelse
grænseværdi
Nummer
35.0
Temperature threshold for migration.
periode
Nummer
30
Time interval in seconds for obtaining statistical aggregation from the data source of the metrics.
Brugte metode — migration.
Luftstrømsoptimering — optimize the ventilation mode. The self strategy is — Uniform Airflow using live migration. The strategy initiates the migration of a virtual machine whenever the airflow from the server's fan exceeds the specified threshold.
The strategy requires:
- Hardware: compute nodes <with NodeManager 3.0 support;
- At least two compute nodes;
- The ceilometer-agent-compute component and Ceilometer API installed and configured on each compute node, which can successfully report such metrics as airflow, system power, and inlet temperature:
metrik
service
plugins
kommentar
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
To operate the strategy, a server with Intel Power Node Manager 3.0 or later installed and configured is required.
Limitations: The concept is not intended for production.
It is suggested to use this algorithm with continuous audits, as only one virtual machine migration is planned per iteration.
Live migrations are possible.
Strategi parameter:
parameter
type
som standard
beskrivelse
threshold_airflow
Nummer
400.0
Airflow threshold for migration Unit is 0.1CFM
threshold_inlet_t
Nummer
28.0
Inlet temperature threshold for migration decision
threshold_power
Nummer
350.0
System power threshold for migration decision
periode
Nummer
30
Time interval in seconds for obtaining statistical aggregation from the data source of the metrics.
Brugte metode — migration.
Hardware Maintenance — hardware maintenance. The strategy related to this objective is Zone migration. The strategy serves as a tool for efficient, automated, and minimal migration of virtual machines and disks when hardware maintenance is necessary. The strategy builds an action plan according to weights: actions with higher weights will be scheduled earlier than others. There are two configuration parameters: action weights (action_weights) and parallelization.
Restrictions: action weights and parallelization settings are required.
Strategi parameter:
parameter
type
som standard
beskrivelse
compute_nodes
array
None
Compute nodes for migration.
storage_pools
array
None
Storage nodes for migration.
parallel_total
integer
6
Total number of actions that should be executed in parallel.
parallel_per_node
integer
2
Number of actions executed in parallel for each compute node.
parallel_per_pool
integer
2
Number of actions executed in parallel for each storage pool.
priority
objekt
None
Priority list for virtual machines and disks.
with_attached_volume
boolean
False
False — virtual machines will be transferred after all disks have been moved. True — virtual machines will be transferred after all attached disks have been migrated.
Array elements of compute nodes:
parameter
type
som standard
beskrivelse
src_node
string
None
The compute node from which virtual machines are being transferred (mandatory).
dst_node
string
None
The compute node to which virtual machines are migrating.
Array elements of storage nodes:
parameter
type
som standard
beskrivelse
src_pool
string
None
The storage pool from which disks are being transferred (mandatory).
dst_pool
string
None
The storage pool to which disks are being transferred.
src_type
string
None
The source disk type (mandatory).
dst_type
string
None
The destination disk type (mandatory).
Elements of object priority:
parameter
type
som standard
beskrivelse
projekt
array
None
Project names.
compute_node
array
None
Names of compute nodes.
storage_pool
array
None
Names of storage pools.
compute
enum
None
Virtual machine parameters [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
storage
enum
None
Disk parameters [“size”, “created_at”].
Methods used — migration of virtual machines, migration of disks.
Ukategoriseret — a secondary objective used to facilitate the strategy development process. It does not contain specifications and can be used whenever the strategy is not yet associated with an existing objective. This objective can also be used as a transitional phase. The strategy associated with this objective is Actuator.
Creating a new objective.
Watcher Decision Engine har et plugin-grænseflade til "eksterne mål", som giver mulighed for at integrere et eksternt mål, der kan opnås med en strategi.
Før du opretter et nyt mål, skal du sikre dig, at ingen af de eksisterende mål opfylder dine behov.
Oprettelse af et nyt plugin
For at oprette et nyt mål skal du: udvide målklassen, implementere metoden get_name() for at returnere en unik identifikator for det nye mål, du ønsker at oprette. Denne unikke identifikator skal matche navnet på indgangspunktet, som du erklærer senere.
Dernæst skal du implementere metoden get_display_name() for at returnere det oversatte visningsnavn for det mål, du ønsker at oprette (brug ikke en variabel til at returnere den oversatte streng, så den kan samles automatisk af oversættelsesværktøjet).
Implementer metoden get_translatable_display_name(), for at returnere oversættelsesnøglen (faktisk det engelske visningsnavn) for dit nye mål. Den returnerede værdi skal matche den streng, der er oversat i get_display_name().
Implementer dens metode get_efficacy_specification(), for at returnere effektivitetsspecifikationen for dit mål. Metoden get_efficacy_specification() returnerer en instance af Unclassified(), som gives af Watcher. Denne effektivitetsspecifikation er nyttig under udviklingen af dit mål, da den svarer til en tom specifikation.
→
Watcher-arkitektur (læs mere ).
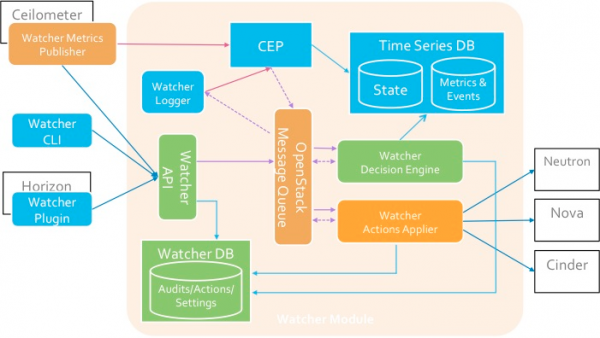
Komponenter
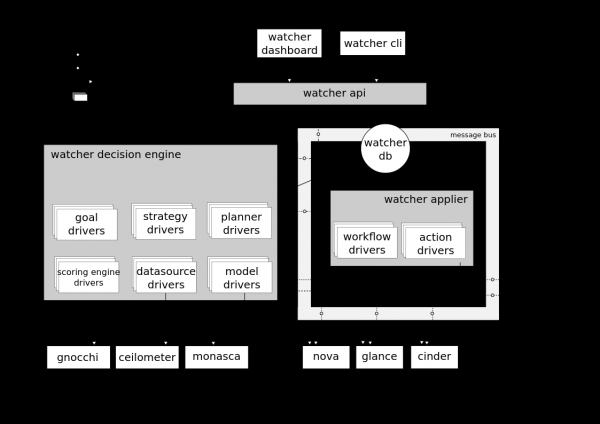
Watcher API — en komponent, der implementerer REST API'en leveret af Watcher. Interaktionsmekanismer: CLI, Horizon-plugin, Python SDK.
Watcher DB — Watcher-databasen.
Watcher Applier — en komponent, der implementerer udførelsen af handlingsplanen skabt af Watcher Decision Engine-komponenten.
Watcher Decision Engine — en komponent, der er ansvarlig for at beregne et sæt af potentielle optimeringshandlinger til udførelse af revisionsmålet. Hvis strategien ikke er angivet, vælger komponenten den mest passende.
Watcher Metrics Publisher — en komponent, der samler og beregner nogle målinger eller hændelser og offentliggør dem på CEP-endepunktet. Komponentens funktionalitet kan også leveres af Ceilometer-publisher.
Complex Event Processing (CEP) Engine — motor til kompleks hændelsesbehandling. Af hensyn til ydeevnen kan der være flere instanser af CEP Engine, der kører samtidigt, hvor hver især behandler en bestemt type måling / hændelser. I Watcher-systemet starter CEP to typer handlinger: — at skrive de relevante hændelser / målinger ind i tidsseriedatabasen; — at sende de relevante hændelser til komponenten Watcher Decision Engine, når denne hændelse kan påvirke resultaterne af den nuværende optimeringsstrategi, da Openstack-klusteret ikke er et statisk system.
Interaktionen mellem komponenterne sker via AMQP-protokollen.
→
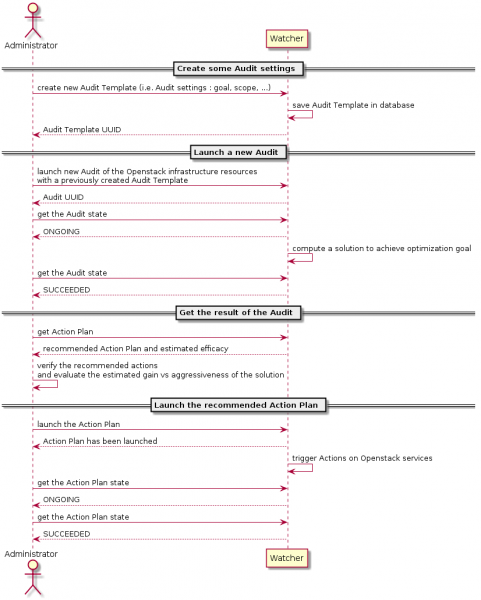
Interaktionsdiagram for Watcher
Testresultater for Watcher
- På siden Optimization — Action plans opstår der en 500-fejl (både på ren Queens og på miljøet med Tionix-moduler) kun efter, at auditeringen startes og handlingsplanen genereres; den åbnes normalt, når den er tom.
- I fanen Action details opstår der fejl, kan ikke få mål og revisionsstrategi (både på ren Queens og på miljøet med Tionix-moduler).
- Audits med målet Dummy (test) oprettes og kører normalt, handlingsplaner genereres.
- Audits med målet Unclassified oprettes ikke, da målet ikke er funktionelt og er beregnet til midlertidig tilpasning ved oprettelse af nye strategier.
- Audits med målet Workload Balancing (strategi Storage Capacity balance) oprettes succesfuldt, men handlingsplanen genereres ikke. Der kræves ikke optimering af lagerpuljer.
- Audits med målet Workload Balancing (strategi Workload Balance Migration Strategy) oprettes succesfuldt, men handlingsplanen genereres ikke.
- Audits med målet Workload Balancing (strategi Workload Stabilization Strategy) afsluttes med fejl.
- Audits med målet Noisy Neighbor oprettes succesfuldt, men handlingsplanen genereres ikke.
- Audits med målet Hardware maintenance oprettes succesfuldt, men handlingsplanen genereres ikke fuldt ud (effektivitetsmålinger genereres, men selve handlingslisten genereres ikke).
- Ændringer i konfigurationerne nova.conf (i default-sektionen compute_monitors = cpu.virt_driver) på de beregnende og kontrolnoder løser ikke fejlene.
- Audits med målet Server Consolidation (strategi Basic) afsluttes også med en fejl.
- Audits med målet Server Consolidation (strategi VM workload consolidation) afsluttes med en fejl. I loggene er der en fejl i at hente kildedata. Drøftelse af fejlen, især, .
Vi har forsøgt at angive i konfigurationsfilen til Watcher (det hjalp ikke – som resultat er der fejl på alle sider af Optimering, tilbagevenden til den oprindelige indhold af konfigurationsfilen løser ikke situationen):[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Energi besparende audits afsluttes med en fejl. Ifølge loggen ligger problemet alligevel i manglen på Ironic, det vil ikke fungere uden baremetal service.
- Termisk optimerings audits afsluttes med en fejl. Traceback er den samme som for Server Konsolidering (strategi for VM arbejdsbyrde konsolidering) (fejl i inputdata)
- Airflow optimerings audits afsluttes med en fejl.
Der opstår også følgende fejl ved audit afslutning. Traceback i loggene decision-engine.log (klusterstatus ikke defineret).
→ Diskussion af fejlen
Konklusion
Resultatet af vores to måneders undersøgelser har givet en klar konklusion, at for at få et fuldt fungerende system til belastningsbalancering, bliver vi nødt til at forbedre værktøjerne til Openstack-platformen.
Watcher har vist sig at være et seriøst og hurtigt udviklende produkt med enormt potentiale, som vil kræve en stor og seriøs indsats for at blive brugt fuldt ud.
Men mere om dette i de næste artikler i rækken.
Kilde: habr.com
