

Hvordan man kan oversætte forretningskrav til konkrete datastrukturer ved at designe en database til en messenger "fra bunden".
- Del 1: design rammen på databasen
Vores database vil ikke være så omfattende og distribueret, eller , men "bare for at have det", skal den være god — funktionel, hurtig og kunne være på én server PostgreSQL — så vi kan implementere en separat tjenesteinstans et sted, for eksempel.
Derfor vil vi ikke berøre spørgsmål om sharding, replikering og geografisk distribuerede systemer, men fokusere på skematiske løsninger inden for databasen.
Trin 1: Lidt forretningsspecifik viden
Vi vil designe vores beskedudveksling ikke abstrakt, men indbygget i miljøet . Det vil sige, at folk ikke "bare skriver til hinanden", men kommunikerer i konteksten af at løse bestemte forretningsopgaver.
Hvilke opgaver har virksomhederne? Lad os se på et eksempel med Vasily - lederen af udviklingsafdelingen.
- "Nikolaj, vi har brug for en patch til denne opgave i dag!"
Det betyder, at kommunikationen kan finde sted i konteksten af et dokument. - "Kola, skal vi spille Dota i aften?"
Det vil sige, at selv for et par samtalepartnere kan kommunikationen finde sted om forskellige emner. - "Petr, Nikolaj, kig i det vedhæftede dokument for prisen på den nye server."
Så et enkelt besked kan have flere modtagere.Desuden kan en besked indeholde vedhæftede filer. - "Semen, du skal også tage et kig."
Og der skal være mulighed for at invitere en ny deltager ind i en eksisterende samtale Lad os holde os til denne liste af "åbenlyse" behov..
Uden forståelse af de applikationsspecifikke opgaver og deres begrænsninger er det praktisk talt umuligt at designe
en effektiv database schema til at løse dem. Trin 2: Minimal logisk skema
Skematisk set ligner alt stadig meget en email-korrespondance — et traditionelt værktøj til at drive forretning. Så ja, "algoritmisk" minder mange forretningsopgaver om hinanden, derfor vil værktøjerne til at løse dem også have strukturel lighed.
Lad os fastholde den logiske skema for enhedsrelationerne, vi allerede har fået. For at forenkle forståelsen af vores model vil vi bruge den mest primitive form for visning
af ER-modellen. uden komplicerede UML eller IDEF-notationer:
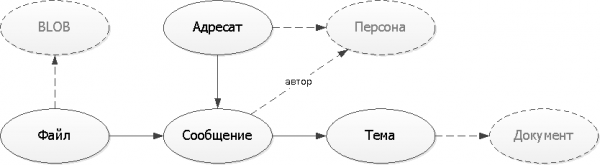
I vores eksempel er person, dokument og den binære "krop" af filen "eksterne" enheder, der eksisterer uafhængigt af vores service. Derfor vil vi blot opfatte dem som nogle links "et eller andet sted" via UUID.
Tegn skemaer så enkelt som muligt — de fleste af dem, du viser dem til, er ikke eksperter i at læse UML/IDEF. Men — sørg for at tegne.
Trin 3: Skitser strukturen af tabeller
Om navne på tabeller og felterMan kan have forskellige holdninger til "russiske" navne på felter og tabeller, men det er en smagssag. Da ikke har udenlandske udviklere, og PostgreSQL tillader os at give navne selv i hieroglyffer, så længe de er indkapslet i anførselstegn, så foretrækker vi at navngive objekter klart og tydeligt for at undgå misforståelser.
Da mange mennesker skriver beskeder til os på én gang, kan nogle endda gøre det i offline-tilstand, så den enkleste løsning er at bruge UUID som identifikatorer ikke kun for eksterne enheder, men også for alle objekter inden for vores service. Desuden kan de genereres selv på klientsiden — det hjælper os med at støtte afsendelse af beskeder ved kortvarig utilgængelighed af databasen, og risikoen for kollision er ekstremt lille.
Den udkastede struktur af tabellerne i vores database vil have følgende udseende:
Tabeller : RU
CREATE TABLE "Emne"(
  "Emne"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Titel"
    text
);

CREATE TABLE "Besked"(
  "Besked"
    uuid
      PRIMARY KEY
, "Emne"
    uuid
, "Forfatter"
    uuid
, "DatoTid"
    timestamp
, "Tekst"
    text
);

CREATE TABLE "Modtager"(
  "Besked"
    uuid
, "Person"
    uuid
, PRIMARY KEY("Besked", "Person")
);

CREATE TABLE "Fil"(
  "Fil"
    uuid
      PRIMARY KEY
, "Besked"
    uuid
, "BLOB"
    uuid
, "Navn"
    text
);
Tabeller : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
Det simpleste, når man beskriver formatet, er at begynde at "folde" forbindelsesgrafen fra tabeller, der ikke henviser til nogen.
Trin 4: Afklare skjulte behov
Det er det, vi har designet en database, hvor man kan skrive og på en eller anden måde læse.
Lad os sætte os i brugerens sted — hvad vi ønsker at gøre med vores service?
- Seneste beskeder
Dette kronologisk sorteret register over 'mine' beskeder. Hvor jeg er en af modtagerne, hvor jeg er forfatter, hvor jeg er blevet skrevet til, men ikke svarede, hvor jeg ikke fik svar, … - Deltagere i samtalen
Hvem deltager egentlig i denne lange chat?
Vores struktur gør det muligt at løse begge disse opgaver, men hurtigt — nej. Problemet er, at det er umuligt at oprette et indeks , der passer til hver deltager (og vi må hente alle registreringer), mens det for at løse den anden opgave er nødvendigtat hente alle beskeder om emnet. Uforudsete brugeropgaver kan sætte en fed
streg over ydeevnen Trin 5: Fornuftig denormalisering.
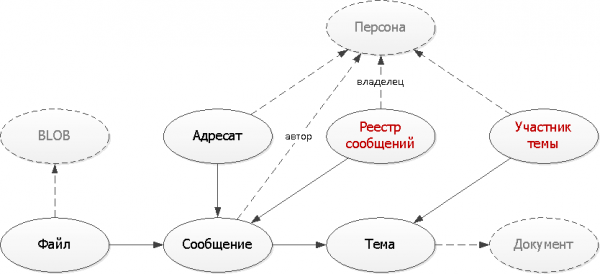
Begge vores problemer kan løses med ekstra tabeller, hvor vi vil
duplikere en del af de data , der er nødvendige for at danne passende indekser til vores opgaver.CREATE TABLE "MessageRegistry"( "Owner" uuid , "RegistryType" smallint , "Datetime" timestamp , "Message" uuid , PRIMARY KEY("Owner", "RegistryType", "Message") ); CREATE INDEX ON "MessageRegistry"("Owner", "RegistryType", "Datetime" DESC);CREATE TABLE "ThemeParticipant"( "Theme" uuid , "Person" uuid , PRIMARY KEY("Theme", "Person") );
Tabeller : RU
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Tabeller : EN
Her har vi anvendt to typiske metoder, der bruges ved oprettelse af hjælpe-tabeller:Multiplicering af optegnelser
- Vi danner for hver enkelt indledende besked straks flere følgeoptegnelser i forskellige typer registrer for forskellige ejere — både for afsenderen og modtageren. Men nu passer hver registrering ind på indekset — for i typisk tilfælde ønsker vi kun at se første side.
Unikalisering af optegnelser - Ved hver afsendelse af en besked inden for et bestemt emne er det nok at kontrollere, om en sådan optegnelse allerede findes. Hvis ikke — tilføjer vi den til vores 'ordbog'.
I den næste del af artiklen vil der være fokus på
implementering af partitionering Arkitektur til opbevaring og levering af billeder i Badoo
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish