

Hej, for nylig stødte jeg på en interessant opgave med at opsætte lager til backup af et stort antal blokke enheder.
Hver uge udfører vi backup af alle virtuelle maskiner i vores sky, og derfor skal vi kunne håndtere tusindvis af sikkerhedskopier og gøre det så hurtigt og effektivt som muligt.
Desværre passer standardkonfigurationerne ikke i dette tilfælde, RAID5, RAID6 da genoprettelsesprocessen på så store diske som vores vil være ubarmhjertigt lang og sandsynligvis aldrig afsluttes.
Lad os overveje, hvilke alternativer der findes:
— Analog til RAID5, RAID6, men med justerbar paritetsniveau. I dette tilfælde udføres redundans ikke blokvis, men for hvert objekt separat. Den nemmeste måde at prøve erasure coding på er at implementere .
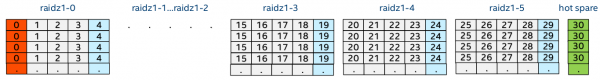
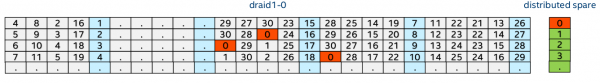
— det er i øjeblikket en endnu ikke frigivet mulighed i ZFS. I modsætning til RAIDZ har DRAID en distribueret paritetsblok og involverer alle diske i arrayet under genopretning, hvilket gør det bedre til at modstå diskfejl og hurtigere at komme sig efter nedbrud.
Vi har en server Fujitsu Primergy RX300 S7 med processor Intel Xeon CPU E5-2650L 0 @ 1.80GHz, ni DIMM-moduler RAM Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), et disk kabinet Supermicro SuperChassis 847E26-RJBOD1, tilsluttet via Dual LSI SAS2X36 Expander og 45 diske Seagate ST6000NM0115-1YZ110 efter 6 TB hver.
Før vi beslutter os for noget, skal vi først teste alt ordentligt.
For dette forberedte jeg mig og gennemførte testning af forskellige konfigurationer. Jeg brugte minio, som fungerede som S3-backend og kørte det i forskellige tilstande med et forskelligt antal targets.
Primært blev casen minio testet i erasure coding vs software raid med det samme antal diske og paritets diske, nemlig: RAID6, RAIDZ2 og DRAID2.
Til reference: når du kører minio med kun én target, fungerer minio i S3-gateway-tilstand og giver dit lokale filsystem som S3-lager. Hvis du derimod kører minio med angivelse af flere targets, aktiveres Erasure Coding-tilstand automatisk, som spreder data mellem dine targets med høj tilgængelighed.
Som standard opdeler minio mål i grupper af 16 diske, hvor hver gruppe har 2 pariteter. Dvs. kan to diske samtidigt være defekte uden tab af data.
Til test af ydeevnen anvendte jeg 16 diske på hver 6TB og skrev små objekter på 1MB, da dette præcist beskrev vores fremtidige belastning, da alle moderne backupværktøjer opdeler data i blokke på nogle megabyte og skriver dem på den måde.
Til benchmarket brugte jeg s3bench værktøjet, som blev kørt på en fjernserver og sendte titusindvis af sådanne objekter til minio i hundredvis af tråde. Derefter forsøgte jeg på samme måde at anmode om dem tilbage.
Resultaterne af benchmarket er angivet i følgende tabel:
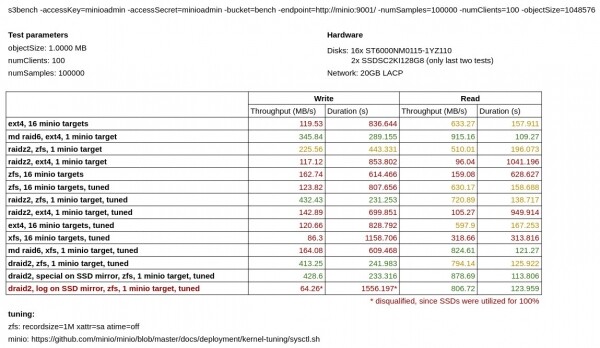
Som vi kan se, fungerer minio i sin egen erasure coding-tilstand betydeligt dårligere ved skrivning end minio, der kører på software RAID6, RAIDZ2 og DRAID2 i den samme konfiguration.
Separat blev jeg at teste minio på ext4 vs XFS. Overraskende nok viste XFS sig at være betydeligt langsommere end ext4 for min type belastning.
I den første test viste Mdadm overlegenhed over ZFS, men senere , at man kan forbedre ydeevnen af ZFS ved at indstille følgende indstillinger:
xattr=sa atime=off recordsize=1Mog efter dette blev testene med ZFS meget bedre.
Det kan også bemærkes, at DRAID ikke giver nogen væsentlig fordel i ydeevne i forhold til RAIDZ, men i teorien burde det være meget sikrere.
I de sidste to tests forsøgte jeg også at flytte metadata (special) og ZIL (log) til et spejl fra SSD. Men flytningen af metadata gav ikke nogen væsentlig forbedring i skrivningshastigheden, og da ZIL blev flyttet, stødte mine op mod loftet med 100% udnyttelse, så jeg betragter denne test som mislykket. Jeg udelukker ikke, at hvis jeg havde hurtigere SSD-diske, kunne dette have forbedret mine resultater betydeligt, men desværre havde jeg ikke nogen.
Til sidst besluttede jeg at stoppe ved brugen af DRAID, og på trods af sin beta-status er det den hurtigste og mest effektive løsning til opbevaring i vores tilfælde.
Jeg oprettede en simpel DRAID2 i konfigurationen med tre grupper og to distributed spares:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Godt, vi har styr på opbevaringen, nu til hvad vi skal tage backup med. Her vil jeg straks nævne tre løsninger, som jeg har haft mulighed for at prøve, nemlig:
— en fork , en specialiseret løsning til backup af bloklagringsenheder, har tæt integration med Ceph. Kan hente diffs mellem snapshots og danne inkrementelle backups. Understøtter et stort antal lagringsbackend, herunder både lokal og S3. Kræver en separat database til opbevaring af deduplication hash-tabellen. Ulemper: skrevet i Python, har en lidt uresponsiv CLI.
— en fork , et længe kendt og afprøvet værktøj til backup, kan sikkerhedskopiere data og deduplicere dem effektivt. Kan gemme backups både lokalt og på en fjernserver via SCP. Kan sikkerhedskopiere bloklagringsenheder, hvis der køres med flaget --special, ulemper: ved oprettelse af en backup blokeres hele repositoryet, så der anbefales at oprette et separat repository for hver virtuel maskine, hvilket ikke er et problem, da de oprettes meget nemt.
— et aktivt udviklende projekt, skrevet i Go, temmelig hurtigt og understøtter mange lagringsbackend, herunder både lokal lagring og SCP, S3 og meget mere. Jeg vil gerne fremhæve, at der er en specielt designet til restic, som muliggør hurtigere eksport af lageret til brug eksternt. Af alle ovennævnte har jeg bedst kunne lide denne. Kan sikkerhedskopiere fra stdin. Har næsten ingen mærkbare ulemper, men der er nogle særlige forhold:
For det første forsøgte jeg at bruge det i tilstand med et fælles repository for alle virtuelle maskiner (som Benji), og det fungerede endda ret godt, men gendannelsesoperationer tog ret lang tid, da restic hver gang forsøger at læse metadata for alle backups før gendannelsen. Dette problem blev let løst som med Borg ved at oprette et separat repository for hver virtuel maskine. Denne tilgang viste sig også at være meget effektiv til at administrere backups. Separate repositories kan have et særskilt adgangskode til dataene, og vi behøver ikke bekymre os om, at det globale repository på en eller anden måde kan gå ned. Nye repositories kan også oprettes lige så nemt som i Borg Backup.
Under alle omstændigheder udføres deduplisering kun i forhold til den tidligere version af backupen, den tidligere backup bestemmes ud fra path for den angivne backup, så hvis du tager backup af forskellige objekter fra stdin i et fælles repository, skal du huske at angive muligheden
--stdin-filename, eller eksplicit hver gang angive muligheden--parent.
For det andet tager gendannelse til stdout betydeligt mere tid end gendannelse til filsystemet på grund af sin parallelitet. I fremtiden planlægges det at tilføje tættere støtte til back-uper for blok-enheder.
For det tredje anbefales det i øjeblikket at bruge , da version 0.9.6 har en fejl med lang gendannelse af store filer.
For at teste effektiviteten af backupen og hastigheden til skrivning / gendannelse fra backupen, har jeg oprettet et separat repository og prøvet at tage backup af et lille billede af en virtuel maskine (21 GB). Der blev udført to backuper uden ændringer af originalen, ved at bruge hver af de nævnte løsninger for at teste, hvor hurtigt / langsomt de deduplikerede data kopieres.
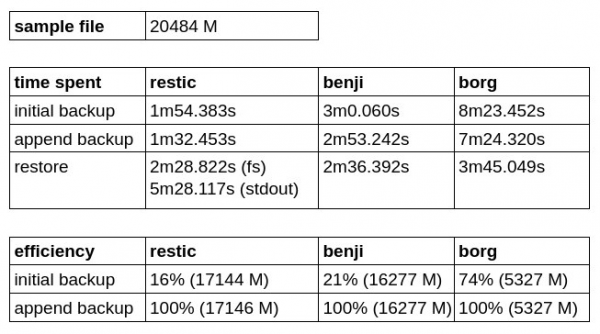
Som vi kan se, har Borg Backup den bedste effektivitet for den indledende backup, men taber i hastighed både ved skrivning og gendannelse.
Restic viste sig at være hurtigere end Benji Backup, men gendanner langsommere til stdout, og desværre kan det ikke skrive direkte til blok-enheden endnu.
Efter at have vejet fordele og ulemper besluttede jeg mig for at vælge restic med rest-server som den mest brugervenlige og lovende løsning til backup.
I denne screencast kan du se, hvordan en 10 gigabit forbindelse fuldt udnyttes under flere samtidige backup-operationer. Det er værd at bemærke, at udnyttelsen af harddiske ikke overstiger 30%.
Jeg er mere end tilfreds med den opnåede løsning!
Kilde: habr.com
