

RabbitMQ – en meddelelsesbroker skrevet i Erlang, der muliggør oprettelse af en fejltolerant klynge med fuld datareplication på flere noder, hvor hver node kan håndtere forespørgsler om læsning og skrivning. Med mange Kubernetes-klynger i produktion understøtter vi et stort antal RabbitMQ-installationer og har mødt behovet for at migrere data fra en klynge til en anden uden nedetid.
Denne operation var nødvendig for os i mindst to tilfælde:
- Overførsel af data fra en RabbitMQ-klynge, der ikke er i Kubernetes, til en ny – allerede "kubernetes-eret" (dvs. fungerende i K8s-pods) – klynge.
- Migration af RabbitMQ inden for Kubernetes fra et namespace til et andet (for eksempel, hvis konturerne er afgrænset af namespaces, så for at flytte infrastrukturen fra én kontur til en anden).
Den opskrift, der foreslås i artiklen, er rettet mod situationer (men begrænses ikke til dem), hvor der er en gammel RabbitMQ-klynge (f.eks. bestående af 3 noder), der enten allerede er i K8s eller på nogle gamle servere. Den fungerer med en applikation, der er placeret i Kubernetes (allerede der eller i perspektiv):
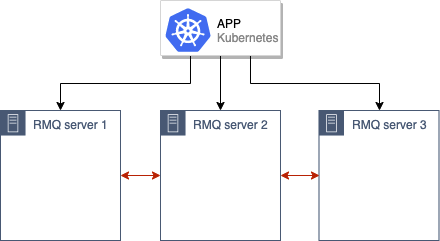
… og vi står over for opgaven med at migrere den til en ny produktion i Kubernetes.
Først vil den generelle tilgang til selve migrationen blive beskrevet, derefter de tekniske detaljer om dens implementering.
Migrationsalgoritmen
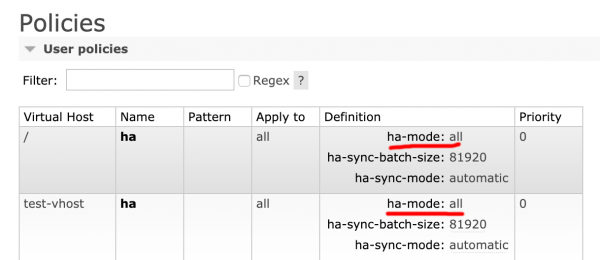
Det første, indledende skridt før nogen handlinger – er at kontrollere, at den gamle RabbitMQ-installation har høj tilgængelighed aktiveret (). Årsagen er åbenbar – vi ønsker jo ikke at miste nogen data. For at foretage denne kontrol kan du gå ind i RabbitMQ-administrationspanelet og under fanen Admin → Policies sikre dig, at værdien er sat til ha-mode: all:
Næste skridt er at oprette en ny RabbitMQ-klynge i Kubernetes-pods (i vores tilfælde f.eks. bestående af 3 noder, men antallet kan være et andet).
Derefter sammenkobler vi den gamle og den nye RabbitMQ-klynge og får en enkelt klynge (bestående af 6 noder):
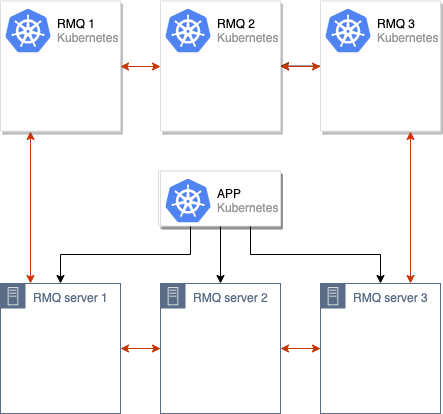
Processen til synkronisering af data mellem de gamle og de nye RabbitMQ-klynger initieres. Når alle data er synkroniseret mellem alle noder i klyngen, kan vi skifte applikationen til at bruge den nye klynge:
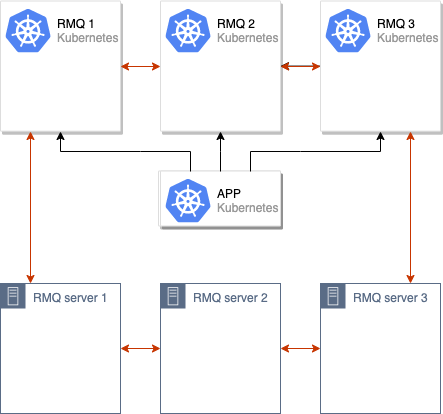
Efter disse operationer er det tilstrækkeligt at fjerne de gamle noder fra RabbitMQ-klyngen, og flytningen kan betragtes som afsluttet:
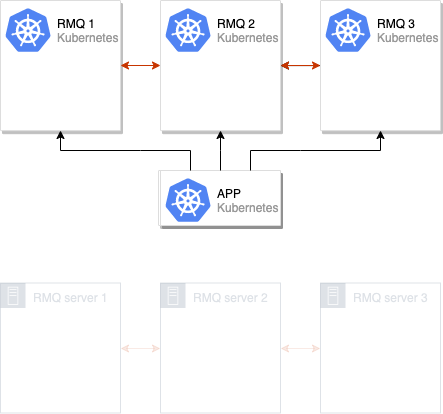
Denne opsætning har vi gentagne gange anvendt i vores produktion. Men for vores egen bekvemmelighed har vi realiseret den som en specialiseret system, der distribuerer standardkonfigurationer af RMQ på flere Kubernetes-klynger. (til dem, der er nysgerrige: det handler om , which we ). Nedenfor vil der blive præsenteret specielle instruktioner, som enhver kan anvende på deres egne installationer for at prøve den foreslåede løsning i praksis.
Prøver i praksis
Krav
Kravene er meget enkle:
- Kubernetes klynge (minikube virker også);
- RabbitMQ-klyngen (kan både være implementeret på bare metal og oprettet som en almindelig klynge i Kubernetes fra det officielle Helm-diagram).
Til det beskrevne eksempel har jeg implementeret RMQ i Kubernetes og navngivet den rmq-old.
Forberedelse af testmiljøet
1. Hent Helm-diagrammet og rediger det lidt:
helm fetch --untar stable/rabbitmq-ha For nemheds skyld sætter vi en adgangskode, ErlangCookie og laver en politik ha-all, så køerne som standard synkroniseres mellem alle noderne i RMQ-klyngen:
rabbitmqPassword: guest
rabbitmqErlangCookie: mae9joopaol7aiVu3eechei2waiGa2we
definitions:
policies: |-
  {
    "name": "ha-all",
    "pattern": ".*",
    "vhost": "\/",
    "definition": {
      "ha-mode": "all",
      "ha-sync-mode": "automatic",
      "ha-sync-batch-size": 81920
    }
  }
2. Installerer diagrammet:
helm install . --name rmq-old --namespace rmq-old3. Gå ind i RabbitMQ adminpanelet, opret en ny kø og tilføj nogle beskeder. De vil være nødvendige for at sikre, at alle data er bevaret og intet er gået tabt efter migrationen:

Testmiljøet er klar: vi har den 'gamle' RabbitMQ med de data, der skal overføres.
Migration af RabbitMQ-klynge
1. For det første skal vi implementere en ny RabbitMQ i en anden navnerummet med de samme ErlangCookie og adgangskode for brugeren. For at gøre dette udfører vi de tidligere nævnte operationer og ændrer den endelige installationskommando for RMQ til følgende:
helm install . --name rmq-new --namespace rmq-new2. Nu skal den nye klynge sammenføjes med den gamle. For at gøre dette går vi ind i hver af pod'erne ny RabbitMQ og udfører kommandoerne:
export OLD_RMQ=rabbit@rmq-old-rabbitmq-ha-0.rmq-old-rabbitmq-ha-discovery.rmq-old.svc.cluster.local &&
  rabbitmqctl stop_app &&
  rabbitmqctl join_cluster $OLD_RMQ &&
  rabbitmqctl start_app
I variablen OLD_RMQ er adressen på en af noderne i den gamle RMQ-klynge.
Disse kommandoer stopper den nuværende node ny fra RMQ-klyngen, forbinder den til den gamle klynge og starter den igen.
3. RMQ-klyngen med 6 noder er klar:
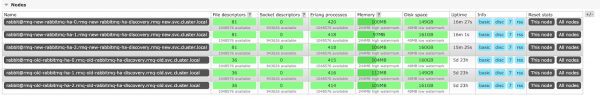
Du skal vente, indtil beskederne synkroniseres mellem alle noder. Det er ikke svært at gætte, at synkroniseringstiden for beskeder afhænger af hardwarekapaciteten, som klyngen er implementeret på, og af antallet af beskeder. I det beskrevne scenarie er der kun 10 beskeder, så dataene blev synkroniseret øjeblikkeligt, men ved et tilstrækkeligt stort antal beskeder kan synkroniseringen tage timer.
Så, synkroniseringsstatus:

Her +5 betyder, at beskederne allerede er endnu på 5 noder (udover den, der er angivet i feltet Node). Således er synkroniseringen succesfuld.
4. Det er kun tilbage at skifte applikationens RMQ-adresse til den nye klynge (de specifikke handlinger her afhænger af den teknologi, du bruger, og anden specifik applikationsinformation), hvorefter du kan sige farvel til den gamle.
Til den sidste operation (dvs. allerede efter skift af applikationen til den nye klynge) går vi ind på hver node i den gamle i klyngen og udfører kommandoerne:
rabbitmqctl stop_app
rabbitmqctl reset
Klyngen har "glemt" de gamle noder: den gamle RMQ kan slettes, hvormed flytningen er færdig.
Bemærk: Hvis du bruger RMQ med certifikater, ændrer det principielt ikke noget - migrationsprocessen vil finde sted på nøjagtig samme måde.
Konklusioner
Den beskrevne metode passer stort set til alle tilfælde, hvor vi skal overføre RabbitMQ eller blot flytte til en ny klynge.
I vores tilfælde opstod der kun problemer én gang, da RMQ blev tilgået fra mange steder, og vi ikke havde mulighed for at ændre RMQ-adressen overalt til den nye. Så lancerede vi den nye RMQ i det samme navnerum med de samme labels for at den kunne falde ind under de eksisterende tjenester og Ingress'er, og ved at starte pod'en manuelt manipulerede vi labels ved at fjerne dem i starten, så der ikke blev sendt forespørgsler til den tomme RMQ, og tilføjede dem igen efter synkroniseringen af beskeder.
Vi anvendte samme strategi ved opgradering af RabbitMQ til en ny version med ændret konfiguration - alt kørte som smurt.
P.S.
Som en logisk fortsættelse af dette materiale forbereder vi artikler om MongoDB (migration fra fysisk server til Kubernetes) og MySQL (hvordan vi forbereder denne DBMS inden for Kubernetes). De vil blive offentliggjort i de kommende måneder.
P.P.S.
Læs også på vores blog:
- «»;
- «».
Kilde: habr.com
