

Præludium
Denne artikel handler om binære søgetræer. For nylig skrev jeg en artikel om Der fokuserede jeg ikke meget på binære træer, da søge-, indsætte- og slette-metoder ikke var relevante. Nu har jeg besluttet at skrive en artikel specifikt om træer. Lad os komme i gang.
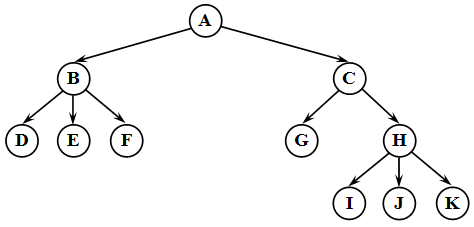
Et træ er en datastruktur, der består af noder der er forbundet med kanter. Man kan sige, at et træ er et særligt tilfælde af en graf. Her er et eksempel på et træ:
Dette er ikke et binært søgetræ! Alt under katten!
Terminologi
Rod
Rod af træet er den øverste node. I eksemplet er det node A. I et træ kan der kun være én vej fra roden til enhver anden node! Faktisk kan enhver node betragtes som rod for det undertræ, der svarer til denne node.
Forældre/efterkommere
Alle noder, undtagen roden, har præcist én kant, der går op til en anden node. Den node, der ligger over den aktuelle, kaldes forælder denne node. Den node, der ligger under den aktuelle og er forbundet med den, kaldes efterkommer denne node. Lad os tage et eksempel. Tag node B, så er dens forælder node A, og dens efterkommere er noderne D, E og F.
Blad
En node, der ikke har nogen efterkommere, kaldes et blad i træet. I eksemplet vil bladene være noderne D, E, F, G, I, J, K.
Dette er den grundlæggende terminologi. Andre begreber vil blive gennemgået senere. Så et binært træ er et træ, hvor hver node har højst to efterkommere. Som du kan gætte, vil træet fra eksemplet ikke være binært, da noderne B og H har mere end to efterkommere. Her er et eksempel på et binært træ:
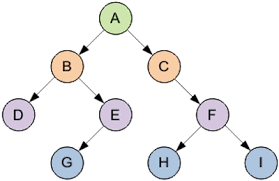
I noderne i træet kan der være enhver information. Et binært søgetræ er et binært træ, der har følgende egenskaber:
- Begge undertræer - venstre og højre - er binære søgetræer.
- Alle noder i venstre undertræ af en vilkårlig node X har datanøgler, der er mindre end datanøglen for node X selv.
- Alle noder i det højre undertræ af en vilkårlig node X har datanøgler, der er større end eller lig med datanøglen for node X selv.
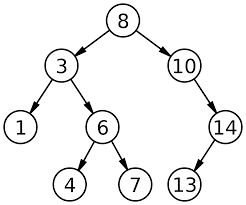
Nøgle - en hvilken som helst egenskab af noden (for eksempel et nummer). Nøglen er nødvendig for at kunne finde elementet i træet, som denne nøgle svarer til. Eksempel på et binært søgetræ:
Præsentation af træet
I takt med at vi skrider frem, vil jeg give nogle (muligvis ufuldstændige) kodeeksempler for at forbedre din forståelse. Den fulde kode vil være i slutningen af artiklen.
Træet består af noder. Struktur for en node:
public class Node<T> {
    private T data;
    private int key;
    private Node<T> leftChild;
    private Node<T> rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }
    public Node<T> getLeftChild() {
        return leftChild;
    }

    public Node<T> getRightChild() {
        return rightChild;
    }
//...andre metoder for noden
}
Hver node har to efterkommere (det er muligt, at efterkommerne leftChild og/eller rightChild kan indeholde værdien null). Du har nok forstået, at i dette tilfælde er data — de data, der opbevares i noden; key — nodens nøgle.
Vi har nu været igennem noden, lad os tage fat på de relevante problemer omkring træer. Her og derefter vil jeg med ordet "træ" henvise til konceptet om et binært søgetræ. Strukturen for et binært træ:
public class BinaryTree<T> {
     private Node<T> root;

    //metoder for træet
}
Som klassefelt har vi kun brug for rodtræet, da vi med metoderne getLeftChild() og getRightChild() kan nå enhver node i træet.
Algoritmer i træet
Søgning
Antag, at du har et opbygget træ. Hvordan finder man et element med nøglen key? Man skal bevæge sig fra roden ned gennem træet og sammenligne værdien af key med nøgleværdien i den aktuelle node: hvis key er mindre end nøgleværdien i den aktuelle node, så gå til den venstre efterkommer; hvis større — til den højre; hvis nøglerne er ens — så er den ønskede node fundet! Den relevante kode er:
public Node<T> find(int key) {
    Node<T> current = root;
    while (current.getKey() != key) {
        if (key < current.getKey())
            current = current.getLeftChild();
        else
            current = current.getRightChild();
        if (current == null)
            return null;
    }
    return current;
}
Hvis current bliver lig med null, så betyder det, at vi er nået til enden af træet (på det konceptuelle niveau befinder du dig et sted, der ikke eksisterer i træet — efterkommeren til et blad).
Lad os se på effektiviteten af søgealgoritmen i et balanceret træ (et træ, hvor noderne er nogenlunde jævnt fordelt). Så vil effektiviteten af søgningen være O(log(n)), hvor logaritmen er med base 2. Se: hvis der er n elementer i det balancerede træ, betyder det, at der vil være log(n) niveauer i træet baseret på 2. Og i søgningen, for hvert skridt i rækken, bevæger du dig ned et niveau.
Indsættelse
Hvis du har forstået essensen af søgningen, vil det ikke være svært for dig at forstå indsættelsen. Du skal bare bevæge dig ned til bladet i træet (ifølge de nedstigende regler, der er beskrevet i søgningen) og blive dens efterkommer — venstre eller højre, afhængigt af nøgleværdien. Implementering:
   public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }
I dette tilfælde skal vi, udover den nuværende node, gemme oplysninger om forælderen til den nuværende node. Når current bliver lig med null, vil variablen parent indeholde det ønskede blad.
Effektiviteten af indsættelse vil åbenlyst være den samme som for søgning — O(log(n)).
Sletning
Sletning er den mest komplekse operation, der skal udføres med træet. Det er klart, at vi først skal finde det element, vi ønsker at slette. Men hvad så? Hvis vi blot tildeler dens reference værdien null, vil vi miste informationen om den undertræ, der har denne node som rod. Metoder til sletning af træer opdeles i tre tilfælde.
Første tilfælde. Den slettede node har ingen efterkommere.
Hvis den slettede node ikke har nogen efterkommere, betyder det, at den er et blad. Derved kan vi blot sætte venstre eller højre barn af dens forælder til null.
Andet tilfælde. Den slettede node har én efterkommer.
Dette tilfælde er heller ikke særlig udfordrende. Lad os vende tilbage til vores eksempel. Antag, at vi skal slette elementet med nøgle 14. Enig, da det er en højre efterkommer af noden med nøgle 10, vil enhver af dens efterkommere (i dette tilfælde højre) have en nøgle, der er større end 10, og derfor kan vi let 'skære' det ud af træet, og forælderen kan forbindes direkte med efterkommeren af den slettede node, dvs. noden med nøgle 10 kan forbindes med noden 13. En lignende situation ville være, hvis vi skulle slette en node, der er en venstre efterkommer af sin forælder. Tænk selv over det — en nøjagtig analogi.
Tredje tilfælde. Noden har to efterkommere.
Det mest komplekse tilfælde. Lad os tage et nyt eksempel.
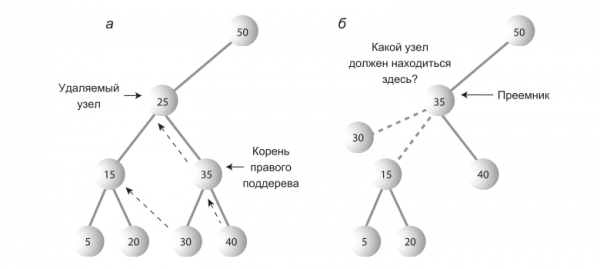
Søgning efter efterfølger.
Lad os antage, at vi skal fjerne noden med nøgle 25. Hvem sætter vi i dens sted? En af dens efterfølgere (efterkommere eller efterkommere til efterkommere) skal blive efterfølgeren(den, der skal overtage den fjernede nodes plads).
Hvordan forstår man, hvem der skal blive efterfølger? Det er intuitivt klart, at det er en node i træet, hvis nøgle er den næste største i forhold til den fjernede node. Algoritmen går som følger. Man skal gå til dens højre efterkommer (altid til højre, da det allerede er sagt, at efterfølgerens nøgle er større end den fjernede nodes nøgle), og derefter bevæge sig ned ad kæden af venstre efterkommere til denne højre efterkommer. I eksemplet skal vi gå til noden med nøgle 35, og derefter bevæge os ned til bladet langs kæden af dens venstre efterkommere — i dette tilfælde består denne kæde kun af noden med nøgle 30. Strengt taget leder vi efter den mindste node i sættet af noder, der er større end den ønskede node.
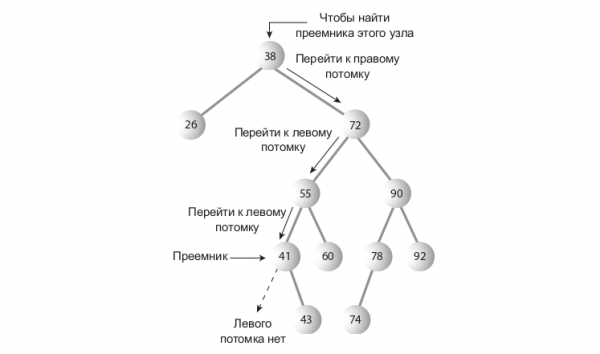
Koden til metoden til at finde efterfølgeren:
    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode; // forælder til efterfølgeren
        Node<T> successor = deleteNode; // efterfølger
        Node<T> current = successor.getRightChild(); // simpelthen en "catching" node
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }
        // når vi forlader loopet har vi efterfølgeren og forælderen til efterfølgeren
        if (successor != deleteNode.getRightChild()) { // hvis efterfølgeren ikke stemmer overens med den højre efterkommer til den fjernede node
            parentSuccessor.setLeftChild(successor.getRightChild()); // så overtager dens forælder efterfølgerens efterkommer, så de ikke mister den
            successor.setRightChild(deleteNode.getRightChild()); // forbinder efterfølgeren med den højre efterkommer til den fjernede node
        }
        return successor;
    }
Den komplette kode til metoden delete:
public boolean delete(int deleteKey) {
        Node current = root;
        Node parent = current;
        boolean isLeftChild = false; // Afhængigt af om den slettede node er venstre eller højre barn af sin forælder, vil boolesk variabel isLeftChild være true eller false henholdsvis.
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) { // første tilfælde
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) { // andet tilfælde
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else { // tredje tilfælde
            Node successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }
Kompleksiteten kan tilnærmes til O(log(n)).
Søgning efter maksimum/minimum i træet
Det er åbenlyst, hvordan man finder den mindste/største værdi i træet - man skal konsekvent bevæge sig gennem kæden af venstre/højre elementer i træet; når man når bladet, er det den mindste/største element.
    public Node getMinimum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node getMaximum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }
Kompleksiteten er O(log(n))
Symmetrisk gennemgang
Gennemgang - at besøge hver node i træet for at udføre en handling med den.
Algoritmen for rekursiv symmetrisk gennemgang:
- Udfør handling med venstre barn
- Udfør handling med dig selv
- Udfør handling med højre barn
Kode:
    public void inOrder(Node current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " "); //Her kan være hvad som helst
            inOrder(current.getRightChild());
        }
    }
Konklusion
Endelig! Hvis jeg har uddybet noget for lidt, eller hvis der er kommentarer, ser jeg frem til at høre dem. Som lovet, bringer jeg den fulde kode.
Node.java:
public class Node {
    private T data;
    private int key;
    private Node leftChild;
    private Node rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }

    public void setLeftChild(Node newNode) {
        leftChild = newNode;
    }

    public void setRightChild(Node newNode) {
        rightChild = newNode;
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public T getData() {
        return data;
    }

    public int getKey() {
        return key;
    }
}
BinaryTree.java:
public class BinaryTree<T> {
    private Node<T> root;

    public Node<T> find(int key) {
        Node<T> current = root;
        while (current.getKey() != key) {
            if (key < current.getKey())
                current = current.getLeftChild();
            else
                current = current.getRightChild();
            if (current == null)
                return null;
        }
        return current;
    }

    public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }

    public Node<T> getMinimum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node<T> getMaximum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }

    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode;
        Node<T> successor = deleteNode;
        Node<T> current = successor.getRightChild();
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }

        if (successor != deleteNode.getRightChild()) {
            parentSuccessor.setLeftChild(successor.getRightChild());
            successor.setRightChild(deleteNode.getRightChild());
        }
        return successor;
    }

    public boolean delete(int deleteKey) {
        Node<T> current = root;
        Node<T> parent = current;
        boolean isLeftChild = false;
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {
            Node<T> successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }

    public void inOrder(Node<T> current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");
            inOrder(current.getRightChild());
        }
    }
}
P.S.
Hen til O(n)
Mange af jer har måske bemærket: hvad nu hvis vi gør, så træet bliver ubalanceret? For eksempel ved at indsætte noder i træet med stigende nøgler: 1,2,3,4,5,6… Så vil træet minde om en kædeloop. Og ja, træet vil miste sin træ-lignende struktur, og dermed også effektiviteten af datatilgang. Tidskompleksiteten for søge-, indsætte- og sletteoperationer vil blive den samme som for en kædeloop: O(n). Dette er en af de vigtigste ulemper ved binære træer, efter min mening.
Kun registrerede brugere kan deltage i undersøgelsen. , please.
Jeg er ikke så længe siden på Habr, og jeg vil gerne vide, hvilke emner I gerne vil se flere artikler om?
Datakonstruktioner
Algoritmer (DP, rekursion, datakompression osv.)
Anvendelse af datakonstruktioner og algoritmer i det virkelige liv
Programmering af Android-applikationer i Java
Programmering af webapplikationer i Java
2 brugere har stemt. 1 bruger har afholdt sig.
Kilde: habr.com
