

I dag har "Bitrix24" ikke hundrede gigabit trafik, og der er ikke et stort antal servere (selvom der selvfølgelig er nogle til stede). Men for mange kunder er det det primære arbejdsredskab i virksomheden, et virkelig business-critical program. Derfor må det ikke gå ned — slet ikke. Hvad hvis nedbruddet faktisk sker, men tjenesten "genopstår" så hurtigt, at ingen overhovedet bemærker det? Og hvordan lykkes det at implementere failover uden tab af kvalitet og kunder? Alexander Demidov, direktør for cloud-tjenesterne i "Bitrix24", fortalte i vores blog om, hvordan systemet til backup har udviklet sig i løbet af de 7 år, produktet har eksisteret.
"Vi lancerede "Bitrix24" som SaaS for 7 år siden. Den største udfordring var sikkert følgende: Inden lanceringen som SaaS eksisterede dette produkt blot i form af en box-løsning. Kunder købte det fra os, installerede det på deres servere, oprettede et firmaportale - en samlet løsning til kommunikation mellem medarbejdere, opbevaring af filer, forvaltning af opgaver, CRM, ja, alt det der. Og i 2012 besluttede vi, at vi ville lancere det som SaaS, administrere det selv og sikre failover og pålidelighed. Vi opnåede erfaring undervejs, fordi vi indtil da ikke havde nogen — vi var kun softwareproducenter, ikke serviceudbydere.
Ved lanceringen af tjenesten vidste vi, at det vigtigste var at sikre failover, pålidelighed og konstant tilgængelighed, fordi hvis du har en almindelig hjemmeside, en butik for eksempel, og den går ned i en time — så er det kun dig selv, der lider, du mister ordrer, du mister kunder, men for din kunde — for ham er det ikke så kritisk. Han bliver naturligvis frustreret, men går hen og køber på en anden hjemmeside. Men hvis det er en applikation, som hele virksomheden, kommunikationen og løsningerne er afhængig af, så er det vigtigste at vinde brugernes tillid, altså ikke svigte dem og ikke gå ned. Fordi hele arbejdet kan stoppe, hvis noget indeni ikke fungerer.
Bitrix24 som SaaS
Den første prototype samlede vi et år før den offentlige lancering, i 2011. Den blev samlet på cirka en uge, vi kiggede på den, drejede den — den fungerede endda. Man kunne tilgå formularen, indtaste navnet på portalen, og en ny portal blev oprettet med en brugerbase. Vi så på den, vurderede produktet generelt, lukkede det ned, og arbejdede videre i et helt år. Fordi vi havde en stor opgave: vi ønskede ikke at have to forskellige kodebaser, vi ville ikke støtte et kasseprodukt og en cloud-løsning separat — vi ønskede at lave det hele inden for én kode.
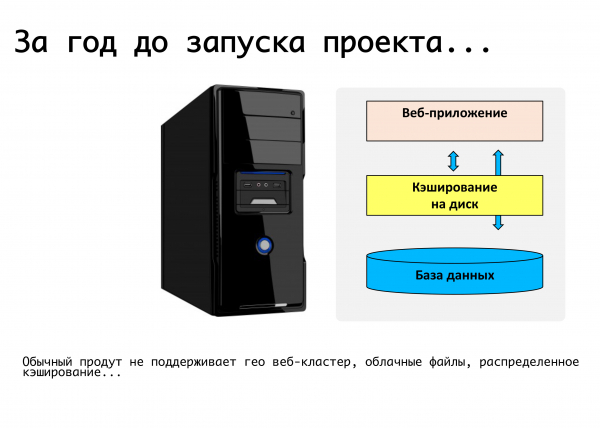
Et typisk webapplikation på det tidspunkt var — en server, hvor der kørte noget PHP-kode, en MySQL-database, filer blev uploadet, dokumenter og billeder blev lagt i en upload-mappe – og så fungerede det hele. Desværre er det umuligt at starte en kritisk robust webservice på dette. Der understøttes ikke distribueret cache, og databasesynkronisering understøttes ikke.
Vi formulerede kravene: evnen til at placere sig i forskellige lokationer, understøtte replikation, ideelt set at være placeret i forskellige geografisk fordelte datacentre. At adskille produktlogikken og selve datalagringen. Dynamisk kunne skalere efter belastningen, statikken skulle helt tage ud. Ud fra disse overvejelser blev kravene til produktet, som vi netop arbejdede på i løbet af et år, dannet. I den platform, som blev enhed — til kasse-løsninger og vores egen service — implementerede vi støtte til de ting, som var nødvendige for os. Støtte til MySQL-replikation på produktniveau: det vil sige, at udvikleren, der skriver koden — ikke behøver at tænke på, hvordan hans forespørgsler vil blive fordelt, han bruger vores API, og vi ved, hvordan vi korrekt fordeler skrive- og læseforespørgsler mellem mastere og slaver.
Vi har implementeret støtte på produktniveau for forskellige cloud objektlagringssystemer: Google Storage, Amazon S3 — plus, støtte til OpenStack Swift. Derfor var det praktisk både for os som service og for udviklere, der arbejder med kasseproduktet: hvis de blot bruger vores API til arbejdet, behøver de ikke at tænke på, hvor filen i sidste ende gemmes, lokalt på filsystemet eller om den ender i objektlagringssystemet.
Som resultat besluttede vi straks, at vi ville have en backup på datacenter-niveau. I 2012 startede vi fuld ud i Amazon AWS, fordi vi allerede havde erfaring med denne platform — vores egen hjemmeside var hostet der. Det tiltrak os, at der i hver region i Amazon er flere tilgængelighedszoner — i deres terminologi, flere datacentre, der er mere eller mindre uafhængige af hinanden og tillader os at have en backup på datacenter-niveau: hvis det pludselig fejler, er databaserne replikat master-master, webapplikationsserverne er reserveret, og statikken er flyttet til objektlageret s3. Belastningen balanceres — på det tidspunkt med Amazons elb, men lidt senere kom vi til vores egne belastningsbalancere, fordi vi havde brug for en mere kompleks logik.
Hvad vi ønskede — fik vi...
Alle de grundlæggende ting, som vi ønskede at sikre — høj tilgængelighed af selve serverne, webapplikationer, databaser — fungerede alle godt. Den enkleste scenario: hvis en af vores webapplikationer fejler, så er det meget simpelt — de tages ud af belastningsbalanceringen.
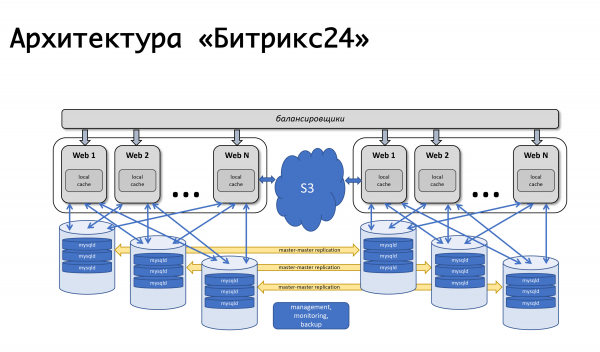
De fejlede maskiner blev markeret som usunde af belastningsbalanceren (dengang var det Amazons elb), som selv stoppede belastningsfordelingen til dem. Amazons autoskalering fungerede: når belastningen steg, blev nye maskiner tilføjet til autoskaleringgruppen, og belastningen blev fordelt til de nye maskiner — alt var godt. Med vores belastningsbalancere er logikken stort set den samme: hvis der sker noget med applikationsserveren, fjerner vi forespørgslerne, fjerner disse maskiner, starter nye og fortsætter med at arbejde. Skemaet har ændret sig en smule gennem årene, men det fungerer stadig: det er enkelt, forståeligt, og der er ingen komplikationer med det.
Vi arbejder over hele verden, og kundernes belastningsspidser er helt forskellige, og ideelt set skal vi have mulighed for at udføre servicearbejde på alle komponenter i vores system når som helst – uden at kunderne lægger mærke til det. Derfor har vi mulighed for at tage databasen ud af drift og omfordele belastningen til det andet datacenter.
Hvordan fungerer det hele? — Vi omdirigerer trafikken til det fungerende datacenter — hvis det er en nedbrud på datacenteret, så er det helt, hvis det er vores planlagte arbejde med en specifik database, så omdirigerer vi en del af trafikken, der betjener disse kunder, til det andet datacenter, og replikationen stoppes. Hvis vi har brug for nye maskiner til webapplikationer, fordi belastningen er steget i det andet datacenter, starter de automatisk. Når arbejdet er færdigt, genoprettes replikationen, og vi returnerer hele belastningen tilbage. Hvis vi skal udføre spejlvendt arbejde i det andet datacenter, for eksempel installere systemopdateringer eller ændre indstillingerne i den anden database, gentager vi i princippet det samme, blot i den modsatte retning. Men hvis det er en nødssituation, gør vi det meget enkelt: vi bruger mekanismen event-handlers i overvågningssystemet. Hvis flere tjek udløses, og status skifter til kritisk, aktiveres den handler, der kan udføre den eller den logik. For hver database har vi specificeret, hvilken server der er dens failover, og hvor trafikken skal omdirigeres, hvis den bliver utilgængelig. Historisk set har vi brugt nagios i en eller anden form eller dens forks. I princippet findes sådanne mekanismer næsten i alle overvågningssystemer, men noget mere komplekst bruger vi ikke endnu, men det kan være, vi gør det en dag. I øjeblikket reagerer overvågningen på utilgængelighed og har mulighed for at omdirigere noget.
Har vi reserveret alt?
Vi har mange kunder fra USA, mange kunder fra Europa, mange kunder, der er tættere på Østen — Japan, Singapore osv. Selvfølgelig er en stor del af klienterne i Rusland. Det vil sige, at arbejdet ikke kun foregår i én region. Brugerne ønsker hurtige svartider, der er krav om overholdelse af forskellige lokale love, og inden for hver region reserverer vi os til to datacentre, plus der er nogle ekstra tjenester, som igen er bekvemme at placere inden for én region — for kunder, der arbejder i denne region. REST-handlere, autorisationsservere er mindre kritiske for klientens samlede drift, og de kan skiftes med en acceptabel forsinkelse, men vi ønsker ikke at opfinde cyklen, hvad angår overvågning og håndtering af dem. Derfor forsøger vi maksimalt at bruge eksisterende løsninger frem for at udvikle kompetencer inden for yderligere produkter. Og nogle gange bruger vi bare skift på dns-niveau, hvorvi også bestemmer tjenestens tilgængelighed ved hjælp af den samme dns. Amazon har en tjeneste kaldet Route 53, men det er ikke bare dns, hvor man kan tilføje poster og så videre — den er langt mere fleksibel og praktisk. Gennem den kan man opbygge geo-distribuerede tjenester med geolocation, når du ved hjælp deraf definerer, hvor kunden kom fra, og giver ham de forskellige poster — man kan opbygge failover-arkitekturer med den. De samme health-checks indstilles i selve Route 53, hvor du angiver endpoints, der overvåges, definerer metrics, og angiver, hvilke protokoller der skal bruges til at bestemme tjenestens 'livlighed' — tcp, http, https; du angiver hyppigheden af tjek, der bestemmer, om tjenesten er live eller ej. Og i selve dns angiver du, hvad der vil være primært, hvad der vil være sekundært, og hvor der skal skiftes hen, hvis health-checks indgår i Route 53. Alt dette kan gøres med nogle andre værktøjer, men det praktiske er, at man kun skal indstille det én gang, og så tænker vi slet ikke mere over, hvordan vi laver tjek, og hvordan overgangen finder sted: alt fungerer af sig selv.
Det første 'men': hvordan og med hvad skal man tage backup af selve route 53? Man ved jo aldrig, hvis der skulle ske noget med det? Heldigvis har vi aldrig været ude for det, men jeg vil igen fortælle, hvorfor vi tænkte, at vi alligevel skulle tage backup. Her forbereder vi os, så vi har sikkerhed forud. Flere gange om dagen laver vi en fuld eksport af alle zoner, som vi har i route 53. Amazons API gør det muligt at hente dem ud i JSON, og vi har opsat flere backup-servere, hvor vi konverterer dette, eksporterer det som konfigurationer og har, så at sige, en backup-konfiguration. I tilfælde af noget kan vi hurtigt genoprette den manuelt, uden at vi mister DNS-indstillingsdata.
Den anden "men": hvad er der endnu ikke blevet taget backup af? Selve balanceringssystemet! Vi har fordelt kunderne på regioner på en meget enkel måde. Vi har domæner som bitrix24.ru, bitrix24.com, .de — nu er der omkring 13 forskellige, som arbejder på meget forskellige zoner. Vi er nået frem til følgende: i hver region er der egne balanceringssystemer. Det er lettere at fordele efter regioner, alt efter hvor den spidse netbelastning er. Hvis der er en fejl på et enkelt balanceringssystem, så tages det simpelthen ud af drift og fjernes fra DNS. Hvis der opstår problemer med gruppen af balanceringssystemer, så tages de backup andre steder, og skiftet mellem dem sker ved hjælp af den samme route53, fordi på grund af den korte TTL sker skiftet maksimalt inden for 2, 3, 5 minutter.
Den tredje "men": hvad er der ellers ikke blevet taget backup af? S3, korrekt. Da vi lagrer filer, som vi opbevarer hos brugerne i S3, troede vi oprigtigt, at det var uovervindeligt, og at der ikke var behov for at tage backup der. Men historien viser, at det sker anderledes. Generelt beskriver Amazon S3 som en grundlæggende tjeneste, fordi Amazon selv bruger S3 til at opbevare maskinbilleder, konfigurationer, AMI-billeder, snapshots... Og hvis S3 falder, som det engang skete i de 7 år, vi har anvendt bitrix24, trækker det en hel del andre problemer med sig — utilgængelighed af opstart af virtuelle maskiner, fejl i API'en, osv.
Og S3 kan falde ned – det skete engang. Derfor kom vi frem til følgende ordning: For flere år siden fandtes der ikke seriøse offentlige objektholdere i Rusland, og vi overvejede at lave noget selv… Heldigvis begyndte vi ikke på det, for vi ville være blevet begravet i den ekspertise, vi ikke har, og sikkert ville vi have lavet fejl. Nu findes der S3-kompatible opbevaringsløsninger fra Mail.ru, fra Yandex, samt fra en række andre udbydere. Til sidst kom vi frem til, at vi ønskede, for det første, redundans, og for det andet, muligheden for at arbejde med lokale kopier. Til den specifikke russiske region bruger vi Mail.ru Hotbox, som er API-kompatibel med S3. Vi havde ikke brug for betydelige modifikationer af koden i applikationen, og vi har lavet følgende mekanisme: i S3 er der triggere, der aktiveres ved oprettelse/fjernelse af objekter; Amazon har en service kaldet Lambda – det er serverless kørsel af kode, der bliver udført, når de forskellige triggere aktiveres.
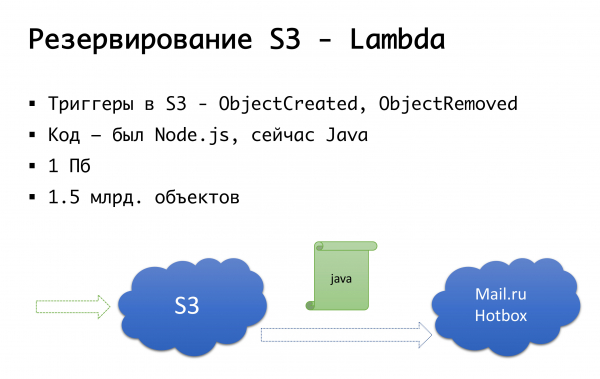
Vi gjorde det meget simpelt: når en trigger udløses, udfører vi koden, der kopierer objektet til Mail.ru-holdet. For at kunne starte arbejdet med lokale kopier af data skal vi have omvendt synkronisering, så kunder, der befinder sig i den russiske sektion, kan arbejde med det lager, der er nærmest dem. Mail er lige ved at færdiggøre triggere i sit lager – der vil være mulighed for at udføre omvendt synkronisering på infrastruktur niveau, men indtil videre gør vi det på niveau med vores egen kode. Hvis vi ser, at en kunde har uploadet en fil, placerer vi et event i køen på vores kode niveau, behandler det og udfører omvendt replikation. Ulempen ved dette er: hvis der sker noget med vores objekter uden for vores produkt, dvs. med nogle eksterne værktøjer, vil vi ikke tage højde for det. Derfor venter vi på, at triggere på lager niveau bliver tilgængelige, så uanset hvor vi udførte koden, vil objektet, der kommer til os, blive kopieret den anden vej.
På kode niveau er der for hver kunde angivet to opbevaringsløsninger: en betragtes som primær, den anden som backup. Hvis alt er i orden, arbejder vi med den opbevaringsløsning, der er tættest på os: vores kunder, der er i Amazon, arbejder med S3, mens dem, der arbejder i Rusland, bruger Hotbox. Hvis flaget aktiveres, skal vi have en failover tilslutte sig, og vi skifter kunderne til den anden opbevaringsløsning. Vi kan sætte dette flag uafhængigt efter regioner og kan skifte dem frem og tilbage. I praksis har vi ikke brugt det endnu, men mekanismen er forudset, og vi tror, at vi en dag vil få brug for dette skift. Det er allerede sket én gang.
Åh, er jeres Amazon stukket af…
I april er det årsdagen for begyndelsen på blokaderne af Telegram i Rusland. Den mest påvirkede udbyder, som blev ramt af dette, er Amazon. Og desværre har de russiske virksomheder, der arbejdede globalt, lidt mest.
Hvis virksomheden er global, og Rusland kun udgør en meget lille del, 3-5% — så kan de på en eller anden måde ofres.
Hvis det er en helt russisk virksomhed — så er jeg sikker på, at de bør placere sig lokalt — det vil simpelthen være mere bekvemt og komfortabelt for brugerne, og risiciene vil være mindre.
Og hvis dette er en virksomhed, der arbejder globalt, og har nogenlunde lige mange kunder i Rusland som rundt om i verden? Forbindelsen mellem segmenterne er vigtig, og de skal på en eller anden måde arbejde sammen.
Allerede i slutningen af marts 2018 sendte Roskomnadzor et brev til de største operatører om, at de planlægger at blokere flere millioner IP-adresser fra Amazon for at blokere… beskedapplikationen Zello. Tak til disse udbydere — de lækkede brevet til alle, og der opstod en forståelse af, at forbindelsen til Amazon kunne bryde sammen. Det var en fredag, og vi løb panikslagne hen til kollegerne fra servers.ru og sagde: „Venner, vi har brug for flere servere, der ikke står i Rusland, ikke i Amazon, men for eksempel et eller andet sted i Amsterdam“, for at kunne sætte vores egne der. vpn og proxy til nogle endpoints, som vi ikke kan påvirke, såsom endpoints for S3 — man kan ikke forsøge at oprette en ny service og få en anden IP, vi skal stadig kunne nå dem. I løbet af et par dage fik vi disse servere konfigureret, opsat, og i det hele taget var vi forberedt, da blokaderne begyndte. Det er interessant, at Roskomnadzor, efter at have set opstyret og panikken, sagde: «Nej, vi vil ikke blokere noget lige nu». (Men det varede lige indtil de begyndte at blokere Telegram.) Efter at have konfigureret mulighederne for at omgå blokaderne og forstået, at blokaden ikke blev indført, besluttede vi ikke at skille os af med det hele. Bare for en sikkerheds skyld.
Og så, i 2019, lever vi nu i betingelser med blokader. Jeg så i går nat: omkring en million IP-adresser fortsætter med at blive blokeret. Sandheden er, at Amazon næsten blev fuldstændig afblokeret, i toppen nåede det op på 20 millioner adresser… Den virkelighed er, at der kan mangle forbindelse — god forbindelse — pludselig. Den kan mangle af tekniske årsager — brande, gravemaskiner, alt det der. Eller, som vi har set, ikke helt teknisk. Derfor kan nogen store og betydelige med egne AS'er, sikkert styre dette på andre måder — direkte forbindelse og andre ting allerede på niveau l2. Men i en simpel variant, som os eller andre mindre, kan det være en god idé at have redundans på serverniveau, opsat et andet sted, på forhånd konfigureret VPN, proxy, med mulighed for hurtigt at skifte konfiguration til de segmenter, som er kritiske for din forbindelse. Dette har hjulpet os flere gange, når blokaderne mod Amazon begyndte, vi brugte i værste fald netop trafik fra S3, men gradvist blev det løst.
Hvordan kan man reservenere… en hel udbyder?
Vi har i øjeblikket ikke et scenarie for en total nedbrud af Amazon. Vi har et lignende scenarie for Rusland. I Rusland brugte vi en udbyder, hvor vi valgte at have flere lokaliteter. For et år siden stødte vi på et problem: selvom det er to datacentre, kan der allerede ved niveauet for udbyderens netværkskonfiguration være problemer, der vil påvirke begge datacentre. Det kan resultere i nedetid på begge lokaliteter. Og selvfølgelig skete det også. Vi har i sidste ende gennemgået vores interne arkitektur. Den har ikke ændret sig meget, men i Rusland har vi nu to lokaliteter, som ikke er hos én udbyder, men hos to forskellige. Hvis én skulle gå ned, kan vi skifte over til den anden.
Hypotetisk set overvejer vi for Amazon at reservere på niveauet for en anden udbyder; måske Google, måske nogen anden… Men indtil videre har vi observeret, at hvis der sker nedbrud på niveauet for en availability-zone hos Amazon, så er nedbrud på niveauet for en hel region et relativt sjældent fænomen. Derfor har vi en teoretisk idé om, at vi måske vil implementere en reserveløsning „Amazon – ikke Amazon“, men praktisk set har det endnu ikke været tilfældet.
Et par ord om automatisering
Er automatisering altid nødvendig? Her er det passende at nævne Dunning-Kruger-effekten. På x-aksen har vi vores viden og erfaring, som vi opnår, og på y-aksen er vores selvtillid i vores handlinger. Først ved vi ikke noget og er slet ikke sikre. Derefter ved vi lidt og bliver mega-sikre — det er det, man kalder „toppunktet for tåbelighed“, som godt illustreres af billedet „dåneskab og mod“. Herefter har vi lært lidt og er klar til at gå i kamp. Så træder vi på nogle mega-seriøse problemer, falder ind i fortvivlelsens dal, hvor vi ser ud til at vide noget, men i virkeligheden ved vi ikke meget. Derefter, efterhånden som vi får mere erfaring, bliver vi mere selvsikre.
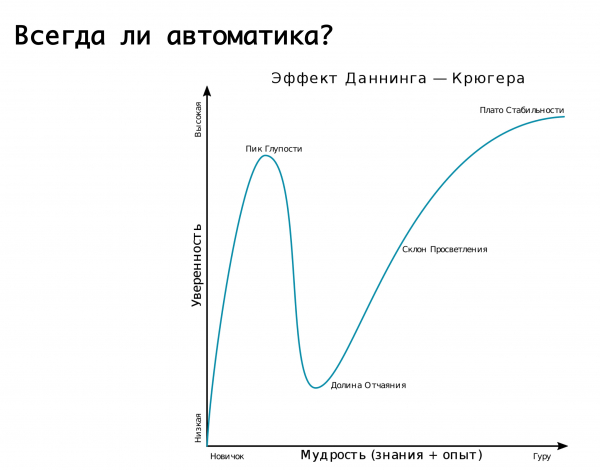
Vores logik omkring de forskellige skift til specifikke fejl er meget godt beskrevet af denne grafik. Vi startede — vi vidste intet, praktisk talt alt arbejde blev udført manuelt. Senere indså vi, at vi kunne automatisere alting og dermed sove roligt. Men pludselig ramte vi en kæmpe forhindring: vi fik false positive, og vi skiftede trafik frem og tilbage, selvom det egentlig ikke burde have været nødvendigt. Følgelig brød replikationen sammen eller noget andet — det er dalen af fortvivlelse. Derefter kom vi til indsigten, at man skal forholde sig til alt med omtanke. Det vil sige, der giver mening at stole på automatiseringen, forudsat at man tager højde for muligheden for falske alarmer. Men! hvis konsekvenserne kan være ødelæggende, er det bedre at overlade det til den vagtholdende skift og ingeniører, som vil sikre, at der virkelig er en fejl, og udføre de nødvendige handlinger manuelt...
Konklusion
I løbet af 7 år har vi bevæget os fra at panikke, når noget gik ned, til at forstå, at problemer ikke eksisterer; der er kun opgaver, der skal løses — og som kan løses. Når du bygger en service, så se den fra oven, og vurder alle de risici, der kan opstå. Hvis du straks ser dem — så forudse reserven og muligheden for at bygge en fejltolerant infrastruktur, for enhver punkt der kan bryde sammen og føre til, at servicen ikke fungerer — det vil helt sikkert ske. Og selv hvis du mener, at visse elementer af infrastrukturen ikke vil bryde sammen — som for eksempel S3 — så vær klar over, at de kan. Og i det mindste i teorien, hav en idé om, hvad du vil gøre med dem, hvis noget alligevel skulle ske. Hav en plan for risikohåndtering. Når du overvejer, om alting skal gøres automatisk eller manuelt, så vurder risiciene: hvad sker der, hvis automatiseringen begynder at skifte alt — vil det føre til en endnu værre situation sammenlignet med en fejl? Måske er der steder, hvor der skal anvendes en fornuftig balance mellem at bruge automatisering og reaktionen fra den vagtholdende ingeniør, der vurderer den reelle situation og forstår, om noget skal skiftes straks eller "ja, men ikke nu".
En fornuftig balance mellem perfektionisme og de reelle ressourcer, tid og penge, som du kan investere i det resultat, du ender op med.
Denne tekst er en udvidet version af Alexander Demidovs præsentation på konferencen. .
Kilde: habr.com
