

Ofte har folk, der træder ind i Data Science, en lidt urealistisk opfattelse af, hvad der venter dem. Mange tror, at de nu vil skrive fantastiske neurale netværk, skabe en stemmeassistent som Iron Man eller overhale alle på de finansielle markeder.
Men arbejdet Data Scientist er knyttet til data, og et af de vigtigste og tidskrævende aspekter er databehandling, før de skal ind i et neuralt netværk eller analyseres på en bestemt måde.
I denne artikel vil vores team beskrive, hvordan man nemt og hurtigt kan behandle data med en trin-for-trin vejledning og kode. Vi har forsøgt at gøre koden tilpasningsdygtig, så den kan anvendes til forskellige datasæt.
Mange professionelle vil muligvis ikke finde noget ekstraordinært i denne artikel, men begyndere kan få noget nyt at lære, og alle, der længe har ønsket at lave deres eget notebook til hurtig og struktureret databehandling, kan kopiere koden og tilpasse den, eller
Vi har fået et datasæt. Hvad gør vi nu?
Så standarden: vi skal forstå, hvad vi har med at gøre, det samlede billede. Til dette bruger vi pandas for bare at identificere de forskellige datatyper.
import pandas as pd #importer pandas
import numpy as np  #importer numpy
df = pd.read_csv("AB_NYC_2019.csv") #læser datasættet og gemmer det i variablen df
df.head(3) #ser på de første 3 rækker for at forstå, hvordan værdierne ser ud 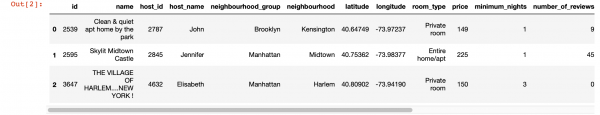
df.info() #Viser information om kolonnerne 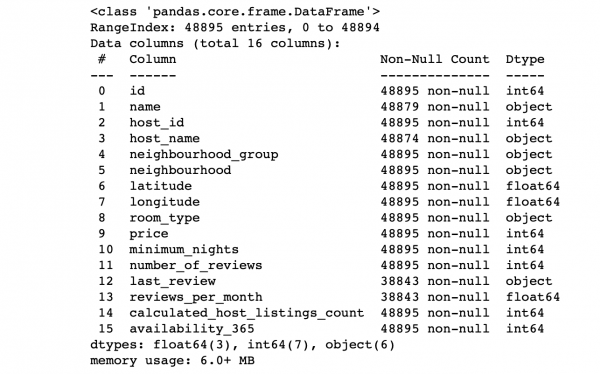
Lad os se på værdierne i kolonnerne:
- Matcher antallet af rækker i hver kolonne det samlede antal rækker?
- Hvad handler dataene i hver kolonne om?
- Hvilken kolonne vil vi vælge som target for at lave forudsigelser for den?
Svarene på disse spørgsmål vil muliggøre analysen af datasættet og give os en idé om de næste skridt.
Desuden, for at få et dybere indblik i værdierne i hver kolonne, kan vi bruge pandas describe()-funktionen. Ulempen ved denne funktion er, at den ikke giver information om kolonner med string-værdier. Det vil vi tage os af senere.
df.describe() 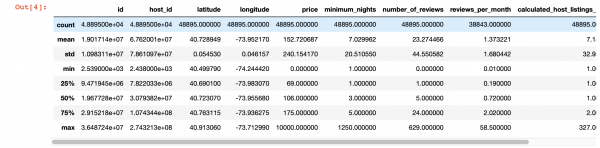
Magisk visualisering
Lad os se på, hvor værdierne helt mangler:
import seaborn as sns
sns.heatmap(df.isnull(), yticklabels=False, cbar=False, cmap='viridis') 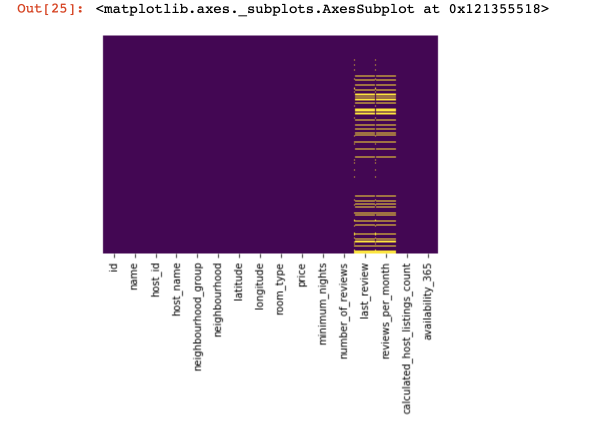
Dette var et lille overblik; nu skal vi til de mere interessante emner.
Lad os forsøge at finde og om muligt fjerne kolonner, der kun indeholder én værdi i alle rækker (de vil ikke påvirke resultatet):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] # Vi genindskriver datasættet og beholder kun de kolonner, hvor der er mere end én unik værdi.
Nu beskytter vi os selv og vores projekts succes mod duplikerede rækker (rækker der indeholder den samme information i samme rækkefølge som en allerede eksisterende række):
df.drop_duplicates(inplace=True) # Gør dette, hvis vi mener, det er nødvendigt.
                                 # I nogle projekter bør sådanne data ikke fjernes fra starten.
Vi opdeler datasættet i to: en med kvalitative værdier og en anden med kvantitative.
Her skal vi lave en lille præcisering: hvis rækkerne med manglende data i kvalitative og kvantitative værdier ikke korrelerer nævneværdigt, skal der træffes en beslutning om, hvad vi ofrer — alle rækker med manglende data, kun en del af dem eller bestemte kolonner. Hvis rækkerne derimod korrelerer, har vi fuld ret til at opdele datasættet i to. Ellers skal vi først tage os af rækkerne, hvor de manglende data i kvalitative og kvantitative ikke korrelerer, og derefter opdele datasættet.
df_numerical = df.select_dtypes(include=[np.number])
df_categorical = df.select_dtypes(exclude=[np.number])
Vi gør dette for at gøre det lettere at behandle disse to forskellige typer data — senere vil vi forstå, hvor meget dette forenkler vores liv.
Vi arbejder med kvantitative data.
Det første, vi bør gøre, er at afgøre, om der er "spionkolonner" i de kvantitative data. Vi kalder disse kolonner sådan, fordi de giver sig ud for at være kvantitative data, men faktisk fungerer som kvalitative.
Hvordan identificerer vi dem? Selvfølgelig afhænger det af arten af de data, du analyserer, men generelt kan sådanne kolonner have få unikke værdier (omkring 3-10 unikke værdier).
print(df_numerical.nunique())Når vi har identificeret spionkolonnerne, vil vi flytte dem fra kvantitative data til kvalitative:
spy_columns = df_numerical[['kolonne1', 'kolonne2', 'kolonne3']]#udskiller spy-kolonner og gemmer dem i et separat dataframe
df_numerical.drop(labels=['kolonne1', 'kolonne2', 'kolonne3'], axis=1, inplace = True)#fjerner disse kolonner fra de numeriske data
df_categorical.insert(1, 'kolonne1', spy_columns['kolonne1']) #tilføjer den første spy-kolonne til de kvalitative data
df_categorical.insert(1, 'kolonne2', spy_columns['kolonne2']) #tilføjer den anden spy-kolonne til de kvalitative data
df_categorical.insert(1, 'kolonne3', spy_columns['kolonne3']) #tilføjer den tredje spy-kolonne til de kvalitative data
Endelig har vi fuldstændig adskilt de kvantitative data fra de kvalitative, og nu kan vi arbejde grundigt med dem. Først skal vi forstå, hvor vi har tomme værdier (NaN, og i nogle tilfælde vil 0 også blive betragtet som tomme værdier).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
På dette stadium er det vigtigt at forstå, i hvilke kolonner nuller kan betyde manglende værdier: Er det relateret til, hvordan dataene blev indsamlet? Eller kan det være relateret til dataværdierne? Disse spørgsmål skal besvares i hvert enkelt tilfælde.
Så hvis vi alligevel beslutter, at data kan mangle, hvor der er nuller, skal vi erstatte nullerne med NaN, så det bliver lettere at arbejde med de mistede data senere:
df_numerical[["kolonne 1", "kolonne 2"]] = df_numerical[["kolonne 1", "kolonne 2"]].replace(0, nan)Lad os nu se, hvor vi har manglende data:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Du kan også bruge df_numerical.info() 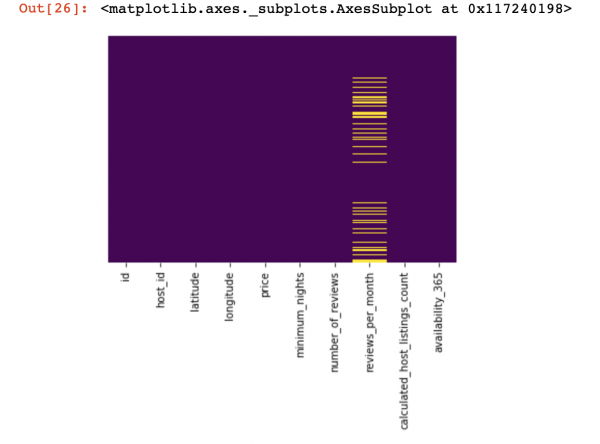
Her skal de manglende værdier inden for kolonnerne markeres med gul farve. Og det mest interessante begynder nu — hvordan skal vi håndtere disse værdier? Skal vi fjerne rækkerne med disse værdier eller kolonnerne? Eller skal vi udfylde disse tomme værdier med noget andet?
Her er et omtrentlig skema, der kan hjælpe dig med at afgøre, hvad der grundlæggende kan gøres med de tomme værdier:
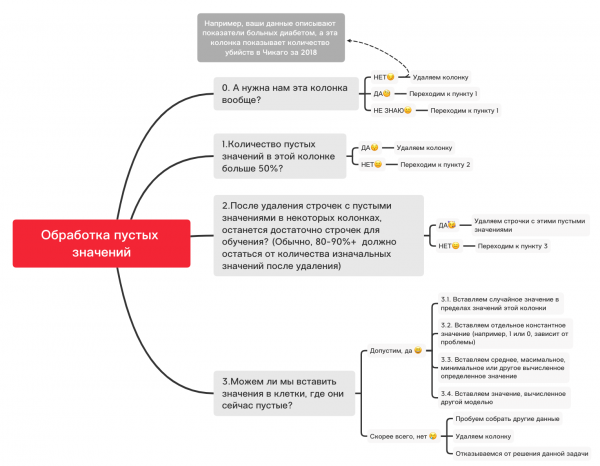
0. Fjern unødvendige kolonner
df_numerical.drop(labels=["kolonne1","kolonne2"], axis=1, inplace=True)1. Er antallet af tomme værdier i denne kolonne større end 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["kolonne1","kolonne2"], axis=1, inplace=True)#Fjerner, hvis en kolonne har mere end 50 tomme værdier2. Fjern rækker med tomme værdier
df_numerical.dropna(inplace=True)#Fjerner rækker med tomme værdier, hvis der derefter er nok data til træning3.1. Indsætter en tilfældig værdi
import random #importerer random
df_numerical["kolonne"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolonne"]), inplace=True) #indsætter tilfældige værdier i tomme celler i tabellen
3.2. Indsætter en konstant værdi
from sklearn.impute import SimpleImputer #importerer SimpleImputer, som hjælper med at indsætte værdier
imputer = SimpleImputer(strategy='constant', fill_value="") #indsætter en bestemt værdi ved hjælp af SimpleImputer
df_numerical[["ny_kolonne1",'ny_kolonne2','ny_kolonne3']] = imputer.fit_transform(df_numerical[['kolonne1', 'kolonne2', 'kolonne3']]) #Anvender dette på vores tabel
df_numerical.drop(labels = ["kolonne1","kolonne2","kolonne3"], axis = 1, inplace = True) #Fjerner kolonner med gamle værdier
3.3. Indsætter gennemsnittet eller den mest hyppige værdi
from sklearn.impute import SimpleImputer #importerer SimpleImputer, som hjælper med at indsætte værdier
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #i stedet for mean kan man også bruge most_frequent
df_numerical[["ny_kolonne1",'ny_kolonne2','ny_kolonne3']] = imputer.fit_transform(df_numerical[['kolonne1', 'kolonne2', 'kolonne3']]) #Anvender dette på vores tabel
df_numerical.drop(labels = ["kolonne1","kolonne2","kolonne3"], axis = 1, inplace = True) #Fjerner kolonner med gamle værdier
3.4. Indsætter et værdi beregnet af en anden model
Nogle gange kan værdier beregnes ved hjælp af regressionsmodeller, ved at bruge modeller fra sklearn biblioteket eller andre lignende biblioteker. Vores team vil dedikere en separat artikel til, hvordan dette kan gøres i den nærmeste fremtid.
Så, indtil videre vil fortællingen om kvantitative data blive afbrudt, fordi der er mange andre nuancer omkring, hvordan man bedst håndterer dataforberedelse og forbehandling til forskellige opgaver, og de grundlæggende aspekter for kvantitative data er blevet dækket i denne artikel, og nu er det tid til at vende tilbage til kvalitative data, som vi adskilt for nogle trin siden fra kvantitative. Du kan ændre denne notebook som du vil, og tilpasse den til forskellige opgaver, så dataforbehandling kan ske meget hurtigt!
Kvalitative data
Primært anvendes metoden One-hot-encoding til kvalitetsdata for at formatere dem fra string (eller objekt) til tal. Før vi går videre til dette punkt, lad os bruge diagrammet og koden ovenfor for at forstå, hvordan vi kommer i gang med manglende værdier.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 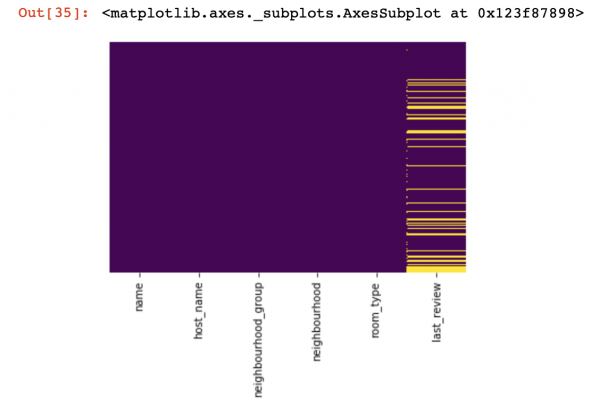
0. Fjern unødvendige kolonner
df_categorical.drop(labels=["kolonne1", "kolonne2"], axis=1, inplace=True)1. Er antallet af tomme værdier i denne kolonne større end 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["kolonne1", "kolonne2"], axis=1, inplace=True) #Fjerner, hvis en kolonne
#har mere end 50% manglende værdier2. Fjern rækker med tomme værdier
df_categorical.dropna(inplace=True) #Fjerner rækker med manglende værdier,
                                   #hvis der derefter er tilstrækkeligt med data til træning
3.1. Indsætter en tilfældig værdi
import random
df_categorical["kolonne"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolonne"]), inplace=True)
3.2. Indsætter en konstant værdi
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["ny_kolonne1", 'ny_kolonne2', 'ny_kolonne3']] = imputer.fit_transform(df_categorical[['kolonne1', 'kolonne2', 'kolonne3']])
df_categorical.drop(labels=["kolonne1", "kolonne2", "kolonne3"], axis=1, inplace=True)
Så, vi har endelig forstået de manglende værdier i kvalitetsdataene. Nu er det tid til at udføre one-hot-encoding for de værdier, der findes i din database. Denne metode anvendes ofte for at din algoritme kan træne med henblik på kvalitetsdata.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["kolonne1", "kolonne2", "kolonne3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Så, vi er endelig færdige med at behandle kvalitets- og kvantitative data hver for sig — tid til at kombinere dem igen.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Efter at vi har samlet datasættene i ét, kan vi til sidst bruge data transformation med MinMaxScaler fra sklearn-biblioteket. Dette vil gøre vores værdier inden for intervallet 0 til 1, hvilket vil hjælpe med træningen af modellen i fremtiden.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Disse data er nu klar til alt — til neurale netværk, standard ML-algoritmer osv!
I denne artikel har vi ikke behandlet arbejdet med data, der vedrører tidsserier, da sådanne data kræver lidt forskellige teknikker til behandling afhængigt af din opgave. I fremtiden vil vores team dedikere en separat artikel til dette emne, og vi håber, at den vil bringe noget interessant, nyt og nyttigt ind i dit liv, ligesom denne.
Kilde: habr.com
