

Hej! Jeg hedder Vadim Madison, og jeg leder udviklingen af System Platform hos Avito. Der har været sagt meget om, hvordan vores virksomhed overgår fra monolitisk til mikrotjenestearkitektur. Det er på tide at dele, hvordan vi har transformeret vores infrastruktur for at maksimere fordelene ved mikrotjenesterne og undgå at miste os selv i dem. Hvordan PaaS hjælper os her, hvordan vi har forenklet deployment og reduceret oprettelsen af mikrotjenester til et enkelt klik — læs videre. Ikke alt, hvad jeg skriver nedenfor, er implementeret fuldt ud i Avito; dele af det er, hvordan vi udvikler vores platform.
(Og i slutningen af denne artikel vil jeg fortælle om muligheden for at deltage i et tre-dages seminar med mikrotjenestearkitektur-ekspert Chris Richardson).
Hvordan vi kom til mikrotjenester
Avito er en af de største klassificerede annoncer i verden, med mere end 15 millioner nye annoncer dagligt. Vores backend håndterer over 20.000 anmodninger i sekundet. Nu har vi flere hundrede mikrotjenester.
Vi har arbejdet på mikrotjenestearkitekturen i flere år. Hvordan præcist — vores kolleger detaljerer det i vores sektion ved RIT++ 2017. På CodeFest 2017 (se. ), forklarede Sergey Orlov og Mikhail Prokoptchuk detaljeret, hvorfor vi overhovedet havde brug for at skifte til mikrotjenester, og hvilken rolle Kubernetes spillede for os. Nu gør vi alt, hvad vi kan, for at minimere de skalaforhold, der er typiske for en sådan arkitektur.
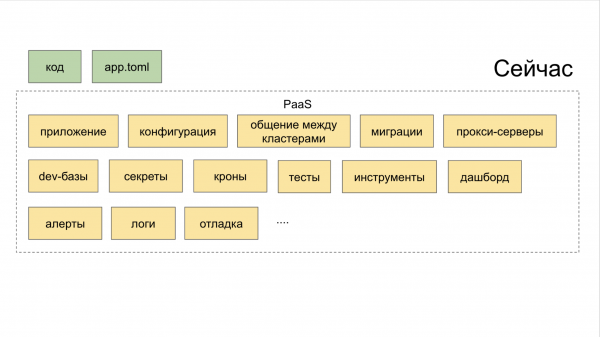
Oprindeligt skabte vi ikke et økosystem, der omfattende støttede os i udviklingen og lanceringen af mikrotjenester. Vi samlede blot smarte open source-løsninger, lancerede dem internt, og bad udviklerne om at finde ud af det. Resultatet var, at de måtte søge information i mange steder (dashboards, interne tjenester), hvorefter de blev bekræftet i ønsket om at udvikle kode på den gamle måde, i monolitten. Det, udvikleren gør med hænderne, er markeret med grøn farve på diagrammerne nedenfor, mens automatiseringen er markeret med gul.
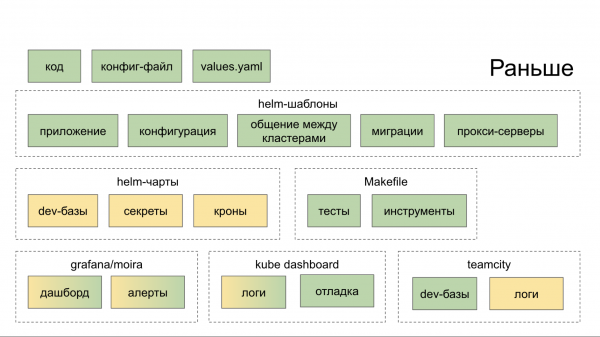
Nu oprettes en ny tjeneste i PaaS CLI-værktøj med en enkelt kommando, og med to yderligere tilføjes en ny database og deployeres til Stage.
Hvordan man overvinder æraen med 'mikrotjenesteopdeling'
I monolitiske arkitektur var udviklerne nødt til at forstå, hvad der skete hos naboerne for at sikre konsistensen af ændringer i produktet. Med den nye arkitektur er servicekonteksterne ikke længere afhængige af hinanden.
Derudover kræver det mange processer for at gøre mikroservicesarkitekturen effektiv, herunder:
• logføring;
• forespørgselstracering (Jaeger);
• fejlaggregation (Sentry);
• statusser, meddelelser, begivenheder fra Kubernetes (Event Stream Processing);
• race limit / circuit breaker (man kan bruge Hystrix);
• kontrol af serviceafhængigheder (vi bruger Netramesh);
• overvågning (Grafana);
• bygning (TeamCity);
• kommunikation og notifikation (Slack, email);
• opgavetracking; (Jira)
• udarbejdelse af dokumentation.
For at systemet ikke skal miste integritet og forblive effektivt i takt med skaleringen, har vi genovervejet organiseringen af mikroservices i Avito.
Hvordan vi håndterer mikroservices
At føre en ensartet 'partipolitik' blandt mange mikroservices i Avito hjælper med:
- opdeling af infrastrukturen i lag;
- konceptet Platform as a Service (PaaS);
- overvågning af alt, hvad der sker med mikroservices.
Niveauerne af infrastrukturens abstraktion omfatter tre lag. Lad os gå fra det øverste til det nederste.
A. Øverste — service mesh. I begyndelsen prøvede vi Istio, men det viste sig at bruge for mange ressourcer, hvilket bliver for dyrt med vores volumener. Derfor udviklede den senioringeniør i arkitekturteamet, Alexander Lukyanchensko, en egen løsning — (tilgængelig i Open Source), som vi nu bruger i produktion og som forbruger mange færre ressourcer end Istio (men den gør ikke alt, hvad Istio kan prale af).
B. Mellem — Kubernetes. Vi implementerer og driver mikroservices på den.
C. Nederste — bare metal. Vi bruger ikke cloud-løsninger og ting som OpenStack, men kører helt på bare metal.
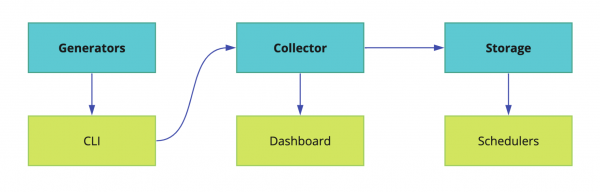
Alle lag integreres i PaaS. Og denne platform består i sin tur af tre dele.
I. Generatorer, styret via en CLI-værktøj. Det hjælper udvikleren med at oprette en mikroservice korrekt og med minimum af indsats.
II. Samlet indsamler med kontrol over alle værktøjer gennem et samlet dashboard.
III. Lager. Den integreres med planlæggere, der automatisk opsætter triggere for betydningsfulde handlinger. Takket være dette system går ingen opgave tabt, blot fordi nogen glemte at oprette en opgave i Jira. Til dette bruger vi et internt værktøj kaldet Atlas.
Implementeringen af mikrotjenester på Avito styres også efter et ensartet skema, hvilket forenkler kontrollen med dem på hver fase af udviklingen og udgivelsen.
Hvordan en standard pipeline til udvikling af mikrotjenester fungerer
Generelt set ser kæden til oprettelse af en mikrotjeneste således ud:
CLI-push → Kontinuerlig integration → Bagning → Udrulning → Kunstige tests → Canary-tests → Squeeze Testing → Produktion → Vedligeholdelse.
Lad os gennemgå den lige i denne rækkefølge.
CLI-push
• Oprettelse af mikrotjeneste.
Vi har længe kæmpet for at lære hver udvikler at lave mikrotjenester. Vi skrev også detaljerede instruktioner i Confluence. Men skemaerne ændrede sig og blev udvidet. Resultatet — det blev en flaskehals i begyndelsen: lanceringen af mikrotjenester tog alt for lang tid, og der opstod ofte problemer under deres oprettelse.
Til sidst konstruerede vi et simpelt CLI-værktøj, der automatiserer de grundlæggende skridt ved oprettelsen af en mikrotjeneste. Faktisk erstatter det første git push. Her er præcist, hvad det gør.
— Opretter en tjeneste efter skabelon — trin for trin, i 'wizard'-tilstand. Vi har skabeloner til de primære programmeringssprog på backend i Avito: PHP, Golang og Python.
— Med én kommando opsætter det et miljø til lokal udvikling på en specifik maskine — Minikube startes, Helm-diagrammer genereres og køres automatiskt i den lokale kubernetes.
— Tilslutter den nødvendige database. Udvikleren behøver ikke at kende IP, brugernavn og adgangskode for at få adgang til den ønskede database — hverken lokalt, i staging eller i produktionen. Desuden opsættes databasen straks i en fejltolerant konfiguration med belastningsbalancering.
— udfører selv live-samling. Antag, at udvikleren har ændret noget i mikrotjenesten gennem sin IDE. Værktøjet ser ændringer i filsystmet og genopbygger applikationen (for Golang) og genstarter den. For PHP sender vi blot mappen ind i kassen, og der opnås 'live-reload' automatisk.
— Genererer autotests. I skabelonform, men helt brugbare.
• Udrulning af mikrotjeneste.
Det var tidligere lidt besværligt at udrulle mikrotjenester. Det krævede altid:
I. Dockerfile.
II. Konfiguration.
III. Helm-chart, som i sig selv er omfattende og inkluderer:
— selve chartene;
— skabeloner;
— specifikke værdier taget i betragtning af forskellige miljøer.
Vi har elimineret besværet ved at ændre Kubernetes-manifest, og nu genereres de automatisk. Men vigtigst af alt, vi har forenklet udrulningen til det maksimale. Fremover har vi kun Dockerfile, og hele konfigurationen angives af udvikleren i en enkelt kort fil app.toml.
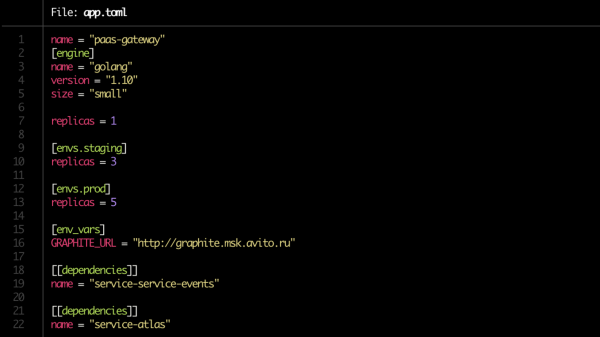
Og i selve app.toml er det nu hurtigt gjort. Vi angiver, hvor mange kopier af tjenesten der skal køre (på dev-serveren, på staging, på produktion) og specificerer dens afhængigheder. Vær opmærksom på linjen size = "small" i blokken [engine]. Dette er begrænsningen, som vil blive tildelt tjenesten gennem Kubernetes.
Dernæst genereres alle nødvendige Helm-charts automatisk baseret på konfigurationen, og forbindelser til databaser oprettes.
• Grundlæggende validering. Sådanne kontroller er også automatiseret.
Det skal overvåges:
— om der er en Dockerfile;
— om der er en app.toml;
— om der er dokumentation;
— om afhængighederne er i orden;
— om alarmreglerne er defineret.
Om det sidste punkt: Tjenesteowner angiver selv, hvilke produktmetrikker der skal overvåges.
• Forberedelse af dokumentation.
Fortsat et problemområde. Synes at være det mest oplagte, men samtidig det mest "ofte glemte", og dermed et sårbart led i kæden.
Det er nødvendigt, at dokumentationen findes for hver mikrotjeneste. Den omfatter følgende sektioner.
I. Kort beskrivelse af tjenesten. Bogstaveligt talt et par sætninger om, hvad den gør og hvorfor den er nødvendig.
II. Link til arkitekturdiagrammet. Det er vigtigt, at man ved første øjekast kan forstå, for eksempel, om I bruger Redis til caching eller som det primære datalager i vedholdende tilstand. Hos Avito er dette indtil videre et link til Confluence.
III. Runbook. Kort guide til opstart af tjenesten og fin-tuning af dens brug.
IV. FAQ, hvor det ville være godt at forudse problemer, som dine kolleger kan støde på, når de arbejder med tjenesten.
V. Beskrivelse af endpoints for API. Hvis du ikke angiver destinationssteder, vil det næsten helt sikkert være dine kolleger, hvis mikrotjenester er forbundet med din, der skal betale for det. I øjeblikket bruger vi Swagger og vores løsning kaldet brief til dette.
VI. Etiketter. Eller markører, der viser, hvilket produkt, hvilken funktionalitet eller hvilket forretningsområde tjenesten tilhører. De hjælper hurtigt med at forstå, om du for eksempel ikke arbejder på en funktionalitet, som dine kolleger for en uge siden har lanceret til den samme forretningsenhed.
VII. Ejeren eller ejerne af tjenesten. I de fleste tilfælde kan deres ejer(e) automatiseres med PaaS, men for sikkerheds skyld kræver vi, at udvikleren angiver dem manuelt.
Endelig er det en god praksis at gennemgå dokumentationen, på samme måde som ved kodegennemgang.
Continous Integration
- Forberedelse af repositories.
- Oprettelse af pipeline i TeamCity.
- Tildeling af rettigheder.
- Søgning efter ejere af tjenesten. Her er det en hybridmodel — manuel mærkning og minimal automatik fra PaaS. En fuldstændig automatisk model fejler ved overdragelse af tjenester til support i et andet udviklingsteam eller, for eksempel, hvis udvikleren af tjenesten har forladt virksomheden.
- Registrering af tjenesten i Atlas (se ovenfor). Med alle dens ejere og afhængigheder.
- Kontrol af migrationer. Vi tjekker, om der er nogen potentielt farlige. For eksempel, hvis en af dem indeholder alter table eller noget andet, der kan bryde dataskemaets kompatibilitet mellem forskellige versioner af tjenesten. Så udføres migrationen ikke, men sættes i abonnement — PaaS skal informere ejeren af tjenesten, når det er sikkert at anvende den.
Bake
Næste fase — pakning af tjenester før deployment.
- Bygning af applikationen. I klassisk stil — i en Docker-billede.
- Generering af Helm-diagrammer for tjenesten og tilknyttede ressourcer. Inklusive for databaser og cache. De oprettes automatisk i henhold til den konfiguration, der blev dannet under CLI-push i app.toml.
- Oprettelse af billetter til administratorer for åbning af porte (når det er nødvendigt).
- Kørsel af unit tests og beregning af code coverageHvis dækningen af koden ligger under det angivne tærskel, vil tjenesten sandsynligvis ikke bestå deployet. Hvis den er på grænsen til acceptabel, vil tjenesten få en "pessimiserende" koefficient: så vil udvikleren modtage en meddelelse om, at der ikke er nogen fremskridt vedrørende testene (og at der bør gøres noget ved det).
- Hensyntagen til begrænsninger for hukommelse og CPUVi skriver primært mikrotjenester i Golang og kører dem i Kubernetes. Her er en nuance, der er relateret til egenskaben ved Golang-sproget: som standard anvendes alle kerner på maskinen ved opstart, medmindre variablen GOMAXPROCS er angivet eksplicit, og når der kører flere sådanne tjenester på én maskine, begynder de at konkurrere om ressourcer og forstyrrer hinanden. I graferne nedenfor er det vist, hvordan køretiden ændrer sig, hvis applikationen kører uden konkurrence og i ressourcekapløb. (Kildedata for graferne findes ).
Køretid, jo mindre jo bedre. Maksimum: 643ms, minimum: 42ms. Billedet er klikbart.
Tid pr. operation, jo mindre jo bedre. Maksimum: 14091 ns, minimum: 151 ns. Billedet er klikbart.
I præparationsfasen af byggeriet kan denne variabel angives eksplicit eller man kan bruge biblioteket fra drengene hos Uber.
Deploy
• Kontrol af konventioner. Før man begynder at levere servicebuilds til de planlagte miljøer, skal følgende kontrolleres:
— API-endpoints.
— Overensstemmelse af svarene fra API-endpoints med skemaet.
— Logformat.
— Indstilling af overskrifter ved forespørgsler til tjenesten (det gør netramesh i øjeblikket)
— Indstilling af ejerens mærke ved afsendelse af meddelelser til busserne (event bus). Dette er nødvendigt for at spore sammenhængen mellem tjenesterne via busserne. I busserne kan man sende både idempotente data, som ikke øger sammenhængen mellem tjenesterne (hvilket er godt), og forretningsdata, der styrker sammenhængen mellem tjenesterne (hvilket er meget dårligt!). Og i det øjeblik, denne sammenhæng bliver et problem, hjælper forståelsen af, hvem der skriver til og læser fra busserne, en korrekt opdeling af tjenesterne.
Der er ikke mange konventioner i Avito endnu, men puljen af dem bliver større. Jo flere sådanne aftaler der findes i en forståelig og bekvem form for teamet, desto lettere er det at opretholde konsistensen mellem mikrotjenesterne.
Syntetiske tests
• Testning i en lukket kontur. Til dette bruger vi nu open source . Først registrerer den den faktiske belastning på tjenesten, dernæst emulerer den den inden for en lukket kreds.
• Belastningstest. Vi stræber efter at optimere præstationen for alle tjenester. Og alle versioner af hver tjeneste skal gennemgå belastningstest — på den måde kan vi forstå den nuværende præstation af tjenesten og forskellen fra tidligere versioner af den samme tjeneste. Hvis præstationen falder med halvanden gang efter en opdatering, er det et klart signal til ejernes: Det er tid til at grave sig ind i koden og rette op på situationen.
Vi baserer os på de indsamlede data for eksempel til korrekt at implementere auto scaling og i sidste ende forstå, hvor godt tjenesten kan skaleres.
Ved belastningstest kontrollerer vi, om ressourceforbruget overholder de angivne grænser. Vi fokuserer især på ekstremværdi.
a) Vi ser på den samlede belastning.
— For lav — der virker sandsynligvis noget ikke overhovedet, hvis belastningen pludselig falder med flere gange.
— For høj — kræver optimering.
b) Vi ser på skillelinjen for RPS.
Her ser vi både på forskellen mellem den nuværende version og den tidligere samt det samlede antal. For eksempel, hvis tjenesten leverer 100 rps — så er den enten dårligt skrevet, eller det er dens specifikation, men i begge tilfælde er det værd at se nærmere på tjenesten.
Hvis RPS derimod er for meget, kan der muligvis være en fejl, og en af endpoint'erne holder op med at udføre nyttelasten og blot aktiverer en eller anden form for return true;
Canary-tests
Efter syntetiske tests, tester vi mikrotjenestens funktion med et lille antal brugere. Vi starter forsigtigt med en beskeden andel af den antagne tjenestepublikum — mindre end 0,1%. På dette stadium er det meget vigtigt, at de rigtige tekniske og produktmetrikker er sat op i overvågningen, så de hurtigt kan vise et problem med tjenesten. Minimumstiden for canary-testen er 5 minutter, den primære er 2 timer. For komplekse tjenester sætter vi tiden manuelt.
Vi analyserer:
— metrics specifik for sprog, især php-fpm workere;
— fejl i Sentry;
— svarstatusser;
— svartider (response time), både præcise og gennemsnitlige;
— latency;
— undtagelser, håndterede og uhåndterede;
— produktmetrikker.
Squeeze Testing
Squeeze Testing kaldes også for udvindingstest. Metoden blev introduceret af Netflix. Ideen er, at vi først fylder en instans med real trafik indtil den når sit brudpunkt, hvilket definerer dens grænse. Vi tilføjer så en ny instans og belaster de to - igen til maksimum; vi ser deres loft og forskellen til den første „squeeze“. Og sådan fortsætter vi med at tilføje én instans ad gangen og beregner mønstre i ændringerne.
Data fra udvindingstestene samles også i en samlet database af målinger, hvor vi enten beriger resultaterne fra kunstig belastning med dem, eller helt erstatter dem med „syntetiske“ data.
Produktion
• Skalering. Når vi lancerer en tjeneste i produktion, overvåger vi, hvordan den skalerer. At monitorere kun CPU-metricer er ineffektivt efter vores erfaring. Auto-skalering med benchmarking af RPS fungerer i teorien, men kun for bestemte tjenester, såsom online streaming. Så vi fokuserer primært på applikationsspecifikke produktmetrikker.
Ved skalering analyserer vi i sidste ende:
— CPU- og RAM-metrier.
— Antallet af anmodninger i kø.
— Svar tid.
— Prognoser baseret på indsamlede historiske data.
Ved skalering af en tjeneste er det også vigtigt at overvåge dens afhængigheder for at undgå, at vi skalerer den første tjeneste i kæden, mens de tjenester, den bruger, bryder sammen under belastningen. For at fastlægge en acceptabel belastning for hele servicepuljen, ser vi på historiske data for den „nærmeste“ afhængige tjeneste (baseret på en kombination af CPU- og RAM-metricer, sammen med app-specifikke metricer) og sammenligner dem med historiske data fra den initierende tjeneste, og så videre gennem hele „afhængighedskæden“, oppefra og ned.
Vedligeholdelse
Når mikrotjenesten er i drift, kan vi implementere triggere.
Her er typiske situationer, hvor triggere aktiveres.
— Potentielt farlige migrationer er blevet opdaget.
— Sikkerhedsopdateringer er blevet udgivet.
— Tjenesten har ikke været opdateret i lang tid.
— Belastningen på tjenesten er markant faldet, eller nogen af dens produktmetrikker overskrider grænserne for det normale.
— Tjenesten lever op til de nye platformkrav.
En del af triggerne er ansvarlige for stabiliteten i arbejdet, mens en anden del fungerer som systemvedligeholdelse — for eksempel, hvis en service ikke er blevet deployeret i lang tid, og dens grundlæggende billede ikke længere klarer sikkerhedstesten.
Dashboard
Kort sagt er dashboardet kontrolpanelet for hele vores PaaS.
- En central informationskilde for tjenesten med data om dens testdækning, antal billeder, antal produktionskopier, versioner osv.
- Et værktøj til filtrering af data efter tjenester og labels (mærker, der angiver tilhørighed til forretningsenheder, produktfunktionalitet osv.)
- Et integrationsværktøj til infrastrukturværktøjer til tracing, logging og overvågning.
- Et centralt dokumentationspunkt for tjenester.
- Et centralt overblik over alle begivenheder relateret til tjenester.
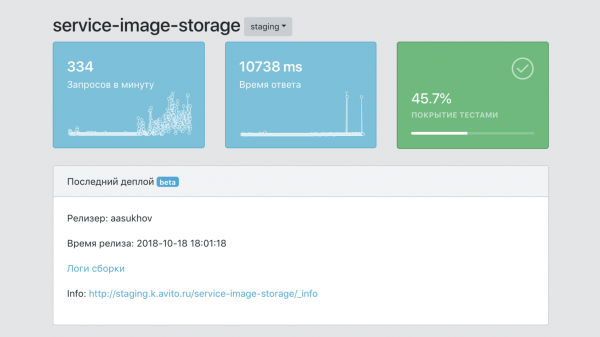
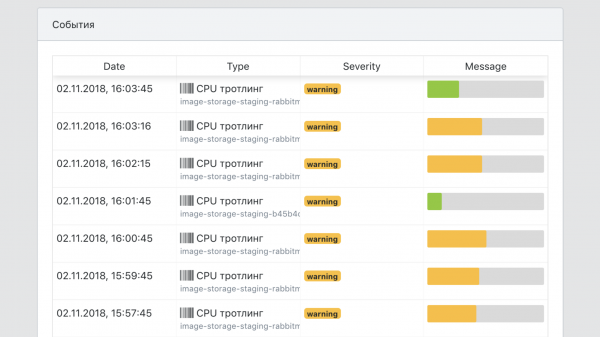
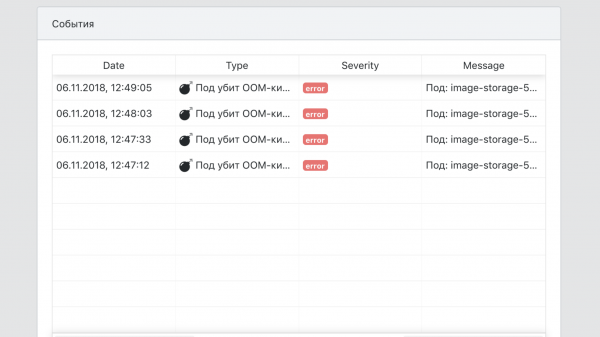
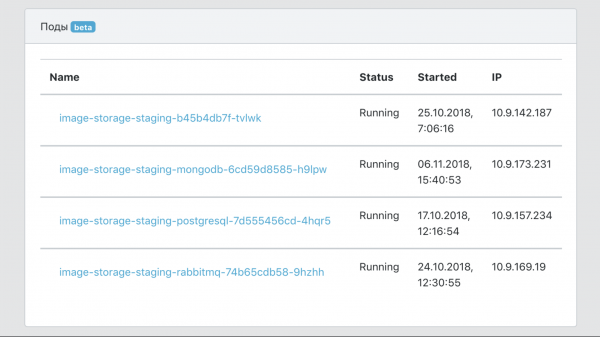
I alt
Før implementeringen af PaaS kunne en ny udvikler bruge flere uger på at sætte sig ind i alle værktøjerne, der var nødvendige for at lancere en mikrotjeneste i produktion: Kubernetes, Helm — vores interne særegenheder i TeamCity, opsætning af forbindelser til databaser og caches på en fejltolerant måde osv. Nu tager det kun et par timer — læse quickstart og lave selve tjenesten.
Jeg lavede en præsentation om dette emne til HighLoad++ 2018, som kan ses. og .
Bonusspor for dem, der læste til ende.
Vi hos Avito organiserer et internt tre-dages træningskursus for udviklere fra , en ekspert inden for mikrotjenestearkitektur. Vi ønsker at give en af læserne af dette indlæg mulighed for at deltage. Programmet for træningen er lagt online.
Træningen finder sted fra den 5. til den 7. august i Moskva. Dette er arbejdsdage, der vil være fuldt optaget. Frokost og undervisning vil være på vores kontor, mens den valgte deltager selv betaler for transport og indkvartering.
Du kan ansøge om deltagelse . Fra dig vil vi have et svar på spørgsmålet, hvorfor netop du skal deltage i træningen, samt oplysninger om, hvordan man kan kontakte dig. Svar venligst på engelsk, da Chris selv vil vælge den deltager, der kommer på træningen.
Vi vil annoncere navnet på deltageren til træningen som en opdatering til dette indlæg og på Avitos sociale medieplatforme for udviklere (AvitoTech på , , Twitter
Kilde: habr.com
