

Hej!
Mit navn er Mikhail, jeg er IT-chef i Sportmaster. Jeg vil dele en historie om, hvordan vi håndterede de udfordringer, der opstod under pandemien.
I de første dage af de nye realiteter stoppede det sædvanlige offline-salg i Sportmaster, og belastningen på vores online kanal, især når det kom til hjemmelevering, voksede ti gange. På få uger transformerede vi en kæmpe offline-forretning til online og tilpassede servicen til vores kunders behov.
Generelt set blev det, der i bund og grund var vores sekundære operation, nu hovedforretningen. Vigtigheden af hver online-bestilling steg ekstremt. Vi måtte holde fast i hver krone, som en kunde bragte ind i virksomheden.
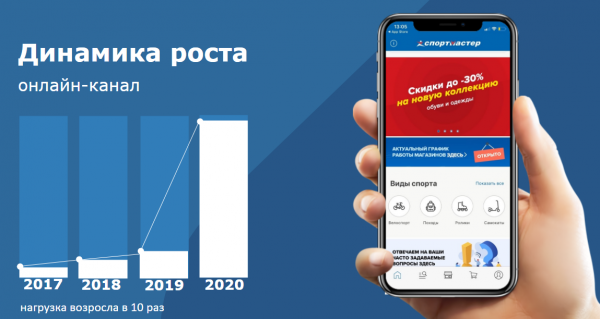
For hurtigt at kunne reagere på kundernes forespørgsler åbnede vi et ekstra kontaktcenter i virksomhedens hovedkontor, og nu kan vi modtage omkring 285.000 opkald om ugen. Samtidig har vi omstillet 270 butikker til en ny kontaktløs og sikker arbejdsmåde, hvilket gav kunderne mulighed for at modtage deres ordrer, og medarbejderne kunne beholde deres job.
Under transformationen stod vi over for to hovedproblemer. For det første var belastningen på vores online ressourcer steget mærkbart (hvordan vi tackling dette, vil Sergey fortælle). For det andet steg antallet af sjældne operationer (før covid) mange gange, hvilket krævede en stor mængde hurtig automatisering. For at løse dette problem måtte vi hurtigt omdirigere ressourcer fra de områder, der tidligere var vores hovedfokus. Hvordan vi klarede dette — vil Elena fortælle.
Drift af online tjenester
Sergey Kolesnikov, ansvarlig for driften af webshoppen og mikroservices
Fra det øjeblik, vores fysiske butikker begyndte at lukke for besøgende, begyndte vi at registrere en stigning i målinger som antal brugere, antal ordrer foretaget i vores app, antal forespørgsler til vores apps.
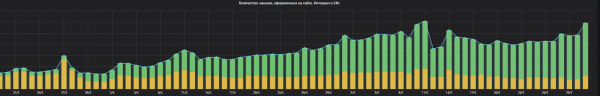 Antal ordrer fra 18. til 31. marts
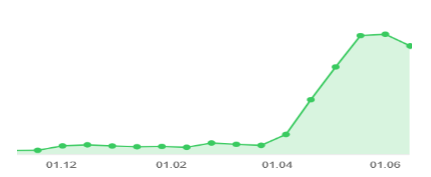 Antal forespørgsler til mikroservice for online betaling
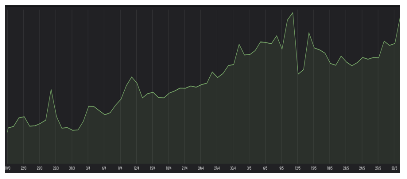 Antal ordrer placeret på hjemmesiden
I det første diagram ser vi, at stigningen var omkring 14 gange, i det andet 4 gange. Den mest indikative måling her anses for at være svartid på vores applikationer.
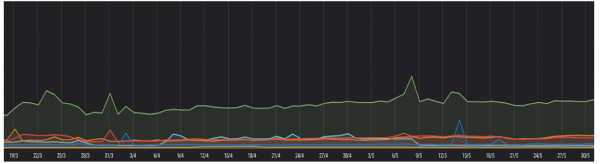
I denne graf ser vi responser fra frontend og applikationer, og for os har vi konstateret, at vi ikke har bemærket nogen vækst som sådan.
Først og fremmest skyldes det, at vi begyndte forberedende arbejde i slutningen af 2019. Nu er vores tjenester reserveret, der er sikret fejlfindingsrobusthed på niveau med fysiske servere, virtualiseringssystemer, dockere og tjenester i dem. Samtidig tillader kapaciteten af vores serverressourcer at udholde gentagne belastninger.
Det vigtigste værktøj, der hjalp os i hele denne proces, var vores overvågningssystem. For nylig havde vi dog ikke et samlet system, der tillod indsamling af metrikker på alle niveauer, fra det fysiske udstyr og hardware til forretningsmetrikker.
Formelt set havde vi overvågning i virksomheden, men det var typisk spredt og lå under ansvaret for specifikke afdelinger. Faktisk, når en hændelse skete, havde vi næsten aldrig en ensartet forståelse af, hvad der egentlig skete, der var ikke nogen information, og ofte førte det til en endeløs søgen efter at lokalisere problemet til senere løsning.
På et tidspunkt tænkte vi over det og besluttede, at vi ikke kunne holde ud længere — vi havde brug for et samlet system for at se hele billedet. De vigtigste teknologier, der indgår i vores stack, er Zabbix som alarmsystem og opslag af metrikker, Prometheus til indsamling og opbevaring af applikationsmetrikker, Stack ELK til logning og opbevaring af data fra hele overvågningssystemet samt Grafana til visualisering, Swagger, Docker og andre nyttige og velkendte værktøjer.
Samtidig bruger vi ikke kun de tilgængelige teknologier på markedet, men udvikler også nogle ting selv. For eksempel laver vi tjenester til integration af systemer med hinanden, det vil sige en form for API til indsamling af metrikker. Desuden arbejder vi på vores egne overvågningssystemer — på niveau med forretningsmetrikker bruger vi UI-tests. Derudover har vi en bot i Telegram til meddelelser til teamene.
Og vi forsøger også at gøre overvågningssystemet tilgængeligt for teamene, så de selv kan gemme deres metrikker og arbejde med dem, herunder indstille alarmer på nogle smalle metrikker, der ikke har den bredeste anvendelse.
I hele systemet stræber vi efter proaktivitet og hurtigst muligt at lokalisere hændelser. Derudover er antallet af vores mikrotjenester og systemer steget betydeligt på det seneste, og derfor vokser antallet af integrationer. I forbindelse med optimering af diagnoseprocessen for hændelser på integrationsniveau udvikler vi et system, der muliggør tværgående systemkontroller og præsenterer resultaterne, hvilket gør det muligt at finde de grundlæggende problemer relateret til importer og interaktion mellem systemerne.
Naturligvis er der stadig plads til vækst og udvikling i vores systemdrift, og vi arbejder aktivt på det. Du kan læse mere om vores overvågningssystem. .
Tekniske test
Sergey Orlov, leder af kompetencecenteret for web- og mobiludvikling
Siden nedlukningen af fysiske butikker har vi været nødt til at stå over for forskellige udfordringer i forhold til udvikling. Først og fremmest drejer det sig om en stigning i belastningen. Det er klart, at hvis der ikke træffes de nødvendige foranstaltninger, kan et højt belastningstryk på systemet føre til en trist forvandling til en græskarlygte, eller det kan helt miste sin ydeevne.
Det andet aspekt, som er lidt mindre indlysende, er, at systemet under høj belastning skal ændres meget hurtigt for at tilpasse sig ændringer i forretningsprocesserne. Nogle gange flere gange om dagen. Mange virksomheder har en regel om, at man ikke bør foretage ændringer i systemet under store marketingaktiviteter. Overhovedet ingen ændringer, lad det fungere, så længe det fungerer.
For os var der i realiteten en uendelig Black Friday, hvor systemet faktisk skulle ændres. Enhver fejl, problem eller systemfejl ville være meget kostbar for forretningen.
For at springe frem til slutningen kan jeg sige, at vi lykkedes med at klare disse udfordringer; alle systemer klarede belastningen, blev let skaleret, og vi havde ikke nogen større tekniske fejl.
Der er fire søjler, som systemets evne til at håndtere høje spidse belastninger hviler på. Den første er overvågning, som du læste om lidt tidligere. Uden et velfungerende overvågningssystem er det næsten umuligt at finde flaskehalse i systemet. Et godt overvågningssystem er som hjemmebeklædning, det skal være behageligt og tilpasset dig.
Den anden aspekt er testning. Vi tager dette meget alvorligt: vi skriver både klassiske unit tests, integrations- og belastningstest og mange andre for hvert system. Vi skriver også en teststrategi og stræber efter, at testniveauet er sådan, at manuelle kontroller ikke længere er nødvendige.
Den tredje søjle er CI/CD Pipeline. Bygge-, test- og implementeringsprocesserne for applikationen skal være så automatiserede som muligt, der bør ikke være nogen manuelle indgreb. Emnet CI/CD Pipeline er ret dybt, og jeg vil kun berøre det kort. Det er værd at nævne, at vi har en tjekliste for CI/CD Pipeline, som hver produktteam gennemgår med hjælp fra kompetencecentre.
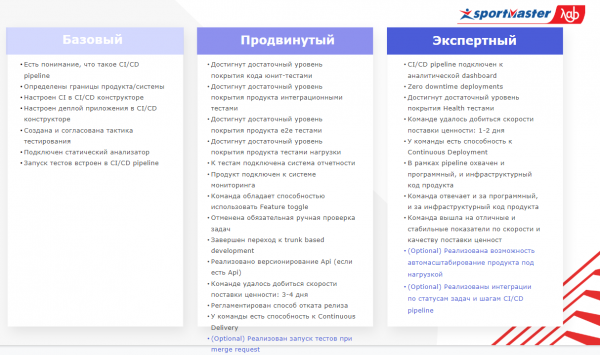 Og her er tjeklisten
På denne måde opnås mange mål. Dette inkluderer versionering af API, og feature toggles for at undgå release tog, samt at nå et niveau af testdækning, så testning bliver helt automatiseret, deployment er sømløse osv.
Den fjerde søjle er de arkitektoniske principper og tekniske løsninger. Man kan tale meget og længe om arkitektur, men jeg vil gerne fremhæve et par principper, som jeg ønsker at fokusere på.
For det første skal man vælge specialiserede værktøjer til specifikke opgaver. Ja, det lyder indlysende, og det er klart, at man skal bruge en hammer til at slå søm i, mens man bør bruge specielle skruetrækkere til at adskille armbåndsure. Men i vores tid stræber mange værktøjer efter at blive universelle for at dække et maksimal segment af brugere: databaser, caches, rammer og andet. For eksempel, hvis vi ser på databasen MongoDB, arbejder den med multi-dokumenttransaktioner, mens Oracle-databasen arbejder med JSON. Og det virker som om, at man kan bruge alting til alt. Men hvis vi ønsker at fokusere på ydeevne, skal vi vide, hvad hver enkelt værktøjs styrker og svagheder er og vælge de, der passer til vores opgavetype.
For det andet, når man designer systemer, skal hver stigning i kompleksitet være berettiget. Vi skal konstant have dette in mente; princippet om lav kobling er velkendt. Jeg mener, at det skal anvendes både på niveauet af den enkelte service, på niveauet for hele systemet og på niveauet af den arkitektoniske landskab. Evnen til horisontal skalering af hver enkelt komponent i systemet under belastning er også vigtig. Hvis man har denne evne, vil skalering ikke være nogen udfordring.
Når vi taler om tekniske løsninger, har vi bedt produktteams om at forberede et friskt sæt anbefalinger, ideer og løsninger, som de har implementeret i forbindelse med forberedelserne til den næste bølge af belastning.
Caches
Det er nødvendigt at nærme sig valget af lokale og distribuerede caches bevidst. Nogle gange giver det mening at bruge både og inden for det samme system. For eksempel har vi systemer, hvor en del af dataene i princippet fungerer som et vitrin-cache, hvilket vil sige, at kilden til opdateringerne ligger uden for selve systemet, og systemerne ændrer ikke disse data. Til sådanne tilgange bruger vi den lokale Caffeine Cache.
Og der er data, som systemet aktivt ændrer under drift, og her bruger vi allerede en distribueret cache med Hazelcast. Denne tilgang gør det muligt for os at udnytte fordelene ved en distribueret cache, hvor det virkelig er nødvendigt, og minimere serviceomkostningerne ved dataomgang i Hazelcast-klyngen der, hvor vi kan klare os uden det. Vi har skrevet meget om caches. og .
Desuden gav skiftet til Kryo-serialisering i Hazelcast os et flot løft. Overgangen fra ReplicatedMap til IMap + Near Cache i Hazelcast gjorde, at vi kunne minimere databevægelsen i klyngen.
Et lille råd: når du foretager masseinvalidation af cache, kan det være nyttigt at bruge taktikken med at opvarme en sekundær cache, hvorefter man skifter til den. Det kunne synes, at vi i denne tilgang ville få en dobbelt hukommelsesforbrug, men i praksis, i de systemer hvor dette er blevet praktiseret, har hukommelsesforbruget faktisk været lavere.
Reaktiv stak
Vi bruger den reaktive stak i et betydeligt antal systemer. I vores tilfælde er det Webflux eller Kotlin med coroutines. Den reaktive stak fungerer særligt godt der, hvor vi forventer langsomme input-output operationer. For eksempel kald til langsomme tjenester, arbejde med filsystemer eller lagringssystemer.
Den vigtigste regel er at undgå blokerende kald. Under hætten på de reaktive rammer kører der et begrænset antal aktive service-tråde. Hvis vi uforsigtigt tillader os at foretage et direkte blokerende kald, som for eksempel et JDBC-driver kald, vil systemet simpelthen stoppe.
Forsøg at konvertere fejl til egne runtime exceptions. Den reelle udførelsestråd i programmet bevæger sig til de reaktive rammer, og udførelsen af koden bliver ikke-lineær. Som følge heraf er det meget vanskeligt at diagnosticere problemer ud fra stack traces. Og løsningen her er at skabe klare og objektive runtime exceptions for hver fejl.
Elasticsearch
Når du bruger Elasticsearch, skal du undgå at vælge unødvendige data. Dette er i princippet et meget enkelt råd, men oftest bliver dette glemt. Hvis du skal vælge mere end 10.000 poster ad gangen, skal du bruge Scroll. Hvis vi laver en analogi, ligner det lidt en cursor i en relationel database.
Undgå at bruge postfilter uden nødvendighed. Ved store data i hovedudvalget kan denne operation kraftigt belaste databasen.
Brug bulk-operationer, hvor det er muligt.
API
Når du designer API'er, skal du tage hensyn til krav om at minimere de overførte data. Dette er især relevant i forbindelse med frontend: netop på dette grænseflade træder vi uden for vores datacentre og arbejder allerede på linjen, der forbinder os med kunden. Hvis der er mindste problemer dér, kan for høj trafik medføre negativ brugeroplevelse.
Og til sidst, undgå at præsentere alle data på én gang, men nærm dig kontrakten mellem forbrugere og leverandører klart.
Organisatorisk transformation
Eroshkina Elena, IT-chef
I det øjeblik, hvor nedlukningen skete, og behovet for hurtigt at øge udviklingen af online og implementere omnichannel-services opstod, var vi allerede i gang med vores organisatoriske transformation.
En del af vores struktur blev omstillet til at arbejde efter principperne og praksis for produktfokus. Der blev dannet teams, som nu har ansvaret for drift og udvikling af hvert produkt. Medarbejderne i disse teams er 100% engagerede og organiserer deres arbejde efter Scrum eller Kanban, afhængigt af hvad der er mest foretrukket, de indstiller implementeringspipeline, indfører tekniske praksisser, kvalitetspraksisser og meget mere.
Ved en lykkelig tilfældighed befandt størstedelen af disse produktteams sig i området for online og omnichannel-services. Dette gjorde det muligt for os at skifte til remote work i løbet af kort tid (altså bogstaveligt talt på to dage) uden at miste effektivitet. Den oprettede proces gjorde det muligt hurtigt at tilpasse sig de nye arbejdsforhold og opretholde et højt tempo for levering af ny funktionalitet.
Derudover havde vi brug for at styrke de teams, der arbejder i frontlinjen for online-forretningen. Det blev klart, at vi kun kunne gøre dette ved hjælp af interne ressourcer. Omtrent 50 personer ændrede på to uger det område, de tidligere havde arbejdet i, og integrerede sig i arbejdet med et nyt produkt.
Dette krævede ikke særlige ledelsesmæssige bestræbelser, da vi samtidig med at organisere vores egen proces, med teknisk forbedring af produktet, med kvalitetssikring, lærer vores teams selvorganisering — at styre deres egen produktionsproces uden at inddrage administrative ressourcer.
Vi har kunnet fokusere vores ledelsesressourcer netop der, hvor det var nødvendigt på det tidspunkt — på koordineringen sammen med forretningen: Hvad er vigtigt for vores kunde lige nu, hvilken funktionalitet skal implementeres først, hvad skal der gøres for at øge vores kapacitet til levering og behandling af ordrer. Alt dette og en klar rollemodel har gjort det muligt for os at belaste vores produktionsstrømme med de værdiskabende elementer, der virkelig er vigtige og nødvendige.
Det er tydeligt, at når man arbejder remote og tempoet for ændringer er højt, og hver enkelts deltagelse afhænger af forretningsmålinger, kan man ikke blot stole på interne fornemmelser som "Går det ikke? Det ser ud til at være okay." Objektive målinger af produktionsprocessen er nødvendige. Vi har sådanne målinger, som er tilgængelige for alle, der er interesseret i metrikker fra produktteams. Først og fremmest for teamet selv, forretningen, interessenterne og ledelsen.
Hver anden uge afholdes der et statusmøde med hvert team, hvor der i løbet af 10 minutter analyseres målinger, der identificeres flaskehalse i produktionsprocessen, og der findes fælles løsninger: hvad kan der gøres for at fjerne disse flaskehalse. Her kan man også straks anmode om hjælp fra ledelsen, hvis et identificeret problem er uden for teamenes indflydelse, eller fra kolleger med ekspertise, som muligvis allerede har stået over for et lignende problem.
Ikke desto mindre forstår vi, at for at opnå en dramatisk acceleration (og netop et sådant mål har vi sat os) er der stadig meget, vi skal lære og implementere i vores daglige arbejde. Lige nu fortsætter vi med at skalere produktmetoden til andre teams og nye produkter. For dette har vi været nødt til at mestre et nyt format for online-skole for metodologer.
Metodologer, mennesker der hjælper teams med at opbygge processer, etablere kommunikation og forbedre arbejdseffektiviteten, fungerer i realiteten som forandringsagenter. Lige nu arbejder kandidaterne fra vores første hold med teams og hjælper dem med at blive succesfulde.
Jeg tror, at den aktuelle situation åbner op for muligheder og perspektiver, som vi måske endnu ikke helt har fået øje på. Men den erfaring og praksis, vi får lige nu, bekræfter, at vi har valgt den rette udviklingsvej, og vi vil ikke miste disse nye muligheder i fremtiden, ligesom vi vil kunne reagere effektivt på de udfordringer, der vil opstå for "Sportmaster".
Konklusioner
I denne svære tid har vi formuleret de vigtigste principper, som udviklingen af software bygger på, og som jeg tror, vil være relevante for enhver virksomhed, der arbejder med det.
Mennesker. Det er fundamentet. Medarbejdere skal nyde deres arbejde, forstå virksomhedens mål og målene for de produkter, de arbejder med. Og selvfølgelig skal de kunne udvikle sig professionelt.
Technology. Det er nødvendigt, at virksomheden udvikler en moden tilgang til arbejdet med sin teknologiske stak og opbygger kompetencer, hvor det virkelig er nødvendigt. Det lyder meget simpelt og åbenlyst. Og det bliver ofte ignorert.
Processer. Det er vigtigt at opbygge arbejdsstrukturen for produktteams og kompetencecentre korrekt samt etablere et samarbejde med forretningen, så man kan arbejde med dem som partnere.
Generelt har vi klaret os nogenlunde på denne måde. Hovedtesen for nutiden er blevet bekræftet endnu en gang med et klart slag i panden.
Selv hvis du er en stor offline-forretning med mange butikker i mange byer, så skal du udvikle din online tilstedeværelse. Det er ikke bare en ekstra salgskanal eller en flot app, hvor man også kan købe noget (og især fordi konkurrenterne også har en flot app). Det er ikke en nødløsning til, hvis situationen bliver svær.
Det er en absolut nødvendighed. Både din tekniske kapacitet og infrastruktur samt mennesker og processer skal være klar til det. For det er muligt at købe ekstra RAM, plads eller oprette nye instanser inden for et par timer. Men mennesker og processer skal forberedes på dette på forhånd.
Kilde: habr.com
