

Semantic Web og Linked Data minder om nærfeltet: der er ikke liv der. For at rejse derhen i en mere eller mindre længere periode... ja, jeg ved ikke, hvad de sagde til dig som barn, når du svarede "jeg vil være astronaut". Men man kan observere, hvad der sker, selv mens man er på Jorden; det er meget lettere at blive amatørastronom eller endda professionel.
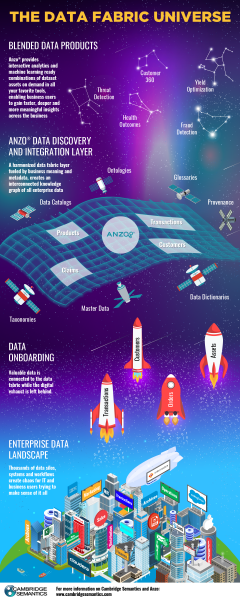
Artiklen vil handle om friske, ikke ældre end et par måneder, tendenser fra verden af RDF-lagre. Metaforen i det første afsnit blev inspireret af en episk størrelse reklamebillede under brødteksten.
Episk billede
I. GraphQL til adgang til RDF
, at GraphQL hævder at være et universelt sprog til adgang til databaser. Hvordan ser det ud med muligheden for adgang ved hjælp af GraphQL til RDF?
"Out of the box" giver følgende mulighed:
- Stardog (, );
- TopQuadrant-produkter (, ).
Hvis lageret ikke tilbyder denne mulighed, implementeres den selv ved at skrive en passende "resolver". Dette skete for eksempel i det franske projekt . Eller man kan allerede nu sige, at man ikke behøver at skrive noget, men blot tage .
Fra synspunktet af den ortodokse tilhænger af Semantic Web og Linked Data er alt dette selvfølgelig sørgeligt, da det virker beregnet til integrationer bygget op omkring endnu en data silo, og ikke til de platforme (naturligvis RDF-lagre).
Indtryk af sammenligning mellem GraphQL og SPARQL forbliver delte.
- På den ene side ser GraphQL ud som en fjern slægtning til SPARQL: det løser de typiske problemer ved REST med overudtagning og multiplicitet af forespørgsler - uden dette, ville man nok ikke kunne kalde det forespørgsels sprog, selvom det kun er for web.
- På den anden side er det skuffende, at GraphQL er så strengt skematisk. Dens "introspektivitet" virker derfor meget begrænset sammenlignet med den fulde refleksivitet af RDF. Og der er ingen ækvivalent til property paths, så det er endda lidt uklart, hvorfor det kaldes "Graph-".
II. Adaptører til MongoDB
Trend, der supplerer den forrige.
- I Stardog kan man nu — specifikt, alt på det samme GraphQL — indstille visningen af MongoDB-data til virtuelle RDF-grafer;
- GraphDB har for nylig begyndt at indsætte fragmenter af MongoDB-forespørgsler i SPARQL.
Hvis man ser bredere på adaptere til JSON-kilder, der mere eller mindre 'on the fly' kan repræsentere det gemte JSON i disse kilder som RDF, kan man også huske på en ret gammel , som kan tilpasses, , til Apache Jena.
Sammenfattende kan man sige om de første to tendenser, at RDF-lagre viser en fuld beredskab for integrationer og funktion i en situation med "polyglot persistence". Det er kendt, at dette seneste ikke længere er på mode, og at Hvordan ser det ud med multimodularitet i verden af RDF-lagre?
Kort sagt: Det gør det ikke. Emnet om multimodale DBMS fortjener en egen artikel, men for nu kan man bemærke, at der i øjeblikket ikke findes multimodale DBMS, "baseret" på grafmodellen (en af arterne af den kan betragtes som RDF). Omdrejningspunktet for en smule multimodularitet — støtte til RDF-lagre for alternativ grafmodel LPG — vil blive beskrevet i .
III. OLTP vs. OLAP
Men Gartner selv , at multimodularitet er en betingelse sine qua non primært for driftsmæssige DBMS. Dette giver mening: i situationen med "polyglot persistence" opstår de vigtigste problemer med transaktionsbehandling.
Men hvor ligger RDF-lagre på OLTP—OLAP-skalaen? Jeg ville svare på denne måde: ingen af delene. For at betegne hvad de er beregnet til, er der behov for en eller anden tredje forkortelse. Som mulighed ville jeg foreslå OLIP — Online Intellektuel Behandling.
Men alligevel:
- De mekanismer, der er implementeret i GraphDB for integration med MongoDB, er ikke mindst til at omgå problemer med skrivepræstation;
- Stardog går endnu længere og motoren, igen med det formål at øge skrivepræstationen.
Og nu tillad mig at præsentere en ny spiller på markedet. Fra skaberne af IBM Netezza og Amazon Redshift — . Billedet fra produktannoncen baseret på den blev præsenteret i begyndelsen af artiklen. AnzoGraph positionerer sig selv som en GOLAP-løsning. Hvad med SPARQL med vinduesfunktioner? —
SELECT ?month (COUNT(?event) OVER (PARTITION BY ?month) AS ?events) WHERE { … }IV. RocksDB
Der blev allerede til anmeldelsen af Stardog 7 Beta, hvor det blev sagt, at Stardog planlægger at bruge RocksDB som nedre lagringssystem — et "nøgle-værdi" lager, Facebooks fork af Googles LevelDB. Hvorfor er det allerede værd at tale om en tendens?
For det første, ifølge , "transplanteres" ikke kun RDF-lagre til RocksDB. Der er projekter, som bruger RocksDB som lagringsmotor i ArangoDB, MongoDB, MySQL og MariaDB, Cassandra.
For det andet, projekter (dvs. ikke produkter) af den relevante type udføres på RocksDB.
For eksempel bruger eBay RocksDB i til sin 'vidensgraf'. For resten er det sjovt at læse: query-sproget begyndte som et hjemmelavet format, men er på det seneste gået hen imod at ligne SPARQL meget mere.. Som i en anekdote: hvor mange knowledge graphs vi end laver, så ender det altid med RDF.
Et andet eksempel — den for et par måneder siden lancerede . Før dens lancering måtte man henvende sig til gennem det standard Mediawiki API for at få historiske oplysninger om Wikidata. Nu er meget muligt via ren SPARQL. Under motorhjelmen bruger de også RocksDB. For øvrigt ser det ud til, at en person, der har arbejdet med importen af Freebase til Google Knowledge Graph, lavede WDHQS.
V. Understøttelse af LPG
Jeg vil minde om den grundlæggende forskel mellem LPG-grafer og RDF-grafer.
I LPG kan skalære egenskaber hænges på eksempler af kanter, mens de i RDF kun kan hænges på 'typer' af kanter (men ikke kun skalære egenskaber, men også almindelige relationer). Denne begrænsning af RDF i forhold til LPG ved forskellige modelleringsmetoder. Begrundelsen bag LPG i forhold til RDF er sværere at overvinde, men LPG-grafer er mere lig billederne i Yuval Harari's lærebog, hvilket er grunden til, at folk ønsker dem.
Åbenlyst opdeles opgaven 'at støtte LPG' i to dele:
- ændringer i RDF-modellen, der gør det muligt at imitere LPG-strukturer i den;
- ændringer i forespørgselssproget for RDF, der gør det muligt at få adgang til dataene i denne ændrede model — eller implementering af muligheden for at stille forespørgsler til denne model på populære forespørgselssprog for LPG.
V.1. Datamodel
Her er der flere mulige tilgange.
V.1.1. Singleton Property
Den mest bogstavelige tilgang til at harmonisere RDF og LPG er måske :
- I stedet for for eksempel predikatet
:isMarriedTobenyttes predikaterne:isMarriedTo1,:isMarriedTo2.osv. - Derefter bliver disse predikater emner for nye tripletter:
:isMarriedTo1 :since "2013-09-13"^^xsd:date.og andre. - Relationen mellem disse predikat-eksempler og det fælles predikat etableres af tripletter af typen
:isMarriedTo1 rdf:singletonPropertyOf :isMarriedTo.. - Det er åbenlyst, at
rdf:singletonPropertyOf rdfs:subPropertyOf rdf:type,men tænk over, hvorfor det ikke giver mening bare at skrive:isMarriedTo1 rdf:type :isMarriedTo..
Opnåelsen af 'understøttelse af LPG' løses her på RDFS-niveauet. Denne løsning kræver ændringer i det relevante . Nogle ændringer kan være nødvendige fra RDF-lagre, der understøtter tilslutning af konsekvenser, mens Singleton Property midlertidigt kan betragtes som endnu en modeleringsteknik.
V.1.2. Reifikation gjort rigtigt
Mindre naive tilgange stammer fra en forståelse af, at instanser af egenskaber kan instansieres af tripletter. Når vi har mulighed for at sige noget om tripletter, vil vi også få mulighed for at tale om instanser af egenskaber.
Den mest solide af disse tilgange er , også kendt som RDR, i kernen af Blazegraph. Den ble valgt fra starten AnzoGraph. Troværdigheden af tilgangen bestemmes af, at de relevante ændringer i RDF Semantics <> :since "2013-09-13"^^xsd:date .
V.1.3. Andre tilgangeMan kan undgå at bekymre sig om formel semantik og blot betragte tripletter som om de har nogle identifikatorer, som naturligvis er URI'er, og skabe nye tripletter med disse URI'er. Det vil kun være nødvendigt at give adgang til disse URI'er i SPARQL. Så
gør I Allegrograph
en mellemløsning. Det er kendt, at identifikatorer til tripletter i Allegrograph , men når man implementerer triple attributes, er de ikke synlige udadtil. Men der er stadig lang vej til formel semantik. Det er bemærkelsesværdigt, at attributterne for tripletter ikke er URI'er, og værdierne af disse attributter kan kun være litteraler. Tilhængere af LPG får præcist det, de ønskede. I et særligt opfundet format NQX ser et eksempel, der svarer til det ovennævnte for RDF*, således ud: :bob :marriedTo :alice {"since" : "2013-09-13"}
V.2. SpørgesprogNår LPG er blevet understøttet på en eller anden måde på modelniveau, er det nødvendigt at give mulighed for at lave forespørgsler til data i en sådan model.
Blazegraph understøtter forespørgsler til RDF* med
- SPARQL* og SELECT * { <> :since ?since }
AnzoGraph understøtter også- og planlægger at støtte Cypher Stardog understøtter sit eget
- SPARQL og igen SELECT * { BIND (stardog:identifier(:bob, :isMarriedTo, ?wife) AS ?id) ?id :since ?since }
Allegrograph understøtter også sit eget- SPARQL: SELECT * { ("since" ?since) franz:attributesNameValue ( :bob :marriedTo ?wife ) }
For resten, GraphDB understøttede engang Tinkerpop/Gremlin, uden at understøtte LPG, men dette stoppede i version 8.0 eller 8.1.For resten, GraphDB understøttede engang Tinkerpop/Gremlin uden at understøtte LPG, men i version 8.0 eller 8.1 stoppede dette.
VI. Strammere licenser
Der har ikke været nogen tilføjelser i krydsningen mellem "triplestore of choice" og "open source triplestore" på det seneste. Nye RDF-lagringssystemer med åbne kilder er langt fra at være et godt valg til daglig brug, og kildekoden til nye RDF-lagre, som man gerne vil benytte (som AnzoGraph), er lukket. Man kan snarere tale om nedskæringer…
Selvfølgelig lukkes ikke tidligere åbne kilder, men nogle lagre med åbne kilder bliver gradvist mindre betragtelige som valg. Virtuoso, der har en opensource-udgave, synker efter min mening i fejl. Blazegraph er blevet købt af AWS og ligger til grund for Amazon Neptune; nu er det uklart, om der nogensinde vil komme en anden version. Der er kun Jena…
Hvis åbne kilder ikke er så vigtige, og man bare vil prøve, så ser det heller ikke så lyst ud som før. For eksempel:
- Stardog udbyder en gratis version (men prøvetiden er dog blevet fordoblet);
- i , hvor det tidligere var muligt at vælge en gratis basisplan, er registreringen af nye brugere suspenderet.
Generelt bliver rummet for den almindelige IT-bruger stadig mere og mere utilgængeligt, og udforskningen af det bliver virksomheders privilegium.
Kilde: habr.com
