

Definitionen af DevOps er meget komplekse, så man bør starte diskussionen om det fra bunden hver gang. Bare på Habr er der tusindvis af publikationer om emnet. Men hvis du læser dette, ved du sikkert, hvad DevOps er. For jeg gør ikke. Hej, jeg hedder Alexander Titov (@), og vi skal bare tale om DevOps, og jeg vil dele mine erfaringer.
Jeg har tænkt meget over, hvordan jeg kan gøre min fortælling nyttig, så der vil være mange spørgsmål her - dem, jeg stiller mig selv, og dem, jeg stiller vores kunders virksomhed. Ved at besvare disse spørgsmål bliver forståelsen bedre. Jeg vil fortælle, hvorfor DevOps er nødvendigt fra mit synspunkt, hvad det er, igen fra min position, og hvordan man kan forstå, at man bevæger sig mod DevOps, også fra min synsvinkel. Det sidste punkt vil komme gennem spørgsmål. Ved at besvare dem for dig selv, kan du forstå, om din virksomhed bevæger sig mod DevOps, eller om der er problemer.
En tid arbejdede jeg på bølgerne af fusioner og opkøb. Først arbejdede jeg i den lille startup Qik, som blev købt af det lidt større firma Skype, som derefter blev opkøbt af det endnu større firma Microsoft. På det tidspunkt fik jeg et indblik i, hvordan opfattelsen af DevOps forvandler sig i forskellige virksomhedsstørrelser. Derefter blev jeg interesseret i at se på DevOps fra et markedsmæssigt synspunkt, og vi organiserede sammen med kolleger virksomheden Ekspress 42. I seks år har vi navigeret igennem markedsbølgerne.
Udover det er jeg en af arrangørerne af DevOps Moscow-fællesskabet og arrangør af DevOps Days 2017, men jeg organiserede ikke 2018. Ekspress 42 arbejder med mange virksomheder. Vi udvikler DevOps der, ser på, hvordan det sker, drager konklusioner, analyserer og fortæller vores konklusioner til alle, underviser folk i DevOps-praksis. Generelt fremmer vi erfaring og ekspertise i denne henseende.
Hvorfor DevOps
Det første spørgsmål, som alle altid stiller - hvorfor? Mange mener, at DevOps blot er automatisering eller noget lignende, der allerede har været i hver virksomhed.
- Vi havde Continuous Integration - det betyder, at der allerede var DevOps, og hvorfor er alt det her nødvendigt? De derude underholder sig selv, mens de forstyrrer os i vores arbejde!
Efter 9 års udvikling af fællesskabet og metodologien er det allerede blevet klart, at det ikke kun er marketingglitter, men det er stadig ikke helt klart, hvad formålet egentlig er. Ligesom med ethvert værktøj og proces har DevOps specifikke mål, som det i sidste ende opnår.
Alt dette hænger sammen med, at verden forandrer sig. Den bevæger sig væk fra en enterprise-tilgang, hvor virksomheder stræber direkte efter drømmen, som vores storslåede klassiker fra Sankt Petersborg synger, fra punkt A til punkt B efter en bestemt strategi, med en struktur der er bygget til dette.
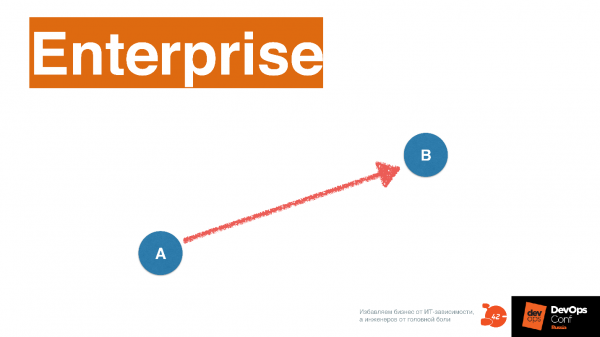
I princippet skal alting inden for IT bygges op omkring denne tilgang. Her bruges IT udelukkende til at automatisere processer.
Automatisering ændrer sig sjældent, fordi når en virksomhed kører på skinnerne - hvad skal der ændres? Det virker - rør ikke ved det. Nu ændrer tilgange i verden sig, og den, der kaldes Agile, siger, at den endelige punkt B ikke kan ses med det samme.
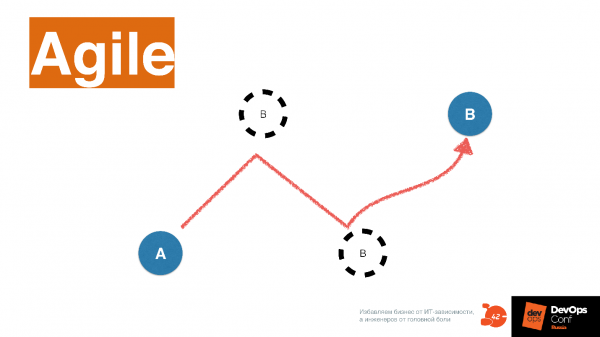
Når en virksomhed bevæger sig på markedet og arbejder med kunderne - undersøger den konstant markedet og justerer sit slutpunkt B. Jo oftere virksomheden ændrer sin retning, jo mere succesfuld bliver den til sidst, fordi den vælger flere markedsseneste.
Strategien demonstreres af en interessant virksomhed, som jeg for nylig blev opmærksom på. One Box Shave - en service til levering af barberblade og tilbehør via abonnement i en boks. De kan tilpasse deres 'boks' til forskellige kunder. Dette håndteres af bestemt software, der derefter sender ordren til en koreansk fabrik, der producerer varerne.
Dette produkt blev købt af Unilever for 1 milliard dollars. Nu konkurrerer det med Gillette og har taget en betydelig del af markedet i USA. One Box Shave siger:
— 4 blade? Er du seriøs? Hvad skal du bruge det til - det forbedrer overhovedet ikke kvaliteten af barberingen. En specielt udvalgt creme, duft og en kvalitetsbarbermaskine med to blade løser langt flere problemer end disse dumme 4 blade fra Gillette! Så snart når vi op på 10?
Sådan ændrer verden sig. Unilever hævder, at de har et fantastisk IT-system, der gør det muligt. Resultatet ser ud som konceptet Time-to-market, som mange allerede har talt om.
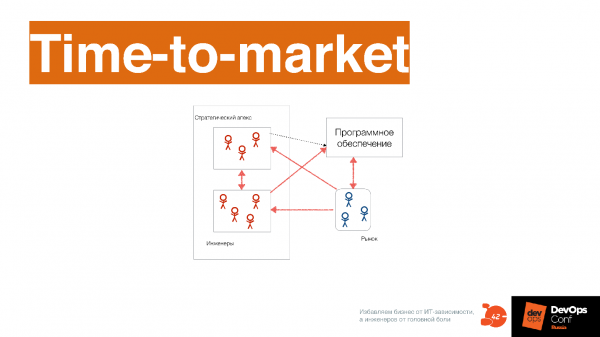
Betydningen af Time-to-market handler ikke om, hvor ofte vi deployer. Man kan ofte deploye, men hvis release-cykluserne er lange, kan det give indtryk af, at virksomheden deployer hver uge, hvis man forskyder de tre måneders release-cykluser uge for uge. Tidsrummet fra idé til endelig implementering varer dog stadig 3 måneder.
Time-to-market handler om at minimere tiden fra idé til endelig implementering.
I dette tilfælde interagerer softwaren med markedet. Ligesom med One Box Shave, hvor kunden interagerer med hjemmesiden. De har ikke sælgere – der er kun hjemmesiden, hvor besøgende klikker og efterlader deres ønsker. Derfor skal der hele tiden være nye opdateringer på hjemmesiden, så den lever op til kundernes ønsker. For eksempel, i Sydkorea barberer man sig ikke på samme måde som i Rusland, og de foretrækker ikke duften af fyrretræ, men derimod for eksempel gulerod og vanilje.
Da der er behov for hurtigt at ændre indholdet på hjemmesiden, ændres softwareudviklingen betydeligt. Gennem softwaren skal vi forstå, hvad kunden ønsker. Tidligere fik vi denne information gennem omveje, for eksempel via forretningsledelse. Derefter designede vi, indarbejdede kravene i IT-systemet, og alt virkede fint. Nu er det anderledes – softwaren designes af alle, der er involveret i processen, herunder ingeniører, fordi de gennem tekniske specifikationer lærer, hvordan markedet fungerer, og også deler deres indsigter med forretningen.
For eksempel i firmaet Qik, fandt vi pludselig ud af, at folk virkelig gerne ville uploade kontaktlister til serveren, og de udviklede en applikation til os. Oprindeligt havde vi faktisk ikke tænkt på det. I en klassisk virksomhed ville man have besluttet, at det var en fejl, da det ikke var angivet i specifikationen, at det skulle fungere godt, og at det overhovedet var blevet implementeret i fuld hast. Man ville have deaktiveret funktionen og sagt: 'Det er ikke nødvendigt, det vigtigste er, at den primære funktionalitet fungerer.' Men en teknologisk virksomhed ser det som en mulighed og begynder at ændre softwaren i overensstemmelse hermed.
I 1968 formulerede den kloge fyr Melvin Conway følgende idé.
En organisation, der skaber et system, er begrænset af designet, som afspejler kommunikationsstrukturen i denne organisation.
For more details, to produce different types of systems, you also need to have a different type of communication structure within the company. If you have a top-down hierarchical communication structure, it will not allow you to create systems that can provide a very high Time-to-market.
Læs you can . It is important for understanding the culture or philosophy of DevOps, as the only thing that fundamentally changes in DevOps is precisely the communication structure between teams..
From a process perspective, before DevOps, all stages: analytics, development, testing, operation, were linear.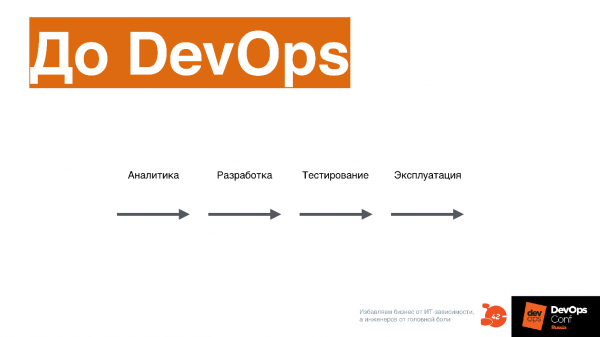
In the case of DevOps, all these processes happen simultaneously.
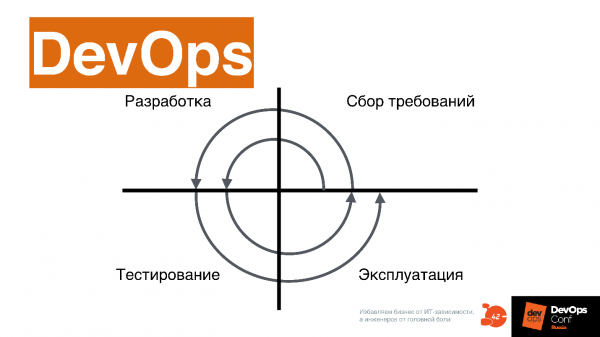
Time-to-market can only be achieved this way. For people who worked in the old process, this looks somewhat science-fiction, and not great at all.
So why is DevOps necessary?
For the development of digital products. If your company does not have a digital product, DevOps is not necessary—this is very important.
DevOps overcomes the speed limitations of the sequential software production model. All processes occur simultaneously in it.
Complexity increases. When DevOps evangelists say that it will make it easier for you to release software—it’s nonsense.
With DevOps, everything will only become more complicated.
At the conference at the Avito booth, one could see what it means to deploy a Docker container—it’s an unreal task. The complexity becomes overwhelming; you have to juggle many balls simultaneously.
DevOps completely changes the process and the organization within the company — or rather, it is not DevOps that changes, but the digital product. To adopt DevOps, you still need to completely change this process.
Questions for the specialist
And what about you? Questions you can ask yourself while working in the company and developing as a specialist.
Do you have a strategy for creating a digital product? If yes—great. This means your company is moving towards DevOps.
Is your company already creating a digital product? This means you can take it to the next level, dealing with more interesting matters—from a DevOps perspective again. I am speaking only from this perspective.
Is your company one of the market leaders in the niche with a digital product? Spotify, Yandex, Uber - virksomheder, der er på toppen af den teknologiske udvikling lige nu.
Stil dig selv disse spørgsmål, og hvis alle svarene er negative, så er det måske bedst, at du ikke beskæftiger dig med DevOps i denne virksomhed. Men hvis emnet DevOps virkelig interesserer dig, kan det være, at... du bør overveje at skifte til en anden virksomhed? Hvis din virksomhed ønsker at bevæge sig ind i DevOps, men du har svaret 'Nej' på alle spørgsmålene, minder det om denne dejlige næsehorn, der aldrig vil ændre sig.
Organisation
Som jeg allerede har nævnt, ændrer organisationen i virksomheden sig ifølge Conway's lov. Jeg vil starte med, hvad der forhindrer DevOps i at trænge ind i virksomheden set fra et organisatorisk perspektiv.
Problemet med 'silocentrering'
Det engelske ord 'Silo' er her oversat til russisk som 'колодец'. Problemet består i, at der ikke er nogen informationsudveksling mellem teamene.Hver team graver dybere i deres ekspertise, uden at der dannes et fælles kort, som man kan navigere efter.
Det minder om en person, der lige er ankommet til Moskva og endnu ikke kan navigere efter metrokortet. Moskvanere kender som regel deres område temmelig godt, men navigerer i hele Moskva efter metrokortet. Når du ankommer til Moskva for første gang, har du ikke denne færdighed, og du vil bare være desorienteret.
DevOps foreslår at overvinde dette øjeblik af desorientering og sammen bygge et fælles interaktionskort for alle afdelinger.
To faktorer hindrer dette.
Følge af virksomhedens ledelsessystem. Det er bygget op af separate hierarkiske 'silot'. For eksempel er der bestemte KPI'er i virksomheder, der understøtter dette system. På den anden side er der menneskets tanker, som har svært ved at komme ud over deres ekspertise og orientere sig i hele systemet. Det er simpelthen ubehageligt. Forestil dig, at du er i Bangkok Lufthavn - det er hurtigt svært at finde rundt. Det er også svært at navigere i DevOps, og derfor siger folk, at de skal finde en guide for at komme dertil.
Men det vigtigste er, at problemet med 'silocentrering' for en ingeniør, der har fået ånden fra DevOps, har læst Fowler og en hel del andre bøger, er, at 'silot' forhindrer en i at gøre 'åbenlyse' ting.Vi samles ofte efter DevOps Moscow, taler med hinanden, og folk klager:
— Vi ville bare starte CI, men det viste sig, at ledelsen ikke havde brug for det.
Dette sker netop fordi CI og Continuous Delivery process ligger på grænsen af mange ekspertiser. Bare ved ikke at overvinde problemet med „brønde” på organisatorisk niveau, kan man ikke komme videre, uanset hvad man gør, og hvor trist det end måtte være.
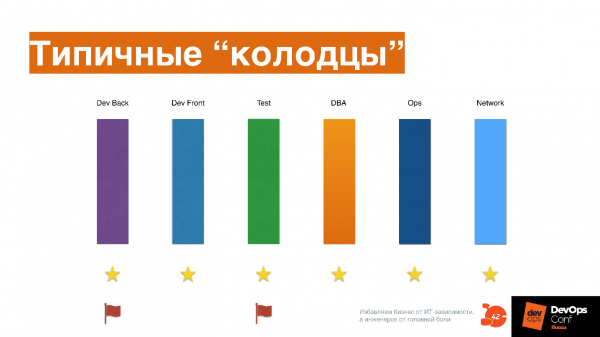
Hver deltager i processen i virksomheden: backend- og frontend-udviklere, testere, DBA'er, drift, netværk, graver i deres egen retning, og ingen har kortlægningen, undtagen lederen, der på en eller anden måde overvåger dem og styrer med metoden „del og hersk”.
Folk kæmper for nogle stjerner eller flag, hver graver i sin egen ekspertise.
Resultatet er, at når opgaven opstår for at samle det hele og bygge en fælles pipeline, og man ikke længere behøver at kæmpe for stjerner og flag, opstår spørgsmålet – hvad skal man så overhovedet gøre? Man skal finde en måde at blive enige på, men hvordan gør man det? Ingen har lært os det i skolen. Vi er lærte fra skolen: ottende klasse – wow! – i sammenligning med syvende klasse! Det er det samme her.
Er det også sådan i din virksomhed?
For at tjekke dette kan man stille sig selv følgende spørgsmål.
Bruger holdene fælles værktøjer, bidrager de til ændringer af disse fælles værktøjer?
Hvor ofte omarrangeres holdene – skifter nogle specialister fra ét hold til et andet? I DevOps-miljøet bliver det normalt, fordi nogle gange kan en person simpelthen ikke forstå, hvad en anden ekspertise laver. Han skifter til en anden afdeling, arbejder der i et par uger for at skabe et kort over orientering og interaktion med den afdeling.
Kan man oprette et udvalg for ændringer og ændre noget? Eller kræver det en stærk hånd fra den øverste ledelse og en ordre? For nylig skrev jeg på Facebook, hvordan en lidt kendt bank implementerer værktøjer gennem ordrer: de skrev en ordre, implementerer i et år, og ser, hvad der sker. Det er selvfølgelig langt og trist.
Hvor vigtigt er det for ledere at få personlige præstationer uafhængigt af virksomhedens præstationer?
Hvis du besvarer disse spørgsmål for dig selv, vil det blive mere klart, om du har et sådant problem i virksomheden.
Infrastruktur som kode
Når dette problem er løst, er den første vigtige praksis, som det er svært at komme videre i DevOps uden, dette infrastruktur som kode.
Ofte opfattes infrastruktur som kode således:
— Lad os automatisere alt med bash, smøre os ind i scripts, så administratorerne har mindre manuelt arbejde!
Men det er ikke sådan.
Infrastruktur som kode indebærer, at du beskriver IT-systemet, som du arbejder med, i form af kode for konstant at forstå dens tilstand.
Sammen med andre teams laver du et kort i form af kode, som alle kan forstå, som man kan navigere efter. Uanset om det er lavet med Chef, Ansible, Salt, eller der anvendes YAML-filer i Kubernetes, gør det ingen forskel.
På konferencen fortalte en kollega fra 2GIS, hvordan de lavede deres interne løsning til Kubernetes, der beskriver strukturen af enkelte systemer. For at beskrive 500 systemer havde de brug for et separat værktøj, der genererede denne beskrivelse. Når der er denne beskrivelse, kan enhver tjekke med hinanden, overvåge ændringer, hvordan man skal ændre og forbedre den, hvad der mangler.
I må indrømme, at separate bash-scripts normalt ikke giver denne forståelse. I et af de virksomheder, hvor jeg arbejdede, var der endda en betegnelse "write only"-script — når scriptet er skrevet, er det ikke muligt at læse det. Jeg tror, det er noget, I også kender til.
Infrastruktur som kode er kode, der beskriver den aktuelle tilstand af infrastrukturen. Denne kode arbejdes der sammen på af mange produkt-, infrastruktur- og serviceteams, og vigtigst af alt, alle skal forstå, hvordan denne kode overhovedet fungerer.
Koden understøttes i henhold til bedste praksisser for arbejde med kode: samarbejde om udvikling, code review, XP-programmering, testning, pull requests, CI for infrastrukturer af kode - alt dette er værdifuldt og kan bruges.
Koden bliver et fælles sprog for alle ingeniører.
Ændring af infrastrukturen i koden tager ikke meget tid. Ja, der kan også være teknisk gæld i infrastrukturskoden. Normalt står teams over for den efter et og et halvt år efter, at de begyndte at implementere "infrastruktur som kode" i form af en bunke scripts eller endda Ansible, som de skriver som spaghetti-kode og endnu tilføjer bash-scripts til bålet!
Det er vigtigt: hvis I ikke har prøvet denne skrammel endnu, så husk, at Ansible er ikke bash! Læs dokumentationen omhyggeligt, og sæt dig ind i, hvad der overhovedet står om dette.
Infrastruktur som kode – det handler om at opdele infrastrukturkoden i separate lag.
Vi i vores virksomhed skelner mellem 3 grundlæggende lag, som er meget forståelige og enkle, men der kan være flere. Du kan tage et kig på din infrastrukturkode og spørge, om dette kriterium er opfyldt. Hvis der ikke skelnes mellem lagene, bør du finde tid til at refaktorisere lidt.
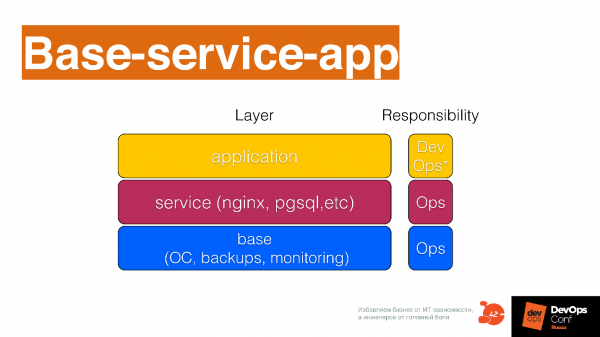
Grundlag – det handler om, hvordan OS, backups og andre lavniveau ting konfigureres, for eksempel, hvordan Kubernetes implementeres på et grundlæggende niveau.
Service niveau – det er de tjenester, du tilbyder udvikleren: logføring som en tjeneste, overvågning som en tjeneste, database som en tjeneste, load balancer som en tjeneste, kø som en tjeneste, Continuous Delivery som en tjeneste – en masse tjenester, som de enkelte teams kan levere til udviklingen. Alt dette skal beskrives i separate moduler i dit konfigurationsstyringssystem.
Lag, hvor applikationer oprettes og hvor det beskrives, hvordan de vil blive implementeret ovenpå de to tidligere lag.
Kontrolspørgsmål
Har din virksomhed en fælles infrastrukturelle repository? Overvåger du den tekniske gæld i infrastrukturen? Bruger du udviklingspraksis i det infrastrukturelle repository? Er din infrastruktur opdelte i lag? Du kan krydsreferere med diagrammet Base-service-APP. Hvor svært er det at foretage en ændring?
Hvis du har oplevet, at ændringer tog halvanden dag, betyder det, at du har opbygget teknisk gæld, og det skal arbejdes med. Du har netop stødt på problemer med teknisk gæld i infrastrukturkoden. Jeg husker mange sådanne historier, hvor man skulle skrive halvdelen af infrastrukturkoden om for at ændre noget CCTL, fordi kreativitet og ønsket om at automatisere alt har ført til, at alt er blevet for meget blandet sammen, alle håndtag er fjernet, og der skal refaktoreres.
Kontinuerlig levering
Lad os sammenligne debet med kredit. Først kommer en beskrivelse af infrastrukturen, som kan være ret grundlæggende. Det er ikke nødvendigt at beskrive alt i detaljer, men en grundlæggende beskrivelse er påkrævet, så I kan arbejde med det. Ellers er det uklart, hvordan man fortsætter med at gøre kontinuerlig levering. Alle disse praksisser udspiller sig samtidig, når I kommer til DevOps, men I skal starte med at forstå, hvad I har, og hvordan I styrer det. Det er præcist praksis med infrastruktur som kode.
Når det er blevet klart, hvad I har, og hvordan I kan styre det, begynder I at finde ud af, hvordan udviklerens kode hurtigst muligt skal sendes til produktion. Jeg mener sammen med udvikleren – husk på problemet med "brønden", altså at det ikke er enkeltpersoner, der finder på det, men et team.
Da vi så Ivan Evtukhovich for den første bog af Jez Humble og et forfatterhold «Continuous Delivery», som blev udgivet i 2009, overvejede vi længe, hvordan vi skulle oversætte dens titel til russisk. Vi ville oversætte det som «Levering hele tiden», men desværre oversatte vi det som «Kontinuerlig levering». Jeg synes, at der er et eller andet russisk over vores navn, med en stærk essens.
Levering hele tiden betyder
At koden, som ligger i produktarkivet, altid kan blive sendt til produktion. Den kan muligvis ikke blive sendt, men den er altid klar til det. Som følge heraf skriver I altid kode med en svær at forklare følelse af en vis ubehag under halebenet. Dette ubehag opstår ofte, når man ruller infrastrukturen ud. Denne følelse af ubehag bør være til stede - den fremkalder mentale processer, som gør, at man kan skrive koden lidt anderledes. Dette skal være fastlagt i reglerne inden for udviklingen.
For at levere konstant er der behov for et artefaktformat, der fungerer på infrastrukturplatformen. Hvis I smider affald af forskellig art ind på infrastrukturplatformen, bliver den ikke ensartet, den er svær at vedligeholde, og der opstår teknisk gæld. Artefaktformatet skal harmoniseres - det er også en kollektiv opgave: alle skal samles, tænke og finde på dette format.
Artefakten forbedres kontinuerlig og ændrer sig under produktionsmiljøet, mens den bevæger sig gennem leveringspipen. Når artefakten bevæger sig gennem pipelinen, støder den hele tiden på nogle ubehagelige situationer, der ligner dem, som artefakten, som du udgiver til produktion, oplever. Hvis en systemadministrator håndterer udgivelserne i klassisk udvikling, så sker det kontinuerligt i DevOps-processen: her bliver den koordineret med forskellige tests, der bliver sendt til et Kubernetes-kluster, som mere eller mindre ligner produktionen, og her vil der pludselig blive udført belastningstests.
Det minder om at spille Pac-Man – artefakten gennemgår en slags historie. Det er vigtigt at kontrollere, om koden faktisk gennemgår historien, og at den på en eller anden måde er knyttet til din produktion. Historier fra produktion kan integreres i Continuous Delivery-processen: i situationen hvor noget bryder sammen, lad os programmere dette scenarie ind i systemet. Hver gang koden vil også gennemgå dette scenarie, og du vil ikke støde på dette problem næste gang. Du vil opdage det meget tidligere, end det når til din kunde.
Forskellige distributionsstrategier. For eksempel kan du bruge AB-test eller kanariefugle-distribution for at "afprøve" koden på forskellige kunder, så du kan få indblik i, hvordan koden fungerer, meget før den rulles ud til 100 millioner brugere.
"At levere kontinuerligt" ser således ud.
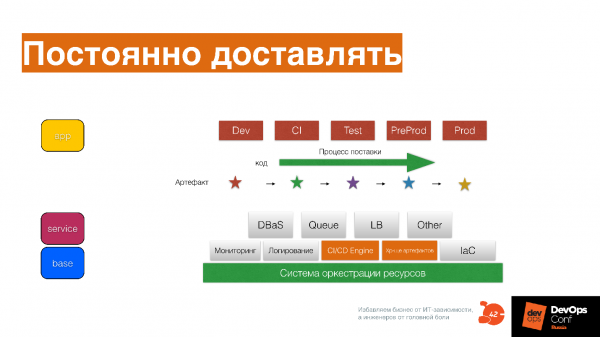
Leveringsprocessen Dev, CI, Test, PreProd, Prod – er ikke et separat miljø, det er stadier eller stationer med brandsikre summer, som din artefakt bevæger sig gennem.
Hvis du har infrastrukturkode, der er beskrevet som Base Service APP, så hjælper det med ikke at glemme alle scenarier., og også optage dem i form af kode for denne artefakt, fremme artefakten og ændre den undervejs.
Spørgsmål til selvkontrol
Er tiden fra beskrivelsen af funktionen til udgivelsen til produktion i 95 % af tilfældene mindre end en uge? Forbedres artefaktens kvalitet på hvert trin i pipelinen? Er der en historie, som den gennemgår? Bruger du forskellige distributionsstrategier?
Hvis alle svar er ja, så er du virkelig fantastisk! Skriv svarene i kommentarerne - jeg vil være glad for det.
Feedback
Dette er den sværeste praksis af alle. På DevOpsConf-konferencen var en kollega fra Infobip lidt forvirret i sine ord, mens han talte om det, fordi det virkelig er en meget kompleks praksis for, hvad man skal overvåge overhovedet.
For eksempel, for længe siden, da jeg arbejdede i Qik, indså vi, at vi skulle overvåge alt. Vi gjorde det, og i Zabbix havde vi 150.000 items, der blev overvåget kontinuerligt. Det var skræmmende, og direktøren rystede på hovedet:
— Fyre, hvad laver I med serveren?
Men derefter skete der en hændelse, der viste, at det faktisk er en rigtig god strategi.
En af tjenesterne begyndte konstant at falde. Oprindeligt faldt den ikke, hvilket er interessant, da der ikke blev tilføjet nogen kode, fordi det var en grundlæggende broker, der praktisk talt ikke havde nogen forretningsfunktionalitet — den sendte blot beskeder mellem de forskellige tjenester. Tjenesten havde ikke ændret sig i 4 måneder, og pludselig begyndte den at falde med fejlen "Segmentation fault".
Vi var chokerede, åbnede vores grafer i Zabbix, og fandt ud af, at adfærden for anmodningerne i API-tjenesten, der bruger denne broker, pludselig ændrede sig for halvanden uge siden. Derefter så vi, at hyppigheden af sendingen af en bestemt type beskeder var ændret. Efterfølgende fandt vi ud af, at det var android-klienter, og vi spurgte:
— Fyre, hvad skete der med jer for halvanden uge siden?
Som svar hørte vi en interessant historie om, at de havde redesignede UI. Det er usandsynligt, at nogen straks ville sige, at de ændrede HTTP-biblioteket. For android-klienter er det som at skifte sæbe i badeværelset — de kan simpelthen ikke huske det. I sidste ende, efter 40 minutters samtale, fandt vi ud af, at de faktisk havde ændret HTTP-biblioteket, og at dets standardtider var blevet ændret. Det førte til, at trafikadfærden på API-serveren ændrede sig, hvilket førte til den situation, der forårsagede en race inde i brokeren, og den begyndte at falde.
Uden dyb overvågning er det overhovedet umuligt at opdage dette.. Hvis der i organisationen også er et problem med "brønde", hvor alle kaster ansvaret videre til hinanden, kan det leve i årevis. Du genstarter bare serveren, fordi det er umuligt at løse problemet. Når du overvåger, sporer alle hændelser, du har, og bruger overvågning som testning - skriver kode og angiver straks, hvordan den skal overvåges, også i kodens form (vi har allerede infrastruktur som kode), bliver alt klart som dagen. Selv så komplekse problemer kan nemt følges.
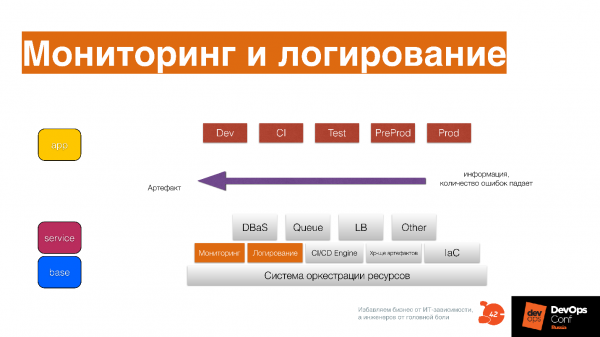
Indsaml al information om, hvad der sker med artefakten på hver fase af leveringsprocessen - ikke i produktion.
Upload overvågning til CI, og der vil allerede være synlige grundlæggende ting. Derefter vil du se dem i Test, i PredProd og i belastningstestning. Indsaml information på alle faser, ikke kun metrics, statistik, men også logs: hvordan applikationen blev udrullet, anomalier - indsaml alt.
Ellers bliver det svært at finde ud af. Jeg har allerede sagt, at DevOps er større kompleksitet. For at håndtere denne kompleksitet kræves der en ordentlig analyse..
Selvkontrol spørgsmål.
Er din overvågning og logføring et udviklingsværktøj for dig? Tænker dine udviklere, inklusive dig, på, hvordan koden skal overvåges, når de skriver den?
Finder du ud af problemer fra kunder? Forstår du kunden bedre gennem overvågning og logførsel? Forstår du systemet bedre gennem overvågning og logførsel? Ændrer du systemet bare fordi du har set, at trenden i systemet stiger, og forstår, at om 3 uger vil alt falde sammen?
Når du har disse tre komponenter, kan du overveje, hvilken infrastruktural platform du har i din virksomhed.
Infrastruktural platform.
Det handler ikke om, at det er en samling af adskilte værktøjer, som findes i hver virksomhed.
Essensen af den infrastrukturelle platform er, at alle teams bruger disse værktøjer og udvikler dem sammen.
Det er klart, at der er adskilte teams, som er ansvarlige for udviklingen af særskilte dele af den infrastrukturelle platform. Men samtidig bærer hvert ingeniør ansvar for udviklingen, driftsikkerheden og fremme af den infrastrukturelle platform. På det interne niveau bliver det et fælles værktøj.
Alle teams udvikler infrastrukturplatformen og behandler den omhyggeligt som deres eget IDE. I dit IDE installerer du forskellige plugins for at gøre det pænt og hurtigt, og du tilpasser genvejstasterne. Når du åbner Sublime, Atom eller Visual Studio Code, popper der kodefejl op, og du forstår, at det er umuligt at arbejde; du bliver straks trist og løber for at reparere dit IDE.
Behandl derfor din infrastrukturplatform på samme måde. Hvis du forstår, at der er noget galt med den, skal du indsende en anmodning, hvis du ikke kan reparere det selv. Men hvis det er noget simpelt, skal du rette det selv og sende pull requesten - folkene ser på det og tilføjer. Det er en lidt anden tilgang til ingeniørværktøjet i udviklerens hoved.
Infrastrukturplatformen sikrer overførsel af artefaktet fra udvikling til kunde med konstant forbedring af kvaliteten. I IP'en er der programmeret en række historier, der sker med koden i produktion. Gennem årene er der blevet mange af disse historier, nogle af dem er unikke og relateret kun til dig - de kan ikke findes på internettet.
På dette tidspunkt bliver infrastrukturplatformen din konkurrencefordel, fordi der er indbygget ting, som ikke findes i konkurrentens værktøj. Jo dybere din IP er, desto større er din konkurrencefordel i forhold til Time-to-market. Her opstår der problem ved vendor lock: du kan tage en andens platform, men ved at bruge andres erfaring vil du ikke forstå, hvor relevant den er for dig. Ja, ikke alle virksomheder kan bygge en platform som Amazon. Det er en svær grænse, hvor en virksomheds erfaring er relevant for dens placering på markedet, og man må ikke give efter for vendor lock. Det er også vigtigt at overveje.
Diagram
Dette er den grundlæggende struktur af infrastrukturplatformen, som vil hjælpe dig med at etablere alle praksisser og processer i en DevOps-virksomhed.
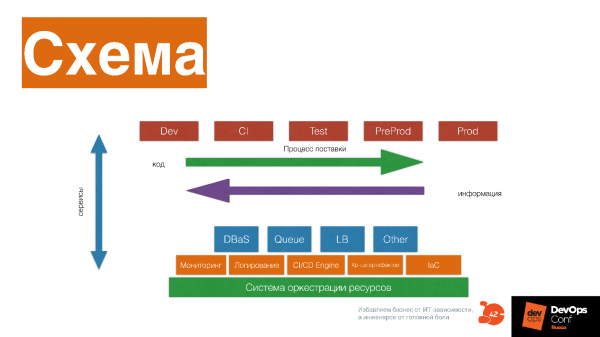
Lad os se på, hvad den består af.
System til orkestrering af ressourcer, som leverer CPU, hukommelse og disk til applikationer og andre tjenester. Oven på dette - tjenester af lavere niveau: overvågning, logging, CI/CD-motor, artefaktholdere, infrastruktur som kode-systemer.
Tjenester af højere niveau: database as a service, queues as a service, Load Balance as a service, image resizing as a service, Big Data factory as a service. On top of this — a pipeline that constantly delivers modified code to your client.
You get information on how your software performs for the client, make changes, deliver the code again, get feedback — and thus continually develop both the infrastructure platform and your software.
In the diagram, the delivery pipeline consists of many stages. But this is a conceptual diagram provided as an example — there's no need to replicate it exactly. The stages interact with services as services — each building block of the platform has its own story: how resources are allocated, how the application is launched, how it interacts with resources, is monitored, and evolves.
It's important to understand that each part of the platform tells a story, and you should ask yourself — what story does this building block tell? Perhaps it should be discarded and replaced with a third-party service. For example, can we replace a block with Okmeter? Maybe those guys have already developed this expertise much more than we have. But maybe not — perhaps we have unique expertise, and we need to implement Prometheus and develop it further.
Creating the platform
It’s a complex communication process. When you have basic practices, you initiate communication among different engineers and specialists who develop requirements and standards, and continuously modify them for different tools and approaches. Here, the culture present in DevOps is crucial.
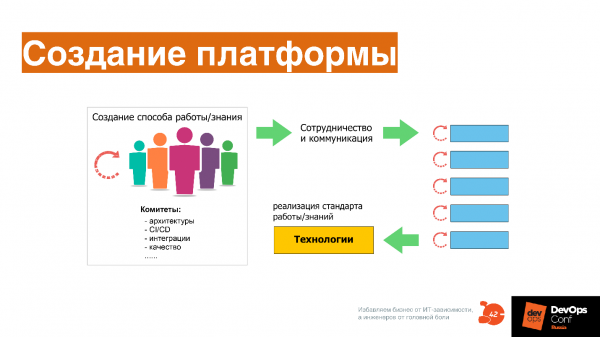
With culture, everything is quite simple — it's collaboration and communication, that is, the willingness to work collectively in the same field, the desire to master a single tool together. There’s no rocket science here — it's all very straightforward, even trivial. For example, we all live in an apartment building and maintain its cleanliness — that’s the level of culture.
And what about you?
Again, questions you can ask yourself.
Is the infrastructure platform distinguished? Who is responsible for its development? Do you understand the competitive advantages of your infrastructure platform?
Disse spørgsmål skal man konstant stille sig selv. Hvis noget kan udskilles til eksterne tjenester, skal det gøres. Hvis en ekstern tjeneste begynder at blokere din fremgang, så skal man opbygge et system internt.
Så, DevOps…
… er et komplekst system, som skal indeholde:
- Et digitalt produkt.
- Forretningsmoduler, der udvikler dette digitale produkt.
- Produktionsteams, der skriver kode.
- Praktikker for Continuous Delivery.
- Platforme som service.
- Infrastruktur som service.
- Infrastruktur som kode.
- Separate praksisser til at opretholde pålideligheden, indbygget i DevOps.
- En feedbackpraksis, der beskriver alt dette.
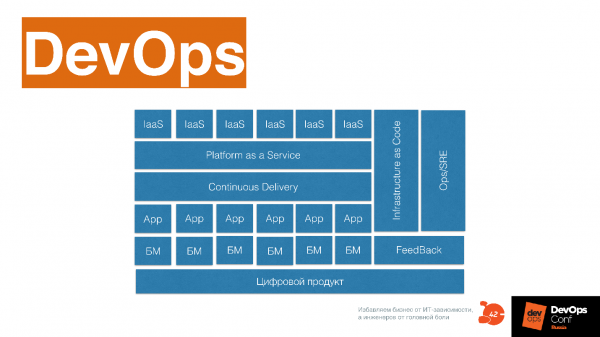
Man kan bruge denne skema, og fremhæve det, som allerede findes i virksomheden i en eller anden form: det er blevet udviklet, eller det skal stadig udvikles.
Allerede om et par uger finder . som en del af RIT++. Kom til konferencen, hvor der venter mange interessante foredrag om kontinuerlig levering, infrastruktur som kode og DevOps-transformation. , sidste frist for priser er 20. maj.
Kilde: habr.com
