

10. august startede der et , hvor vi dækker det fuldstændigt — fra grundlæggende abstraktioner til netværksparametre.
I denne artikel vil vi tale om historien bag Docker og dets grundlæggende abstraktioner: Image, CLI, Dockerfile. Forelæsningen er rettet mod nybegyndere, så det vil næppe være interessant for erfarne brugere. Der vil ikke være nogen blodige detaljer, appendicer eller dybtgående analysere. Bare det helt grundlæggende.
Hvad er Docker
Lad os se på definitionen af Docker fra Wikipedia.
Docker er software til automatisering af implementering og styring af applikationer i miljøer med containerunderstøttelse.
Ud fra denne definition er der ikke meget klarhed. Især hvad det betyder at 'i miljøer med containerunderstøttelse'. For at forstå det, lad os gå tilbage i tiden. Vi starter i en æra, som jeg delvis kalder 'Monolitæraen'.
Monolitæraen
Monolitæraen er begyndelsen af 2000'erne, hvor alle applikationer var monolitiske, med et væld af afhængigheder. Udviklingen tog lang tid. På samme tid var serverne ikke så mange, og vi kendte dem alle ved navn og overvågede dem. Der er et sjovt sammenligningspunkt:
Pets — det er kæledyr. I monolitæraen behandlede vi vores servere som kæledyr, vi plejer og tager os af dem, blæser støvet af dem. For bedre at styre ressourcerne brugte vi virtualisering: vi tog en server og delte den op i flere virtuelle maskiner, og dermed sikrede vi isolering af miljøet.
Virtualiseringssystemer baseret på hypervisor
Alle har sikkert hørt om virtualiseringssystemer: VMware, VirtualBox, Hyper-V, Qemu KVM osv. De sikrer isolering af applikationer og ressourceforvaltning, men de har også ulemper. For at lave virtualisering kræves en hypervisor. Og hypervisoren medfører ressourceoverhead. Desuden er selve den virtuelle maskine ofte en stor enhed — et tungt billede, som har et operativsystem, Nginx, Apache og muligvis MySQL. Billedet er stort, og det er uhandy at arbejde med en virtuel maskine. Som følge heraf kan arbejdet med virtualisering være langsomt. For at løse dette problem blev der skabt virtualiseringssystemer på kernniveau.
Virtualiseringssystemer på kernniveau
Virtualisering på kerniveau understøttes af systemer som OpenVZ, Systemd-nspawn, LXC. Et klart eksempel på sådan virtualisering er LXC (Linux Containers).
LXC — et virtualiseringssystem på operativsystemniveau, der tillader kørsel af flere isolerede forekomster af Linux-operativsystemet på én værtsmaskine. LXC bruger ikke virtuelle maskiner, men opretter et virtuelt miljø med sit eget procesrum og netværksstak.
Essentielt set opretter LXC containere. Hvad er forskellen mellem virtuelle maskiner og containere?
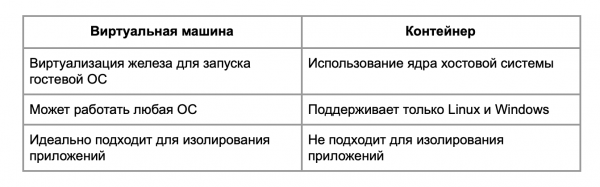
Containere er ikke velegnede til procesisolering: i virtualiseringssystemer på kerniveau findes der sårbarheder, der gør det muligt at komme ud af en container til værten. Så hvis du har brug for at isolere noget, er det bedre at bruge en virtuel maskine.
Forskelle mellem virtualisering og containerisering kan ses i diagrammet.
Der findes hardwarehypervisorer, hypervisorer ovenpå operativsystemet og containere.
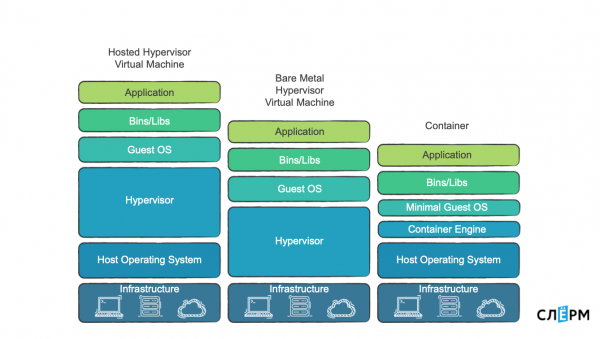
"Hardware" hypervisorer er fantastisk, hvis du virkelig vil isolere noget. Fordi der er mulighed for at isolere på niveau med hukommelsessider og processorer.
Der er hypervisorer som programmer, og der er containere, og dem vil vi tale videre om. I containeriseringssystemer findes der ikke en hypervisor, men der er en Container Engine, der opretter og administrerer containere. Denne løsning er lettere, så ved at arbejde med kernen er overheadet mindre, eller det findes slet ikke.
Hvad der bruges til containerisering på kerne-niveau
De primære teknologier, der muliggør oprettelsen af en isoleret container fra andre processer, er Namespaces og Control Groups.
Namespaces: PID, Networking, Mount og User. Der er flere, men for enkelhedens skyld stopper vi ved disse.
PID Namespace begrænser processer. Når vi for eksempel opretter et PID Namespace og placerer en proces der, får den PID 1. Normalt er PID 1 i systemer systemd eller init. Når vi derfor placerer en proces i et nyt namespace, får den også PID 1.
Networking Namespace tillader begrænsning/isolering af netværket, og man kan placere sine egne grænseflader der. Mount er en begrænsning i filsystemet. User er en begrænsning for brugere.
Control Groups: Memory, CPU, IOPS, Network — omkring 12 indstillinger i alt. De kaldes også Cgroups ("C-grupper").
Control Groups styrer ressourcerne for containeren. Gennem Control Groups kan vi angive, at containeren ikke må forbruge mere end en vis mængde ressourcer.
For containerization to work effectively, additional technologies are used: Capabilities, Copy-on-write, and others.
Capabilities refer to defining what a process can and cannot do. At the kernel level, these are simply bitmaps with numerous parameters. For instance, the root user has full privileges and can do anything. A time server can change the system time: it has capabilities for Time Capsule, and that’s it. Privileges allow for flexible constraints on processes, thereby enhancing security.
The Copy-on-write system allows us to work with Docker images more efficiently.
Currently, Docker has compatibility issues with Cgroups v2, so this article specifically addresses Cgroups v1.
But let’s return to the history.
When virtualization systems at the kernel level emerged, they began to be widely adopted. The overhead on the hypervisor disappeared, but some issues remained:
- large images: OpenVZ pushes the operating system, libraries, and a bunch of different software, and as a result, the image still becomes quite large;
- there’s no proper packaging and delivery standard, which leaves the dependency problem. There are situations where two pieces of code use the same library but with different versions. This can lead to conflicts.
To solve all these problems, the next era arrived.
The Era of Containers
When the Era of Containers began, the philosophy of working with them changed:
- One process — one container.
- All necessary dependencies for the process are delivered within its container. This requires breaking up monoliths into microservices.
- The smaller the image, the better — fewer potential vulnerabilities, faster deployments, and so on.
- Instances become ephemeral.
Remember when I talked about pets vs cattle? Previously, instances were akin to pets, but now they have become like cattle. There used to be a monolith — one application. Now there are 100 microservices, 100 containers. Some containers might have 2-3 replicas. It becomes less important to control each container. What matters more is the availability of the service itself: what this set of containers does. This changes monitoring approaches.
In 2014-2015, the rise of Docker occurred — the technology we will discuss now.
Docker har ændret filosofien og standardiseret applikationspakning. Med Docker kan vi pakke en applikation, sende den til et repository, hente den derfra og implementere den.
I Docker-containeren lægger vi alt nødvendigt, hvilket løser afhængighedsproblemet. Docker garanterer reproducerbarhed. Jeg tror, mange har stået over for uforudsigelighed: alt fungerer, når du skubber til produktion, men så stopper det med at fungere. Med Docker forsvinder dette problem. Hvis din Docker-container starter op og udfører det, den skal, så er der en stor sandsynlighed for, at den også vil fungere i produktionen og gøre det samme.
Et afsnit om overhead
Der er konstant debat om overhead. Nogle mener, at Docker ikke tilføjer ekstra belastning, da det bruger Linux-kernen og alle dens processer, der er nødvendige for containerisering. "Hvis du siger, at Docker er overhead, så er Linux-kernen også overhead."
På den anden side, hvis man dykker dybere ned, så er der faktisk nogle ting i Docker, som med lidt god vilje kan kaldes overhead.
Det første er PID-namespace. Når vi placerer en proces i namespace, tildeles den PID 1. Samtidig har denne proces også en anden PID, der findes i host-namespace, uden for containeren. For eksempel, hvis vi kører Nginx i en container, bliver den PID 1 (master-proces). På værten har den PID 12623. Det er svært at vurdere, hvor meget overhead det er.
Den anden ting er Cgroups. Lad os tage Cgroups for hukommelse, det vil sige muligheden for at begrænse hukommelsen for containeren. Når det slås til, aktiveres tællere, memory accounting: kernen skal forstå, hvor mange sider der er tildelt, og hvor mange der stadig er ledige for denne container. Dette kan være overhead, men jeg har ikke set præcise undersøgelser af, hvordan det påvirker ydeevnen, og jeg har ikke selv bemærket, at applikationer, der kører i Docker, pludselig mistede ydeevne.
En ting mere om ydeevnen. Nogle kerneparametre overføres fra værten til containeren. Især nogle netværksparametre. Derfor, hvis du ønsker at køre noget højtydende i Docker, for eksempel noget der aktivt benytter netværket, skal du i det mindste justere disse parametre. For eksempel nf_conntrack.
Om konceptet Docker
Docker består af flere komponenter:
- Docker Daemon – den samme Container Engine; starter containere.
- Docker CII – et værktøj til at administrere Docker.
- Dockerfile – instruktioner til, hvordan man bygger et billede.
- Image – et billede, der rulles ud til en container.
- Container.
- Docker registry – et lager af billeder.
Schematisk ser det cirka sådan her ud:
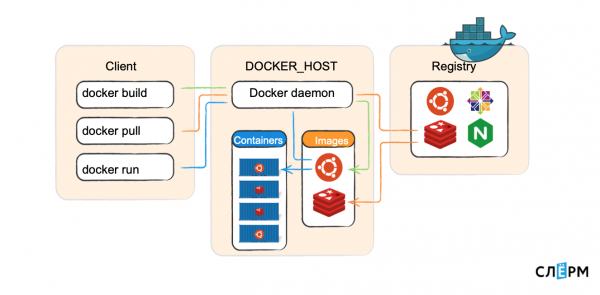
På Docker_host kører Docker daemon, som starter containere. Der er en Client, der sender kommandoer: bygg billede, download billede, start container. Docker daemon henter i registry og udfører dem. Docker-klienten kan få adgang både lokalt (til Unix-socket) og via TCP fra en fjernhost.
Lad os gennemgå hver komponent.
Docker daemon (daemon) – er den server-side komponent, der kører på værtmaskinen: downloader billeder og starter containere fra dem, opretter netværk mellem containere, indsamler logs. Når vi siger "opret billede", er det også noget, daemonen håndterer.
Docker CLI – er klientkomponenten i Docker, et konsolværktøj til arbejde med daemonen. Jeg gentager, den kan arbejde ikke kun lokalt, men også over netværket.
Grundlæggende kommandoer:
docker ps – viser de containere, der i øjeblikket kører på Docker-vært.
docker images – viser billeder, der er downloadet lokalt.
docker search – søg efter et billede i registry.
docker pull – download billede fra registry til maskinen.
docker build <> – byg et billede.
docker run – start en container.
docker rm – slet en container.
docker logs – logs fra containeren.
docker start/stop/restart – arbejde med containeren.
Hvis du mestrer disse kommandoer og bruger dem sikkert, kan du betragte det som at have mestret Docker på brugerens niveau med 70%.
Dockerfile – instruktionen til at oprette et billede. Næsten hver kommando i instruktionen er et nyt lag. Lad os se på et eksempel.
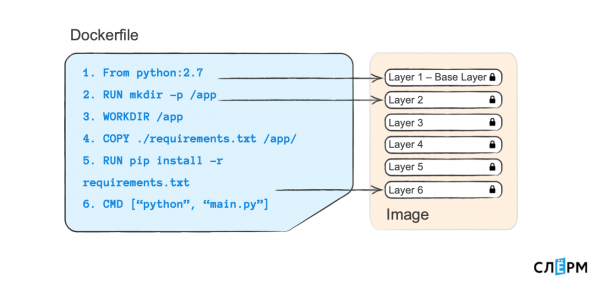
Sådan ser en Dockerfile ud: til venstre kommandoer, til højre – argumenter. Hver kommando, der er her (og generelt skrevet i Dockerfile), skaber et nyt lag i Image.
Selv ved at se på venstre side kan man få en idé om, hvad der foregår. Vi siger: "opret en mappe for os" – det er et lag. "Gør mappen til arbejdsmappe" – det er endnu et lag, og så videre. Lagkagen gør livet lettere. Hvis jeg opretter endnu en Dockerfile og ændrer noget i den sidste linje – hvis jeg starter ikke "python" "main.py", men noget andet, eller installerer afhængigheder fra en anden fil – så vil de tidligere lag blive genbrugt som cache.
Billede — dette er en containerpakke, fra hvilken der startes containere. Ser man på Docker som en pakkeadministrator (som om vi arbejder med deb eller rpm-pakker), så er et image i bund og grund en rpm-pakke. Via yum install kan vi installere applikationen, slette den, finde den i depotet og downloade den. Her er det lidt det samme: containere startes fra image, de opbevares i Docker registry (svarende til yum, i depotet), og hvert image har en SHA-256 hash, et navn og et tag.
Et image opbygges efter instruktionerne fra Dockerfile. Hver instruktion fra Dockerfile skaber et nyt lag. Lagene kan genbruges.
Docker registry — er et repository for Docker images. I lighed med et operativsystem har Docker et offentligt standardregister — dockerhub. Men man kan også oprette sit eget repository, sit eget Docker registry.
Container — er det, der startes fra et image. Vi har samlet et image efter instruktionen fra Dockerfile, og derefter starter vi det fra dette image. Denne container er isoleret fra de øvrige containere, og den skal indeholde alt, hvad der er nødvendigt for at køre applikationen. Desuden er én container lig med én proces. Det sker nogle gange, at man må have to processer, men det strider lidt imod Docker's ideologi.
Kravet om "én container — én proces" er relateret til PID Namespace. Når der i Namespace startes en proces med PID 1, hvis den pludselig dør, dør hele containeren også. Hvis der derimod kører to processer: en lever, og den anden er død, vil containeren stadig fortsætte med at eksistere. Men det er et spørgsmål om Best Practices, som vi vil tale om i andre materialer.
Du kan udforske detaljerne og det fulde program for kurset via linket: "».
Forfatter: Marcel Ibraev, certificeret Kubernetes-administrator, praktiserende ingeniør i Southbridge, taler og kursusudvikler for Slyrm.
Kilde: habr.com
