

I dette indlæg vil vi dele en interessant måde at håndtere konfigurationen af et distribueret system på.
Konfigurationen er direkte repræsenteret i Scala-sproget på en typesikker måde. Et eksempel på implementeringen er beskrevet i detaljer. Forskellige aspekter af forslaget diskuteres, herunder indflydelse på den overordnede udviklingsproces.
()
Introduktion
At bygge robuste distribuerede systemer kræver brug af korrekt og sammenhængende konfiguration på alle noder. En typisk løsning er at bruge en tekstuel deploymentsbeskrivelse (terraform, ansible eller noget lignende) og automatisk genererede konfigurationsfiler (ofte - dedikeret til hver node/rolle). Vi vil også gerne bruge de samme protokoller af de samme versioner på hver kommunikerende node (ellers ville vi opleve inkompatibilitetsproblemer). I JVM-verdenen betyder det, at i det mindste skal messaging-biblioteket være af den samme version på alle kommunikerende noder.
Hvad med at teste systemet? Selvfølgelig skal vi have enhedstest for alle komponenter, før vi går videre til integrationstest. For at kunne ekstrapolere testresultaterne til runtime, skal vi sikre, at versionerne af alle biblioteker holdes identiske i både runtime og testmiljøer.
Når der køres integrationstest, er det ofte meget lettere at have den samme classpath på alle noder. Vi skal blot sikre, at den samme classpath bruges ved deployment. (Det er muligt at bruge forskellige classpaths på forskellige noder, men det er sværere at repræsentere denne konfiguration og korrekt implementere den.) Så for at holde tingene enkle vil vi kun betragte identiske classpaths på alle noder.
Konfiguration har tendens til at udvikle sig sammen med softwaren. Vi bruger som regel versioner til at identificere forskellige
faser af softwareudvikling. Det virker rimeligt at dække konfigurationen under versionsstyring og identificere forskellige konfigurationer med nogle labels. Hvis der kun er én konfiguration i produktion, kan vi bruge en enkelt version som identificator. Nogle gange kan vi have flere produktionsmiljøer. Og for hvert miljø har vi muligvis brug for en separat gren af konfigurationen. Så konfigurationer kan mærkes med gren og version for unikt at identificere forskellige konfigurationer. Hver grenlabel og version svarer til en enkelt kombination af distribuerede noder, porte, eksterne ressourcer, classpath-biblioteksversioner på hver node. Her vil vi kun dække den enkelte gren og identificere konfigurationer med en trekomponents decimalversion (1.2.3), på samme måde som andre artefakter.
I moderne miljøer ændres konfigurationsfiler ikke længere manuelt. Typisk genererer vi
konfigurationsfiler ved deploymentstidspunktet og bagefter. Så man kunne spørge, hvorfor vi stadig bruger tekstformat til konfigurationsfiler? En holdbar mulighed er at placere konfigurationen inden for en kompilationsenhed og drage fordel af validering af konfigurationen ved kompileringstid.
I dette indlæg vil vi undersøge ideen om at holde konfigurationen i det kompilerede artefakt.
Kompilérbar konfiguration
I dette afsnit vil vi diskutere et eksempel på statisk konfiguration. To enkle tjenester - echo-service og klienten til echo-servicen bliver konfigureret og implementeret. Derefter oprettes to forskellige distribuerede systemer med begge tjenester. Den ene er til en enkelt nodekonfiguration, og den anden til en konfiguration med to noder.
Et typisk distribueret system består af nogle noder. Noderne kan identificeres ved hjælp af en type:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
eller blot
case class NodeId(hostName: String)eller endda
object Singleton
type NodeId = Singleton.type
Disse noder udfører forskellige roller, kører forskellige tjenester og skal kunne kommunikere med de andre noder via TCP/HTTP-forbindelser.
For TCP-forbindelse kræves mindst et portnummer. Vi vil også sikre, at klient og server taler den samme protokol. For at modellere en forbindelse mellem noderne lad os erklære følgende klasse:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])where Port er blot en Int inden for det tilladte interval:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined typer
Se bibliotek. Kort sagt giver det mulighed for at tilføje kompileringstid begrænsninger til andre typer. I dette tilfælde Int er det kun tilladt at have 16-bit værdier, som kan repræsentere portnummer. Der er ikke noget krav om at bruge dette bibliotek til denne konfigurationsmetode. Det ser bare ud til at passe meget godt.
For HTTP (REST) kan vi også have brug for en sti til tjenesten:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom type
For at identificere protokollen under kompilering bruger vi Scala-funktionen til at erklære typeargumentet Protokol der ikke bruges i klassen. Det er en såkaldt phantom type. Ved runtime har vi sjældent brug for en forekomst af protokolidentifikatoren, derfor gemmer vi ikke den. Under kompilering giver denne phantom type ekstra typesikkerhed. Vi kan ikke sende en port med forkert protokol.
En af de mest anvendte protokoller er REST API med Json serialisering:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]where RequestMessage er den grundlæggende type af beskeder, som klienten kan sende til serveren og ResponseMessage er svarets besked fra serveren. Selvfølgelig kan vi oprette andre protokoldeskrivelser, der specificerer kommunikationsprotokollen med den ønskede præcision.
Til formålene med dette indlæg vil vi bruge en simplere version af protokollen:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]I denne protokol tilføjes anmodningsbeskeden til url'en, og svarets besked returneres som ren tekst.
En servicekonfiguration kunne beskrives ved service navnet, en samling af porte og nogle afhængigheder. Der er nogle måder at repræsentere alle disse elementer i Scala (for eksempel, HList, algebraiske datatyper). Til formålene med dette indlæg vil vi bruge Cake Pattern og repræsentere kombinerbare dele (moduler) som traits. (Cake Pattern er ikke et krav til denne compilable konfigurationsmetode. Det er blot en mulig implementering af idéen.)
Afhængigheder kunne repræsenteres ved hjælp af Cake Pattern som endpoints for andre noder:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo-tjenesten har kun brug for en konfigureret port. Og vi erklærer, at denne port understøtter echo protokollen. Bemærk, at vi ikke har behov for at specificere en bestemt port på dette tidspunkt, fordi traits tillader abstrakte metodeerklæringer. Hvis vi bruger abstrakte metoder, vil kompilatoren kræve en implementering i en konfigurationsinstans. Her har vi givet implementeringen (8081) og den vil blive brugt som standardværdi, hvis vi springer den over i en konkret konfiguration.
Vi kan erklære en afhængighed i konfigurationen af klientsiteten:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Afhængigheden har den samme type som echoService. Især kræver det den samme protokol. Derfor kan vi være sikre på, at hvis vi forbinder disse to afhængigheder, vil de fungere korrekt.
Tjenesteimplementering
En tjeneste har brug for en funktion til at starte og lukke ned på en kontrolleret måde. (Muligheden for at lukke en tjeneste er afgørende for testning.) Igen er der et par muligheder for at specificere en sådan funktion for en given konfiguration (for eksempel kunne vi bruge type klasser). For dette indlæg vil vi igen bruge Cake Pattern. Vi kan repræsentere en tjeneste ved hjælp af cats.Resource som allerede giver indramning og ressourcefrigivelse. For at få fat i en ressource skal vi give en konfiguration og noget runtime-kontext. Så funktionen til at starte tjenesten kunne se således ud:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
where
Konfigurer− type for konfiguration, der kræves af denne service starterAddressResolver− et runtime-objekt, der har evnen til at opnå virkelige adresser fra andre noder (fortsæt med at læse for detaljer).
de andre typer kommer fra cats:
F[_]− effekt type (i det enkleste tilfældeF[A]kunne være blot() => A. I dette indlæg vil vi brugecats.IO.)Reader[A,B]− er stort set et synonym for en funktionA => Bcats.Resource− har metoder til at erhverve og frigiveTimer− tillader at sove/måle tidContextShift− analog tilExecutionContextApplicative− wrapper af funktioner i effekt (næsten en monad) (vi kan i sidste ende erstatte det med noget andet)
Ved at bruge dette interface kan vi implementere et par tjenester. For eksempel, en tjeneste der ikke laver noget:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Se for andre implementeringer af tjenester − ,
og .)
En node er et enkelt objekt, der kører et par tjenester (start af en kæde af ressourcer er aktiveret af Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Bemærk, at vi i noden angiver den præcise type af konfiguration, der er nødvendig for denne node. Compiler vil ikke lade os bygge objektet (Cake) med en utilstrækkelig type, fordi hver service trait erklærer en begrænsning på den Konfigurer type. Vi vil heller ikke være i stand til at starte noden uden at give en komplet konfiguration.
Node adresseoplysning
For at etablere en forbindelse har vi brug for en rigtig værtadresse for hver node. Den kan være kendt senere end andre dele af konfigurationen. Derfor har vi brug for en måde at levere en kortlægning mellem node-id og dens aktuelle adresse. Denne kortlægning er en funktion:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Der er et par mulige måder at implementere en sådan funktion.
- Hvis vi kender de faktiske adresser før implementeringen, under nodernes værtsinstansiering, kan vi generere Scala-kode med de faktiske adresser og køre bygningen bagefter (som udfører compile-time checks og derefter kører integrations-testsuite). I dette tilfælde er vores kortlægningsfunktion kendt statisk og kan forenkles til noget som en
Map[NodeId, NodeAddress]. - Nogle gange får vi de faktiske adresser først senere, når noden faktisk er startet, eller vi har ikke adresser for noder, der ikke er startet endnu. I dette tilfælde kan vi have en opdagelsestjeneste, der startes før alle andre noder, og hver node kan annoncere sin adresse i den tjeneste og abonnere på afhængigheder.
- Hvis vi kan modificere
/etc/hosts, kan vi bruge prædefinerede vært navne (sommy-project-main-nodeogecho-backend) og blot associere dette navn med ip-adresse ved implementeringstidspunktet.
I dette indlæg dækker vi ikke disse tilfælde mere detaljeret. Faktisk i vores legetøj eksempel vil alle noder have den samme IP-adresse − 127.0.0.1.
I dette indlæg vil vi overveje to distribuerede systemlayouter:
- Enkelt node-layout, hvor alle tjenester er placeret på den enkelte node.
- To node-layout, hvor service og klient er på forskellige noder.
Konfigurationen for en layout er som følger:
Enkelt nodekonfiguration
objekt SingleNodeConfig udvider EchoConfig[String]
  med EchoClientConfig[String] med FiniteDurationLifecycleConfig
{
  case object Singleton

  type NodeId = Singleton.type
  def nodeId = Singleton


  /** Typesikker serviceport-specifikation. */
  override def portNumber: PortNumber = 8088


  /** Vi bruger den service, som tilbydes af den samme vært. */
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hej"

  def pollInterval: FiniteDuration = 1.second


  // livscykluscontroller konfiguration
  def lifetime: FiniteDuration = 10500.milliseconds
}
Her opretter vi en enkelt konfiguration, der udvider både server- og klientkonfiguration. Vi konfigurerer også en livscykluscontroller, der normalt afslutter klient og server efter levetid intervallet er passeret.
Det samme sæt af serviceimplementeringer og konfigurationer kan bruges til at skabe et systems layout med to separate noder. Vi skal bare oprette med de relevante tjenester:
To nodekonfigurationer
  objekt NodeServerConfig udvider EchoConfig[String] med SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  objekt NodeClientConfig udvider EchoClientConfig[String] med FiniteDurationLifecycleConfig
  {

    // NB! afhængighedsspecifikation
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds

    def testMessage: String = "dolly"
  }
Se hvordan vi specificerer afhængigheden. Vi nævner den anden nodes leverede service som en afhængighed af den aktuelle node. Afhængighedstypen kontrolleres, fordi den indeholder en spøgelsestype, der beskriver protokollen. Og ved kørsel vil vi have den korrekte node-id. Dette er et af de vigtigste aspekter ved den foreslåede konfigurationsmetode. Det giver os mulighed for kun at sætte porten én gang og sikre, at vi refererer til den korrekte port.
To nodes implementering
For denne konfiguration bruger vi præcis de samme serviceimplementeringer. Ingen ændringer overhovedet. Vi opretter dog to forskellige nodeimplementeringer, der indeholder forskellige sæt af tjenester:
  objekt TwoJvmNodeServerImpl udvider ZeroServiceImpl[IO] med EchoServiceService og SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] med SigTermLifecycleConfig
  }

  objekt TwoJvmNodeClientImpl udvider ZeroServiceImpl[IO] med EchoClientService og FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] med FiniteDurationLifecycleConfig
  }
Den første node implementerer serveren, og den har kun brug for serverside-konfiguration. Den anden node implementerer klienten og har brug for en anden del af konfigurationen. Begge noder kræver en form for livslang specification. Til formålene for denne post vil service node have en ubegribelig livslang, der kan afsluttes ved hjælp af SIGTERM, mens echo-klienten vil afslutte efter den konfigurerede finite varighed. Se ved for detaljer.
Den samlede udviklingsproces
Lad os se, hvordan denne tilgang ændrer den måde, vi arbejder med konfiguration.
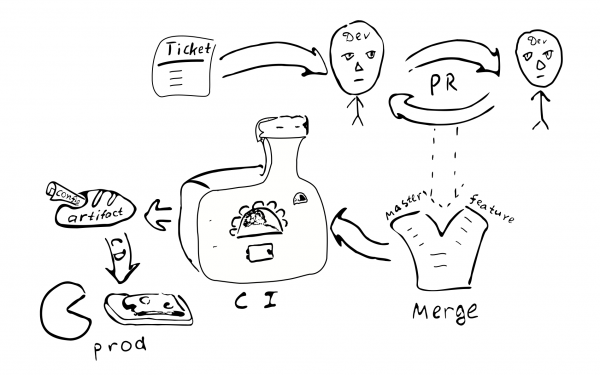
Konfigurationen som kode vil blive kompilert og producere en artefakt. Det virker rimeligt at adskille konfigurationsartefakten fra andre kodeartefakter. Ofte kan vi have mange konfigurationer på den samme kodebase. Og naturligvis kan vi have flere versioner af forskellige konfigurationsgrene. I en konfiguration kan vi vælge bestemte versioner af biblioteker, og denne vil forblive konstant, når vi implementerer denne konfiguration.
En konfigurationsændring bliver en kodeændring. Så den skal dækkes af den samme kvalitetssikring.
Ticket -> PR -> gennemgang -> sammenfletning -> kontinuerlig integration -> kontinuerlig implementering
Der er følgende konsekvenser af tilgangen:
- Konfigurationen er sammenhængende for en bestemt systeminstans. Det synes, at der ikke er nogen måde at have en forkert forbindelse mellem noder.
- Det er ikke nemt at ændre konfigurationen på blot én node. Det virker urimeligt at logge ind og ændre nogle tekstfiler. Så konfigurationsdrift bliver mindre mulig.
- Små konfigurationsændringer er ikke lette at foretage.
- De fleste af de konfigurationsændringer vil følge den samme udviklingsproces, og det vil gennemgå en eller anden form for anmeldelse.
Har vi brug for et separat repository til produktionskonfiguration? Produktionskonfigurationen kan indeholde følsomme oplysninger, som vi gerne vil holde uden for rækkevidde af mange mennesker. Så det kan være værd at holde et separat repository med begrænset adgang, der vil indeholde produktionskonfigurationen. Vi kan opdele konfigurationen i to dele - en der indeholder de fleste åbne parametre for produktionen og en der indeholder den hemmelige del af konfigurationen. Dette vil muliggøre adgang for de fleste udviklere til størstedelen af parametrene, samtidig med at adgangen til virkelig følsomme oplysninger begrænses. Det er nemt at opnå dette ved hjælp af mellemtræk med standardparameter værdier.
Variationer
Lad os se fordele og ulemper ved den foreslåede tilgang sammenlignet med andre teknikker til konfigurationsstyring.
Først og fremmest vil vi oplyse et par alternativer til de forskellige aspekter af den foreslåede måde at håndtere konfiguration på:
- Tekstfil på den målmaskine.
- Centraliseret nøgle-værdi lager (som
i den relevante Docker-container/zookeeper). - Underprocessorkomponenter, der kan omkonfigureres/genstartes uden at genstarte processen.
- Konfiguration uden for artifact og versionskontrol.
Tekstfil giver noget fleksibilitet med hensyn til ad-hoc reparationer. En systemadministrator kan logge ind på den målrettede node, foretage en ændring og simpelthen genstarte tjenesten. Dette er måske ikke så godt for større systemer. Ingen spor efterlades bag ændringen. Ændringen bliv ikke gennemgået af en anden, hvilket gør det svært at finde ud af, hvad der forårsagede ændringen. Det er ikke blevet testet. Fra et distribueret systems perspektiv kan en administrator simpelthen glemme at opdatere konfigurationen i en af de andre noder.
(I øvrigt, hvis der til sidst vil være behov for at begynde at bruge tekst konfigurationsfiler, skal vi kun tilføje en parser + validator, der kunne producere den samme Konfigurer type, og det ville være nok til at begynde at bruge tekstkonfigurationer. Dette viser også, at kompleksiteten ved compile-tids konfiguration er lidt mindre end kompleksiteten ved tekstbaserede konfigurationer, fordi vi i tekstversionen har brug for noget yderligere kode.)
Centraliseret nøgle-værdi lagring er en god mekanisme til distribution af applikations-meta parametre. Her skal vi tænke over, hvad vi betragter som konfigurationsværdier og hvad der bare er data. Givet en funktion C => A => B kalder vi normalt sjældent skiftende værdier C «konfiguration», mens hyppigt ændrede data A — blot inputdata. Konfiguration skal gives til funktionen før dataene A. Givet denne idé kan vi sige, at det er den forventede ændringsfrekvens, der kan bruges til at skelne konfigurationsdata fra blot data. Data kommer typisk fra en kilde (bruger), mens konfiguration kommer fra en anden kilde (administrator). At håndtere parametre, der kan ændres efter procesinitialisering, fører til en stigning i applikationens kompleksitet. For sådanne parametre må vi håndtere deres leveringsmekanisme, parsing og validering, håndtering af forkerte værdier. Derfor, for at reducere programmets kompleksitet, er det bedst at reducere antallet af parametre, der kan ændres i runtime (eller endda eliminere dem helt).
Fra dette indlægsperspektiv skal vi skelne mellem statiske og dynamiske parametre. Hvis service-logikken kræver sjældne ændringer af nogle parametre under kørsel, kan vi kalde dem dynamiske parametre. Ellers er de statiske og kan konfigureres ved hjælp af den foreslåede tilgang. For dynamisk rekonfiguration kan andre tilgange være nødvendige. For eksempel kan dele af systemet genstartes med de nye konfigurationsparametre på en måde, der ligner genstart af separate processer i et distribueret system.
(Min ydmyge mening er at undgå runtime-rekonfiguration, da det øger systemets kompleksitet.)
Det kan være mere ligetil bare at stole på OS-support til genstart af processer. Selvom det ikke altid er muligt.)
Et vigtigt aspekt ved at bruge statisk konfiguration, der nogle gange får folk til at overveje dynamisk konfiguration (uden andre grunde), er service-nedetid under konfigurationsopdatering. Hvis vi skal foretage ændringer i den statiske konfiguration, skal vi genstarte systemet, så de nye værdier træder i kraft. Kravene til nedetid varierer for forskellige systemer, så det er måske ikke så kritisk. Hvis det er kritisk, skal vi planlægge på forhånd for eventuelle systemgenstarter. For eksempel kunne vi implementere . I dette scenarie, når vi skal genstarte systemet, starter vi en ny instans af systemet parallelt, så skifter vi ELB til den, mens vi lader det gamle system afslutte servicerings eksisterende forbindelser.
Hvad med at holde konfigurationen inde i en versionsstyret artefakt eller udenfor? At holde konfigurationen inde i en artefakt betyder i de fleste tilfælde, at denne konfiguration har gennemgået den samme kvalitetssikringsproces som andre artefakter. Så man kan være sikker på, at konfigurationen er af god kvalitet og pålidelig. Omvendt betyder konfiguration i en separat fil, at der ikke er spor af, hvem og hvorfor der er foretaget ændringer til den fil. Er dette vigtigt? Vi mener, at det for de fleste produktionssystemer er bedre at have en stabil og høj kvalitet konfiguration.
Versionen af artefakten gør det muligt at finde ud af, hvornår den blev oprettet, hvilke værdier den indeholder, hvilke funktioner der er aktiveret/deaktiveret, og hvem der var ansvarlig for at foretage hver ændring i konfigurationen. Det kan kræve en del arbejde at holde konfigurationen inden i en artefakt, og det er et designvalg at træffe.
Fordele & ulemper
Her vil vi gerne fremhæve nogle fordele og diskutere nogle ulemper ved den foreslåede tilgang.
Fordele
Funktioner ved den kompilerbare konfiguration af et komplet distribueret system:
- Statisk kontrol af konfiguration. Dette giver et højt niveau af tillid til, at konfigurationen er korrekt givet de typebegrænsninger.
- Rigt konfigurationssprog. Typisk er andre konfigurationsmetoder begrænset til maksimalt variabel substitution.
Ved at bruge Scala kan man bruge et bredt udvalg af sprogfunktioner til at gøre konfigurationen bedre. For eksempel kan vi bruge traits til at give standardværdier, objekter til at sætte forskellige scopes, vi kan henvise tilvals defineret kun én gang i den ydre omverden (DRY). Det er muligt at bruge bogstavelige sekvenser eller instanser af visse klasser (Seq,Kort, osv.). - DSL. Scala har en god støtte til DSL-forfattere. Man kan bruge disse funktioner til at etablere et konfigurationssprog, der er mere bekvemt og brugervenligt, så den endelige konfiguration i det mindste er læsbar af domænebruger.
- Integritet og sammenhæng på tværs af noder. En af fordelene ved at have konfiguration til hele det distribuerede system ét sted er, at alle værdier er defineret strengt én gang og derefter genbrugt alle steder, hvor vi har brug for dem. Også typesikre portdeklarationer sikrer, at systemets noder i alle mulige korrekte konfigurationer taler det samme sprog. Der er eksplicitte afhængigheder mellem noder, hvilket gør det svært at glemme at levere nogle tjenester.
- Høj kvalitet af ændringer. Den overordnede tilgang til at videregive konfigurationsændringer gennem normal PR-proces fastlægger høje standarder for kvalitet også i konfiguration.
- Samtidig konfigurationsændringer. Hver gang vi foretager ændringer i konfigurationen, sikrer automatisk implementering, at alle noder opdateres.
- Forenkling af applikationen. Applikationen behøver ikke at analysere og validere konfigurationen og håndtere forkerte konfigurationsværdier. Dette forenkler den overordnede applikation. (Der er en vis stigning i kompleksiteten i selve konfigurationen, men det er et bevidst valg til fordel for sikkerhed.) Det er ret ligetil at vende tilbage til almindelig konfiguration — bare tilføj de manglende elementer. Det er lettere at komme i gang med den kompilerede konfiguration og udsætte implementeringen af yderligere dele til senere.
- Versioneret konfiguration. Da konfigurationsændringer følger den samme udviklingsproces, resulterer dette i et artefakt med en unik version. Det gør det muligt for os at skifte konfiguration tilbage, hvis det er nødvendigt. Vi kan endda implementere en konfiguration, der blev brugt for et år siden, og den vil fungere nøjagtig på samme måde. Stabil konfiguration forbedrer forudsigeligheden og pålideligheden af det distribuerede system. Konfigurationen er fastlagt ved kompileringstidspunktet og kan ikke let ændres på et produktionssystem.
- Modularitet. Den foreslåede ramme er modulær, og moduler kan kombineres på forskellige måder for
at støtte forskellige konfigurationer (opsætninger/layouts). Det er især muligt at have en lille skala enkelt-node opsætning og en stor skala multi-node opsætning. Det er rimeligt at have flere produktions-layouts. - Testning. Til testformål kan man implementere en mock-tjeneste og bruge den som en afhængighed på en type-sikker måde. Forskellige test-layouts med forskellige dele erstattet af mocks kunne opretholdes simultant.
- Integrationstest. Nogle gange er det vanskeligt at køre integrationstest i distribuerede systemer. Ved at bruge den beskrevne tilgang til type-sikker konfiguration af det komplette distribuerede system kan vi køre alle distribuerede dele på en enkelt server på en kontrollerbar måde. Det er nemt at efterligne situationen
når en af tjenesterne bliver utilgængelig.
Ulemper
Den kompilerede konfigurationsmetode adskiller sig fra "normal" konfiguration og passer måske ikke til alle behov. Her er nogle af ulemperne ved den kompilerede konfiguration:
- Statisk konfiguration. Det passer måske ikke til alle applikationer. I nogle tilfælde er der behov for hurtigt at rette konfigurationen i produktionen uden at gå igennem alle sikkerhedsforanstaltninger. Denne tilgang gør det vanskeligere. Kompilering og genimplementering er påkrævet efter enhver ændring i konfigurationen. Dette er både en funktion og en byrde.
- Generering af konfiguration. Når konfigurationen genereres af et automatiseringsværktøj, kræver denne tilgang efterfølgende kompilering (som igen kan fejle). Det kan kræve en ekstra indsats at integrere dette ekstra trin i byggesystemet.
- Værktøjer. Der findes mange værktøjer, der i dag er afhængige af tekstbaserede konfigurationer. Nogle af dem
vil ikke være anvendelige, når konfigurationen er kompilering. - Et skift i tankegangen er nødvendigt. Udviklere og DevOps er fortrolige med tekstkonfigurationsfiler. Ideen om at kompilere konfiguration kan virke underlig for dem.
- Før introduktion af kompilérbar konfiguration kræves en høj kvalitet softwareudviklingsproces.
Der er nogle begrænsninger ved det implementerede eksempel:
- Hvis vi leverer ekstra konfiguration, som ikke kræves af nodeimplementeringen, vil compileren ikke hjælpe os med at opdage den manglende implementering. Dette kan adresseres ved at bruge
HListeller ADTs (case-klasser) til nodekonfiguration i stedet for traits og Cake Pattern. - Vi skal give noget boilerplate i konfigurationsfilen: (
pakke,import,objektdeklarationer;
override def‘s for parametre, der har standardværdier). Dette kan delvist løses ved hjælp af en DSL. - I dette indlæg dækker vi ikke dynamisk rekonfiguration af klynger af lignende noder.
Konklusion
I dette indlæg har vi diskuteret idéen om at repræsentere konfiguration direkte i kildekoden på en typesikker måde. Denne tilgang kan anvendes i mange applikationer som en erstatning for XML- og andre tekstbaserede konfigurationer. Selvom vores eksempel er implementeret i Scala, kan det også oversættes til andre kompilérbare sprog (som Kotlin, C#, Swift osv.). Man kan prøve denne tilgang i et nyt projekt, og hvis den ikke passer godt, skifte til den gammeldags metode.
Selvfølgelig kræver kompilérbar konfiguration en høj kvalitets udviklingsproces. Til gengæld lover den at levere en lige så robust konfiguration af høj kvalitet.
Denne tilgang kan udvides på forskellige måder:
- Man kan bruge makroer til at udføre konfigurationsvalidisering og fejle ved kompileringstidspunktet i tilfælde af eventuelle forretningslogiske fejlsituationer.
- En DSL kunne implementeres for at repræsentere konfiguration på en måde, der er brugervenlig for domænebrugere.
- Dynamisk ressourcehåndtering med automatiske konfigurationjusteringer. For eksempel, når vi justerer antallet af kluster-knuder, ønsker vi måske (1) at knuderne får en lidt modificeret konfiguration; (2) at klusterchefen modtager nye knudeoplysninger.
Tak
Jeg vil gerne sige tak til Andrey Saksonov, Pavel Popov, Anton Nehaev for deres inspirerende feedback på udkastet til dette indlæg, som hjalp mig med at gøre det klarere.
Kilde: habr.com
