

Lad os diskutere, hvorfor CI-værktøjer og CI er helt forskellige.
Hvilket problem CI er tiltænkt at løse, hvor idéen stammer fra, hvilke seneste beviser der er for, at det fungerer, og hvordan man kan forstå, at man har praksis og ikke bare en installeret Jenkins.
Idéen om at holde et foredrag om Continuous Integration opstod for et år siden, da jeg var til samtaler for at finde et job. Jeg talte med 10-15 virksomheder, og kun én kunne forståeligt forklare, hvad CI er, og hvordan de indså, at de ikke havde det. De andre sagde uforståelige ting om Jenkins 🙂 Nå, vi har Jenkins, den laver builds, CI! I mit foredrag vil jeg forsøge at forklare, hvad Continuous Integration faktisk er, og hvorfor Jenkins og lignende værktøjer har en meget svag relation til det.
Så hvad kommer normalt i tankerne, når man hører ordet CI? For de fleste mennesker vil det være Jenkins, Gitlab CI, Travis osv.
Selv hvis vi googler, så vil vi få disse værktøjer op.
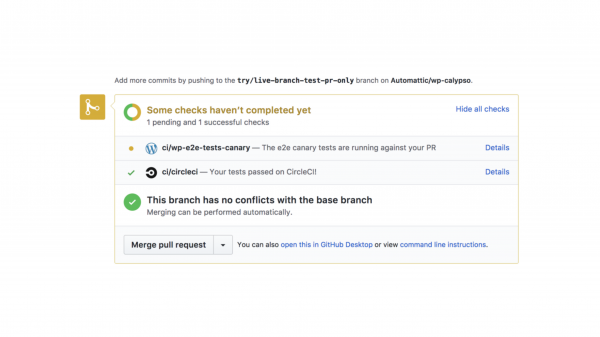
Hvis man spørger kendte, vil de straks efter at have nævnt værktøjerne fortælle, at CI er, når der sker builds og testkørsel i Pull Requests på commits.
Continuous Integration handler ikke om værktøjer, ikke om builds med tests i grenen! Continuous Integration er en praksis med meget hyppig integration af ny kode, og for at anvende det er det slet ikke nødvendigt at bygge Jenkins, GitLab osv.
Før vi dykker ned i, hvordan en fuld CI ser ud, lad os først se på konteksten af de mennesker, der fandt på det, og mærke den smerte, de forsøgte at løse.
De forsøgte at løse smerterne ved samarbejde i et team!
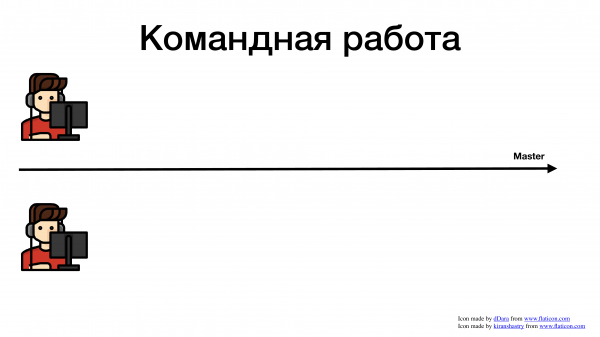
Lad os se på eksempler på, hvilke problemer udviklere oplever ved teamudvikling. Her har vi et projekt, master-grenen i git og to udviklere.
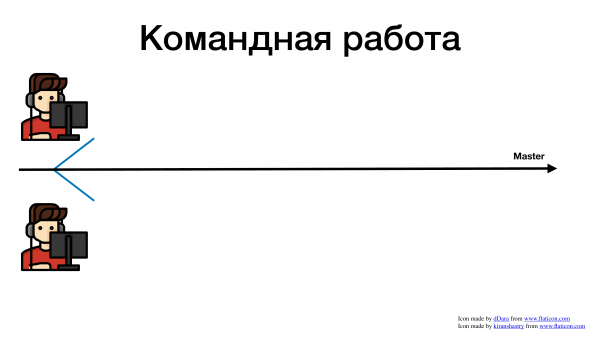
Og de gik i gang med at arbejde ligesom alle efterhånden er blevet vant til. De tog en opgave i JIRA, oprettede en feature-gren, og skrev kode.
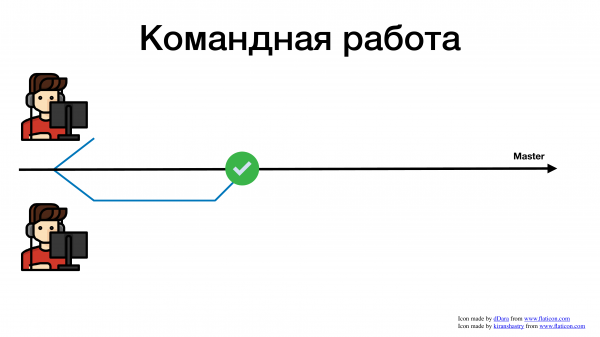
En af dem blev færdig med funktionen hurtigere og fusionerede den i master.
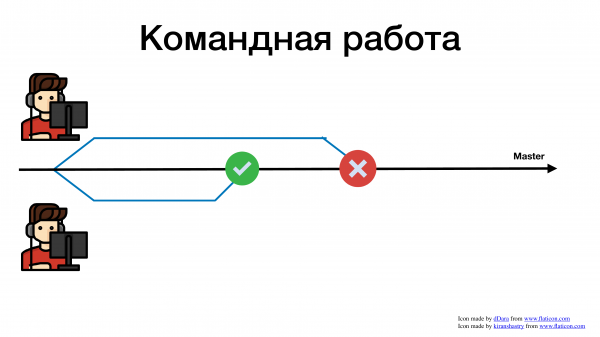
Den anden brugte mere tid, fusionerede senere og fik en konflikt. Nu, i stedet for at skrive de nødvendige funktioner til forretningen, bruger udvikleren sin tid og energi på at løse konflikter.
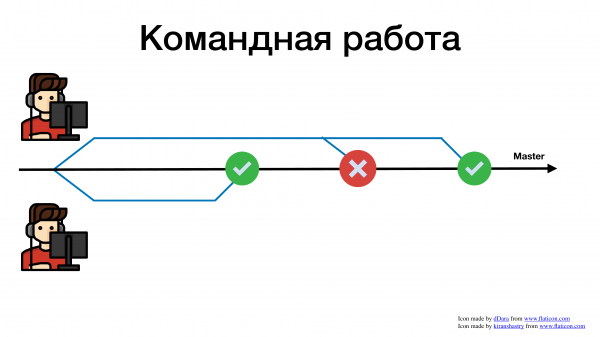
Jo mere komplekst det er at integrere din funktion med masteren, jo mere tid bruger vi på det. Og det er kun et ret simpelt eksempel. Dette eksempel involverer kun 2 udviklere. Forestil dig, hvis der er 10, 15 eller 100 personer i firmaet, der skriver i det samme repository. Du ville miste forstanden ved at løse alle disse konflikter.
Der er en lidt anderledes situation. Vi har en master og flere udviklere, der laver noget.
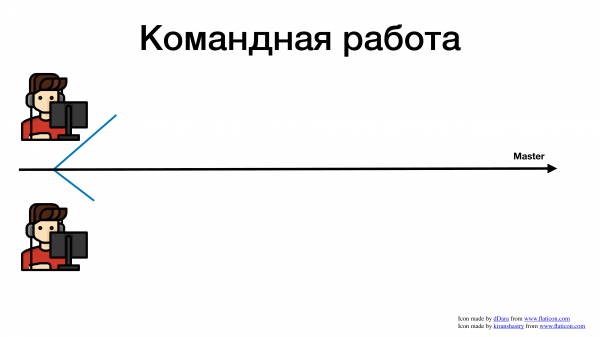
De har oprettet hver deres gren.
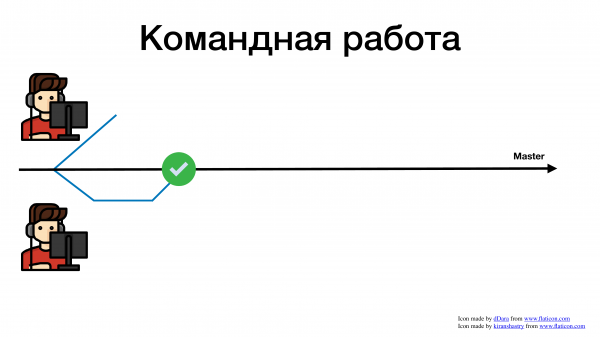
Én blev flettet ind, alt var godt, opgaven blev afleveret.
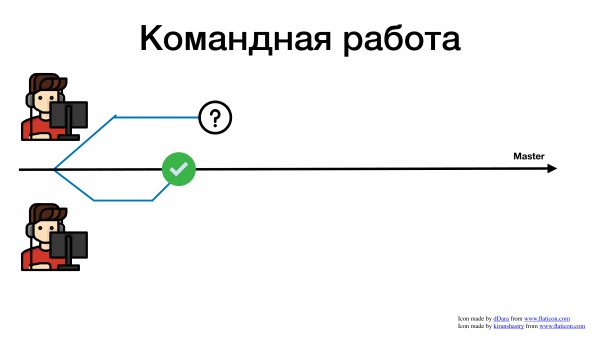
Den anden udvikler afleverede sin opgave imens. Antag, at han gav den til en gennemgang. I mange virksomheder er der en praksis – gennemgang. På den ene side er det en god og nyttig praksis, men på den anden side bremser det os ofte. Lad os ikke dykke dybere ned i det, men her er et glimrende eksempel på, hvorledes en skæv proces med gennemgang kan føre til komplikationer. Du har sendt en pull request til gennemgang. Den udvikler, der skal se på det, har ikke noget andet at lave. Hvad gør han? Han begynder at tage andre opgaver.
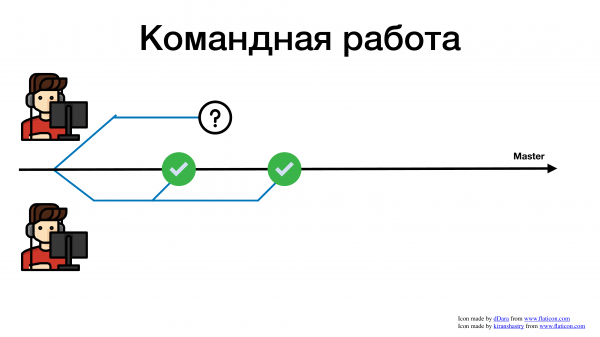
I mellemtiden har den anden udvikler også lavet noget.
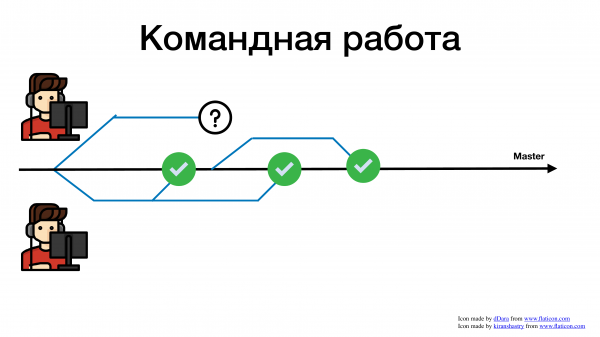
Den første udførte den tredje opgave.
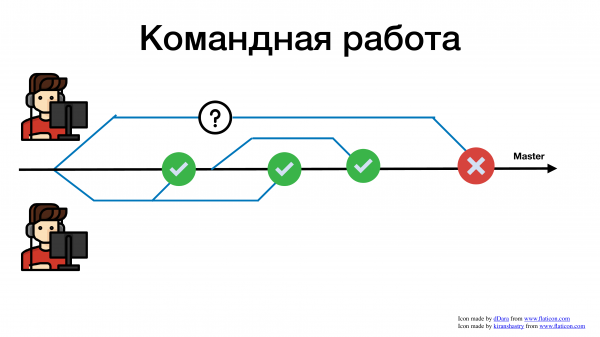
Og efter et stykke tid blev hans gennemgang lavet, og han prøver at flettes ind. Hvad sker der så? Han står over for et stort antal konflikter. Hvorfor? Fordi mens hans pull request var til gennemgang, er der allerede sket mange ændringer i koden.
Udover konflikten er der også kommunikationsproblemet. Mens din gren hænger til gennemgang, mens du venter, mens du arbejder længe på en funktion, mister du overblikket over, hvad der ellers ændrer sig i kodebasen for din service. Det er muligt, at det, du nu forsøger at løse, allerede blev løst i går, og du kunne tage og genbruge en metode. Men du vil ikke se det, fordi du altid arbejder med en forældet gren. Og denne forældede gren fører altid til, at du skal håndtere en merge-konflikt.
Så hvis vi arbejder i et team, dvs. ikke bare én person roder rundt i repositoryet, men 5-10 personer, så jo længere tid vi ikke tilføjer vores kode til masteren, jo mere lider vi af, at vi til sidst skal flette noget. Jo flere konflikter vi har, og jo ældre version vi arbejder med, desto flere problemer får vi.
At gøre noget sammen er smertefuldt! Vi forstyrrer altid hinanden.
Dette problem blev gjort opmærksom på for over 20 år siden. Jeg fandt den første omtale af praksis for Continuous Integration i ekstrem programmering.
Ekstrem programmering er den første agile ramme. Siden blev lanceret i 96, og ideen var at bruge nogle programmerings- og planlægningspraksisser for at gøre udviklingen så fleksibel som muligt, så vi hurtigt kunne reagere på ændringer og krav fra vores kunder. For 24 år siden begyndte de at indse, at hvis man arbejder med noget meget længe og sideløbende, bruger man mere tid, fordi der opstår konflikter.
Nu vil vi analysere udtrykket 'Continuous Integration' ord for ord. Hvis man oversætter direkte, får man kontinuerlig integration. Men hvor kontinuerlig den egentlig er, er ikke helt klart; den er faktisk meget afbrudt. Hvor meget den er integration, er heller ikke helt åbenbart.
Derfor giver jeg dig nu citater fra ekstrem programmering. Vi vil analysere de to ord hver for sig.
Integration — Som jeg allerede har sagt, stræber vi efter, at hver ingenør arbejder med den nyeste version af koden, så han ofte tilføjer sin kode til den fælles gren, så det bliver små grene. For hvis de er store, kan vi let sidde fast i en uge med merge-konflikter. Især hvis vi har en lang udviklingscyklus som vandfald, hvor udvikleren har været væk i en måned for at udvikle en kæmpestor funktion. Ved integrationsfasen kan han altså sidde fast i lang tid.
Integration – det er når vi tager vores gren og integrerer den med masteren, vi merge den. Der er en ultimativ mulighed, når vi transbase developer, hvor vi stræber efter at skrive direkte i master uden yderligere grene.
Generelt er integration at tage sin kode og bringe den ind i master.
Hvad menes der her med ordet "continuous", hvad kaldes kontinuitet? Praksis indebærer, at udvikleren stræber efter at integrere sin kode så hurtigt som muligt. Det er hans mål, når han udfører en hvilken som helst opgave – at få sin kode til at blive en del af masteren så hurtigt som muligt. I en ideel verden ville udviklerne gøre dette hvert par timer. Det vil sige, du tager en lille opgave og merger den ind i masteren. Alt er fantastisk. Du stræber efter dette. Og det skal gøres kontinuerligt. Så snart du har lavet noget, skal du straks få det ind i masteren.
Og udvikleren, der laver noget, er ansvarlig for det, han har lavet, så det fungerer og ikke ødelægger noget. Her dukker historien om tests normalt op. Vi ønsker at køre nogle tests på vores commit, på vores merge, for at sikre, at det fungerer. Og her kan Jenkins faktisk hjælpe dig.
Men med historierne: lad os sørge for, at ændringerne er små, lad os sørge for, at opgaverne er små, og lad os lave opgaven og straks forsøge at merge den ind i masteren – her vil ingen Jenkins kunne hjælpe. For Jenkins kan udelukkende hjælpe dig med at køre tests.
Du kan klare dig uden dem. Det vil ikke skade dig. For målet med praksis er at merge så ofte som muligt for ikke at bruge en stor mængde tid på konflikter i fremtiden.
Forestil dig, at vi i 2020 på en eller anden måde lever uden internet. Og vi arbejder lokalt. Vi har ikke Jenkins. Det er fint. Du kan stadig tage og lave en lokal gren. Du har skrevet noget kode i den. Udført opgaven på 3-4 timer. Skiftet til master, lavet git pull, og merged din gren ind. Klar. Hvis du gør dette ofte – tillykke, du har Continuous Integration!
Hvilke beviser findes der i den moderne verden om, at det er værd at investere kræfter i? Fordi det generelt er svært. Hvis du prøver at arbejde på denne måde, vil du indse, at du nu vil berøre en slags planlægning, og du må bruge mere tid på at dekomponere opgaver. For hvis du laver man…, så vil du ikke kunne merge hurtigt og dermed havne i problemer. Du vil ikke længere have praksis.
Og det vil blive dyrt. At begynde at arbejde med Continuous Integration fra i morgen vil ikke være muligt. I vil alle tage meget lang tid om at vænne jer til det, meget lang tid om at lære at nedbryde opgaver, meget lang tid om at vænne jer til at ændre review-praksis, hvis I har sådan en. Fordi vores mål er, at det skal merge i dag. Og hvis I bruger tre dage på review, så har I problemer, og så fungerer Continuous Integration ikke.
Men har vi nogle aktuelle beviser lige nu, der fortæller os, at det giver mening at investere i denne praksis?
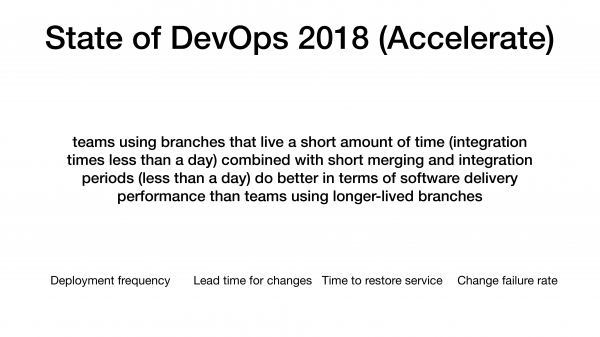
Det første, der kom til at tænke på, var State of DevOps. Dette er en undersøgelse, som folkene har udført i 7 år. Nu gør de det som en uafhængig organisation, men under Google.
Og deres undersøgelse i 2018 viste en korrelation mellem virksomheder, der forsøger at bruge kortlivede grene, som integreres hurtigt og ofte, de har bedre IT-ydeevnemålinger.
Hvad er disse målinger? Det er 4 metrikker, som de indsamler fra alle selskaber i deres spørgeskemaer: deployment frequency, lead time for changes, time to restore service, change failure rate.
Og for det første er der denne korrelation; vi ved, at virksomheder, der merger ofte, har disse metrikker meget bedre. Og de opdeler virksomhederne i flere kategorier: dette er langsomme virksomheder, der producerer noget langsomt, medium performer, high performer og elite. Eliten er Netflix, Amazon, som er superhurtige, gør alt hurtigt, smukt og kvalitetsfuldt.
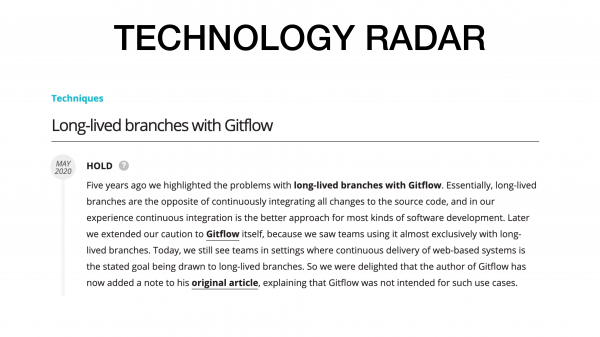
Den anden historie, der skete for bare en måned siden. I Technology Radar kom der en fantastisk note om Gitflow. Gitflow adskiller sig fra alle andre ved, at dets grene lever længe. Der er release-grene, der lever længe, og feature-grene, der også lever længe. Denne praksis i Technology Radar er blevet flyttet til HOLD. Hvorfor? Fordi folk oplever smerte i integrationen.
Hvis din gren lever meget længe, bliver den indviklet, forældes, og vi begynder at bruge mere tid på at foretage ændringer i den.
Og for nylig sagde forfatteren til Gitflow, at hvis du stræber efter Continuous Integration, hvis du ønsker at deploye så ofte som muligt, så er Gitflow en dårlig idé. Han tilføjede separat i artiklen, at hvis du har en backend, hvor du kan stræbe efter dette, så er Gitflow overflødigt for dig, fordi Gitflow vil bremse dig ned og skabe integrationsproblemer.
Det betyder ikke, at Gitflow er dårligt, og at man ikke skal bruge det. Det er til andre situationer. For eksempel, når du skal understøtte flere versioner af en service eller app, dvs. når du skal supportere i en længere periode.
Men hvis du snakker med folk, der understøtter sådanne tjenester, vil du høre meget om, at denne version var 3.2, som blev udgivet for 4 måneder siden, og at denne fix ikke kom med, og nu skal der laves en masse ændringer for at få det ind. Og nu er de igen fanget, og de kæmper i en uge for at få smeltet en ny funktion sammen.
Som Alexander Kovalev korrekt bemærkede i chatten, er korrelation ikke det samme som årsagssammenhæng. Det er korrekt. Det vil sige, der er ikke en direkte forbindelse, at hvis du har Continuous Integration, så vil alle metrics være fantastiske, nej. Men der er en positiv korrelation, at hvis det ene er tilfældet, så er det sandsynligvis tilfældet med det andet også. Ikke et faktum, men sandsynligvis. Det er kun en korrelation.
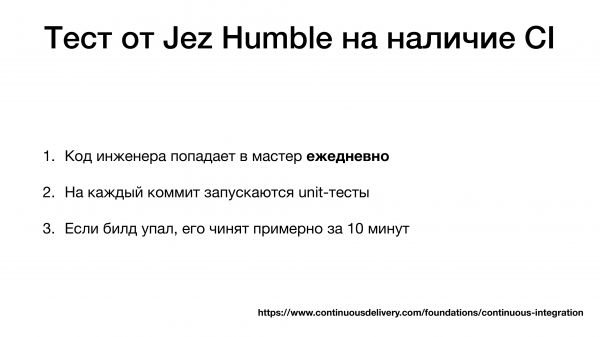
Det virker som om, vi allerede laver noget, vi er allerede i gang med at merge, men hvordan kan vi forstå, at vi faktisk har Continuous Integration, at vi mergeer ofte nok?
Jez Humble er forfatter til Handbook, Accelerate, hjemmesiden Continuous Delivery og bogen "Continuous Delivery". Han foreslår en test som denne:
- Ingeniørens kode går ind i master dagligt.
- For hver commit kører du unit-tests.
- Builden i master er faldet, og det blev fikset på cirka 10 minutter.
Han foreslår at anvende denne test for at sikre, at du faktisk har denne praksis.
Det sidste finder jeg lidt tvivlsomt. Det vil sige, hvis du kan løse det på 10 minutter, så har du Continuous Integration, hvilket lyder lidt underligt, efter min mening, men der er mening i det. Hvorfor? Fordi, hvis du ofte laver merges, betyder det, at dine ændringer er små. Hvis en lille ændring fører til, at din master-build går i stykker, kan du hurtigt finde et eksempel, fordi ændringen er lille. Du havde en lille merge, hvor 20-30 linjer blev ændret. Og derfor kan du hurtigt forstå årsagen, fordi ændringerne er meget små, og du har et meget lille søgeområde for problemet.
Og selv hvis vores prod går i stykker efter en release, så er det, hvis vi har praksis for Continuous Integration, meget lettere at handle, fordi ændringerne er små. Ja, det vil berøre planlægningen. Det vil være smertefuldt. Og nok det sværeste ved denne praksis er at vænne sig til at opdele opgaver, det vil sige, hvordan man tager noget og gør det på et par timer og samtidig gennemgår en review, hvis det er noget, du har. Review er en særskilt smerte.
Unit-tests er bare en hjælper, der hjælper dig med at forstå – om din integration er gået godt, om der ikke er noget, der er gået i stykker. Efter min mening er dette heller ikke en helt nødvendig punkt, fordi essensen af praksis ikke ligger i dette.
Det er kort om Continuous Integration. Det er alt, hvad der er i denne praksis. Jeg er klar til spørgsmål.
Kort opsummering:
- Continuous Integration er ikke Jenkins, det er ikke Gitlab.
- Det er ikke et værktøj, det er en praksis om, at vi så ofte som muligt merger vores kode ind i masteren.
- Vi gør dette for at undgå den enorme smerte, der opstår med merges i fremtiden, det vil sige, vi oplever lille smerte nu for ikke at opleve stor smerte senere. Det er hele meningen.
- Fra siden sker kommunikationen gennem koden, men jeg ser det meget sjældent, men det var også intentionen.
Spørgsmål
Hvad skal man gøre med uklare opgaver?
Decomponere. Hvad er problemet? Kan du give et eksempel på, at der er en opgave, som ikke kan dekomponeres?
Der er sådanne opgaver, som slet ikke kan dekomponeres, for eksempel dem, der kræver meget dyb ekspertise og som virkelig kan tage en måned at nå frem til et eller andet formålstjenligt resultat.
Hvis jeg forstår dig rigtigt, så er der en stor og kompleks opgave, hvis resultat først vil være synligt om en måned?
Ja, det er korrekt. Ja, resultatet kan først vurderes om en måned.
Okay. Generelt er det ikke et problem. Hvorfor? Fordi vi i dette tilfælde, når vi taler om grene, ikke taler om en gren med en funktion. Funktioner kan være store og komplekse. De kan involvere mange komponenter. Og måske kan vi ikke gøre dem helt i én gren. Det er helt i orden. Vi skal bare opdele denne historie. Hvis funktionen ikke er helt klar, betyder det ikke, at der ikke er dele af dens kode, der kan flettes. Du har f.eks. tilføjet migration, og der er nogle trin inden for funktionen. Du har f.eks. et trin – at lave migration, tilføje en ny metode. Og du kan allerede flette disse ting dagligt.
Okay. Hvad er så meningen med det?
Hvad er meningen med at flette små ting dagligt?
Ja.
Hvis de ødelagde noget for dig, ser du det straks. Du har et lille stykke, som ødelagde noget, det er nemmere at rette. Meningen er, at det i højere grad er lettere at flette et lille stykke nu end at flette noget stort om nogle uger. Den tredje pointe er, at andre ingeniører vil arbejde med den nuværende version af koden. De vil se, at nogle migrationer er blevet tilføjet her, og at der er en metode, som de måske også ønsker at bruge. Alle kan se, hvad der sker i din kode. Målet med disse tre ting er grundlaget for praksis.
Tak, spørgsmålet er afsluttet!
(Oleg Soroka) Må jeg tilføje noget? Du sagde det hele rigtigt, jeg vil kun tilføje en sætning.
Sådan.
Ved Continuous Integration fletter koden ikke i den samlede gren, når funktionen er helt klar, men når buildet ikke længere fejler. Og I kan roligt commite i master så mange gange om dagen, I vil. Det andet aspekt – hvis I ikke kan dele en måneds opgave op i opgaver på mindst tre dage, jeg nævner ikke engang tre timer, så har I et kæmpe problem. Og det faktum, at I ikke har Continuous Integration – er det mindste af disse problemer. Det betyder, at I har problemer med arkitekturen og ingeniørpraksisserne er på nul. Fordi selv hvis det er research, skal det stadig præsenteres som hypoteser eller cyklus.
Vi snakkede om 4 metrikker, der adskiller succesfulde virksomheder fra de mindre heldige. Det kræver tid at nå disse 4 metrikker. Hvis en opgave tager en måned, ville jeg fokusere på at få den ned på 3 dage først. Efter det kan du begynde at tænke på Continuous.
Forstår jeg dig korrekt, at du mener, det ikke giver mening at investere i ingeniørpraksis, hvis enhver opgave tager en måned?
Du har Continuous Integration. Og der er en ting med, at du enten retter en fejl på 10 minutter eller ruller tilbage. Forestil dig, at du har udgivet det. Og du har endda continuous deployment, du har udgivet det til produktion og bemærkede først bagefter, at noget gik galt. Og nu skal du rulle det tilbage, men du har allerede gennemført database-migrering. Din databaseskema er allerede i den næste version, desuden er der endda blevet udført en backup, og der er blevet skrevet data ind.
Hvad er dit alternativ? Hvis du ruller koden tilbage, kan den ikke længere fungere med denne opdaterede database.
Databasen bevæger sig kun fremad, ja.
For folk med dårlig ingeniørpraksis har de sandsynligvis ikke engang læst den tykke bog om ... Hvad gør man med backup? Hvis du gendanner fra en backup, betyder det, at du mister de data, der er blevet indhentet i mellemtiden. For eksempel, hvis du har arbejdet i tre timer med den nye version af databasen, og brugerne har registreret sig. Du går tilbage til den gamle backup, fordi skemaet ikke fungerer med den nye version, hvilket betyder, at de brugere er mistet. Og de er utilfredse, de klager.
For mastering the full range of practices that support Continuous Integration and Continuous Delivery, it's not enough to just learn to write code. First of all, there can be a lot of them, which would be impractical. In addition, there are many other practices like Scientific. There's a practice that GitHub popularized for a time, where you can run both the old code and the new code simultaneously. This is when you implement an unfinished feature, but it can still return some value, either as a function or as a REST API. You run both the new code and the old code and compare the differences between them. If there's a difference, you log that event. This way you know that your new feature is ready to be rolled out over the old one if there have been no discrepancies between the two for a certain period of time.
There are hundreds of such practices. I would suggest starting with transbase development. It’s not 100% on Continuous Integration, but the practices are the same; one does not live well without the other.
Did you mention transbase development as an example of where to look for practices, or are you suggesting that people should start using transbase development?
Look at it since they won’t be able to use it. To use it, one needs to read a lot. And when the question arises, 'What to do with a feature that takes a month?', it means that they haven't read about transbase development. I wouldn’t recommend it just yet. I would advise focusing solely on the topic of how to properly architecturally break down large tasks into smaller ones. That’s the essence of decomposition.
Decomposition is one of the architect's tools. We first perform analysis, then decomposition, followed by synthesis and finally integration. This way everything comes together. One must grow towards Continuous Integration through decomposition. Questions arise at the first stage, and yet we are already talking about the fourth stage, meaning the more often integration is done, the better. It’s still a bit premature to do it; it wouldn't hurt to first break down your monolith.
Der skal tegnes nogle pile og firkanter på en eller anden skema. Du kan ikke sige, at jeg nu vil vise et arkitektonisk skema for den nye applikation og vise én firkant, hvor der er en grøn knap til applikationen. Under alle omstændigheder vil der være flere firkanter og pile. På ethvert skema, jeg har set, har der været mere end én. Og dekompositionen foretages allerede på niveauet for grafisk repræsentation. Derfor kan firkanterne være uafhængige. Hvis ikke, så har jeg store spørgsmål til arkitekten.
Der er et spørgsmål fra chatten: "Hvis review er obligatorisk og tager lang tid, omkring en dag eller mere?".
I har problemer med praksis. Review bør ikke tage en dag eller mere. Det er den samme historie som det tidligere spørgsmål, bare lidt blødere. Hvis review tager en dag, så betyder det sandsynligvis, at det er et meget stort ændringsreview. Så det skal gøres mindre. I transbase-udviklingen, som Oleg anbefalede, er der en historie, der kaldes kontinuerlig review. Idéen er, at vi laver så små pull requests som muligt bevidst, fordi vi stræber efter konstant at merge lidt ad gangen. Derfor ændrer pull requesten kun én abstraktion eller 10 linjer. Takket være dette tager vores review et par minutter.
Hvis review tager en dag eller mere, betyder det, at der er noget galt. For det første kan det være, at I har problemer med arkitekturen. Enten er det et stort kodeafsnit på 1.000 linjer, for eksempel. Eller jeres arkitektur er så kompleks, at personen ikke kan forstå den. Det er et problem, men det må også løses. Måske behøver I slet ikke at have review. Dette skal også overvejes. Review er der, der holder jer tilbage. Det har sine fordele generelt, men I skal forstå, hvorfor I gør det. Er det en måde at hurtigt overføre information på? Er det en måde at etablere nogle standarder internt? Hvad er formålet? Fordi review skal enten være meget hurtig, eller helt annulleres. Det er ligesom transbase-udvikling - en meget smuk historie, men kun for modne folk.
Angående de 4 metrikker, vil jeg anbefale at tage dem ned for at forstå, hvad det fører til. Se på tallene, se på billedet, hvor slemt det hele er.
(Dmitrij) Jeg er klar til at deltage i diskussionen om dette emne med dig. Tallene og målingerne er alle gode, praksis er også god. Men vi skal forstå, om dette er nødvendigt for forretningen. Der er virksomheder, der ikke har brug for sådan en hurtig ændringshastighed. Jeg kender virksomheder, hvor man ikke kan foretage ændringer hver 15. minut. Og ikke fordi de er dårlige. Det er en del af livscyklussen. Og for at lave feature branches, feature toggles, kræver det dyb viden.
Det er svært. Hvis du vil læse mere om historien bag feature toggles, anbefaler jeg stærkt. . Og der er en fantastisk artikel af Martin Fowler om feature toggles: om de forskellige typer, livscykler osv. Feature toggle er komplekst.
Og du svarede stadig ikke på spørgsmålet: "Er Jenkins nødvendigt eller ej?"
Jenkins er faktisk ikke nødvendigt i nogen tilfælde. Hvis jeg skal være alvorlig, så vil værktøjerne: Jenkins, Gitlab give dig bekvemmelighed. Du vil kunne se, om bygningen lykkedes eller ej. De kan hjælpe dig, men de vil ikke give dig praksis. De kan kun give dig en cirkel – Ok, ikke Ok. Og det, hvis du stadig skriver tests, for hvis der ikke er tests, er det stort set meningsløst. Så det er nødvendigt, fordi det er mere praktisk, men generelt kan man klare sig uden det, du vil ikke miste meget.
Det vil sige, hvis du har praksis, så er det ikke nødvendigt for dig?
Helt korrekt. Jeg anbefaler testen af Jez Humble. Jeg har en blandet følelse over for det sidste punkt. Men generelt, hvis du har tre ting, du merger konstant, du kører tests på commits i masteren, hurtigt reparerer builden i masteren, så er det muligt, at du ikke har brug for mere.
Mens vi venter på spørgsmål fra deltagerne, har jeg et spørgsmål. Vi har lige talt om produktionskoden. Har du brugt det til infrastrukturskode? Er det samme kode, med de samme principper og livscyklus, eller er der andre livscykler og principper? Normalt, når alle taler om Continuous Integration og Development, glemmer folk ofte, at der også er infrastrukturskode. Og i den seneste tid bliver det mere og mere vigtigt. Bør vi bringe alle disse regler derind?
Det er ikke bare, at vi bør, det ville være fantastisk, fordi det helt sikkert også vil forenkle livet. Så snart vi arbejder med kode, ikke med scripts i bash, men vi har normal kode.
Stop-stop, skripter i bash er også kode. Lad være med at røre ved min gamle kærlighed.
Det er fint, jeg vil ikke træde ind i dine minder. Jeg har en personlig modvilje mod bash. Det går ofte galt på en grim og skræmmende måde. Og det går ofte uforudsigeligt galt, så jeg har ikke meget kærlighed til det. Men ok, lad os antage, at du har kode i bash. Måske forstår jeg ikke det, og der findes gode testframeworks der. Jeg er bare ikke i det. Og vi får de samme fordele.
Når vi arbejder med infrastruktur som kode, får vi de samme problemer som udviklere. For et par måneder siden stod jeg i en situation, hvor en kollega sendte mig en pull request på 1.000 linjer i bash. Og du sidder fast i gennemgangen i 4 timer. Problemerne er de samme. Det er stadig kode. Og det er stadig samarbejde. Vi sidder fast med pull requests og sidder fast med de samme merge-konflikter i bash, for eksempel.
Jeg ser i øjeblikket meget aktivt på at lave smuk infrastrukturprogrammering. Jeg har nu fået Pulumi ind i infrastrukturen. Det er ren programmering. Det er endnu mere tiltalende, fordi jeg har alle mulighederne fra programmeringssproget, dvs. jeg har lavet smukke toggles med de samme if'er. Dvs. min ændring er allerede i masteren. Alle kan se det. Andre ingeniører er opmærksomme på det. Det har allerede haft indflydelse på noget. Men det er ikke slået til for al infrastruktur. Det er slået til for mine testmiljøer, for eksempel. Så for at svare på dit spørgsmål igen, ja, det er noget, der bestemt gør vores liv lettere som ingeniører, der arbejder med kode.
Er der nogen spørgsmål endnu?
Jeg har et spørgsmål. Jeg vil gerne fortsætte diskussionen med Oleg. Generelt mener jeg, at du har ret; hvis en opgave tager dig en måned, så har du et problem med arkitekturen, et problem med analysen, dekomponeringen, planlægningen osv. Men jeg får det indtryk, at hvis du begynder at leve efter Continuous Integration, så vil du begynde at løse problemerne med planlægningen, fordi du ikke kan undgå det.
(Oleg) Ja, det er korrekt. Med hensyn til arbejdsbyrden er denne praksis sammenlignelig med enhver anden alvorlig praksis, der ændrer kulturen. Den sværeste del ved at overvinde dette er vaner, især dårlige vaner. Og hvis det kræver en betydelig ændring af vanerne hos de omkringliggende: udviklere, ledelse, produktionschefer, så vil du møde overraskelser.
Hvilke overraskelser kan der være? Antag, at du har besluttet dig for at lave integration oftere. Og integrationen er knyttet til nogle andre ting, som for eksempel artefakter. Og i din virksomhed er der for eksempel en politik om, at hvert artefakt skal registreres på en eller anden måde i et system til opbevaring af artefakter. Det tager noget tid. En person skal sætte en markering for, at han som release manager har testet dette artefakt til klarhed til produktion. Hvis det tager 5-10-15 minutter, men du laver en udrulning én gang om ugen, så er det ikke al for stor en skat at bruge en halv time på det en gang om ugen.
Hvis du laver Continuous Integration 10 gange om dagen, skal du gange 10 med 30 minutter. Og det overstiger den arbejdsbyrde, som denne release manager har. Han bliver simpelthen træt af det. Der er faste omkostninger ved visse praksisser. Og det hele.
Og du skal enten ophæve denne regel, så du ikke beskæftiger dig med sådan noget fis, dvs. du tildeler ikke manuelt en grad af overensstemmelse fra noget til noget. Du stoler helt og holdent på et eller andet automatiseret testset til klarhed.
Og hvis du har brug for nogen til at give dig et bevis, så chefen underskriver, og du ikke går ind i produktion uden at Vasja har sagt, at han giver tilladelse osv. – alt denne fis står i vejen for praksisser. Fordi hvis der er aktiviteter, der er forbundet som en skat, så bliver alt 100 gange sværere. Derfor vil et skift ofte ikke blive positivt modtaget af alle. Fordi det er svært at ændre folks vaner.
Når en person udfører sit sædvanlige arbejde, gør han det praktisk talt uden at tænke over det. Den kognitive belastning er nul. Han arbejder blot på det færdige, han har allerede en tjekliste i hovedet, han har gjort dette tusind gange. Og så snart du kommer og siger til ham: «Lad os opsige denne praksis og fra mandag implementere en ny», bliver det en stor kognitiv belastning for ham. Og denne belastning træder straks i kraft for alle.
Derfor er det enkleste, men sandt, at ikke alle har råd til denne luksus, men jeg gør det altid sådan. Hvis et nyt projekt starter, presses som regel alle uafprøvede praksisser ind i dette projekt. Mens projektet stadig er ungt, risikerer vi ikke meget. Der er ingen produktion, der er ikke noget at ødelægge. Så denne metode kan bruges som træning. Denne tilgang virker. Men ikke alle virksomheder har mulighed for ofte at starte sådanne projekter. Selv om det også er lidt mærkeligt, fordi der er masser af digital transformation lige nu, og alle bør eksperimentere for at følge med konkurrenterne.
Her støder man på det faktum, at man først skal have en forståelse af, hvad man skal gøre. Verden er ikke perfekt, produktion er heller ikke perfekt.
Ja, disse ting er indbyrdes forbundet.
Virksomheden har heller ikke altid en forståelse af, at de skal bevæge sig i den retning.
Der er situationer, hvor ingen ændringer er mulige overhovedet. Det er en situation, hvor teamet oplever større pres. Teamet er allerede temmelig udbrændt. De har ikke noget overskud af tid til eksperimenter. De arbejder fra morgen til aften med at udvikle funktioner. Og ledelsen kræver stadig flere funktioner. Der kræves mere og mere. I en sådan situation er der overhovedet ikke mulighed for nogen ændringer. Teamet kan kun få besked på, at i morgen skal vi gøre som i går, vi skal bare lave lidt flere funktioner. Ingen overgange til nogen praksisser er i denne forstand mulige. Det er en klassisk situation, hvor der ikke er tid til at slibe øksen, man skal fælde træer, og derfor fælder man med en stump økse. Her er der ingen nemme løsninger.
(Dmitry) Jeg vil læse en præcisering fra chatten: "Men der er behov for stor testdækning på forskellige niveauer. Hvor meget tid bruges der på tests? Det virker lidt dyrt og tager meget tid."
(Oleg) Det er en klassisk misforståelse. Der skal være tilstrækkeligt med tests, så du selv har tillid. Continuous Integration er ikke sådan noget, hvor 100 % af tests skal være klar, før du begynder at anvende denne praksis. Continuous Integration reducerer din kognitive belastning, fordi hver ændring, du kan se, er så åbenlys, at du forstår, om den vil bryde noget eller ej, selv uden tests. Du kan hurtigt teste det mentalt, fordi ændringerne er små. Selv hvis du kun har manuelle testere, er det også lettere for dem. Du ruller det ud og siger: "Tjek, er der noget, der er brudt?" De tjekker og siger: "Nej, der er ikke brudt noget." Fordi testeren ved, hvor de skal se. Du har én commit, der er relateret til ét stykke kode. Og det eksploderer med en bestemt opførsel.
Her har du selvfølgelig lidt pyntet på det.
(Dmitry) Her er jeg ikke enig. Der findes en praksis – testdrevet udvikling, som netop kan redde dig fra dette.
(Oleg) Jeg er ikke nået dertil endnu. Den første illusion er, at man skal skrive 100 % tests eller slet ikke beskæftige sig med Continuous Integration. Det er forkert. Det er to parallelle praksisser. Og de afhænger ikke direkte af hinanden. Din testdækning skal være optimal. Optimal betyder, at du selv er sikker på, at den kvalitet, som din master har efter commit, giver dig tillid til at trykke på "Deploy"-knappen fredag aften, selv når du er påvirket. Hvordan når du dertil? Gennem review, gennem dækning, gennem god overvågning.
God overvågning er ikke til at skelne fra tests. Hvis du kører tests én gang på pre prod, så tjekker de alle dine bruger-scenarier én gang og så er det det. Men hvis du kører dem i en uendelig løkke, er det dit udvidede overvågningssystem, der konstant tester – om systemet er nede eller ej. I dette tilfælde er forskellen kun i engangs- eller gentagne tests. Et meget godt sæt tests…, der køres uendeligt, er egentlig overvågning. Og korrekt overvågning skal være sådan.
Og derfor, hvordan du præcist når til den tilstand, hvor du deployer fredag aften og så går hjem, er et andet spørgsmål. Måske er du bare en modig skrædder.
Lad os gå lidt tilbage til Continuous Integration. Vi er trådt ind i en anden kompleks praksis.
Og den anden illusion er, at MVP'en, det siges, skal laves hurtigt, og derfor er tests slet ikke nødvendige. Det er ikke helt korrekt. Når du skriver user stories til din MVP, kan du lave dem enten på en impulsiv måde, dvs. høre om en user story og straks begynde at kode den, eller arbejde efter TDD. Og ifølge erfaringerne fra TDD tager det ikke længere tid, så tests er bare et biprodukt. TDC-praksis handler ikke om at teste. Selvom det kaldes Test Driven Development, omhandler det slet ikke tests. Det er snarere en arkitektonisk tilgang. Det handler om, hvordan man skriver det, der er nødvendigt, og ikke skriver det, der ikke er nødvendigt. Denne praksis fokuserer på den næste iteration af din tankegang i forhold til at skabe appens arkitektur.
Derfor er det ikke så let at slippe af med disse illusioner. MVP og tests modsætter ikke hinanden. Tværtimod, hvis du laver din MVP efter TDD-praksis, vil du gøre det bedre og hurtigere, end hvis du gør det uden praksis, på impuls.
Det er en meget uheldig og kompleks tanke. Når du hører, at jeg nu også skal skrive tests og alligevel vil gøre noget hurtigere, lyder det helt usandsynligt.
(Dmitry) Mange, når de taler om MVP, er bare for dovne til at skrive noget ordentligt. Og det er trods alt forskellige ting. Man skal ikke gøre MVP til noget dårligt, der ikke fungerer.
Ja, du har ret.
Og så pludselig MVP i produktion.
For altid.
Og TDD lyder meget uvant, når man hører, at du skriver tests, og tilsyneladende laver mere arbejde. Det lyder meget mærkeligt, men i virkeligheden går det hurtigere og ser bedre ud. Når du skriver en test, tænker du allerede meget over, hvilken kode der skal bruges, hvordan den vil blive kaldt, og hvilken adfærd vi forventer af den. Du siger ikke bare, at jeg har skrevet en funktion, og den gør noget. Du overvejer først, hvilke betingelser den har, og hvordan den vil blive kaldt. Du dækker det med tests, og ud fra dette forstår du, hvordan dine interfaces i koden vil se ud. Det har en stor indflydelse på arkitekturen. Din kode bliver automatisk mere modulær, fordi du først prøver at forstå, hvordan du vil teste den, og først derefter skriver du den.
Jeg har haft det sådan med TDD, at jeg på et tidspunkt hyrede en mentor til Ruby, da jeg stadig var Ruby-udvikler. Og han sagde: „Lad os gøre det med TDD.” Jeg tænkte: „Åh nej, skal jeg skrive noget ekstra.” Vi blev enige om, at jeg i løbet af to uger skulle skrive al min funktionelle kode på Python med TDD. Efter to uger indså jeg, at jeg ikke ville tilbage. Efter at have forsøgt at anvende det overalt i to uger, forstår man, hvor meget lettere det er at tænke klart. Men det er ikke indlysende, så jeg anbefaler alle, at hvis I føler, at TDD er kompliceret, tidskrævende og unødvendigt, så prøv at holde fast i det i bare to uger. To uger var tilstrækkeligt for mig.
(Dmitrij) Vi kan udfolde denne tanke fra et perspektiv af infrastrukturdrift. Før vi starter noget nyt, udfører vi overvågning og derefter lancerer vi. I dette tilfælde bliver vores overvågning en normal testning. Og der er udvikling gennem overvågning. Men næsten alle siger, at det er tidskrævende, jeg orker ikke det, jeg lavede et midlertidigt udkast. Hvis vi udfører overvågningen ordentligt, forstår vi tilstanden af CI-systemet. Og der er meget overvågning i CI-systemet. Vi forstår systemets tilstand, vi forstår, hvad der foregår inden i det. Og under udviklingen laver vi netop systemet, så det når den ønskede tilstand.
Disse praksisser har været kendt i lang tid. Vi diskuterede det for omkring 4 år siden. Men på de 4 år er der næsten ikke sket nogen forandringer.
Men på denne note vil jeg foreslå, at vi afslutter den officielle diskussion.
Video (indsat som et medieelement, men af en eller anden grund fungerer det ikke):
Kilde: habr.com
