

Hvilke principper bygger det perfekte Data Warehouse på?
Fokus på forretningsværdi og analyse uden boilerplate-kode. Håndtering af DWH som en kodebase: versionering, review, automatisk test og CI. Modularitet, udvidelighed, open source og fællesskab. Brugervenlig dokumentation og visualisering af afhængigheder (Data Lineage).
Lad os dykke dybere ned i det hele og i DBT's rolle i Big Data & Analytics-økosystemet — velkommen under cut.
Hej alle sammen
Det er Artyom Kozyr her. Jeg har arbejdet med data warehousing i over 5 år, har arbejdet med ETL/ELT-opbygning samt dataanalyse og visualisering. I øjeblikket arbejder jeg hos , underviser i OTUS på kurset , og i dag vil jeg gerne dele en artikel, jeg har skrevet i anledning af starten på et nyt hold til kurset.
Kort oversigt
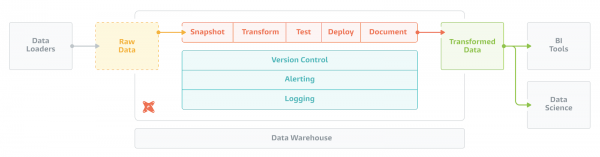
DBT-rammen handler om bogstavet T i akronymet ELT (Extract — Transform — Load).
Med fremkomsten af sådan højtydende og skalerbare analytiske databaser som BigQuery, Redshift, Snowflake er der ikke længere nogen mening i at foretage transformationer uden for Data Warehouset.
DBT eksporterer ikke data fra kilder, men giver enorme muligheder for at arbejde med de data, der allerede er indlæst i Warehouse (i Internal eller External Storage).
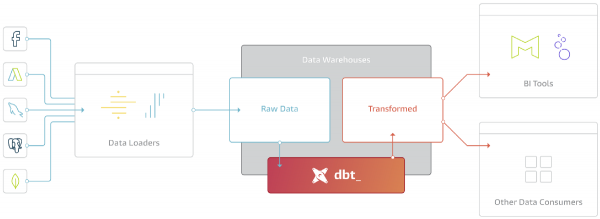
Hovedformålet med DBT er at tage koden, kompilere den til SQL og udføre kommandoer i den rigtige rækkefølge i Warehouse.
Strukturen af DBT-projektet
Projektet består af to typer mapper og filer:
- Model (.sql) — en enhed af transformation, udtrykt som en SELECT-forespørgsel
- Konfigurationsfil (.yml) — parametre, indstillinger, tests, dokumentation
På et grundlæggende niveau arbejder det således:
- Brugeren forbereder modelkoden i en hvilken som helst praktisk IDE
- Ved hjælp af CLI startes modellerne, DBT kompilerer modelkoden til SQL
- Den komprimerede SQL-kode udføres i Warehouse i den angivne rækkefølge (graf)
Sådan kan starten fra CLI se ud:
Alt er SELECT
Dette er killer-funktionen i Data Build Tool-rammen. Med andre ord abstraherer DBT al kode relateret til materialisering af dine forespørgsler i Warehouset (variationer af kommandoerne CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, …).
Enhver model indebærer at skrive en enkelt SELECT-forespørgsel, der definerer det resulterende datasæt.
Logikken bag transformationerne kan være flertals- og konsolidere data fra flere andre modeller. Et eksempel på en model, der bygger en ordnebutik (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Hvad interessant kan vi se her?
For det første: CTE (Common Table Expressions) anvendes — for at organisere og forstå kode, der indeholder mange transformationer og forretningslogik.
For det andet: Modelkoden er en blanding af SQL og (templating language).
Eksemplet benytter en løkke til for at danne summen for hver betalingsmetode, der er angivet i udtrykket set. Funktionen ref — muligheden for at henvise til andre modeller i koden:
- Under kompileringen ref vil den blive omdannet til en målrettet pegepind til en tabel eller visning i depotet
- ref muliggør opbygning af en afhængighedsgraf for modellerne
Det tilføjer næsten ubegrænsede muligheder i DBT. De mest almindeligt anvendte er:
- If / else udsagn — vejledningsoperatorer
- For løkker — cykler
- Variabler — variable
- Makro — oprettelse af makroer
Materialisering: Tabel, Visning, Inkrementel
Materialiseringsstrategi — en tilgang, hvor datasættet, der er resultatet af modellen, vil blive gemt i depotet.
I en grundlæggende betragtning er dette:
- Tabel — en fysisk tabel i depotet
- Visning — en visning, en virtuel tabel i depotet
Der er også mere komplekse materialiseringsstrategier:
- Inkrementel — inkrementel indlæsning (af store faktatabeller); nye rækker tilføjes, ændrede opdateres, slettede fjernes
- Ephemeral — modellen materialiseres ikke direkte, men deltager som CTE i andre modeller
- Alle andre strategier, du selv kan tilføje
Ud over materialiseringsstrategier åbner muligheder for optimering mod specifikke depot, for eksempel:
- Snowflake: Transient tables, Merge behavior, Table clustering, Copying grants, Secure views
- Redshift: Distkey, Sortkey (interleaved, compound), Late Binding Views
- BigQuery: Table partitioning & clustering, Merge behavior, KMS Encryption, Labels & Tags
- Spark: Filformat (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
På nuværende tidspunkt understøttes følgende lagre:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (delvist)
- Spark (delvist)
- Microsoft SQL Server (community adapter)
Lad os forbedre vores model:
- Gør dens fyldning inkrementel (Incremental)
- Tilføj segmenterings- og sorteringsnøgler til Redshift
-- Modelkonfiguration:
-- Inkrementel fyldning, unik nøgle til opdatering af poster (unique_key)
-- Segmenteringsnøgle (dist), sorteringsnøgle (sort)
{{
  config(
        materialized='incremental',
        unique_key='order_id',
        dist="customer_id",
        sort="order_date"
    )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Denne filter vil kun blive anvendt for inkrementel opstart
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Modelafhængighedernes graf
Det er også træet for afhængigheder. Det er også DAG (Directed Acyclic Graph — Retningsbestemt Acyklisk Graf).
DBT bygger grafen baseret på konfigurationen af alle projektmodeller, mere præcist henvisningerne ref() inden for modellerne til andre modeller. Tilstedeværelsen af grafen muliggør følgende:
- Kørsel af modeller i korrekt rækkefølge
- Parallelisering af opbygningen af vitrinene
- Kørsel af en vilkårlig undergraf
Eksempel på visualisering af grafen:
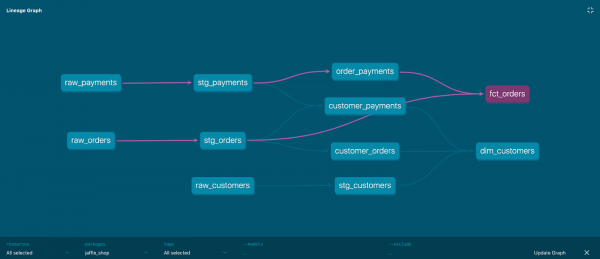
Hver node i grafen er en model, kanterne i grafen defineres ved udtrykket ref.
Datakvalitet og Dokumentation
Udover at danne selve modellerne, giver DBT mulighed for at teste en række antagelser (assertions) om det resulterende datasæt, såsom:
- Not Null
- Unique
- Reference Integrity — referentiel integritet (for eksempel, customer_id i orders-tabellen svarer til id i customers-tabellen)
- Overensstemmelse med listen over tilladte værdier
Mulighed for at tilføje egne tests (custom data tests), såsom procentdelen af afvigelse i indtægter med værdier fra dagen, ugen, måneden før. Enhver antagelse, der er formuleret som en SQL-forespørgsel, kan blive en test.
På den måde kan man fange uønskede afvigelser og fejl i dataene i lagervitrinerne.
Hvad angår dokumentation, tilbyder DBT mekanismer til at tilføje, versionere og distribuere metadata og kommentarer på modelniveau og endda på attributniveau.
Sådan ser det ud, når man tilføjer tests og dokumentation på konfigurationsfilens niveau:
 - name: fct_orders
   description: Denne tabel indeholder grundlæggende oplysninger om ordrer samt nogle afledte fakta baseret på betalinger
   columns:
     - name: order_id
       tests:
         - unique # test for unikhed af værdier
         - not_null # test for tilstedeværelse af null
       description: Dette er et unikt id for en ordre
     - name: customer_id
       description: Fremmed nøgler til kunder-tabellen
       tests:
         - not_null
         - relationships: # test for referentiel integritet
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Dato (UTC) hvornår ordren blev afgivet
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # test for tilladte værdier
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
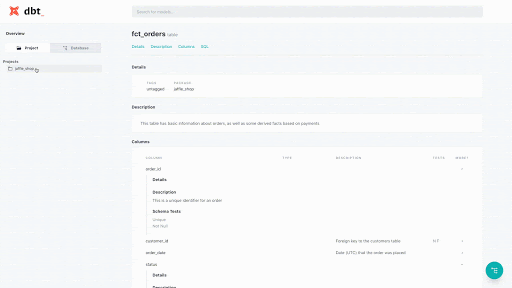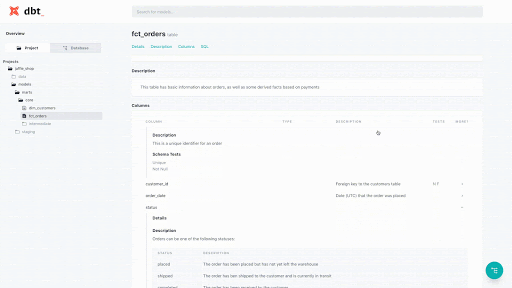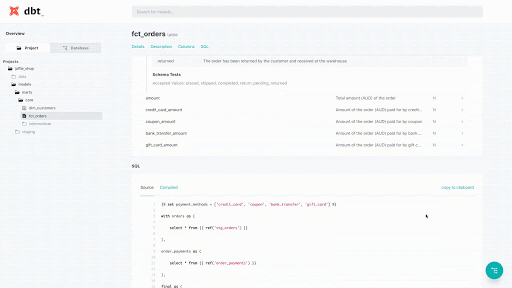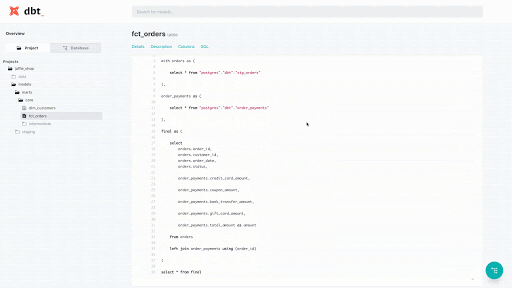
Og sådan ser denne dokumentation ud på den genererede hjemmeside:
Makroer og Moduler
Formålet med DBT er ikke kun at blive et sæt SQL-scripts, men at give brugerne kraftfulde og funktionelle værktøjer til at bygge deres egne transformationer og distribuere disse moduler.
Makroer er sæt af konstruktioner og udtryk, der kan kaldes som funktioner inden for modellerne. Makroer muliggør genbrug af SQL mellem modeller og projekter i overensstemmelse med ingeniørprincippet DRY (Don’t Repeat Yourself).
Eksempel på en makro:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike '%osx%' then 'osx'
 when {{ column_name }} ilike '%android%' then 'android'
 when {{ column_name }} ilike '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
Og dens anvendelse:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- kald af makroen
from my_table
DBT leveres med en pakke manager (packages), der gør det muligt for brugerne at publicere og genbruge individuelle moduler og makroer.
Dette betyder muligheden for at downloade og bruge biblioteker som:
- : arbejde med dato/tid, surrogate nøgler, skema-tests, pivot/unpivot og andre
- Færdige skabeloner til datalager som: og
- Biblioteker til specifikke datalagre, fx
- — Modul til logging af DBT-arbejde
Den komplette liste over pakker kan findes på .
Endnu flere muligheder
Her vil jeg beskrive nogle andre interessante funktioner og implementationer, som jeg og teamet bruger til at bygge Data Warehouse i .
Opdeling af driftsmiljøer DEV — TEST — PROD
Selv inden for en enkelt DWH-kluster (i forskellige skemaer). For eksempel med følgende udtryk:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Denne kode siger bogstaveligt: for miljøerne dev, test, ci tag kun data for de sidste 3 dage og ikke mere. Det vil sige, at kørsel i disse miljøer vil være meget hurtigere og kræve færre ressourcer. Når det køres i miljøet prod vil filterbetingelsen blive ignoreret.
Materialisering med alternativ kolonnekomprimering
Redshift er en kolonnedatabase, der tillader indstilling af komprimeringsalgoritmer for hver enkelt kolonne. Valg af optimale algoritmer kan reducere den optagne plads på disken med 20-50%.
Makro vil udføre ANALYZE COMPRESSION-kommandoen, oprette en ny tabel med de anbefalede kolonnekomprimeringsalgoritmer, specificerede segmenteringsnøgler (dist_key) og sorteringsnøgler (sort_key), overføre dataene til den, og om nødvendigt slette den gamle kopi.
Makros signatur:
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Logning af modeludførelse
For hver udførelse af en model kan du tilføje hooks, som vil blive udført før eller straks efter oprettelsen af modellen:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
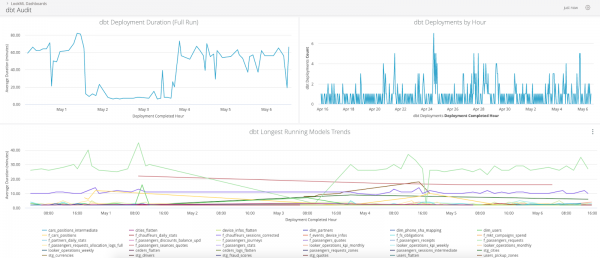
Logningsmodulet vil gøre det muligt at registrere alle nødvendige metadata i en separat tabel, som senere kan bruges til at udføre revision og analysere problemområder (bottlenecks).
Her er, hvordan dashboardet for logdata ser ud i Looker:
Automatisering af vedligeholdelse af Data Warehouse
Hvis du bruger nogle udvidelser til funktionaliteten af det anvendte Data Warehouse, såsom UDF (User Defined Functions), så er versionering af disse funktioner, adgangsstyring og automatisering af udgivelser af nye versioner meget praktisk at udføre i DBT.
Vi bruger UDF i Python til at beregne hash-værdier, domæner for e-mailadresser og dekode bitmasker.
Eksempel på en makro, der opretter UDF i enhver kørsel (dev, test, prod):
{% macro create_udf() -%}

  {% set sql %}
        CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
            RETURNS varchar
            LANGUAGE plpythonu
            STABLE
        AS $$
            import hashlib
            return hashlib.sha256(mes).hexdigest()
        $$
        ;
  {% endset %}

  {% set table = run_query(sql) %}

{%- endmacro %}
Hos Wheely bruger vi Amazon Redshift, der er baseret på PostgreSQL. For Redshift er det vigtigt regelmæssigt at samle statistik om tabeller og frigøre plads på disken — henholdsvis kommandoerne ANALYZE og VACUUM.
For dette køres der hver nat kommandoer fra makroen redshift_maintenance:
{% macro redshift_maintenance() %}

   {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

   {% for row in vacuumable_tables %}
       {% set message_prefix=loop.index ~ " of " ~ loop.length %}

       {%- set relation_to_vacuum = adapter.get_relation(
                                       database=row['table_database'],
                                       schema=row['table_schema'],
                                       identifier=row['table_name']
                                   ) -%}
       {% do run_query("commit") %}

       {% if relation_to_vacuum %}
           {% set start=modules.datetime.datetime.now() %}
           {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
           {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
           {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
           {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
           {% set end=modules.datetime.datetime.now() %}
           {% set total_seconds = (end - start).total_seconds() | round(2)  %}
           {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
       {% else %}
           {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
       {% endif %}

   {% endfor %}

{% endmacro %}
DBT Cloud
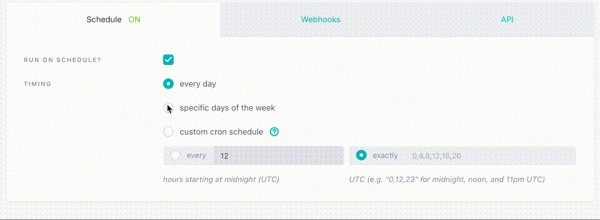
Der er mulighed for at bruge DBT som en service (Managed Service). Inkluderet:
- Web IDE til udvikling af projekter og modeller
- Konfiguration af jobs og planlægning
- Nem og bekvem adgang til logs
- Hjemmeside med dokumentation for dit projekt
- Tilslutning af CI (Continuous Integration)
Konklusion
At forberede og anvende DWH bliver ligeså behageligt og gavnligt som at drikke smoothies. DBT består af Jinja, brugerdefinerede udvidelser (moduler), en kompilator, en motor (executor) og en pakkemanager. Når du samler disse elementer, får du et fuldt fungerende arbejdsmiljø for dit Data Warehouse. Der er næppe en bedre måde at håndtere transformationer inden for DWH på i dag.
Overbevisningerne, som DBT-udviklerne følger, formuleres således:
- Kode, ikke GUI, er den bedste abstraktion til at udtrykke kompleks analytisk logik.
- Arbejdet med data skal tilpasse de bedste praksisser inden for softwareudvikling (Software Engineering).
- Den vigtigste infrastruktur til databehandling bør kontrolleres af brugerfællesskabet som open source-software.
- Ikke kun analyseværktøjer, men også kode vil i stigende grad blive public domain for Open Source-fællesskabet.
Disse grundlæggende overbevisninger har givet anledning til et produkt, der i dag anvendes i mere end 850 virksomheder, og de danner grundlaget for mange interessante udvidelser, der vil blive skabt i fremtiden.
For dem, der er interesserede, er der en videoptagelse af den åbne lektion, jeg holdt for nogle måneder siden i forbindelse med den åbne lektion i OTUS — .
Udover DBT og Data Warehouses underviser jeg og mine kolleger i en række andre relevante og moderne emner i forbindelse med Data Engineer-kurset på OTUS-platformen:
- Arkitektoniske koncepter for Big Data-applikationer.
- Praktisk anvendelse af Spark og Spark Streaming.
- Undersøgelse af metoder og værktøjer til indlæsning af datakilder.
- Opbygning af analytiske datavarehuse i DWH.
- NoSQL-koncepter: HBase, Cassandra, ElasticSearch.
- Principper for organisation af overvågning og orkestrering.
- Afsluttende projekt: samler alle færdigheder under mentorens støtte.
Links:
- — Officiel dokumentation.
- — Oversigtsartikel af en af forfatterne til DBT.
- — YouTube, Optagelse af den åbne lektion i OTUS.
- — Næste åbne lektion 15. maj 2020.
- — OTUS.
- — Et blik på fremtiden for databehandling og analyse.
- — Evolutionen af analyse og indflydelse fra Open Source.
- — Principper for opbygning af CI ved brug af DBT.
- — Praktisk, trin-for-trin vejledning til selvstændig anvendelse.
- — Github, kode til læringsprojektet
Kilde: habr.com
