

Hej, Habr! Vi i Dodo Pizza Engineering elsker data (hvem gør ikke det nu om dage?). Nu vil jeg fortælle en historie om, hvordan man indsamler al data fra Dodo Pizza og giver enhver medarbejder i virksomheden nem adgang til denne store mængde data. Opgaven med stjerner: at bevare nervefreden i Data Engineering-teamet.
Som ægte Plyushkin'er samler vi al mulig information om driften af vores pizzerier:
- vi husker alle kundeordrer;
- vi ved, hvor lang tid det tog at lave den allerførste pizza i Syktyvkar;
- vi ser, hvor lang tid pizzaen står og afkøler på varmereolen i Voronezh lige nu;
- vi opbevarer data om spild af råvarer;
- og meget, meget mere.
Flere teams håndterer data i Dodo Pizza, og et af dem er Data Engineering-teamet. I øjeblikket står vi (det vil sige os) over for opgaven: at give enhver medarbejder nem adgang til denne store mængde data.
Da vi begyndte at tænke på, hvordan vi kunne gøre det, og diskuterede opgaven, fandt vi en meget interessant tilgang til datastyring - (du kan finde en kæmpe fantastisk artikel via linket). Dens ideer passede rigtig godt ind i vores forestilling om, hvordan vi ønsker at opbygge vores system. I den følgende tekst vil vi dele vores omfortolkning af tilgangen og hvordan vi ser dens implementering i Dodo Pizza Engineering.
Hvad mener vi med 'data'
For at starte lad os definere, hvad vi forstår ved data i Dodo Pizza Engineering:
- Begivenheder, som tjenester sender (vi har en fælles bus bygget med RabbitMQ);
- Poster i databasen (for os er det MySQL og CosmosDB);
- Clickstream fra mobilappen og hjemmesiden.
For at Dodo Pizza's forretning kan bruge disse data og stole på dem, er det vigtigt, at følgende betingelser er opfyldt:
- De skal være komplette. Vi skal være sikre på, at vi ikke ændrer dataene under behandlingen, opbevaringen og visningen. Hvis forretningen ikke kan stole på vores data, vil de være værdiløse.
- De skal have et tidsstempel og må ikke blive overskrevet. Det betyder, at vi til enhver tid ønsker at kunne gå tilbage og se de data fra den tidsperiode. For eksempel finde ud af, hvor mange pizzaer der blev solgt den 8. juli 2018.
- De skal være pålidelige. I dataindsamlingen og -opbevaringen må vi ikke kun miste integritet, men også pålidelighed. Vi kan ikke miste data og tidsvinduer, for sammen med dem mister vi tilliden fra vores kunder (både interne og eksterne).
- De skal have en stabil struktur – vi skriver forespørgsler til disse data. Vi ville virkelig ikke vil have, at ændringer i applikationskoden, med refaktorering, ændrede dem så, at vores forespørgsler stoppede med at fungere. Den, der skriver forespørgsler, vil aldrig vide, at du foretog en refaktorering, før alt går galt. Vi ville ikke gerne finde ud af det fra kunderne.
I betragtning af alle disse krav er vi nået frem til, at data i Dodo er et produkt. Ligesom den offentlige API for tjenesten. Derfor skal det samme team, der ejer tjenesten, også eje dataene. Desuden skal ændringer i datastrukturen altid være bagudkompatible.
Den traditionelle tilgang – Data Lake
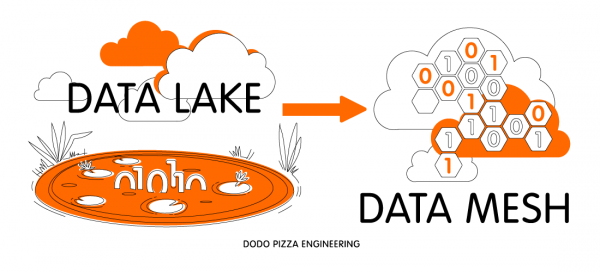
Til løsning af opgaver om pålidelig opbevaring og behandling af big data findes der en traditionel tilgang, der anvendes i mange virksomheder, som arbejder med denne informationsmængde – Data Lake. I denne tilgang indsamler datateknikere information fra alle systemets komponenter og opbevarer dem i et stort lager (det kan være, for eksempel, Hadoop, Azure Kusto, Apache Cassandra eller endda en MySQL-replika, hvis data kan passe ind i den).
Derefter skriver de samme ingeniører forespørgsler til et sådant lager. Implementeringen af denne tilgang i Dodo Pizza Engineering indebærer, at Data Engineering-teamet ejer datastrukturen i det analytiske lager.
I dette udviklingsscenarie bliver teamet meget triste katte, og her er hvorfor:
- De skal holde øje med ændringerne i ALLE tjenesterne inden for virksomheden. Og der er mange tjenester, og der har været mange ændringer (gennemsnitligt fusionerer vi ~100 pull requests om ugen, mens mange tjenester slet ikke laver pull requests).
- Når datastrukturen ændres, skal produktlederen og teamet, der ændrer datastrukturen, vente, indtil Data Engineering skriver den nødvendige kode, så ændringerne kan understøttes. Vi har længe haft funktionen, og situationen, hvor ét team venter på et andet, er meget sjælden. Og vi ønsker ikke, at det skal blive en 'normal' del af udviklingsprocessen.
- De skal være dybt involveret i HELE virksomheden. En kæde af pizzeriaer kan virke som en simpel forretning, men det er kun ved første øjekast. Det er meget svært at samle tilstrækkelige kompetencer i ét team til at opbygge en passende datamodel for hele virksomheden.
- Det udgør et enkelt fejlpunk. Hver gang, der skal ændres data, som tjenesten returnerer, eller der skal skrives en forespørgsel, bliver alle disse opgaver sendt til Data Engineering-teamet. Resultatet er, at teamet har en overbelastet backlog.
Det viser sig, at teamet befinder sig i krydsfeltet for et enormt antal behov, og det er usandsynligt, at de kan imødekomme dem. De vil dog konstant være under tidspres og stress. Vi ønsker bestemt ikke dette. Derfor må vi overveje, hvordan man kan løse disse problemer og samtidig få mulighed for at analysere data.
Fra Data Lake til Data Mesh
Heldigvis har ikke kun vi stillet dette spørgsmål. Faktisk er et lignende problem allerede blevet løst i industrien (halleluja!). Men inden for et andet område: deployment af applikationer. Ja, jeg taler om DevOps-metoden, hvor teamet bestemmer, hvordan de skal implementere det produkt, de skaber.
En tilsvarende tilgang til at løse Data Lake-problemer blev foreslået af Zhamak Dehghani, konsulent hos ThoughtWorks. Ved at observere, hvordan virksomheder som Netflix og Spotify løser sådanne opgaver, skrev hun en fantastisk artikel (linken til den var i begyndelsen af artiklen). De vigtigste ideer, vi har taget med os fra den:
- Opdel en stor Data Lake i datadomæner, som ligner domænerne i domain-driven design. Hvert domæne er en lille bounded context.
- Feature Teams, der ansvarer for DDD-domæner, står også ansvarligt for de tilsvarende datadomæner. De opbevarer skemaet, foretager ændringer i det og indlæser data i det. De ved alt om, hvordan man ændrer dataindlæsningen uden at bryde noget, når applikationen ændres. Viden forsvinder ikke. For at tilgå data har de ikke brug for at gå et andet sted hen. Selve teamet styrer hele udviklingscyklussen fra ændring af operationelle data til at levere analytiske data til tredjepart. Én team ejer alt, hvad der relaterer sig til domænet (både forretningsdomænet og datadomænet).
- Data Engineer – en rolle inden for Feature Team. Det skal ikke nødvendigvis være en separat person, men det er nødvendigt, at teamet besidder denne kompetence.
Og imens arbejder Data Engineering-teamet...
Hvis man forestiller sig, at alt dette kan gennemføres ved et fingerknips, er der kun to spørgsmål tilbage at besvare:
Hvad skal Data Engineering-teamet beskæftige sig med nu? I Dodo Pizza Engineering er der allerede et platform-/SRE-team. Deres opgave er at give udviklerne værktøjer til nemt at distribuere tjenester. Data Engineering-teamet vil udføre en lignende rolle, men for data.
At omdanne operationelle data til analytiske data er en kompleks proces. At gøre de analytiske data tilgængelige for hele virksomheden er endnu sværere. Det er netop disse problemer, Data Engineering-teamet vil arbejde med.
Vi planlægger at give Feature Team et praktisk sæt værktøjer og metoder, så de kan offentliggøre data fra deres tjeneste til resten af virksomheden. Vi vil også stå for de fælles infrastrukturelle dele af data-pipelinen (køer, pålidelig opbevaring, klynger til databehandling).
Hvordan vil Data Engineer-færdighederne komme til udtryk i Feature Team? Det er mere kompliceret med Feature Team. Selvfølgelig kunne vi forsøge at ansætte en Data Engineer til hvert af vores teams. Men det er meget vanskeligt. At finde en person med en god baggrund inden for datahåndtering og overbevise dem om at arbejde i et produktteam er udfordrende.
En stor fordel ved Dodo er, at vi værdsætter intern træning. Så lige nu er vores plan, at Data Engineering-teamet begynder at offentliggøre data fra nogle tjenester, klager, lider, men fortsætter med at spise kaktussen. Så snart vi forstår, at vi har en klar proces til offentliggørelse, begynder vi at dele denne viden med Feature Team.
Vi har flere måder, hvorpå vi kan gøre dette:
- , hvor vi vil forklare, hvordan processen, vi har skabt, ser ud, hvilke værktøjer der er tilgængelige, og hvordan de kan bruges mest effektivt.
- Et oplæg på DevForum vil hjælpe os med at indsamle feedback fra produktudviklerne. Derefter kan vi tilslutte os produktteamene og hjælpe dem med at løse opgaver relateret til dataoffentliggørelse og organisere træning for teamene.
Dataforbrug
Jeg har nu talt meget om dataoffentliggørelse. Men der er også dataforbrug. Hvad med det?
Vi har et fantastisk BI-team, der skriver meget komplekse rapporter til ledelsesselskabet. Inden for Dodo IS er der mange rapporter til vores partnere, som hjælper dem med at administrere pizzarierne. I vores nye model tænker vi på dem som datakonsumenter, der har deres egne datadomæner. Og det er netop forbrugerne, der vil være ansvarlige for deres egne domæner. Nogle gange kan forbrugerens domæne beskrives med en enkelt forespørgsel i datalageret – og det er fint. Men vi forstår, at det ikke altid vil fungere. Derfor ønsker vi, at den platform, vi bygger til produktteams, også kan bruges af datakonsumenter (for i tilfælde af rapporterne inden for Dodo IS vil det være de samme teams).
Sådan ser vi på arbejdet med data i Dodo Pizza Engineering. Vi ser frem til at læse dine tanker om dette i kommentarerne.
Kilde: habr.com
