

SQL, hvad kan være lettere? Hver af os kan skrive en simpel forespørgsel — vi indtaster select, angiver de nødvendige kolonner, så fra, tabelnavnet, lidt betingelser i where og det hele — de nyttige data har vi i lommen, næsten uafhængigt af hvilken DBMS der er under hætten (eller måske endda ). Som resultat kan arbejdet med næsten enhver datakilde (relationel og ikke så meget) betragtes ud fra synspunktet om almindelig kode (med alle konsekvenserne — versionskontrol, kodegennemgang, statisk analyse, automatiserede tests og alt det dér). Og dette gælder ikke kun selve dataene, skemaer og migrationer, men for hele datalagerets liv. I denne artikel vil vi diskutere daglige opgaver og problemer med at arbejde med forskellige databaser under objektivet "database as code".
Og lad os starte lige med . De første kampe mellem "SQL vs ORM" blev observeret allerede i .
Objekt-relationel mapping
Tilhængere af ORM værdsætter traditionelt hastighed og enkelhed i udviklingen, uafhængighed fra DBMS og kodekvalitet. For mange af os ser koden til at arbejde med databaser (og ofte selve databasen)
som regel ud omtrent sådan her...
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Modellen er udstyret med smarte annotationer, og et sted backstage genererer og udfører den tapre ORM ton af SQL-kode. For øvrigt forsøger udviklerne med alle midler at afskærme sig fra deres DB med kilometer af abstraktioner, hvilket indikerer en form for .
På den anden side af barrikaden bemærker tilhængere af rent "handmade"-SQL muligheden for at presse alt ud af deres DB uden yderligere lag og abstraktioner. Som resultat opstår der "data-centric" projekter, hvor databaser håndteres af specielt uddannede personer (de er også kendt som "database-nørder", "database-experter", "database-specialister", osv.), mens udviklerne kun skal "kalde" færdige views og gemte procedurer uden at dykke ned i detaljerne.
Hvad hvis vi tager det bedste fra begge verdener? Hvordan dette er gjort i det fantastiske værktøj med den livsbekræftende titel . Jeg vil give et par linjer fra den overordnede koncept i min frie oversættelse, og mere om den kan man læse .
Clojure er et fantastisk sprog til at skabe DSL'er, men SQL er allerede selv et fremragende DSL, og vi har ikke brug for endnu et. S-expressioner er smukke, men her tilføjer de ikke noget nyt. I sidste ende får vi blot parenteser for parentesernes skyld. Er du uenig? Så vent, indtil abstraktionen over databasen begynder at lække, så du kan starte kampen med funktionen. (raw-sql)
Hvad skal vi så gøre? Lad os holde SQL som almindelig SQL — én fil pr. forespørgsel:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… og læs derefter denne fil, og gør den til en almindelig Clojure-funktion:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; En funktion med navnet `users-by-country` er blevet oprettet.
;;; Lad os bruge den:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Ved at følge princippet "SQL adskilt, Clojure adskilt" får du:
- Ingen syntaktiske overraskelser. Din database (som enhver anden) overholder ikke SQL-standarden 100% — men for Yesql er det ikke vigtigt. Du vil aldrig spilde tid på at lede efter funktioner med syntaks svarende til SQL. Du vil aldrig være nødt til at vende tilbage til funktionen (raw-sql "some (‘funky’ :: SYNTAX)")).
- Bedre editorstøtte. Din editor har allerede fremragende understøttelse af SQL. Ved at holde SQL som SQL kan du bare bruge det.
- Kompatibilitet med teamet. Dine DBA'er kan læse og skrive SQL, som du bruger i dit Clojure-projekt.
- Enklere performanceoptimering. Skal du opbygge en plan for en problematisk forespørgsel? Det er ikke et problem, når din forespørgsel er almindelig SQL.
- Genbrug af forespørgsler. Træk disse samme SQL-filer til andre projekter, fordi det blot er den gode gamle SQL — bare del dem.
For mig er idéen både rigtig cool og meget simpel, hvilket har givet projektet en masse på mange forskellige sprog. Vi vil forsøge at anvende en tilsvarende filosofi, der adskiller SQL-kode fra alt det andet, langt ud over ORM.
IDE & DB- managers
Lad os starte med en simpel, dagligdags opgave. Vi skal ofte finde objekter i databasen, for eksempel finde en tabel i et skema og undersøge dens struktur (hvilke kolonner, nøgler, indekser, begrænsninger osv. der bruges). Og fra enhver grafisk IDE eller en hvilken som helst DB-manager forventer vi først og fremmest netop disse funktioner. Det skal være hurtigt, uden at vi skal vente en halv time på, at vinduet med de nødvendige oplysninger dukker op (især ved en langsom forbindelse til en fjern database), og samtidig skal oplysningerne være friske og aktuelle, ikke cachede gamle data. Desuden, jo mere kompleks og større databasen er, og jo flere databaser der er, jo sværere bliver det at gøre dette.
Men normalt lægger jeg musen væk og skriver bare koden. Lad os sige, at vi skal finde ud af, hvilke tabeller (og med hvilke egenskaber) der findes i skemaet "HR". I de fleste databasesystemer kan man opnå det ønskede resultat med denne enkle forespørgsel fra information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Indholdet af sådanne reference-tabeller varierer fra database til database afhængigt af hver databasesystems kapaciteter. For eksempel, for MySQL kan man fra den samme reference få specifikke parametre for denne database:
select table_name
     , storage_engine -- Den anvendte "motor" ("MyISAM", "InnoDB" osv.)
     , row_format     -- Row format ("Fixed", "Dynamic" osv.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle bruger ikke information_schema, men har derimod , og der opstår ikke store problemer:
select table_name
     , pct_free       -- Minimum fri plads i datablokken (%)
     , pct_used       -- Minimum brugt plads i datablokken (%)
     , last_analyzed  -- Dato for sidste statistiksamling
     , ...
  from all_tables
 where owner = 'HR'
ClickHouse er ikke en undtagelse:
select name
     , engine -- Den anvendte "motor" ("MergeTree", "Dictionary" osv.)
     , ...
  from system.tables
 where database = 'HR'
Noget lignende kan gøres i Cassandra (hvor der er columnfamilies i stedet for tabeller og keyspaces i stedet for skemaer):
select columnfamily_name
     , compaction_strategy_class  -- Affaldssamlingsstrategi
     , gc_grace_seconds           -- Affalds livstid
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
For de fleste andre databaser kan man også konstruere lignende forespørgsler (selv i Mongo findes der , som indeholder information om alle kollektioner i systemet).
Selvfølgelig kan man på denne måde få information ikke kun om tabeller, men faktisk om enhver objekt. Periodisk deler venlige mennesker sådan kode til forskellige databaser, som for eksempel i serien af Habr-artikler "Funktioner til dokumentation af PostgreSQL-databaser" (, , ). Selvfølgelig er det
ikke særlig sjovt at holde denne enorme bunke forespørgsler i hovedet og konstant indtaste dem, så i min yndlings IDE/redigeringsværktøj har jeg et forudbestemt sæt snippets til ofte brugte forespørgsler, og jeg skal blot indtaste navne på objekter i skabelonen. ).
"Eksport af data fra databasen i ethvert format: hvad IDE'er på IntelliJ-platformen kan"
Operationer med objekter
Efter at vi har fundet og studeret de nødvendige objekter, er det på tide at gøre noget nyttigt med dem. Naturligvis uden at tage fingrene væk fra tastaturet.
Det er ingen hemmelighed, at en simpel sletning af en tabel vil se ens ud i næsten alle databaser:drop table hr.persons fylder 31 sider, , , cassandra ). Det er usandsynligt, at en grafisk "wizard" fra en hvilken som helst IDE (især en universel) helt kan dække alle disse evner, og hvis den kan, vil det være et syn for følsomme sjæle. På den anden side vil en korrekt og rettidigt skrevet operator create table gøre det muligt at udnytte dem alle uden problemer og sikre, at opbevaring og adgang til dine data er pålidelig, optimal og så komfortabel som muligt.
Desuden har mange databasesystemer deres egne specifikke objekttyper, som ikke findes i andre databasesystemer. Og vi kan udføre operationer ikke kun på databaseobjekterne, men også på selve databasesystemet, for eksempel "dræbe" en proces, frigive et område i hukommelsen, aktivere sporing, skifte til "read only" tilstand og meget mere.
Og nu skal vi tegne lidt.
En af de mest almindelige opgaver er at opbygge et diagram med databaseobjekter, så man på et smukt billede kan se objekterne og relationerne imellem dem. Dette kan stort set enhver grafisk IDE, separate "command line"-værktøjer, specialiserede grafiske værktøjer og modellerere gøre. De vil tegne noget "som de kan", og man kan kun i begrænset omfang påvirke denne proces med et par parametre i konfigurationsfilen eller ved at klikke på nogle indstillinger i grænsefladen.
Men dette problem kan løses meget enklere, mere fleksibelt og elegantere, selvfølgelig ved hjælp af kode. Til opbygning af diagrammer af enhver kompleksitet har vi adskillige specialiserede markup-sprog (DOT, GraphML osv.), samt en række applikationer (GraphViz, PlantUML, Mermaid), der kan læse sådanne instruktioner og visualisere dem i de mest forskellige formater. Og vi ved allerede, hvordan vi kan få information om objekterne og relationerne mellem dem.
Lad os give et lille eksempel på, hvordan dette kan se ud, med brug af PlantUML og (til venstre er SQL-forespørgslen, der genererer den nødvendige instruktion til PlantUML, og til højre er resultatet):
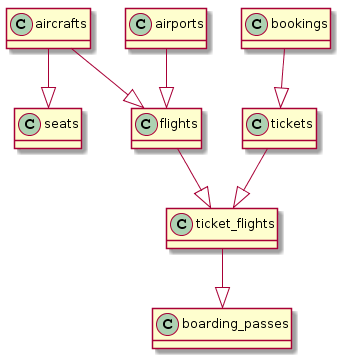
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Og hvis man anstrenger sig lidt, kan man basere sig på for at opnå noget, der ligner en rigtig ER-diagram:
SQL-forespørgslen er en smule mere kompleks.
-- Header
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tables
select format('Table(%s, "%s n information about %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relationships between tables
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s may have many %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Footer
select '@enduml' 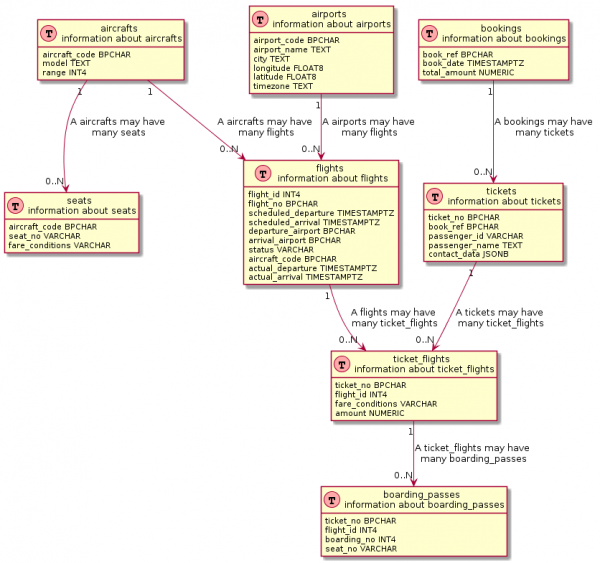
Hvis man ser nærmere efter, så bruger mange visualiseringsværktøjer også lignende forespørgsler under overfladen. Dog er disse forespørgsler normalt dybt , for ikke at tale om at modificere dem.
Metrikker og overvågning
Lad os gå videre til et traditionelt komplekst emne - overvågning af databaseydelse. Jeg husker en lille sand historie, som blev fortalt mig af "en af mine venner". På et projekt levede der engang en magtfuld DBA, og få udviklere kendte ham personligt, eller havde overhovedet set ham (på trods af at han angiveligt arbejdede et sted i den nærliggende bygning). På time "X", når produktionssystemet hos en stor forhandler igen begyndte at "føle sig dårligt", sendte han tavst skærmbilleder fra Oracle Enterprise Manager, hvor han omhyggeligt markerede kritiske områder med rød markør for "forståelighed" (som sagt, det hjalp ikke meget). Og på baggrund af dette "fotografi" måtte man diagnosticere problemerne. Desuden havde ingen adgang til den dyrebare (i begge betydninger af ordet) Enterprise Manager, da systemet er komplekst og kostbart; hvad nu hvis "udviklerne finder på noget, og alt går i stykker". Derfor fandt udviklerne på empirisk vis placeringen og årsagen til forsinkelser og udsendte et patch. Hvis der ikke kom et skræmmende brev fra DBA'en igen i den nærmeste fremtid, udåndede alle lettet og vendte tilbage til deres nuværende opgaver (indtil det nye brev).
Men overvågningsprocessen kan se mere munter og venlig ud, og vigtigst af alt - tilgængelig og gennemsigtig for alle. I det mindste den grundlæggende del, som et supplement til de vigtigste overvågningssystemer (som uden tvivl er nyttige og i mange tilfælde uundgåelige). Hver database management system er villig og helt gratis til at dele information om sin nuværende tilstand og ydeevne. Selv i den "blodige" Oracle DB kan næsten al information om ydeevne hentes fra systemvisninger, lige fra processer og sessioner til tilstanden af buffer cache (for eksempel, , sektionen "Overvågning"). I Postgresql findes der også en hel række systemvisninger til , herunder sådanne uundgåelige i enhver DBA's hverdag, som , , . I MySQL er der endda et separat skema dedikeret til dette . Og i Mongo findes der en indbygget der samler data om ydeevne i en systemkollektion .
Således, ved at udstyre sig med en eller anden metrics-samler (Telegraf, Metricbeat, Collectd), der er i stand til at udføre tilpassede SQL-forespørgsler, et lager til disse målinger (InfluxDB, Elasticsearch, Timescaledb) og en visualizer (Grafana, Kibana), kan man opnå et relativt let og fleksibelt overvågningssystem, der vil være tæt integreret med andre generelle systemmetrikker (f.eks. indsamlet fra applikationsserveren, fra operativsystemet osv.). Som for eksempel er gjort i pgwatch2, hvor der bruges et setup med InfluxDB + Grafana og et sæt forespørgsler til systemvisninger, som også kan .
I alt
Og dette er kun en omtrentlig liste over, hvad der kan gøres med vores database ved hjælp af almindelig SQL-kode. Jeg er sikker på, at der kan findes mange flere anvendelser, skriv i kommentarerne. Og vi vil tale om, hvordan (og vigtigst af alt, hvorfor) man kan automatisere alt dette og inkludere det i sin CI/CD-pipeline næste gang.
Kilde: habr.com
